16 Agrupamento com K-Means
No aprendizado não supervisionado, o K-Means é um dos algoritmos de clusterização mais tradicionais. Estudaremos os tipos de agrupamento e as medidas de similaridade, a formulação do K-Means como um problema de minimização da inércia (soma de quadrados intra-cluster), o algoritmo de Lloyd e sua convergência, a decomposição da soma de quadrados, estratégias de inicialização como o k-means++, métodos para selecionar o número ideal de clusters (cotovelo, silhueta e estatística gap), as limitações do método e alternativas como K-medoids, agrupamento hierárquico e DBSCAN. Aprofundamos ainda a teoria: a geometria de Voronoi e a complexidade computacional do problema, as variantes de MacQueen, Hartigan–Wong e mini-batch, os índices de Calinski–Harabasz e Davies–Bouldin, a validação externa (Rand ajustado e informação mútua), as misturas gaussianas e o algoritmo EM (do qual o K-Means é um caso limite), a fórmula de Lance–Williams e a correlação cofenética, as definições formais do DBSCAN, o uso da PCA, o kernel K-Means, o agrupamento espectral e a estabilidade dos grupos.
16.1 O que é Aprendizado Não Supervisionado?
Diferentemente dos capítulos anteriores (onde os dados continham um sinal de supervisão, ou seja, rótulos de classe ou valores numéricos \(y\) de alvo), no Aprendizado Não Supervisionado lidamos apenas com dados brutos não estruturados de entrada. O objetivo fundamental é a Clusterização (ou Agrupamento): dividir e organizar um conjunto de dados heterogêneo em múltiplos grupos homogêneos (clusters) baseando-se estritamente na similaridade geométrica das características de cada registro.
Exemplos práticos de aplicação de agrupamentos:
- Segmentação de clientes de comércio eletrônico com perfis similares de compra para direcionamento de marketing.
- Agrupamento de genes ou proteínas com comportamentos de expressão semelhantes em biomedicina.
- Compressão e segmentação de pixels em imagens digitais.
- Organização de documentos por tema e detecção de anomalias (pontos que não pertencem a nenhum grupo).
Formalmente, dispomos de \(n\) observações \(\mathbf{x}_1, \dots, \mathbf{x}_n \in \mathbb{R}^p\), sem variável resposta. Um agrupamento em \(K\) grupos (no caso particional, rígido) é uma partição \(\mathcal{C} = \{C_1, \dots, C_K\}\) do conjunto de índices \(\{1, \dots, n\}\), isto é,
\[ C_1 \cup C_2 \cup \dots \cup C_K = \{1, \dots, n\}, \qquad C_k \cap C_{l} = \emptyset \;\; (k \neq l), \qquad C_k \neq \emptyset. \]
Uma dificuldade central é que não existe “resposta correta” para comparar: a qualidade de um agrupamento depende da noção de similaridade escolhida, do objetivo da análise e da interpretação substantiva dos grupos. Além disso, o número de partições possíveis é astronômico: o número de maneiras de dividir \(n\) objetos em \(K\) grupos não vazios é o número de Stirling de segunda espécie, \(S(n, K) \approx K^n / K!\). Para \(n = 100\) e \(K = 5\), isso dá cerca de \(6{,}6 \times 10^{67}\) partições — impossível examinar todas. Por isso recorremos a algoritmos heurísticos como o K-Means.
16.2 Tipos de Agrupamento
Os métodos de agrupamento costumam ser classificados em quatro grandes famílias (Jain 2010; Kaufman e Rousseeuw 1990):
| Família | Ideia | Exemplos | Forma dos grupos |
|---|---|---|---|
| Particional | Divide os dados diretamente em \(K\) grupos otimizando um critério | K-Means, K-Medoids (PAM) | Compactos, aproximadamente convexos |
| Hierárquico | Constrói uma hierarquia de partições aninhadas (dendrograma) | Aglomerativo (single, complete, average, Ward), divisivo | Depende da ligação |
| Baseado em densidade | Grupos são regiões densas separadas por regiões esparsas | DBSCAN, OPTICS | Formas arbitrárias; identifica ruído |
| Baseado em modelos | Os dados vêm de uma mistura de distribuições de probabilidade | Misturas gaussianas (algoritmo EM) | Elipsoidais; atribuição probabilística |
Outra distinção importante é entre agrupamento rígido (hard), em que cada ponto pertence a exatamente um grupo, e suave (soft ou fuzzy), em que cada ponto tem um grau de pertinência (ou probabilidade) em cada grupo.
16.3 Medidas de Similaridade e Dissimilaridade
Todo método de agrupamento depende de uma noção de proximidade entre observações. Uma dissimilaridade \(d(\mathbf{x}, \mathbf{z})\) satisfaz \(d \geq 0\), \(d(\mathbf{x}, \mathbf{x}) = 0\) e \(d(\mathbf{x},\mathbf{z}) = d(\mathbf{z},\mathbf{x})\); se também satisfaz a desigualdade triangular, é uma métrica (distância). As mais usadas, várias já vistas no Capítulo de k-NN, são:
- Euclidiana: \(d(\mathbf{x}, \mathbf{z}) = \sqrt{\sum_{j=1}^p (x_j - z_j)^2}\). É a base do K-Means.
- Manhattan: \(d(\mathbf{x}, \mathbf{z}) = \sum_{j=1}^p |x_j - z_j|\). Menos sensível a valores extremos em uma única coordenada.
- Minkowski (generaliza as anteriores): \(d_q(\mathbf{x}, \mathbf{z}) = \left(\sum_{j=1}^p |x_j - z_j|^q\right)^{1/q}\), com \(q = 1\) (Manhattan) e \(q = 2\) (Euclidiana).
- Dissimilaridade do cosseno: \(1 - \dfrac{\mathbf{x}^\top\mathbf{z}}{\|\mathbf{x}\|\,\|\mathbf{z}\|}\). Ignora a magnitude e considera apenas a direção; muito usada em textos.
- Baseada em correlação: \(1 - r(\mathbf{x}, \mathbf{z})\), em que \(r\) é a correlação de Pearson entre os perfis. Agrupa observações com o mesmo padrão de variação (comum em expressão gênica).
- Jaccard (dados binários): \(1 - \dfrac{|A \cap B|}{|A \cup B|}\), em que \(A\) e \(B\) são os conjuntos de atributos presentes.
- Gower (dados mistos — numéricos e categóricos): média de dissimilaridades parciais calculadas por variável, cada uma em \([0, 1]\).
Como no k-NN e no SVM, variáveis com grande amplitude dominam as distâncias. Antes de aplicar o K-Means, em geral padronizamos cada variável: \(z_{ij} = (x_{ij} - \bar x_j)/s_j\). Há exceções — quando todas as variáveis já estão na mesma unidade e a diferença de escala é significativa (por exemplo, intensidades de pixels) —, mas a decisão deve ser consciente.
16.4 O Funcionamento do Algoritmo K-Means
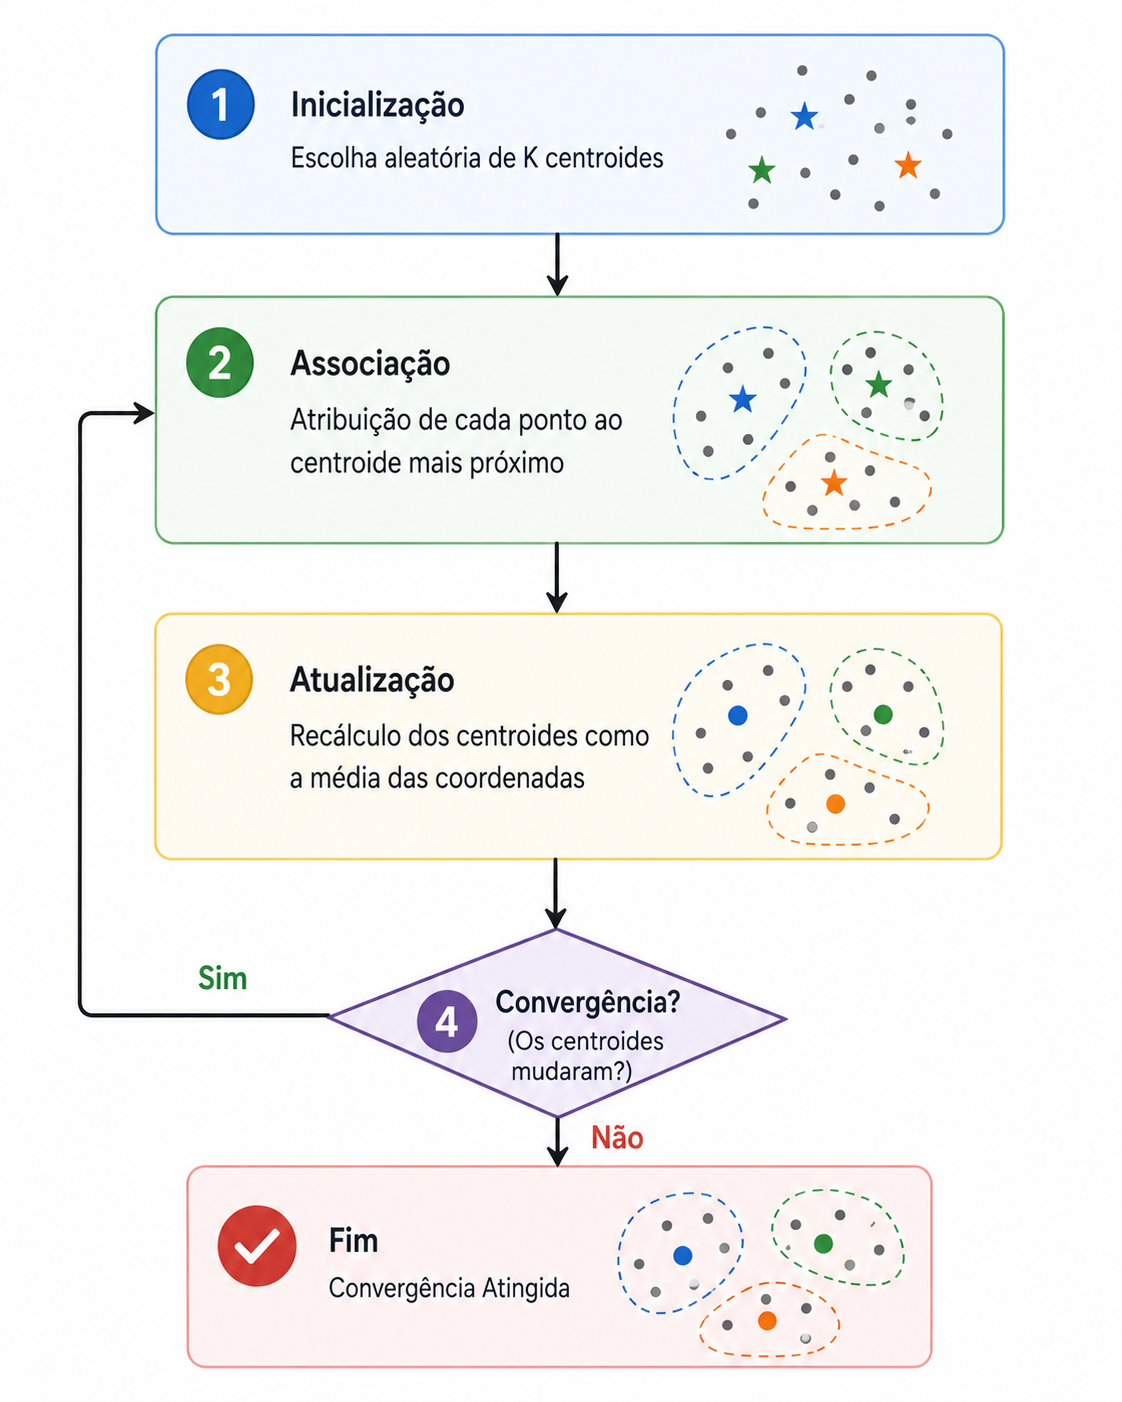
O K-Means, introduzido conceitualmente por James MacQueen (MacQueen 1967), é um dos algoritmos de agrupamento baseados em centroides mais tradicionais e fáceis de aplicar. O algoritmo busca dividir os dados em \(K\) grupos distintos organizando os pontos ao redor de “centroides” (os centros geométricos matemáticos dos clusters) de forma iterativa. A versão em lote mais usada é conhecida como algoritmo de Lloyd, proposta por Stuart Lloyd em 1957 em um relatório dos Bell Labs sobre quantização de sinais e publicada apenas em 1982 (Lloyd 1982); outra variante clássica é a de Hartigan e Wong (Hartigan e Wong 1979), padrão da função kmeans do R.
O passo a passo do algoritmo K-Means é composto por quatro etapas cíclicas:
- Escolha de \(K\): o usuário define o número de grupos.
- Inicialização: escolhem-se \(K\) centroides iniciais \(\boldsymbol\mu_1, \dots, \boldsymbol\mu_K\) (por exemplo, \(K\) observações sorteadas ao acaso).
- Atribuição: cada observação é associada ao centroide mais próximo (em distância euclidiana).
- Atualização: cada centroide é recalculado como a média (vetor de médias) das observações a ele atribuídas. Repetem-se os passos 3 e 4 até que as atribuições não mudem mais (ou até um número máximo de iterações).
16.5 Minimização da Inércia Matemática
O objetivo matemático de convergência do algoritmo K-Means é minimizar a chamada soma das distâncias quadradas intra-clusters (WSS - Total Within-Cluster Sum of Squares), também chamada de WCSS (Within-Cluster Sum of Squares) ou, frequentemente, de Inércia. Ela mede a soma dos quadrados das distâncias de todos os pontos ao centroide do seu cluster correspondente: \[WSS = \sum_{j=1}^{K} \sum_{i \in C_j} ||x_i - \mu_j||^2\] Onde \(\mu_j\) é a coordenada tridimensional ou n-dimensional do centroide do cluster \(C_j\), e \(x_i\) é um ponto pertencente a esse grupo. Queremos que essa distância seja o menor valor possível, o que garante a minimização da variância interna dos clusters, caracterizando grupos compactos e bem definidos.
16.5.1 Formulação como Problema de Otimização
Podemos escrever o K-Means como a minimização conjunta sobre partições e centroides:
\[ \min_{\mathcal{C},\; \boldsymbol\mu_1, \dots, \boldsymbol\mu_K} \; J(\mathcal{C}, \boldsymbol\mu) = \sum_{k=1}^K \sum_{i \in C_k} \|\mathbf{x}_i - \boldsymbol\mu_k\|^2. \]
Uma formulação equivalente (e útil) mostra que o K-Means minimiza as distâncias quadradas entre pares de pontos dentro de cada grupo:
\[ \sum_{i \in C_k}\|\mathbf{x}_i - \bar{\mathbf{x}}_k\|^2 = \frac{1}{2|C_k|}\sum_{i \in C_k}\sum_{i' \in C_k}\|\mathbf{x}_i - \mathbf{x}_{i'}\|^2, \]
em que \(\bar{\mathbf{x}}_k\) é a média do grupo \(k\). Encontrar o mínimo global de \(J\) é um problema NP-difícil em geral, mesmo para \(K = 2\); o algoritmo de Lloyd é uma heurística de otimização alternada (ou descida coordenada) que encontra ótimos locais.
16.5.2 Lema: a Média Minimiza a Soma de Quadrados
Para qualquer conjunto de pontos \(\{\mathbf{x}_i\}_{i \in C}\) com média \(\bar{\mathbf{x}}_C\) e qualquer \(\mathbf{m} \in \mathbb{R}^p\):
\[ \sum_{i \in C}\|\mathbf{x}_i - \mathbf{m}\|^2 = \sum_{i \in C}\|\mathbf{x}_i - \bar{\mathbf{x}}_C\|^2 + |C|\,\|\bar{\mathbf{x}}_C - \mathbf{m}\|^2. \]
Prova. Escreva \(\mathbf{x}_i - \mathbf{m} = (\mathbf{x}_i - \bar{\mathbf{x}}_C) + (\bar{\mathbf{x}}_C - \mathbf{m})\) e expanda o quadrado. O termo cruzado é \(2(\bar{\mathbf{x}}_C - \mathbf{m})^\top\sum_{i\in C}(\mathbf{x}_i - \bar{\mathbf{x}}_C) = 0\), pois os desvios em relação à média somam zero. \(\blacksquare\)
Como o segundo termo é não negativo e só se anula em \(\mathbf{m} = \bar{\mathbf{x}}_C\), a média é o único minimizador da soma de quadrados. (Esse é o análogo multivariado do fato de que a média minimiza \(\sum(y_i - c)^2\), usado no capítulo de Modelos de Regressão.)
16.5.3 O Algoritmo de Lloyd e sua Convergência
Denotemos por \(\mathcal{C}^{(t)}\) e \(\boldsymbol\mu^{(t)}\) a partição e os centroides na iteração \(t\). Cada iteração tem dois passos:
- Passo de atribuição: com os centroides fixos, \(C_k^{(t+1)} = \{i : \|\mathbf{x}_i - \boldsymbol\mu_k^{(t)}\|^2 \leq \|\mathbf{x}_i - \boldsymbol\mu_l^{(t)}\|^2 \;\; \forall\, l\}\) (empates resolvidos por uma regra fixa, por exemplo, mantendo o grupo atual).
- Passo de atualização: com a partição fixa, \(\boldsymbol\mu_k^{(t+1)} = \dfrac{1}{|C_k^{(t+1)}|}\sum_{i \in C_k^{(t+1)}}\mathbf{x}_i\).
Proposição. (i) Nenhum dos passos aumenta \(J\); (ii) o algoritmo termina em um número finito de iterações; (iii) no ponto de parada, a solução é um ótimo local, no sentido de que nenhum dos dois passos consegue melhorá-la.
Prova.
- Atribuição não aumenta \(J\). Com \(\boldsymbol\mu^{(t)}\) fixo, \(J\) é uma soma de termos, um por observação. Mover cada \(\mathbf{x}_i\) para o centroide mais próximo minimiza individualmente cada termo; logo \(J(\mathcal{C}^{(t+1)}, \boldsymbol\mu^{(t)}) \leq J(\mathcal{C}^{(t)}, \boldsymbol\mu^{(t)})\).
- Atualização não aumenta \(J\). Com a partição fixa, \(J\) se separa em \(K\) somas independentes, e pelo lema cada uma é minimizada pela média do grupo; logo \(J(\mathcal{C}^{(t+1)}, \boldsymbol\mu^{(t+1)}) \leq J(\mathcal{C}^{(t+1)}, \boldsymbol\mu^{(t)})\).
- Convergência finita. A sequência \(J^{(t)}\) é não crescente e limitada inferiormente por 0. Além disso, após cada atualização os centroides são as médias da partição corrente, de modo que \(J^{(t)}\) é uma função apenas da partição. Se a partição muda (com a regra de desempate acima, uma mudança só ocorre se reduz estritamente a distância de algum ponto), \(J\) diminui estritamente; portanto nenhuma partição pode ser revisitada. Como há um número finito de partições (no máximo \(K^n\)), o algoritmo para após um número finito de iterações. \(\blacksquare\)
O ponto de parada é um ótimo local: dada a partição, os centroides são ótimos, e dados os centroides, a partição é ótima. Porém, nada garante que seja o ótimo global — diferentes inicializações podem levar a soluções diferentes, com valores distintos de \(J\). Na prática, a convergência costuma ocorrer em poucas dezenas de iterações. O custo de cada iteração é \(O(nKp)\), o que torna o K-Means muito eficiente para grandes bases.
16.5.4 Decomposição da Soma de Quadrados
Seja \(\bar{\mathbf{x}}\) a média global dos dados e \(n_k = |C_k|\). Aplicando o lema a cada grupo com \(\mathbf{m} = \bar{\mathbf{x}}\) e somando sobre \(k\):
\[ \underbrace{\sum_{i=1}^n\|\mathbf{x}_i - \bar{\mathbf{x}}\|^2}_{SQ_{Total}} = \underbrace{\sum_{k=1}^K\sum_{i \in C_k}\|\mathbf{x}_i - \bar{\mathbf{x}}_k\|^2}_{SQ_{Intra} \; (WCSS)} + \underbrace{\sum_{k=1}^K n_k\,\|\bar{\mathbf{x}}_k - \bar{\mathbf{x}}\|^2}_{SQ_{Entre} \; (BCSS)}. \]
Como \(SQ_{Total}\) não depende do agrupamento, minimizar a soma de quadrados intra-cluster equivale a maximizar a soma de quadrados entre clusters: grupos internamente compactos são, automaticamente, grupos bem separados entre si (no sentido de suas médias). A razão \(SQ_{Entre}/SQ_{Total}\), reportada pela função kmeans do R como between_SS / total_SS, é análoga ao \(R^2\) da regressão e à decomposição da ANOVA.
Considere \(n = 6\) pontos em \(\mathbb{R}^2\) e \(K = 2\):
| Ponto | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| \((x_1, x_2)\) | (1, 1) | (2, 1) | (1, 2) | (5, 4) | (6, 5) | (5, 6) |
Para ilustrar a dinâmica, usamos uma inicialização ruim: \(\boldsymbol\mu_1^{(0)} = A = (1,1)\) e \(\boldsymbol\mu_2^{(0)} = B = (2,1)\).
Iteração 1 — atribuição. Distâncias euclidianas ao quadrado:
| Ponto | \(d^2(\cdot, \boldsymbol\mu_1)\) | \(d^2(\cdot, \boldsymbol\mu_2)\) | Grupo |
|---|---|---|---|
| A (1,1) | 0 | 1 | 1 |
| B (2,1) | 1 | 0 | 2 |
| C (1,2) | 1 | 2 | 1 |
| D (5,4) | 25 | 18 | 2 |
| E (6,5) | 41 | 32 | 2 |
| F (5,6) | 41 | 34 | 2 |
\(C_1 = \{A, C\}\), \(C_2 = \{B, D, E, F\}\), com \(J = 0 + 1 + 0 + 18 + 32 + 34 = 85\).
Iteração 1 — atualização.
\[ \boldsymbol\mu_1^{(1)} = \tfrac{1}{2}\big[(1,1) + (1,2)\big] = (1;\; 1{,}5), \qquad \boldsymbol\mu_2^{(1)} = \tfrac{1}{4}\big[(2,1) + (5,4) + (6,5) + (5,6)\big] = (4{,}5;\; 4). \]
Com os novos centroides, \(J\) cai para \(23{,}5\).
Iteração 2 — atribuição.
| Ponto | \(d^2(\cdot, \boldsymbol\mu_1)\) | \(d^2(\cdot, \boldsymbol\mu_2)\) | Grupo |
|---|---|---|---|
| A (1,1) | 0,25 | 21,25 | 1 |
| B (2,1) | 1,25 | 15,25 | 1 (mudou) |
| C (1,2) | 0,25 | 16,25 | 1 |
| D (5,4) | 22,25 | 0,25 | 2 |
| E (6,5) | 37,25 | 3,25 | 2 |
| F (5,6) | 36,25 | 4,25 | 2 |
O ponto B migra para o grupo 1: \(C_1 = \{A, B, C\}\), \(C_2 = \{D, E, F\}\), e \(J = 0{,}25 + 1{,}25 + 0{,}25 + 0{,}25 + 3{,}25 + 4{,}25 = 9{,}5\).
Iteração 2 — atualização.
\[ \boldsymbol\mu_1^{(2)} = \left(\tfrac{4}{3};\; \tfrac{4}{3}\right) \approx (1{,}33;\; 1{,}33), \qquad \boldsymbol\mu_2^{(2)} = \left(\tfrac{16}{3};\; 5\right) \approx (5{,}33;\; 5). \]
Agora \(J = \underbrace{\tfrac{2}{9} + \tfrac{5}{9} + \tfrac{5}{9}}_{4/3} + \underbrace{\tfrac{10}{9} + \tfrac{4}{9} + \tfrac{10}{9}}_{8/3} = 4\).
Iteração 3. Refazendo as distâncias, nenhum ponto muda de grupo: o algoritmo convergiu. A sequência do objetivo foi \(85 \to 23{,}5 \to 9{,}5 \to 4\), sempre decrescente, como garante a proposição.
Decomposição. A média global é \(\bar{\mathbf{x}} = (20/6;\; 19/6) \approx (3{,}33;\; 3{,}17)\) e \(SQ_{Total} \approx 48{,}17\). Como \(SQ_{Intra} = 4\), temos \(SQ_{Entre} \approx 44{,}17\) (verifique: \(3\,\|(4/3, 4/3) - \bar{\mathbf{x}}\|^2 + 3\,\|(16/3, 5) - \bar{\mathbf{x}}\|^2 = 3(4 + 121/36) \times 2 \approx 44{,}17\)). A razão \(SQ_{Entre}/SQ_{Total} \approx 91{,}7\%\) indica grupos muito bem separados.
16.5.5 Geometria do K-Means: Diagramas de Voronoi
Fixados os centroides, o passo de atribuição divide \(\mathbb{R}^p\) em \(K\) regiões, chamadas células de Voronoi:
\[ V_k = \{\mathbf{x} \in \mathbb{R}^p : \|\mathbf{x} - \boldsymbol\mu_k\| \leq \|\mathbf{x} - \boldsymbol\mu_l\| \;\; \forall\, l \neq k\}. \]
Expandindo os quadrados, a condição \(\|\mathbf{x} - \boldsymbol\mu_k\|^2 \leq \|\mathbf{x} - \boldsymbol\mu_l\|^2\) equivale a
\[ 2(\boldsymbol\mu_l - \boldsymbol\mu_k)^\top\mathbf{x} \leq \|\boldsymbol\mu_l\|^2 - \|\boldsymbol\mu_k\|^2, \]
que é linear em \(\mathbf{x}\): o termo \(\|\mathbf{x}\|^2\) cancela dos dois lados. Cada célula é, portanto, uma interseção de \(K-1\) semiespaços — um poliedro convexo —, e a fronteira entre dois grupos é o hiperplano mediador do segmento que liga os centroides. Duas consequências importantes:
- O K-Means só consegue produzir grupos linearmente separáveis entre si, o que explica sua dificuldade com anéis e meias-luas.
- Os grupos de uma solução convergida são ao mesmo tempo centroidais (cada centroide é a média de sua célula) e de Voronoi (cada ponto está na célula do centroide mais próximo). Essas tesselações de Voronoi centroidais aparecem também em quantização de sinais, geração de malhas e localização de instalações.
No exemplo anterior, com centroides \((4/3, 4/3)\) e \((16/3, 5)\), a fronteira é a reta \(2\,(4;\; 11/3)^\top\mathbf{x} = \big[(16/3)^2 + 5^2\big] - 2\,(4/3)^2\), isto é, \(8x_1 + \tfrac{22}{3}x_2 = \tfrac{449}{9} \approx 49{,}9\). Qualquer novo ponto com \(8x_1 + \tfrac{22}{3}x_2 < 49{,}9\) (abaixo e à esquerda da reta) seria atribuído ao grupo 1; por exemplo, para B = (2, 1), o lado esquerdo vale \(23{,}3\), e para D = (5, 4), vale \(69{,}3\).
16.5.6 Complexidade Computacional
Encontrar a partição que minimiza globalmente \(J\) é um problema NP-difícil: Aloise et al. (Aloise et al. 2009) provaram a NP-dificuldade já para \(K = 2\) quando a dimensão \(p\) faz parte da entrada, e Mahajan, Nimbhorkar e Varadarajan (Mahajan, Nimbhorkar, e Varadarajan 2012) provaram-na no plano (\(p = 2\)) quando \(K\) é parte da entrada. Assim, não se conhece algoritmo eficiente que garanta o ótimo global, e é improvável que exista.
Há, porém, casos tratáveis e resultados finos sobre o próprio algoritmo de Lloyd:
- Uma dimensão: em \(\mathbb{R}\), os grupos ótimos são intervalos contíguos dos dados ordenados, e o ótimo global pode ser obtido por programação dinâmica em tempo polinomial (por exemplo, \(O(Kn^2)\), implementado no pacote
Ckmeans.1d.dpdo R). - \(K\) e \(p\) fixos: como cada partição ótima é induzida por um diagrama de Voronoi, o número de partições “candidatas” é polinomial em \(n\) (da ordem de \(n^{Kp}\)), o que dá um algoritmo exato polinomial — mas inútil na prática pelo expoente.
- Pior caso de Lloyd: Vattani (Vattani 2011) construiu conjuntos de pontos no plano para os quais o algoritmo de Lloyd exige um número exponencial de iterações. Esses exemplos são patológicos; em dados reais, a convergência costuma ocorrer em poucas dezenas de iterações.
16.6 Inicialização dos Centroides
Como o K-Means converge para ótimos locais, a inicialização é decisiva.
16.6.1 Inicialização Aleatória e Múltiplos Inícios
A estratégia mais simples sorteia \(K\) observações como centroides iniciais (método de Forgy) ou atribui cada ponto a um grupo aleatório. Para reduzir o risco de um ótimo local ruim, executa-se o algoritmo várias vezes com sementes diferentes e retém-se a solução de menor WCSS. No R, isso é controlado pelo argumento nstart de kmeans (o padrão é 1; recomenda-se 25 ou mais); no scikit-learn, pelo argumento n_init.
16.6.2 k-means++
Arthur e Vassilvitskii (Arthur e Vassilvitskii 2007) propuseram uma inicialização que espalha os centroides iniciais:
- Escolha o primeiro centroide uniformemente ao acaso entre as observações.
- Para cada observação \(\mathbf{x}_i\), calcule \(D(\mathbf{x}_i)\), a distância ao centroide mais próximo já escolhido.
- Escolha o próximo centroide sorteando \(\mathbf{x}_i\) com probabilidade proporcional a \(D(\mathbf{x}_i)^2\): \[P(\mathbf{x}_i) = \frac{D(\mathbf{x}_i)^2}{\sum_{l=1}^n D(\mathbf{x}_l)^2}.\]
- Repita os passos 2 e 3 até ter \(K\) centroides; em seguida, execute o algoritmo de Lloyd.
Pontos distantes dos centroides já escolhidos têm maior chance de serem sorteados, o que evita iniciar dois centroides no mesmo grupo natural. Os autores provaram que o valor esperado de \(J\) obtido logo após essa inicialização é no máximo \(8(\ln K + 2)\) vezes o ótimo global — uma garantia de aproximação \(O(\log K)\). O k-means++ é o padrão do scikit-learn.
Nos dados do exemplo anterior, suponha que o primeiro centroide sorteado seja A = (1,1). As distâncias quadradas até A são: B: 1, C: 1, D: 25, E: 41, F: 41, cuja soma é 109. As probabilidades de escolha do segundo centroide são, portanto, \(1/109 \approx 0{,}009\) para B e C, \(25/109 \approx 0{,}229\) para D e \(41/109 \approx 0{,}376\) para E e F. Com probabilidade de aproximadamente \(98\%\), o segundo centroide cairá no grupo “de cima”, evitando a inicialização ruim que usamos no exemplo.
Teorema (Arthur e Vassilvitskii, 2007). Seja \(J_{\text{ótimo}}\) o menor valor possível do objetivo com \(K\) grupos e \(J_{++}\) o valor do objetivo para os centroides produzidos apenas pela semeadura \(D^2\) (antes de qualquer iteração de Lloyd). Então
\[ \mathbb{E}[J_{++}] \leq 8(\ln K + 2)\,J_{\text{ótimo}}. \]
A ideia da prova é a seguinte: (i) se um centroide é sorteado uniformemente dentro de um grupo ótimo \(A\), o custo esperado de \(A\) é exatamente o dobro do ótimo daquele grupo — isso segue do lema da média, pois \(\mathbb{E}_{\mathbf{a}}\big[\sum_{\mathbf{x} \in A}\|\mathbf{x} - \mathbf{a}\|^2\big] = 2\sum_{\mathbf{x} \in A}\|\mathbf{x} - \bar{\mathbf{x}}_A\|^2\); (ii) sob a amostragem \(D^2\), um ponto sorteado dentro de um grupo ainda “não coberto” custa, em esperança, no máximo \(8\) vezes o ótimo desse grupo; (iii) um argumento de indução sobre os grupos não cobertos contabiliza a probabilidade de sortear pontos em grupos já cobertos, o que gera o fator harmônico \(1 + 1/2 + \dots + 1/K \leq \ln K + 1\). Como as iterações de Lloyd nunca aumentam \(J\), a garantia vale também para a solução final. Os autores mostram ainda que o fator \(O(\log K)\) não pode ser melhorado em geral para essa semeadura.
16.7 Variantes Algorítmicas
16.7.1 O Algoritmo de MacQueen (Atualização Online)
Na proposta original de MacQueen (MacQueen 1967), os pontos são processados um a um, e o centroide mais próximo é atualizado imediatamente. Se o grupo \(k\) tinha \(n_k\) pontos e média \(\boldsymbol\mu_k\) e recebe o ponto \(\mathbf{x}\), a nova média é
\[ \boldsymbol\mu_k^{\text{novo}} = \frac{n_k\boldsymbol\mu_k + \mathbf{x}}{n_k + 1} = \boldsymbol\mu_k + \frac{1}{n_k + 1}\,(\mathbf{x} - \boldsymbol\mu_k). \]
Essa é uma iteração de gradiente estocástico sobre o termo \(\frac{1}{2}\|\mathbf{x} - \boldsymbol\mu_k\|^2\) (cujo gradiente em \(\boldsymbol\mu_k\) é \(-(\mathbf{x} - \boldsymbol\mu_k)\)) com taxa de aprendizado \(1/(n_k + 1)\) decrescente, o que permite agrupar fluxos de dados (streaming) sem armazená-los.
16.7.2 O Algoritmo de Hartigan–Wong
O algoritmo de Lloyd move um ponto para o centroide mais próximo, mas ignora que o próprio movimento altera os centroides. Usando o lema da média, pode-se calcular a variação exata de \(J\) ao transferir o ponto \(\mathbf{x}\) do grupo \(A\) (com \(n_A\) pontos) para o grupo \(B\) (com \(n_B\) pontos):
\[ \Delta J = \frac{n_B}{n_B + 1}\,\|\mathbf{x} - \boldsymbol\mu_B\|^2 - \frac{n_A}{n_A - 1}\,\|\mathbf{x} - \boldsymbol\mu_A\|^2. \]
O algoritmo de Hartigan e Wong (Hartigan e Wong 1979), padrão da função kmeans do R, transfere o ponto sempre que \(\Delta J < 0\). Como \(n_B/(n_B + 1) < 1 < n_A/(n_A - 1)\), se \(\mathbf{x}\) está mais próximo de \(\boldsymbol\mu_B\) do que de \(\boldsymbol\mu_A\), então \(\Delta J < 0\): todo movimento que Lloyd faria também é vantajoso para Hartigan–Wong, mas a recíproca é falsa — um ponto ligeiramente mais próximo de seu próprio centroide ainda pode valer a pena ser transferido. Consequentemente, toda partição estável para Hartigan–Wong também é estável para Lloyd, mas não reciprocamente, e o método tende a encontrar ótimos locais melhores. (O critério exige \(n_A \geq 2\): não se esvazia um grupo.)
No exemplo resolvido, após a primeira atualização tínhamos \(C_1 = \{A, C\}\) com \(\boldsymbol\mu_1 = (1;\; 1{,}5)\), \(C_2 = \{B, D, E, F\}\) com \(\boldsymbol\mu_2 = (4{,}5;\; 4)\) e \(J = 23{,}5\). Para transferir B = (2,1) de \(C_2\) (\(n_A = 4\)) para \(C_1\) (\(n_B = 2\)):
\[ \Delta J = \frac{2}{3}\underbrace{\|(2,1) - (1;\, 1{,}5)\|^2}_{1{,}25} - \frac{4}{3}\underbrace{\|(2,1) - (4{,}5;\, 4)\|^2}_{15{,}25} = 0{,}833 - 20{,}333 = -19{,}5. \]
A transferência reduz \(J\) de \(23{,}5\) para \(23{,}5 - 19{,}5 = 4\), exatamente o valor final obtido antes, agora em um único passo e com os centroides já atualizados.
16.7.3 Mini-Batch K-Means
Para bases com milhões de observações, mesmo o custo \(O(nKp)\) por iteração pode ser alto. O mini-batch K-Means (Sculley 2010) sorteia, a cada passo, um pequeno lote \(\mathcal{B}\) de observações (por exemplo, 1.024), atribui cada uma ao centroide mais próximo e atualiza os centroides com a regra de MacQueen, usando taxas de aprendizado \(1/n_k\) em que \(n_k\) conta quantos pontos o centroide \(k\) já recebeu ao longo de todos os lotes. O custo por passo passa a ser \(O(|\mathcal{B}|Kp)\), independente de \(n\). Em troca, a solução costuma ser pior que a do algoritmo em lote (o valor de \(J\) fica acima do obtido pelo algoritmo de Lloyd; a diferença é pequena quando os grupos são bem separados, mas pode chegar a dezenas de por cento se o mini-batch ficar preso em um ótimo local ruim — vale comparar ambos em uma subamostra), uma troca vantajosa quando os dados não cabem na memória. No scikit-learn, use MiniBatchKMeans.
16.8 Como Escolher o Número Ideal de Clusters (\(K\))?
Uma das grandes dificuldades do K-Means é que você precisa informar ao algoritmo o valor de \(K\) antes de iniciar a execução. Note que não podemos simplesmente escolher o \(K\) que minimiza a WCSS: o valor ótimo de \(J\) é não crescente em \(K\) e chega a zero quando \(K = n\). Três ferramentas clássicas nos auxiliam a descobrir esse número de forma matemática coerente — além, é claro, do conhecimento do domínio e da interpretabilidade dos grupos.
16.8.1 O Método do Cotovelo (Elbow Method)
- Nós rodamos o algoritmo K-Means repetidas vezes para diferentes valores de \(K\) (ex: de 1 a 10) e calculamos a Inércia total para cada corrida.
- Em seguida, plotamos um gráfico de linha relacionando o valor de \(K\) (no eixo x) com a Inércia resultante (no eixo y).
- Conforme aumentamos \(K\), a inércia tende a cair naturalmente (se \(K\) for igual ao número total de registros, a inércia é 0).
- Buscamos o ponto de inflexão da curva de linha onde a queda da inércia se estabiliza (formando um desenho semelhante a um “cotovelo”). Esse ponto indica o valor ideal de \(K\).
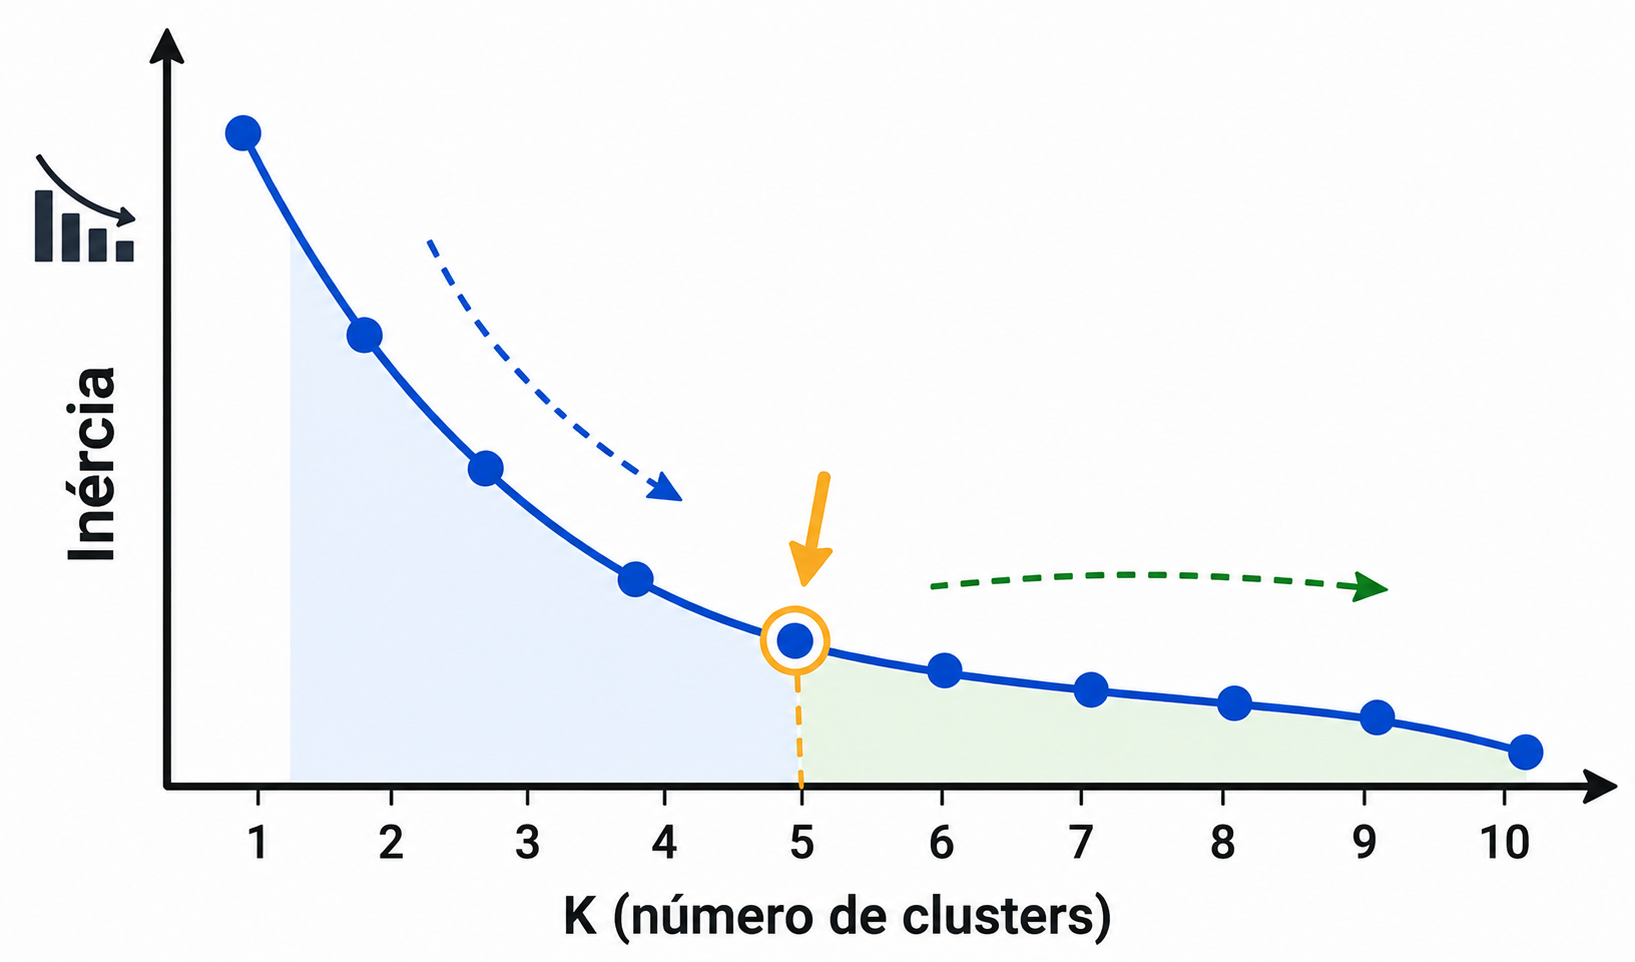
A lógica é a de retornos decrescentes: enquanto \(K\) for menor que o número “natural” de grupos, aumentar \(K\) divide grupos reais e reduz muito a WCSS; depois disso, aumentar \(K\) apenas subdivide grupos homogêneos, com ganhos pequenos. A principal limitação do método é a subjetividade: muitas curvas não exibem um cotovelo nítido.
16.8.2 O Método da Silhueta (Silhouette Method)
Mede o quanto um ponto está próximo e bem alinhado ao seu próprio grupo comparado com a sua distância aos grupos vizinhos (Rousseeuw 1987). Para cada observação \(i\), pertencente ao grupo \(C_A\):
- \(a(i)\): distância média de \(i\) aos demais pontos do próprio grupo, \[a(i) = \frac{1}{|C_A| - 1}\sum_{j \in C_A,\, j \neq i} d(i, j);\]
- \(b(i)\): menor distância média de \(i\) aos pontos de outro grupo (o “grupo vizinho”), \[b(i) = \min_{C \neq C_A}\; \frac{1}{|C|}\sum_{j \in C} d(i, j).\]
O coeficiente de silhueta da observação \(i\) é
\[ s(i) = \frac{b(i) - a(i)}{\max\{a(i),\, b(i)\}}, \qquad -1 \leq s(i) \leq 1, \]
com a convenção \(s(i) = 0\) se \(i\) estiver sozinho em seu grupo. O coeficiente de silhueta varia de -1 a +1, onde valores próximos a +1 indicam que o ponto está perfeitamente agrupado e muito distante de grupos vizinhos ambíguos; valores próximos de 0 indicam um ponto na fronteira entre dois grupos; valores negativos sugerem que o ponto provavelmente foi alocado ao grupo errado.
A silhueta média \(\bar s = \frac{1}{n}\sum_i s(i)\) resume a qualidade do agrupamento, e escolhe-se o \(K\) que a maximiza. Kaufman e Rousseeuw (Kaufman e Rousseeuw 1990) sugerem a interpretação: \(\bar s > 0{,}70\), estrutura forte; \(0{,}50\) a \(0{,}70\), razoável; \(0{,}25\) a \(0{,}50\), fraca; abaixo de \(0{,}25\), nenhuma estrutura substancial. O gráfico de silhuetas, que exibe os \(s(i)\) ordenados por grupo, também revela grupos mal formados.
Na solução final do exemplo (\(C_1 = \{A,B,C\}\), \(C_2 = \{D,E,F\}\)), com distância euclidiana:
- \(a(A) = \frac{1}{2}\big[d(A,B) + d(A,C)\big] = \frac{1}{2}(1 + 1) = 1\).
- \(d(A,D) = \sqrt{16 + 9} = 5\), \(d(A,E) = \sqrt{25+16} \approx 6{,}403\), \(d(A,F) = \sqrt{16+25} \approx 6{,}403\), logo \(b(A) = (5 + 6{,}403 + 6{,}403)/3 \approx 5{,}935\).
- \(s(A) = (5{,}935 - 1)/5{,}935 \approx 0{,}83\).
O ponto A está muito bem agrupado.
16.8.3 A Estatística Gap
Tibshirani, Walther e Hastie (Tibshirani, Walther, e Hastie 2001) formalizaram a ideia do cotovelo comparando a curva de \(\log W_K\) (em que \(W_K\) é a WCSS ótima com \(K\) grupos) com a que se esperaria sob uma distribuição de referência sem estrutura de grupos (tipicamente, uniforme sobre a caixa que contém os dados):
\[ \operatorname{Gap}(K) = \mathbb{E}^*\big[\log W_K^*\big] - \log W_K, \]
em que a esperança \(\mathbb{E}^*\) é estimada pela média sobre \(B\) conjuntos de dados simulados da referência. Se há \(K\) grupos reais, \(\log W_K\) cai muito mais rápido que o esperado sob a referência, e o gap é grande. Com \(s_K\) o desvio padrão das simulações (corrigido por \(\sqrt{1 + 1/B}\)), a regra recomendada escolhe
\[ \hat K = \min\{K : \operatorname{Gap}(K) \geq \operatorname{Gap}(K+1) - s_{K+1}\}. \]
Uma vantagem importante da estatística gap é que ela pode indicar \(\hat K = 1\), isto é, ausência de estrutura de agrupamento — algo que o cotovelo e a silhueta (definida apenas para \(K \geq 2\)) não conseguem.
16.8.4 O Índice de Calinski–Harabasz
Inspirado na estatística \(F\) da ANOVA, o índice de Calinski e Harabasz (Caliński e Harabasz 1974) compara as somas de quadrados entre e intra grupos, cada uma dividida por seus “graus de liberdade”:
\[ CH(K) = \frac{SQ_{Entre}/(K - 1)}{SQ_{Intra}/(n - K)}. \]
Valores maiores indicam grupos mais compactos e mais separados; escolhe-se o \(K\) que maximiza \(CH\). O denominador \(n - K\) compensa a queda natural de \(SQ_{Intra}\) com \(K\), de forma análoga ao \(R^2\) ajustado. Como a silhueta, o índice só é definido para \(K \geq 2\), e, por depender da média, favorece grupos esféricos.
16.8.5 O Índice de Davies–Bouldin
O índice de Davies e Bouldin (Davies e Bouldin 1979) avalia, para cada grupo, o “pior vizinho”. Sejam \(S_k = \frac{1}{n_k}\sum_{i \in C_k}\|\mathbf{x}_i - \boldsymbol\mu_k\|\) a dispersão média do grupo \(k\) e \(M_{kl} = \|\boldsymbol\mu_k - \boldsymbol\mu_l\|\) a distância entre centroides. Definindo a similaridade \(R_{kl} = (S_k + S_l)/M_{kl}\),
\[ DB(K) = \frac{1}{K}\sum_{k=1}^K \max_{l \neq k} R_{kl}. \]
Valores menores são melhores (grupos pequenos e distantes); o mínimo teórico é 0.
Para a partição final \(C_1 = \{A, B, C\}\), \(C_2 = \{D, E, F\}\) (\(n = 6\), \(K = 2\)), já sabemos que \(SQ_{Intra} = 4\) e \(SQ_{Entre} = 44{,}17\). Logo
\[ CH = \frac{44{,}17/1}{4/4} = 44{,}17. \]
Para o DB, as distâncias (não ao quadrado) de cada ponto ao seu centroide são:
- Grupo 1, centroide \((4/3, 4/3)\): A: \(\sqrt{2/9} = 0{,}471\); B: \(\sqrt{5/9} = 0{,}745\); C: \(0{,}745\); logo \(S_1 = 0{,}654\).
- Grupo 2, centroide \((16/3, 5)\): D: \(\sqrt{10/9} = 1{,}054\); E: \(\sqrt{4/9} = 0{,}667\); F: \(1{,}054\); logo \(S_2 = 0{,}925\).
- \(M_{12} = \sqrt{(4)^2 + (11/3)^2} = \sqrt{29{,}44} = 5{,}426\).
Com apenas dois grupos, \(R_{12} = R_{21} = (0{,}654 + 0{,}925)/5{,}426 = 0{,}291\) e \(DB = 0{,}291\).
Comparando com outras partições (valores calculados com o scikit-learn):
| Partição | \(SQ_{Intra}\) | \(CH\) (\(\uparrow\)) | \(DB\) (\(\downarrow\)) | Silhueta média (\(\uparrow\)) |
|---|---|---|---|---|
| \(K = 2\): \(\{A,B,C\}\), \(\{D,E,F\}\) | 4,00 | 44,17 | 0,291 | 0,746 |
| \(K = 2\) ruim: \(\{A,C\}\), \(\{B,D,E,F\}\) | 23,50 | 4,20 | 0,597 | 0,379 |
| \(K = 3\) (ótimo) | 2,33 | 29,46 | 0,375 | 0,423 |
| \(K = 4\) (ótimo) | 1,33 | 23,42 | 0,127 | 0,374 |
O CH e a silhueta escolhem \(K = 2\). O DB, porém, prefere \(K = 4\), cuja solução ótima isola D, E e F em grupos unitários — e um grupo unitário tem \(S_k = 0\), o que reduz artificialmente o índice. Moral: nenhum índice interno é infalível; compare vários e inspecione as partições.
16.9 Validação Externa: Comparando Partições
Quando existe uma partição de referência \(\mathcal{U}\) (rótulos verdadeiros em dados simulados, ou uma classificação de especialistas), podemos medir a concordância com a partição obtida \(\mathcal{V}\). Como os rótulos dos grupos são arbitrários (o “grupo 1” de um método pode ser o “grupo 3” de outro), a acurácia comum não serve; usam-se medidas invariantes a permutações, calculadas a partir da tabela de contingência \(n_{ij} = |U_i \cap V_j|\), com totais marginais \(a_i = \sum_j n_{ij}\) e \(b_j = \sum_i n_{ij}\).
16.9.1 Índices de Rand e de Rand Ajustado
O índice de Rand (Rand 1971) considera os \(\binom{n}{2}\) pares de observações. Cada par pode estar junto ou separado em \(\mathcal{U}\) e em \(\mathcal{V}\); sejam \(a\) o número de pares juntos em ambas e \(d\) o número de pares separados em ambas. Então
\[ RI = \frac{a + d}{\binom{n}{2}} \in [0, 1]. \]
Seu defeito é que o valor esperado para duas partições aleatórias não é zero — costuma ser alto quando há muitos grupos, pois a maioria dos pares fica separada em ambas. O índice de Rand ajustado (ARI) de Hubert e Arabie (Hubert e Arabie 1985) corrige pelo acaso, sob o modelo hipergeométrico (partições aleatórias com os mesmos totais marginais):
\[ ARI = \frac{\sum_{ij}\binom{n_{ij}}{2} - \Big[\sum_i\binom{a_i}{2}\sum_j\binom{b_j}{2}\Big]\Big/\binom{n}{2}}{\frac{1}{2}\Big[\sum_i\binom{a_i}{2} + \sum_j\binom{b_j}{2}\Big] - \Big[\sum_i\binom{a_i}{2}\sum_j\binom{b_j}{2}\Big]\Big/\binom{n}{2}}, \]
que tem a forma (índice \(-\) esperado)/(máximo \(-\) esperado): vale 1 para concordância perfeita, tem esperança 0 sob partições aleatórias e pode ser negativo.
16.9.2 Informação Mútua Normalizada
Pela via da Teoria da Informação, tratamos os rótulos como variáveis aleatórias com distribuição conjunta \(\hat P(i, j) = n_{ij}/n\). A informação mútua
\[ I(\mathcal{U}, \mathcal{V}) = \sum_{i,j}\frac{n_{ij}}{n}\log\frac{n\,n_{ij}}{a_i\,b_j} \]
mede quanto conhecer o grupo em uma partição reduz a incerteza sobre o grupo na outra. Como \(0 \leq I \leq \min\{H(\mathcal{U}), H(\mathcal{V})\}\), em que \(H\) é a entropia, normaliza-se (Strehl e Ghosh 2002), por exemplo pela média aritmética (padrão do scikit-learn):
\[ NMI = \frac{I(\mathcal{U}, \mathcal{V})}{\big[H(\mathcal{U}) + H(\mathcal{V})\big]/2} \in [0, 1]. \]
Oito observações têm classes verdadeiras \(\mathcal{U} = (1,1,1,1,2,2,2,2)\), e um algoritmo produziu \(\mathcal{V} = (1,1,1,2,2,2,2,2)\) — apenas a quarta observação foi “mal agrupada”. A tabela de contingência é
| \(V_1\) | \(V_2\) | Total | |
|---|---|---|---|
| \(U_1\) | 3 | 1 | 4 |
| \(U_2\) | 0 | 4 | 4 |
| Total | 3 | 5 | 8 |
Rand. Há \(\binom{8}{2} = 28\) pares. Juntos em ambas: \(a = \binom{3}{2} + \binom{1}{2} + \binom{0}{2} + \binom{4}{2} = 3 + 0 + 0 + 6 = 9\). Juntos em \(\mathcal{U}\): \(\binom{4}{2} + \binom{4}{2} = 12\); juntos em \(\mathcal{V}\): \(\binom{3}{2} + \binom{5}{2} = 13\). Logo, pares juntos só em \(\mathcal{U}\): \(12 - 9 = 3\); juntos só em \(\mathcal{V}\): \(13 - 9 = 4\); separados em ambas: \(d = 28 - 9 - 3 - 4 = 12\). Então \(RI = (9 + 12)/28 = 0{,}75\).
ARI. O termo esperado é \(12 \times 13/28 = 5{,}571\), e
\[ ARI = \frac{9 - 5{,}571}{\frac{1}{2}(12 + 13) - 5{,}571} = \frac{3{,}429}{6{,}929} \approx 0{,}495. \]
NMI. \(H(\mathcal{U}) = \log 2 = 0{,}693\) e \(H(\mathcal{V}) = -\tfrac{3}{8}\log\tfrac{3}{8} - \tfrac{5}{8}\log\tfrac{5}{8} = 0{,}662\) (em nats). A informação mútua é
\[ I = \tfrac{3}{8}\log\tfrac{8 \cdot 3}{4 \cdot 3} + \tfrac{1}{8}\log\tfrac{8 \cdot 1}{4 \cdot 5} + \tfrac{4}{8}\log\tfrac{8 \cdot 4}{4 \cdot 5} = 0{,}260 - 0{,}115 + 0{,}235 = 0{,}380, \]
e \(NMI = 0{,}380/[(0{,}693 + 0{,}662)/2] \approx 0{,}562\).
Um único erro em oito pontos derruba o ARI para cerca de 0,5, enquanto o RI permanece em 0,75: o ARI é bem mais exigente, por descontar a concordância que ocorreria por acaso.
16.10 Limitações do K-Means
Apesar de simples e eficiente, o K-Means faz suposições implícitas que nem sempre se verificam:
- Grupos esféricos e de tamanho semelhante: por usar distância euclidiana ao centroide, a fronteira entre dois grupos é o hiperplano mediador entre os centroides (as regiões formam um diagrama de Voronoi). Grupos alongados, em forma de anel ou de “meia-lua” não são recuperados corretamente, e grupos de dispersões muito diferentes tendem a ser “cortados”.
- Sensibilidade à escala: variáveis com maior variância dominam o agrupamento (por isso padronizamos).
- Sensibilidade a outliers: a média não é robusta; um único ponto extremo pode deslocar um centroide ou até formar um grupo isolado.
- Necessidade de especificar \(K\) e dependência da inicialização (ótimos locais).
- Apenas variáveis numéricas: a média não faz sentido para variáveis categóricas (alternativas: K-modes, K-prototypes, ou K-medoids com distância de Gower).
- Agrupamento rígido: não há medida de incerteza da alocação (misturas gaussianas fornecem probabilidades de pertinência).
16.11 Agrupamento Baseado em Modelos: Misturas Gaussianas e o Algoritmo EM
O K-Means é um procedimento geométrico, sem modelo probabilístico explícito. A abordagem baseada em modelos (Fraley e Raftery 2002; McLachlan e Peel 2000) supõe que cada observação foi gerada por um de \(K\) componentes, e que o agrupamento consiste em descobrir de qual.
16.11.1 O Modelo de Mistura
Uma mistura gaussiana finita tem densidade
\[ f(\mathbf{x}) = \sum_{k=1}^K \pi_k\,\phi(\mathbf{x};\, \boldsymbol\mu_k, \boldsymbol\Sigma_k), \qquad \pi_k \geq 0, \quad \sum_{k=1}^K\pi_k = 1, \]
em que \(\phi(\cdot;\boldsymbol\mu, \boldsymbol\Sigma)\) é a densidade normal multivariada. Equivalentemente, há uma variável latente (não observada) \(Z_i \in \{1, \dots, K\}\) com \(P(Z_i = k) = \pi_k\) e \(\mathbf{X}_i \mid Z_i = k \sim N(\boldsymbol\mu_k, \boldsymbol\Sigma_k)\). Agrupar é inferir \(Z_i\) a partir de \(\mathbf{x}_i\), e o teorema de Bayes fornece a probabilidade a posteriori de pertinência (ou responsabilidade):
\[ \gamma_{ik} = P(Z_i = k \mid \mathbf{x}_i) = \frac{\pi_k\,\phi(\mathbf{x}_i;\boldsymbol\mu_k, \boldsymbol\Sigma_k)}{\sum_{l=1}^K \pi_l\,\phi(\mathbf{x}_i;\boldsymbol\mu_l, \boldsymbol\Sigma_l)}. \]
O resultado é um agrupamento suave: cada ponto tem um vetor de probabilidades, e a atribuição rígida, se desejada, é \(\arg\max_k\gamma_{ik}\). As matrizes \(\boldsymbol\Sigma_k\) permitem grupos elipsoidais, de orientações e volumes diferentes, superando uma das principais limitações do K-Means.
16.11.2 O Algoritmo EM
A log-verossimilhança \(\ell(\boldsymbol\theta) = \sum_{i=1}^n\log\sum_{k=1}^K\pi_k\,\phi(\mathbf{x}_i;\boldsymbol\mu_k, \boldsymbol\Sigma_k)\) tem um logaritmo de uma soma, sem solução fechada. O algoritmo EM (Expectation–Maximization) de Dempster, Laird e Rubin (Dempster, Laird, e Rubin 1977) contorna a dificuldade: se conhecêssemos os \(Z_i\), a verossimilhança “completa” seria fácil de maximizar (bastaria calcular médias e covariâncias por grupo). O EM alterna:
- Passo E: com os parâmetros correntes \(\boldsymbol\theta^{(t)}\), calcule as responsabilidades \(\gamma_{ik}^{(t)}\).
- Passo M: maximize a log-verossimilhança completa esperada \(Q(\boldsymbol\theta \mid \boldsymbol\theta^{(t)}) = \sum_i\sum_k\gamma_{ik}^{(t)}\big[\log\pi_k + \log\phi(\mathbf{x}_i;\boldsymbol\mu_k, \boldsymbol\Sigma_k)\big]\). Derivando (com um multiplicador de Lagrange para \(\sum_k\pi_k = 1\)) e definindo \(n_k = \sum_i\gamma_{ik}^{(t)}\) (o “tamanho efetivo” do grupo \(k\)): \[ \pi_k^{(t+1)} = \frac{n_k}{n}, \qquad \boldsymbol\mu_k^{(t+1)} = \frac{1}{n_k}\sum_{i=1}^n\gamma_{ik}^{(t)}\mathbf{x}_i, \qquad \boldsymbol\Sigma_k^{(t+1)} = \frac{1}{n_k}\sum_{i=1}^n\gamma_{ik}^{(t)}(\mathbf{x}_i - \boldsymbol\mu_k^{(t+1)})(\mathbf{x}_i - \boldsymbol\mu_k^{(t+1)})^\top. \] São as médias e covariâncias de cada grupo, ponderadas pelas responsabilidades.
Por que o EM funciona? Para qualquer distribuição \(q_i\) sobre \(\{1, \dots, K\}\), a desigualdade de Jensen (concavidade do log) dá
\[ \log\sum_k \pi_k\phi_k(\mathbf{x}_i) = \log\sum_k q_i(k)\,\frac{\pi_k\phi_k(\mathbf{x}_i)}{q_i(k)} \geq \sum_k q_i(k)\log\frac{\pi_k\phi_k(\mathbf{x}_i)}{q_i(k)}, \]
com igualdade quando \(q_i(k) = \gamma_{ik}\). O passo E escolhe \(q_i\) que torna a cota justa no ponto atual; o passo M maximiza a cota inferior. Logo \(\ell(\boldsymbol\theta^{(t+1)}) \geq \ell(\boldsymbol\theta^{(t)})\): a verossimilhança nunca diminui — o mesmo argumento de “otimização alternada” da convergência do K-Means. Como lá, o EM converge para um máximo local (ou ponto estacionário) e depende da inicialização; na prática, inicializa-se com o resultado do K-Means ou de um agrupamento hierárquico.
Se um componente se concentrar em um único ponto (\(\boldsymbol\mu_k = \mathbf{x}_i\) e \(\boldsymbol\Sigma_k \to \mathbf{0}\)), a densidade naquele ponto vai a infinito e \(\ell \to \infty\): a verossimilhança de misturas com covariâncias livres é ilimitada. O EM procura máximos locais “razoáveis”, e as implementações impõem um piso aos autovalores das covariâncias (por exemplo, reg_covar no scikit-learn) ou usam prioris (como no pacote mclust).
16.11.3 O K-Means como Caso Limite do EM
Suponha agora covariâncias esféricas e iguais e fixas, \(\boldsymbol\Sigma_k = \sigma^2\mathbf{I}\), e pesos iguais. As responsabilidades ficam
\[ \gamma_{ik} = \frac{\exp\big(-\|\mathbf{x}_i - \boldsymbol\mu_k\|^2/2\sigma^2\big)}{\sum_l\exp\big(-\|\mathbf{x}_i - \boldsymbol\mu_l\|^2/2\sigma^2\big)}. \]
Quando \(\sigma^2 \to 0\), o termo do centroide mais próximo domina todos os outros, e \(\gamma_{ik} \to 1\) se \(k\) é o centroide mais próximo de \(\mathbf{x}_i\) e \(\to 0\) caso contrário: o passo E vira o passo de atribuição do K-Means, e o passo M (média ponderada por pesos 0 ou 1) vira o passo de atualização. O K-Means é, portanto, um “EM rígido” (hard EM) para uma mistura de gaussianas esféricas de mesma variância — o que explica formalmente por que ele prefere grupos esféricos e de tamanhos parecidos.
Dados \(x = (1, 2, 3, 7, 8, 9)\), \(K = 2\), e valores iniciais \(\mu_1 = 1\), \(\mu_2 = 5\), \(\sigma_1^2 = \sigma_2^2 = 1\), \(\pi_1 = \pi_2 = 0{,}5\). Com variâncias e pesos iguais,
\[ \gamma_{i1} = \frac{1}{1 + \exp\big\{[(x_i - 1)^2 - (x_i - 5)^2]/2\big\}}. \]
Passo E.
| \(x_i\) | 1 | 2 | 3 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|
| \(\gamma_{i1}\) | \(1/(1+e^{-8}) = 0{,}9997\) | \(1/(1+e^{-4}) = 0{,}9820\) | \(1/(1+e^{0}) = 0{,}5\) | \(\approx 0\) | \(\approx 0\) | \(\approx 0\) |
O ponto \(x = 3\) está exatamente a meio caminho e é dividido igualmente entre os componentes.
Passo M. \(n_1 = 0{,}9997 + 0{,}9820 + 0{,}5 = 2{,}482\) e \(n_2 = 6 - n_1 = 3{,}518\). Então
\[ \mu_1 = \frac{0{,}9997 \cdot 1 + 0{,}9820 \cdot 2 + 0{,}5 \cdot 3}{2{,}482} = 1{,}799, \qquad \mu_2 = 7{,}258, \qquad \sigma_1^2 = 0{,}564, \qquad \sigma_2^2 = 3{,}760, \qquad \pi_1 = 0{,}414. \]
A log-verossimilhança sobe de \(-25{,}96\) para \(-13{,}07\). Prosseguindo, as iterações convergem para \(\mu_1 = 2\), \(\mu_2 = 8\), \(\sigma_1^2 = \sigma_2^2 = 2/3\) e \(\pi_1 = \pi_2 = 0{,}5\), com \(\ell = -11{,}456\) — que correspondem exatamente às médias e variâncias (com divisor \(n_k\)) dos grupos \(\{1,2,3\}\) e \(\{7,8,9\}\).
16.11.4 Escolha do Modelo e de \(K\) pelo BIC
Por ser um modelo probabilístico, a mistura permite escolher \(K\) — e a estrutura das covariâncias — com critérios de informação. O pacote mclust (Fraley e Raftery 2002) parametriza \(\boldsymbol\Sigma_k = \lambda_k\mathbf{D}_k\mathbf{A}_k\mathbf{D}_k^\top\) (volume \(\lambda_k\), forma \(\mathbf{A}_k\) e orientação \(\mathbf{D}_k\)), e cada componente pode ser igual (E) ou variável (V) entre grupos, gerando modelos como EII (esféricos de mesmo volume — o análogo do K-Means), VVV (totalmente livres) e intermediários. Para cada modelo e cada \(K\), calcula-se o BIC (no mclust, na convenção “quanto maior, melhor”, \(\operatorname{BIC} = 2\ell(\hat{\boldsymbol\theta}) - d\log n\)) e escolhe-se o melhor. Diferentemente da silhueta, a abordagem também permite comparar \(K = 1\) com \(K > 1\).
16.12 Alternativas ao K-Means
16.12.1 K-Medoids (PAM)
No K-Medoids, cada grupo é representado por um medoide — uma observação real do grupo — em vez da média. O algoritmo PAM (Partitioning Around Medoids) de Kaufman e Rousseeuw (Kaufman e Rousseeuw 1990) minimiza
\[ \sum_{k=1}^K\sum_{i \in C_k} d(\mathbf{x}_i, \mathbf{m}_k), \qquad \mathbf{m}_k \in \{\mathbf{x}_1, \dots, \mathbf{x}_n\}, \]
com \(d\) qualquer dissimilaridade (não necessariamente ao quadrado, nem euclidiana). Vantagens: maior robustez a outliers, possibilidade de usar dados categóricos ou mistos (por exemplo, com Gower) e centros interpretáveis (são observações reais). Desvantagem: custo computacional maior — cada iteração do PAM é \(O(K(n-K)^2)\) —, o que motivou variantes como o CLARA para grandes bases.
16.12.2 Agrupamento Hierárquico
O agrupamento hierárquico aglomerativo não exige fixar \(K\) previamente:
- Comece com \(n\) grupos, cada um com uma observação.
- Calcule a dissimilaridade entre todos os pares de grupos.
- Una os dois grupos mais próximos.
- Repita até restar um único grupo.
O resultado é um dendrograma, uma árvore em que a altura de cada junção indica a dissimilaridade em que os grupos foram unidos. Cortar o dendrograma em uma altura \(h\) produz uma partição; cortes diferentes dão números de grupos diferentes.
A dissimilaridade entre dois grupos \(G\) e \(H\) é definida pela ligação (linkage):
| Ligação | Definição de \(d(G, H)\) | Comportamento |
|---|---|---|
| Simples (single) | \(\min_{i \in G,\, j \in H} d(i, j)\) | Grupos alongados; sofre do “efeito encadeamento” (chaining) |
| Completa (complete) | \(\max_{i \in G,\, j \in H} d(i, j)\) | Grupos compactos de diâmetro semelhante |
| Média (average) | \(\frac{1}{\lvert G\rvert \lvert H\rvert}\sum_{i \in G}\sum_{j \in H} d(i, j)\) | Compromisso entre simples e completa |
| Ward | Aumento da WCSS ao unir \(G\) e \(H\): \(\frac{\lvert G\rvert\lvert H\rvert}{\lvert G\rvert + \lvert H\rvert}\|\bar{\mathbf{x}}_G - \bar{\mathbf{x}}_H\|^2\) | Grupos esféricos; objetivo análogo ao K-Means |
O método de Ward (Ward 1963) une, a cada passo, o par de grupos que causa o menor aumento da soma de quadrados intra-cluster — é, portanto, a versão hierárquica e gulosa do critério do K-Means (no R, use method = "ward.D2" em hclust com distâncias euclidianas). Uma prática comum é usar o resultado do Ward como inicialização do K-Means. Desvantagens do hierárquico: custo \(O(n^2)\) em memória (matriz de distâncias) e pelo menos \(O(n^2)\) em tempo, e o fato de que uniões feitas cedo nunca são desfeitas.
Com os pontos A, B e C do exemplo, a primeira união (distância 1) junta A com B ou A com C (empate). Suponha \(G = \{A, B\}\) e considere \(H = \{C\}\): \(d(A,C) = 1\) e \(d(B,C) = \sqrt{2} \approx 1{,}414\). Pela ligação simples, \(d(G,H) = 1\); pela completa, \(d(G,H) = 1{,}414\); pela média, \(d(G,H) \approx 1{,}207\).
A fórmula de Lance–Williams. Na implementação, não se recalculam as dissimilaridades a partir dos pontos a cada união. Lance e Williams (Lance e Williams 1967) mostraram que, para as ligações usuais, a dissimilaridade entre um grupo \(k\) e o grupo recém-formado \(i \cup j\) pode ser atualizada apenas a partir das dissimilaridades já conhecidas:
\[ d(k, i \cup j) = \alpha_i\,d(k, i) + \alpha_j\,d(k, j) + \beta\,d(i, j) + \gamma\,\big|d(k, i) - d(k, j)\big|. \]
| Ligação | \(\alpha_i\) | \(\beta\) | \(\gamma\) |
|---|---|---|---|
| Simples | \(1/2\) | 0 | \(-1/2\) |
| Completa | \(1/2\) | 0 | \(1/2\) |
| Média (UPGMA) | \(\dfrac{n_i}{n_i + n_j}\) | 0 | 0 |
| Ward (sobre \(d^2\)) | \(\dfrac{n_i + n_k}{n_i + n_j + n_k}\) | \(\dfrac{-n_k}{n_i + n_j + n_k}\) | 0 |
Para a ligação simples, por exemplo, \(\frac{1}{2}(a + b) - \frac{1}{2}|a - b| = \min\{a, b\}\), e para a completa, \(\frac{1}{2}(a + b) + \frac{1}{2}|a - b| = \max\{a, b\}\). A fórmula permite um algoritmo genérico que, a cada passo, só atualiza uma linha da matriz de dissimilaridades.
Derivação do critério de Ward. Sejam \(G\) e \(H\) dois grupos com médias \(\bar{\mathbf{x}}_G\), \(\bar{\mathbf{x}}_H\) e a média da união \(\bar{\mathbf{x}}_{GH} = (n_G\bar{\mathbf{x}}_G + n_H\bar{\mathbf{x}}_H)/(n_G + n_H)\). Aplicando o lema da média a cada parte da união,
\[ SQ(G \cup H) = SQ(G) + n_G\|\bar{\mathbf{x}}_G - \bar{\mathbf{x}}_{GH}\|^2 + SQ(H) + n_H\|\bar{\mathbf{x}}_H - \bar{\mathbf{x}}_{GH}\|^2. \]
Como \(\bar{\mathbf{x}}_G - \bar{\mathbf{x}}_{GH} = \frac{n_H}{n_G + n_H}(\bar{\mathbf{x}}_G - \bar{\mathbf{x}}_H)\) e \(\bar{\mathbf{x}}_H - \bar{\mathbf{x}}_{GH} = \frac{n_G}{n_G + n_H}(\bar{\mathbf{x}}_H - \bar{\mathbf{x}}_G)\), o aumento da soma de quadrados é
\[ \Delta(G, H) = SQ(G \cup H) - SQ(G) - SQ(H) = \frac{n_G n_H^2 + n_H n_G^2}{(n_G + n_H)^2}\,\|\bar{\mathbf{x}}_G - \bar{\mathbf{x}}_H\|^2 = \frac{n_G\,n_H}{n_G + n_H}\,\|\bar{\mathbf{x}}_G - \bar{\mathbf{x}}_H\|^2, \]
a expressão que aparece na tabela de ligações. Note o fator \(n_G n_H/(n_G + n_H)\): unir grupos grandes é “caro”, o que faz o Ward produzir grupos de tamanhos equilibrados. (No R, hclust(..., method = "ward.D2") e, no Python, scipy.cluster.hierarchy.linkage(..., method = "ward") reportam como altura de cada união \(\sqrt{2\Delta}\).)
Monotonicidade e ultramétricas. Para as ligações simples, completa, média e de Ward, as alturas das uniões são não decrescentes ao longo do algoritmo. Isso permite definir a distância cofenética \(c(i, j)\) como a altura em que \(i\) e \(j\) são unidos pela primeira vez no dendrograma. Ela satisfaz a desigualdade ultramétrica
\[ c(i, j) \leq \max\{c(i, k),\, c(k, j)\} \quad \text{para todos } i, j, k, \]
mais forte que a desigualdade triangular: em qualquer trio de pontos, as duas maiores distâncias cofenéticas são iguais. Um dendrograma é exatamente uma ultramétrica, e o agrupamento hierárquico pode ser visto como a busca de uma ultramétrica próxima das dissimilaridades originais. (A ligação pelo centroide não é monótona e pode produzir inversões no dendrograma.)
A qualidade dessa aproximação é medida pela correlação cofenética (Sokal e Rohlf 1962), a correlação de Pearson entre os \(\binom{n}{2}\) pares \(\big(d(i,j), c(i,j)\big)\). Valores próximos de 1 indicam que o dendrograma preserva bem as dissimilaridades originais.
As distâncias euclidianas entre os pontos do exemplo são:
| A | B | C | D | E | F | |
|---|---|---|---|---|---|---|
| A | 0 | 1 | 1 | 5 | 6,403 | 6,403 |
| B | 0 | 1,414 | 4,243 | 5,657 | 5,831 | |
| C | 0 | 4,472 | 5,831 | 5,657 | ||
| D | 0 | 1,414 | 2 | |||
| E | 0 | 1,414 | ||||
| F | 0 |
Ligação simples. (1) Une A e B em altura 1 (empate com A–C). (2) \(d(C, \{A,B\}) = \min\{1;\, 1{,}414\} = 1\): C entra em altura 1. (3) D e E unem-se em 1,414. (4) \(d(F, \{D,E\}) = \min\{2;\, 1{,}414\} = 1{,}414\). (5) Os dois grupos unem-se na menor distância entre eles, \(d(B, D) = 4{,}243\).
Ligação completa. As alturas são \(1\) (A–B), \(1{,}414\) (C entra, pois \(\max\{1;\, 1{,}414\}\)), \(1{,}414\) (D–E), \(2\) (F entra) e \(6{,}403\) (a maior distância entre os grupos, \(d(A,E) = d(A,F)\)).
Ward. As alturas reportadas pelo software são \(1\); \(1{,}291\); \(1{,}414\); \(1{,}826\); \(9{,}399\). Por exemplo, ao unir \(\{A,B\}\) (média \((1{,}5;\, 1)\)) com C: \(\Delta = \frac{2 \cdot 1}{3}\big[(0{,}5)^2 + 1^2\big] = 0{,}833\) e \(\sqrt{2 \times 0{,}833} = 1{,}291\). Na última união, \(\Delta = \frac{3 \cdot 3}{6}\times 29{,}44 = 44{,}17\) — exatamente a \(SQ_{Entre}\) da solução do K-Means com \(K = 2\), como deveria ser.
Nos três casos, o corte em dois grupos fornece \(\{A,B,C\}\) e \(\{D,E,F\}\). As correlações cofenéticas ficam todas em torno de 0,96 (de 0,9607 na ligação simples a 0,9615 na média): com grupos tão bem separados, todas as ligações representam bem os dados.
16.12.3 DBSCAN
O DBSCAN (Density-Based Spatial Clustering of Applications with Noise) (Ester et al. 1996) define grupos como regiões densas. Com dois parâmetros, o raio \(\varepsilon\) e o número mínimo de pontos minPts:
- Um ponto central (core point) tem pelo menos
minPtspontos (incluindo ele mesmo) em sua vizinhança de raio \(\varepsilon\). - Um ponto de borda não é central, mas está na vizinhança de um ponto central.
- Um ruído (noise) não é central nem de borda.
Grupos são formados pelos pontos centrais mutuamente alcançáveis por cadeias de vizinhanças, mais seus pontos de borda.
Definições formais. Seja \(N_\varepsilon(\mathbf{p}) = \{\mathbf{q} : d(\mathbf{p}, \mathbf{q}) \leq \varepsilon\}\) a \(\varepsilon\)-vizinhança de \(\mathbf{p}\) (que inclui o próprio \(\mathbf{p}\)), e \(\mathbf{p}\) é central se \(|N_\varepsilon(\mathbf{p})| \geq \texttt{minPts}\).
- \(\mathbf{q}\) é diretamente alcançável por densidade a partir de \(\mathbf{p}\) se \(\mathbf{p}\) é central e \(\mathbf{q} \in N_\varepsilon(\mathbf{p})\).
- \(\mathbf{q}\) é alcançável por densidade a partir de \(\mathbf{p}\) se existe uma cadeia \(\mathbf{p} = \mathbf{p}_1, \mathbf{p}_2, \dots, \mathbf{p}_m = \mathbf{q}\) em que cada \(\mathbf{p}_{r+1}\) é diretamente alcançável a partir de \(\mathbf{p}_r\). (Todos os elos, exceto possivelmente o último, são centrais. A relação não é simétrica: um ponto de borda é alcançável a partir de um central, mas não o contrário.)
- \(\mathbf{p}\) e \(\mathbf{q}\) são conectados por densidade se existe um ponto \(\mathbf{o}\) a partir do qual ambos são alcançáveis por densidade. Essa relação é simétrica.
- Um grupo é um conjunto não vazio \(C\) que é (i) maximal — se \(\mathbf{p} \in C\) e \(\mathbf{q}\) é alcançável por densidade a partir de \(\mathbf{p}\), então \(\mathbf{q} \in C\) — e (ii) conexo — quaisquer dois pontos de \(C\) são conectados por densidade. Os pontos que não pertencem a nenhum grupo são ruído.
Restritos aos pontos centrais, os grupos são exatamente as componentes conexas do grafo que liga pontos centrais a menos de \(\varepsilon\) um do outro; os pontos de borda são então anexados. Os grupos formados por pontos centrais são determinísticos, mas um ponto de borda alcançável a partir de dois grupos é atribuído ao primeiro que o encontrar, de modo que a ordem dos dados pode alterar a atribuição de pontos de borda. Com um índice espacial, o custo é da ordem de \(O(n\log n)\) em baixa dimensão; no pior caso, \(O(n^2)\).
Considere os pontos \(x = \{1, 2, 3, 4, 7, 8, 9, 15\}\), com \(\varepsilon = 1\) e \(\texttt{minPts} = 3\).
| Ponto | \(N_\varepsilon\) | \(\lvert N_\varepsilon\rvert\) | Tipo |
|---|---|---|---|
| 1 | {1, 2} | 2 | borda (vizinho de 2) |
| 2 | {1, 2, 3} | 3 | central |
| 3 | {2, 3, 4} | 3 | central |
| 4 | {3, 4} | 2 | borda (vizinho de 3) |
| 7 | {7, 8} | 2 | borda (vizinho de 8) |
| 8 | {7, 8, 9} | 3 | central |
| 9 | {8, 9} | 2 | borda (vizinho de 8) |
| 15 | {15} | 1 | ruído |
Os pontos centrais 2 e 3 são vizinhos e formam o grupo \(\{1, 2, 3, 4\}\) (com as bordas 1 e 4); o central 8 forma o grupo \(\{7, 8, 9\}\); o ponto 15 é ruído. Note que 1 é alcançável a partir de 2, mas 2 não é alcançável a partir de 1, pois 1 não é central.
Aumentando para \(\varepsilon = 3\), todos os pontos de 1 a 9 tornam-se centrais e, como \(|7 - 4| = 3 \leq \varepsilon\), os dois grupos fundem-se em um só; 15 continua ruído. A escolha de \(\varepsilon\) é decisiva.
Vantagens: não exige \(K\), encontra grupos de formas arbitrárias (anéis, meias-luas) e identifica outliers como ruído. Limitações: dificuldade quando os grupos têm densidades muito diferentes e sensibilidade à escolha de \(\varepsilon\) (uma heurística é o gráfico das distâncias ao \(k\)-ésimo vizinho mais próximo, procurando um “joelho”).
| Critério | K-Means | K-Medoids | Hierárquico | DBSCAN |
|---|---|---|---|---|
| Precisa de \(K\)? | Sim | Sim | Não (corte) | Não |
| Formas não convexas | Não | Não | Com ligação simples | Sim |
| Robusto a outliers | Não | Sim | Depende | Sim (ruído) |
| Qualquer dissimilaridade | Não | Sim | Sim | Sim |
| Escalabilidade | Excelente | Moderada | Baixa | Boa |
O problema das densidades heterogêneas motivou extensões hierárquicas do DBSCAN, como o OPTICS e o HDBSCAN (Campello, Moulavi, e Sander 2013), que essencialmente consideram todos os valores de \(\varepsilon\) simultaneamente, constroem uma hierarquia de grupos por densidade e extraem os grupos mais “persistentes”, exigindo apenas o tamanho mínimo de grupo como parâmetro principal.
16.13 Agrupamento em Alta Dimensão: PCA antes do K-Means
Em alta dimensão, as distâncias euclidianas tornam-se pouco informativas (a maldição da dimensionalidade, vista no Capítulo de k-NN): muitas variáveis irrelevantes ou ruidosas “diluem” a estrutura de grupos. Uma prática comum é projetar os dados padronizados nas primeiras \(q\) componentes principais e agrupar no espaço reduzido. Os benefícios são remover ruído (as últimas componentes costumam capturar variação aleatória), reduzir o custo e permitir visualizar os grupos em duas dimensões — é o que faz a função fviz_cluster do pacote factoextra.
Há uma conexão teórica profunda entre os dois métodos. Codifique uma partição em \(K\) grupos pela matriz \(\mathbf{G}\) (\(n \times K\)) com \(G_{ik} = 1/\sqrt{n_k}\) se \(i \in C_k\) e 0 caso contrário; suas colunas são ortonormais. Para dados centrados \(\mathbf{X}\), pode-se mostrar que
\[ J = \operatorname{tr}(\mathbf{X}^\top\mathbf{X}) - \operatorname{tr}\big(\mathbf{G}^\top\mathbf{X}\mathbf{X}^\top\mathbf{G}\big), \]
de modo que minimizar \(J\) equivale a maximizar \(\operatorname{tr}(\mathbf{G}^\top\mathbf{X}\mathbf{X}^\top\mathbf{G})\) sobre matrizes de pertinência. Se relaxarmos a restrição e permitirmos qualquer \(\mathbf{G}\) com colunas ortonormais, o teorema de Ky Fan garante que o máximo é atingido pelos autovetores principais de \(\mathbf{X}\mathbf{X}^\top\) — isto é, pelos escores das componentes principais. Ding e He (Ding e He 2004) exploraram esse fato: a solução contínua do K-Means “vive” no subespaço das \(K - 1\) primeiras componentes principais (o \(K\)-ésimo autovetor relaxado é absorvido pela centralização), o que justifica projetar os dados nesse subespaço antes de agrupar. Cuidado, porém: a PCA preserva direções de maior variância, que nem sempre são as que separam os grupos; um grupo pequeno, mas bem separado, pode ficar escondido em uma componente de baixa variância.
16.14 Kernel K-Means e Agrupamento Espectral
16.14.1 Kernel K-Means
Como no SVM, podemos aplicar o K-Means em um espaço de atributos \(\varphi(\mathbf{x})\) de alta dimensão, onde grupos não convexos (como anéis concêntricos) podem tornar-se linearmente separáveis. O centroide do grupo \(C_k\) no espaço de atributos é \(\mathbf{m}_k = \frac{1}{n_k}\sum_{j \in C_k}\varphi(\mathbf{x}_j)\), que não precisa ser calculado explicitamente: com o kernel \(\kappa(\mathbf{x}, \mathbf{z}) = \varphi(\mathbf{x})^\top\varphi(\mathbf{z})\), expandindo o quadrado,
\[ \|\varphi(\mathbf{x}_i) - \mathbf{m}_k\|^2 = \kappa(\mathbf{x}_i, \mathbf{x}_i) - \frac{2}{n_k}\sum_{j \in C_k}\kappa(\mathbf{x}_i, \mathbf{x}_j) + \frac{1}{n_k^2}\sum_{j \in C_k}\sum_{l \in C_k}\kappa(\mathbf{x}_j, \mathbf{x}_l). \]
O passo de atribuição usa apenas a matriz de kernel, e o passo de atualização fica implícito. O custo é \(O(n^2)\) por iteração, e o método herda as dificuldades de escolha do kernel e de seus parâmetros.
16.14.2 Agrupamento Espectral
O agrupamento espectral (Luxburg 2007) parte de um grafo de similaridade: cada observação é um vértice, e o peso da aresta entre \(i\) e \(j\) é uma similaridade como \(w_{ij} = \exp(-\|\mathbf{x}_i - \mathbf{x}_j\|^2/2s^2)\) (eventualmente restrita aos \(k\) vizinhos mais próximos). Com a matriz de pesos \(\mathbf{W}\) e a matriz diagonal de graus \(\mathbf{D} = \operatorname{diag}(d_1, \dots, d_n)\), \(d_i = \sum_j w_{ij}\), define-se a matriz laplaciana \(\mathbf{L} = \mathbf{D} - \mathbf{W}\). Sua propriedade-chave é
\[ \mathbf{f}^\top\mathbf{L}\mathbf{f} = \frac{1}{2}\sum_{i,j} w_{ij}\,(f_i - f_j)^2 \geq 0 \quad \text{para todo } \mathbf{f} \in \mathbb{R}^n. \]
Logo \(\mathbf{L}\) é positiva semidefinida, e um vetor \(\mathbf{f}\) com \(\mathbf{f}^\top\mathbf{L}\mathbf{f}\) pequeno varia pouco entre vértices fortemente ligados. Se o grafo tem \(K\) componentes conexas, o autovalor 0 tem multiplicidade \(K\), e os autovetores correspondentes são as indicadoras das componentes. Quando os grupos são “quase” desconectados, os \(K\) primeiros autovetores são aproximadamente indicadoras, e é fácil separá-los. O algoritmo típico (na versão normalizada de Ng, Jordan e Weiss (Ng, Jordan, e Weiss 2002)) é:
- Construa \(\mathbf{W}\) e calcule \(\mathbf{L}_{sym} = \mathbf{I} - \mathbf{D}^{-1/2}\mathbf{W}\mathbf{D}^{-1/2}\).
- Obtenha os \(K\) autovetores de \(\mathbf{L}_{sym}\) associados aos menores autovalores e empilhe-os nas colunas de \(\mathbf{U}\) (\(n \times K\)).
- Normalize cada linha de \(\mathbf{U}\) para ter norma 1.
- Aplique o K-Means às linhas de \(\mathbf{U}\) e atribua a observação \(i\) ao grupo da linha \(i\).
O método é uma relaxação contínua do problema de cortar o grafo em \(K\) partes com o menor peso de arestas cortadas, normalizado pelo tamanho das partes (o corte normalizado). Ele recupera grupos de formas arbitrárias, como as meias-luas e os anéis, desde que o grafo de similaridade os conecte bem. Dhillon, Guan e Kulis (Dhillon, Guan, e Kulis 2004) mostraram que o kernel K-Means ponderado e o corte normalizado otimizam o mesmo objetivo, unificando as duas abordagens.
16.15 Estabilidade dos Agrupamentos
Um algoritmo de agrupamento sempre devolve grupos, mesmo em dados sem estrutura alguma. Uma forma de distinguir grupos “reais” de artefatos é avaliar sua estabilidade: grupos reais devem reaparecer quando os dados são ligeiramente perturbados. Um procedimento comum (Hennig 2007) é:
- Agrupe os dados originais, obtendo os grupos \(C_1, \dots, C_K\).
- Para \(b = 1, \dots, B\), sorteie uma amostra bootstrap (ou uma subamostra), agrupe-a com o mesmo método e, para cada grupo original \(C_k\), encontre o grupo da reamostra mais parecido segundo o coeficiente de Jaccard \(\gamma(C, D) = |C \cap D|/|C \cup D|\) (calculado apenas sobre os pontos presentes na reamostra).
- A estabilidade de \(C_k\) é a média dos \(B\) valores máximos de Jaccard.
Como regra prática (sugerida na documentação da função clusterboot do pacote fpc), grupos com média de Jaccard abaixo de 0,6 não devem ser considerados confiáveis; entre 0,6 e 0,75 indicam algum padrão, mas com pertinência duvidosa dos pontos; a partir de 0,75 são considerados válidos e estáveis, e acima de 0,85, altamente estáveis. A mesma ideia permite escolher \(K\): prefere-se o número de grupos cujas soluções são mais reprodutíveis entre reamostras, medindo a concordância, por exemplo, pelo ARI. Estabilidade, contudo, não é sinônimo de validade: um algoritmo que sempre corta os dados ao meio ao longo da maior variância é muito estável, mesmo que não haja grupos.
16.16 Implementação Prática em R
# install.packages(c("cluster", "factoextra", "dbscan"))
library(cluster)
library(factoextra)

# Taxas de crimes violentos por 100 mil habitantes nos 50 estados dos EUA (1973)
data(USArrests)
dados <- scale(USArrests)        # padronização: média 0, desvio 1

# 1. K-Means com múltiplos inícios
set.seed(123)
km <- kmeans(dados, centers = 4, nstart = 25, iter.max = 50)
km$size                          # tamanho de cada grupo
km$centers                       # centroides (na escala padronizada)
km$tot.withinss                  # WCSS (SQ intra)
km$betweenss / km$totss          # proporção SQ entre / SQ total

# Verificação da decomposição SQ total = SQ intra + SQ entre
all.equal(km$totss, km$tot.withinss + km$betweenss)   #> TRUE

# 2. Escolha de K: cotovelo, silhueta e estatística gap
fviz_nbclust(dados, kmeans, method = "wss", nstart = 25)        # cotovelo
fviz_nbclust(dados, kmeans, method = "silhouette", nstart = 25) # silhueta
gap <- clusGap(dados, FUN = kmeans, nstart = 25, K.max = 10, B = 100)
print(gap, method = "Tibs2001SEmax")                            # regra do 1-EP
fviz_gap_stat(gap)

# 3. Visualização dos grupos (projeção nas duas primeiras componentes principais)
fviz_cluster(km, data = dados, ellipse.type = "convex", repel = TRUE)

# 4. Gráfico de silhuetas
sil <- silhouette(km$cluster, dist(dados))
summary(sil)$avg.width           # silhueta média
fviz_silhouette(sil)

# 5. Médias dos grupos na escala original (para interpretação)
aggregate(USArrests, by = list(grupo = km$cluster), FUN = mean)
Alternativas ao K-Means no R:
# K-Medoids (PAM)
pam_res <- pam(dados, k = 4)
pam_res$medoids                  # observações reais que representam os grupos
fviz_cluster(pam_res)

# Agrupamento hierárquico com diferentes ligações
d <- dist(dados, method = "euclidean")
hc_ward   <- hclust(d, method = "ward.D2")
hc_single <- hclust(d, method = "single")
hc_comp   <- hclust(d, method = "complete")
hc_avg    <- hclust(d, method = "average")

plot(hc_ward, cex = 0.6, main = "Dendrograma - ligação de Ward")
rect.hclust(hc_ward, k = 4, border = 2:5)
grupos_hc <- cutree(hc_ward, k = 4)
table(KMeans = km$cluster, Ward = grupos_hc)   # comparação das partições

# DBSCAN em dados com formato não convexo
library(dbscan)
set.seed(1)
t  <- runif(300, 0, 2 * pi)
r  <- c(rep(1, 150), rep(3, 150)) + rnorm(300, 0, 0.15)
aneis <- cbind(r * cos(t), r * sin(t))         # dois anéis concêntricos

kNNdistplot(aneis, k = 5); abline(h = 0.4, lty = 2)   # ajuda a escolher eps
db <- dbscan(aneis, eps = 0.4, minPts = 5)
table(db$cluster)                # grupo 0 = ruído
km_aneis <- kmeans(aneis, centers = 2, nstart = 25)
par(mfrow = c(1, 2))
plot(aneis, col = km_aneis$cluster, pch = 19, main = "K-Means")
plot(aneis, col = db$cluster + 1, pch = 19, main = "DBSCAN")
par(mfrow = c(1, 1))
Índices internos, validação externa, misturas gaussianas e estabilidade no R:
# install.packages(c("mclust", "fpc"))
library(cluster)
library(mclust)

# Exemplo dos seis pontos: CH, DB e silhueta "à mão"
P  <- matrix(c(1,1, 2,1, 1,2, 5,4, 6,5, 5,6), ncol = 2, byrow = TRUE)
km <- kmeans(P, centers = 2, nstart = 25)
n <- nrow(P); K <- 2
CH <- (km$betweenss / (K - 1)) / (km$tot.withinss / (n - K))
CH                                                  #> 44.17
S  <- sapply(1:K, function(k) {
  Pk <- P[km$cluster == k, , drop = FALSE]
  mean(sqrt(rowSums(sweep(Pk, 2, km$centers[k, ])^2)))
})
M  <- as.matrix(dist(km$centers))
R  <- outer(S, S, "+") / M; diag(R) <- 0
mean(apply(R, 1, max))                              #> DB = 0.291
summary(silhouette(km$cluster, dist(P)))$avg.width  #> 0.746

# Dendrogramas e correlação cofenética
for (m in c("single", "complete", "average", "ward.D2")) {
  h <- hclust(dist(P), method = m)
  cat(m, round(h$height, 3), " coph =", round(cor(cophenetic(h), dist(P)), 4), "\n")
}

# Validação externa: Rand ajustado (exemplo do texto)
U <- c(1, 1, 1, 1, 2, 2, 2, 2); V <- c(1, 1, 1, 2, 2, 2, 2, 2)
table(U, V)
adjustedRandIndex(U, V)                             #> 0.495

# Misturas gaussianas com mclust: escolha do modelo e de K pelo BIC
dados <- scale(iris[, 1:4])
mc <- Mclust(dados, G = 1:6)
summary(mc)                     # o BIC escolhe o modelo VVV com K = 2:
                                # versicolor e virginica ficam juntas
plot(mc, what = "BIC")                              # BIC por modelo e K
head(round(mc$z, 3))                                # responsabilidades gamma_ik
table(Especie = iris$Species, Grupo = mc$classification)
adjustedRandIndex(iris$Species, mc$classification)  #> 0.568
mc3 <- Mclust(dados, G = 3)                         # fixando K = 3
adjustedRandIndex(iris$Species, mc3$classification) #> 0.904

# Comparação com o K-Means (K = 3) pelo ARI
set.seed(1)
km_iris <- kmeans(dados, centers = 3, nstart = 25)
adjustedRandIndex(iris$Species, km_iris$cluster)    #> 0.620

# Estabilidade por bootstrap (Jaccard), implementação simples
jaccard <- function(a, b) length(intersect(a, b)) / length(union(a, b))
estab <- matrix(NA, 100, 3)
for (b in 1:100) {
  idx <- sample(nrow(dados), replace = TRUE)
  kb  <- kmeans(dados[idx, ], centers = 3, nstart = 10)
  for (k in 1:3) {
    orig <- intersect(which(km_iris$cluster == k), idx)
    estab[b, k] <- max(sapply(1:3, function(l) jaccard(orig, unique(idx[kb$cluster == l]))))
  }
}
colMeans(estab)                                     # Jaccard médio por grupo
# Alternativa pronta: fpc::clusterboot(dados, B = 100, clustermethod = fpc::kmeansCBI, k = 3)
16.17 Implementação Prática em Python
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs, make_moons
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans, AgglomerativeClustering, DBSCAN
from sklearn.metrics import silhouette_score, silhouette_samples

# Exemplo resolvido no texto: confere a solução final e a WCSS
P = np.array([[1, 1], [2, 1], [1, 2], [5, 4], [6, 5], [5, 6]])
km_ex = KMeans(n_clusters=2, init=np.array([[1, 1], [2, 1]]), n_init=1).fit(P)
print(km_ex.labels_)            #> [0 0 0 1 1 1]
print(km_ex.cluster_centers_)   #> [[1.333 1.333] [5.333 5.   ]]
print(km_ex.inertia_)           #> 4.0
print(km_ex.n_iter_)            # número de iterações até convergir

# Dados simulados com 4 grupos
X, y_real = make_blobs(n_samples=500, centers=4, cluster_std=1.0, random_state=42)
X = StandardScaler().fit_transform(X)

# Cotovelo e silhueta para K = 2, ..., 10
Ks = range(2, 11)
inercias, silhuetas = [], []
for k in Ks:
    km = KMeans(n_clusters=k, init="k-means++", n_init=10, random_state=0).fit(X)
    inercias.append(km.inertia_)
    silhuetas.append(silhouette_score(X, km.labels_))

fig, ax = plt.subplots(1, 2, figsize=(10, 4))
ax[0].plot(Ks, inercias, "o-"); ax[0].set(xlabel="K", ylabel="WCSS (inércia)",
                                          title="Método do cotovelo")
ax[1].plot(Ks, silhuetas, "o-"); ax[1].set(xlabel="K", ylabel="Silhueta média",
                                           title="Método da silhueta")
plt.tight_layout(); plt.show()

k_otimo = Ks[int(np.argmax(silhuetas))]
print("K escolhido pela silhueta:", k_otimo)

# Ajuste final e decomposição SQ total = SQ intra + SQ entre
km = KMeans(n_clusters=k_otimo, n_init=10, random_state=0).fit(X)
sq_total = ((X - X.mean(axis=0)) ** 2).sum()
sq_intra = km.inertia_
sq_entre = sum((km.labels_ == k).sum() * ((c - X.mean(axis=0)) ** 2).sum()
               for k, c in enumerate(km.cluster_centers_))
print(f"SQ total = {sq_total:.2f}; intra + entre = {sq_intra + sq_entre:.2f}")

# Silhueta individual: pontos com s(i) < 0 podem estar mal alocados
s_i = silhouette_samples(X, km.labels_)
print("Pontos com silhueta negativa:", (s_i < 0).sum())
Comparação com alternativas em dados não convexos:
from scipy.cluster.hierarchy import linkage, dendrogram

Xm, _ = make_moons(n_samples=400, noise=0.06, random_state=0)
Xm = StandardScaler().fit_transform(Xm)

modelos = {
    "K-Means":          KMeans(n_clusters=2, n_init=10, random_state=0),
    "Ward":             AgglomerativeClustering(n_clusters=2, linkage="ward"),
    "Ligação simples":  AgglomerativeClustering(n_clusters=2, linkage="single"),
    "DBSCAN":           DBSCAN(eps=0.3, min_samples=5),
}

fig, ax = plt.subplots(1, 4, figsize=(16, 4))
for a, (nome, m) in zip(ax, modelos.items()):
    rot = m.fit_predict(Xm)
    a.scatter(Xm[:, 0], Xm[:, 1], c=rot, s=10, cmap="viridis")
    a.set_title(nome)
plt.tight_layout(); plt.show()
# Espera-se: K-Means e Ward cortam as meias-luas ao meio;
# ligação simples e DBSCAN recuperam as duas formas.

# Dendrograma (ligação de Ward) para uma amostra dos dados
Z = linkage(Xm[:60], method="ward")
plt.figure(figsize=(10, 4)); dendrogram(Z); plt.title("Dendrograma - Ward"); plt.show()
Índices internos e externos, misturas gaussianas, PCA, mini-batch e agrupamento espectral:
import numpy as np
from sklearn.datasets import load_iris, make_moons, make_circles
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.cluster import KMeans, MiniBatchKMeans, SpectralClustering, DBSCAN
from sklearn.mixture import GaussianMixture
from sklearn.metrics import (calinski_harabasz_score, davies_bouldin_score,
                             silhouette_score, adjusted_rand_score, rand_score,
                             normalized_mutual_info_score)

# Índices internos no exemplo dos seis pontos
P = np.array([[1, 1], [2, 1], [1, 2], [5, 4], [6, 5], [5, 6]])
rot = np.array([0, 0, 0, 1, 1, 1])
print(calinski_harabasz_score(P, rot))   #> 44.17
print(davies_bouldin_score(P, rot))      #> 0.291
print(silhouette_score(P, rot))          #> 0.746

# Validação externa: exemplo do texto
U = [1, 1, 1, 1, 2, 2, 2, 2]; V = [1, 1, 1, 2, 2, 2, 2, 2]
print(rand_score(U, V), adjusted_rand_score(U, V),
      normalized_mutual_info_score(U, V))           #> 0.75 0.495 0.562

# DBSCAN do exemplo em uma dimensão
x1 = np.array([1, 2, 3, 4, 7, 8, 9, 15]).reshape(-1, 1)
db = DBSCAN(eps=1, min_samples=3).fit(x1)
print(db.labels_, db.core_sample_indices_)  #> [0 0 0 0 1 1 1 -1] [1 2 5]

# Mistura gaussiana: escolha de K e do tipo de covariância pelo BIC
X, y = load_iris(return_X_y=True)
X = StandardScaler().fit_transform(X)
bics = {}
for cov in ["spherical", "diag", "full"]:
    for k in range(1, 7):
        gm = GaussianMixture(k, covariance_type=cov, n_init=5, random_state=0).fit(X)
        bics[(cov, k)] = gm.bic(X)        # no sklearn, quanto MENOR, melhor
melhor = min(bics, key=bics.get)
print("Melhor (covariância, K) pelo BIC:", melhor)   #> ('full', 2), como no mclust

gm3 = GaussianMixture(3, covariance_type="full", n_init=5, random_state=0).fit(X)
gamma = gm3.predict_proba(X)              # responsabilidades gamma_ik
print("Pontos com pertinência incerta (max gamma < 0,9):", (gamma.max(1) < 0.9).sum())
km3 = KMeans(3, n_init=25, random_state=0).fit(X)
print("ARI GMM:", round(adjusted_rand_score(y, gm3.predict(X)), 3),
      " ARI K-Means:", round(adjusted_rand_score(y, km3.labels_), 3))

# PCA antes do K-Means
Z = PCA(n_components=2).fit_transform(X)
km_pca = KMeans(3, n_init=25, random_state=0).fit(Z)
print("ARI K-Means em 2 CPs:", round(adjusted_rand_score(y, km_pca.labels_), 3))

# Mini-batch K-Means em uma base grande
from sklearn.datasets import make_blobs
Xg, _ = make_blobs(n_samples=200_000, centers=8, random_state=0)
full = KMeans(8, n_init=3, random_state=0).fit(Xg)
mini = MiniBatchKMeans(8, batch_size=1024, n_init=3, random_state=0).fit(Xg)
print(f"Inércia: lote = {full.inertia_:.0f}; mini-batch = {mini.inertia_:.0f}")
# Compare as inércias: o mini-batch é muito mais rápido, mas pode ficar acima

# Agrupamento espectral em dados não convexos
Xc, yc = make_circles(n_samples=500, factor=0.4, noise=0.05, random_state=0)
esp = SpectralClustering(2, affinity="nearest_neighbors", n_neighbors=10,
                         random_state=0).fit(Xc)
kmc = KMeans(2, n_init=10, random_state=0).fit(Xc)
print("ARI anéis - espectral:", round(adjusted_rand_score(yc, esp.labels_), 3),
" K-Means:", round(adjusted_rand_score(yc, kmc.labels_), 3))Em dados simulados, conhecemos os rótulos verdadeiros e podemos comparar partições com o índice de Rand ajustado (sklearn.metrics.adjusted_rand_score), que vale 1 para concordância perfeita e aproximadamente 0 para partições aleatórias, ou com a informação mútua normalizada. Em dados reais, combine medidas internas (silhueta, gap, Calinski–Harabasz, Davies–Bouldin) com a estabilidade dos grupos (por exemplo, reagrupando subamostras) e, sobretudo, com a interpretação substantiva dos grupos.
16.18 Resumo do Capítulo
- Agrupamento busca grupos homogêneos sem variável resposta; as famílias principais são particional, hierárquica, baseada em densidade e baseada em modelos.
- A escolha da dissimilaridade (euclidiana, Manhattan, cosseno, correlação, Jaccard, Gower) e a padronização das variáveis determinam o resultado.
- O K-Means minimiza a soma de quadrados intra-cluster \(J = \sum_k\sum_{i \in C_k}\|\mathbf{x}_i - \boldsymbol\mu_k\|^2\); o algoritmo de Lloyd alterna atribuição ao centroide mais próximo e atualização pela média.
- Nenhum dos passos aumenta \(J\) e o algoritmo converge em número finito de passos para um ótimo local; por isso usam-se múltiplos inícios (
nstart) e a inicialização k-means++. - Vale \(SQ_{Total} = SQ_{Intra} + SQ_{Entre}\): minimizar a variação interna equivale a maximizar a separação entre os centroides.
- \(K\) pode ser escolhido pelo cotovelo, pela silhueta média (\(s(i) = (b - a)/\max(a,b)\)) ou pela estatística gap, que também detecta ausência de grupos.
- O K-Means supõe grupos esféricos de tamanho semelhante e é sensível à escala e a outliers; K-Medoids, agrupamento hierárquico (com ligações simples, completa, média ou Ward) e DBSCAN são alternativas para essas situações.
- As células do K-Means são poliedros convexos de Voronoi; o problema global é NP-difícil (mesmo para \(K = 2\) ou no plano), mas exato em uma dimensão por programação dinâmica; a semeadura k-means++ garante \(\mathbb{E}[J] \leq 8(\ln K + 2)J_{\text{ótimo}}\).
- O critério de Hartigan–Wong considera o efeito exato de mover um ponto (\(\Delta J\)) e tende a encontrar ótimos melhores que Lloyd; o mini-batch troca um pouco de qualidade por escalabilidade.
- Calinski–Harabasz (maior é melhor) e Davies–Bouldin (menor é melhor) complementam silhueta e gap; com rótulos de referência, usam-se o ARI (corrigido pelo acaso) e a NMI.
- Misturas gaussianas, ajustadas pelo EM (verossimilhança não decrescente, via Jensen), fornecem pertinências probabilísticas e grupos elipsoidais; o K-Means é o limite “rígido” com covariâncias esféricas iguais e \(\sigma^2 \to 0\), e o BIC escolhe \(K\) e a estrutura de covariância.
- O agrupamento hierárquico atualiza dissimilaridades pela fórmula de Lance–Williams; o Ward une os grupos com menor \(\Delta = \frac{n_Gn_H}{n_G+n_H}\|\bar{\mathbf{x}}_G - \bar{\mathbf{x}}_H\|^2\); o dendrograma define uma ultramétrica avaliada pela correlação cofenética.
- O DBSCAN define grupos como conjuntos maximais conectados por densidade; PCA, kernel K-Means e agrupamento espectral (autovetores do laplaciano do grafo) ampliam o alcance do K-Means, e a estabilidade por bootstrap ajuda a distinguir grupos reais de artefatos.
16.19 Exercícios Propostos
- Para os pontos \((0,0)\), \((1,0)\), \((0,1)\), \((4,4)\), \((5,4)\), \((4,5)\) e \((10, 10)\), execute à mão o K-Means com \(K = 2\) e centroides iniciais \((0,0)\) e \((10,10)\). Registre \(J\) após cada passo. Repita com \(K = 3\) e discuta o efeito do ponto \((10, 10)\).
- Prove o lema \(\sum_{i\in C}\|\mathbf{x}_i - \mathbf{m}\|^2 = \sum_{i \in C}\|\mathbf{x}_i - \bar{\mathbf{x}}_C\|^2 + |C|\,\|\bar{\mathbf{x}}_C - \mathbf{m}\|^2\) e use-o para demonstrar a decomposição \(SQ_{Total} = SQ_{Intra} + SQ_{Entre}\).
- Mostre que \(\sum_{i \in C}\|\mathbf{x}_i - \bar{\mathbf{x}}_C\|^2 = \frac{1}{2|C|}\sum_{i \in C}\sum_{i' \in C}\|\mathbf{x}_i - \mathbf{x}_{i'}\|^2\).
- Explique por que o argumento de convergência do algoritmo de Lloyd garante término em número finito de passos, mas não a obtenção do mínimo global. Construa um exemplo simples em uma dimensão (por exemplo, com 4 pontos e \(K = 2\)) em que duas inicializações levam a soluções com valores de \(J\) diferentes.
- Se substituirmos a distância euclidiana ao quadrado pela distância de Manhattan no critério do K-Means, qual estatística passa a ser o “centro” ótimo de cada grupo em cada coordenada? Justifique (dica: em uma dimensão, a mediana minimiza \(\sum|x_i - m|\)).
- No exemplo resolvido do capítulo, calcule a silhueta de todos os seis pontos e a silhueta média. Em seguida, calcule a silhueta média para a partição \(\{A, C\}\), \(\{B, D, E, F\}\) e compare.
- Para os dados do exemplo com primeiro centroide em D = (5,4), calcule as probabilidades de escolha do segundo centroide pelo k-means++.
- Construa à mão o dendrograma dos pontos A, B, C, D, E e F do exemplo usando a ligação simples e, depois, a ligação completa. As partições em dois grupos coincidem?
- Discuta por que o K-Means falha em separar dois anéis concêntricos e por que o DBSCAN tem sucesso. Que transformação dos dados permitiria ao K-Means separá-los? (Relacione com o mapeamento de atributos do Capítulo de SVM.)
- Explique por que não se pode escolher \(K\) minimizando diretamente a WCSS e por que a estatística gap pode indicar \(K = 1\).
- Com a base
irissem a colunaSpecies, padronize as variáveis e aplique o K-Means com \(K = 2, \dots, 6\). Usefviz_nbclust(cotovelo e silhueta) eclusGap. Compare a partição com \(K = 3\) com as espécies verdadeiras por meio detable().
- Com a base
- Aplique o K-Means aos dados
USArrestssem padronização e compare com o resultado padronizado. Qual variável domina o agrupamento sem padronização? Por quê?
- Aplique o K-Means aos dados
- (Python) Gere dados com
make_blobs(n_samples=600, centers=3, cluster_std=[1.0, 2.5, 0.5])e compare K-Means, ligação de Ward e DBSCAN usando o índice de Rand ajustado. Repita acrescentando 20 outliers uniformes. - (Python) Use o K-Means para quantização de cores: carregue uma imagem (por exemplo,
sklearn.datasets.load_sample_image("china.jpg")), trate cada pixel como um ponto em \(\mathbb{R}^3\) (RGB) e reconstrua a imagem com \(K \in \{4, 16, 64\}\) cores. Relacione com a origem do algoritmo de Lloyd na quantização de sinais. - Mostre que as células de Voronoi de um conjunto de centroides são convexas. Escreva a equação da fronteira entre os centroides \((0, 0)\) e \((4, 2)\).
- Deduza a fórmula \(\Delta J = \frac{n_B}{n_B+1}\|\mathbf{x} - \boldsymbol\mu_B\|^2 - \frac{n_A}{n_A-1}\|\mathbf{x} - \boldsymbol\mu_A\|^2\) do critério de Hartigan–Wong e mostre que todo movimento de Lloyd tem \(\Delta J < 0\).
- Calcule os índices de Calinski–Harabasz e Davies–Bouldin para a solução com \(K = 2\) do exercício 1 (com e sem o ponto \((10, 10)\)).
- Para \(\mathcal{U} = (1,1,1,2,2,2)\) e \(\mathcal{V} = (1,1,2,2,3,3)\), monte a tabela de contingência e calcule à mão RI, ARI e NMI. Confira com o
scikit-learn. - Mostre que o ARI de duas partições idênticas é 1 e explique por que o índice de Rand não corrigido tende a 1 quando ambas as partições têm muitos grupos pequenos.
- Derive as equações do passo M do EM para uma mistura de gaussianas univariadas. Execute à mão uma iteração para \(x = (0, 1, 5, 6)\), com \(\mu_1 = 0\), \(\mu_2 = 6\), \(\sigma_1^2 = \sigma_2^2 = 1\) e \(\pi_1 = 0{,}5\).
- Mostre que, para \(\boldsymbol\Sigma_k = \sigma^2\mathbf{I}\) e \(\pi_k = 1/K\), as responsabilidades do EM tendem às atribuições do K-Means quando \(\sigma^2 \to 0\).
- Verifique, pela fórmula de Lance–Williams, que os coeficientes da tabela reproduzem as ligações simples, completa e média. Prove o critério de Ward a partir do lema da média.
- Para os pontos \(\{0; 0{,}5; 1; 1{,}5; 4; 4{,}5; 5; 9\}\), aplique o DBSCAN com \(\varepsilon = 0{,}5\) e \(\texttt{minPts} = 3\), classificando cada ponto como central, de borda ou ruído.
- Prove que \(\mathbf{f}^\top\mathbf{L}\mathbf{f} = \frac{1}{2}\sum_{i,j}w_{ij}(f_i - f_j)^2\) e conclua que, se o grafo tem \(K\) componentes conexas, o autovalor 0 de \(\mathbf{L}\) tem multiplicidade \(K\).
- (Python) Compare K-Means, mistura gaussiana (
covariance_type="full") e agrupamento espectral em dados gerados pormake_blobscom as coordenadas multiplicadas pela matriz \(\begin{pmatrix} 0{,}6 & -0{,}6 \\ -0{,}4 & 0{,}8 \end{pmatrix}\) (grupos alongados), usando o ARI. - Use
Mclustna basefaithfule interprete o modelo e o número de grupos escolhidos pelo BIC. Compare com o K-Means e avalie a estabilidade dos grupos por bootstrap.
- Use
16.20 Leituras Recomendadas
- MacQueen (1967) (MacQueen 1967) e Lloyd (1982) (Lloyd 1982): as origens do K-Means.
- Arthur e Vassilvitskii (2007) (Arthur e Vassilvitskii 2007): a inicialização k-means++ e sua garantia teórica.
- Rousseeuw (1987) (Rousseeuw 1987) e Tibshirani, Walther e Hastie (2001) (Tibshirani, Walther, e Hastie 2001): silhueta e estatística gap.
- Kaufman e Rousseeuw (1990) (Kaufman e Rousseeuw 1990): livro clássico sobre agrupamento, origem do PAM e do pacote
clusterdo R. - Ester et al. (1996) (Ester et al. 1996): artigo original do DBSCAN.
- Jain (2010) (Jain 2010): revisão histórica e panorâmica de cinquenta anos de pesquisa em agrupamento.
- James et al. (2013) (James et al. 2013), Capítulo 10, e Hastie, Tibshirani e Friedman (2009) (Hastie, Tibshirani, e Friedman 2009), Capítulo 14: tratamento didático e aprofundado de aprendizado não supervisionado.
- Aloise et al. (2009) (Aloise et al. 2009), Mahajan, Nimbhorkar e Varadarajan (2012) (Mahajan, Nimbhorkar, e Varadarajan 2012) e Vattani (2011) (Vattani 2011): a complexidade do problema do K-Means e do algoritmo de Lloyd.
- Sculley (2010) (Sculley 2010): o mini-batch K-Means.
- Calinski e Harabasz (1974) (Caliński e Harabasz 1974) e Davies e Bouldin (1979) (Davies e Bouldin 1979): índices internos de validação.
- Rand (1971) (Rand 1971), Hubert e Arabie (1985) (Hubert e Arabie 1985) e Strehl e Ghosh (2002) (Strehl e Ghosh 2002): comparação de partições.
- Dempster, Laird e Rubin (1977) (Dempster, Laird, e Rubin 1977), McLachlan e Peel (2000) (McLachlan e Peel 2000) e Fraley e Raftery (2002) (Fraley e Raftery 2002): o algoritmo EM e o agrupamento baseado em misturas.
- Lance e Williams (1967) (Lance e Williams 1967) e Sokal e Rohlf (1962) (Sokal e Rohlf 1962): fundamentos do agrupamento hierárquico e da correlação cofenética.
- von Luxburg (2007) (Luxburg 2007), Ng, Jordan e Weiss (2002) (Ng, Jordan, e Weiss 2002) e Dhillon, Guan e Kulis (2004) (Dhillon, Guan, e Kulis 2004): agrupamento espectral e sua relação com o kernel K-Means; Ding e He (2004) (Ding e He 2004) para a relação entre K-Means e PCA.
- Campello, Moulavi e Sander (2013) (Campello, Moulavi, e Sander 2013) (HDBSCAN) e Hennig (2007) (Hennig 2007) (estabilidade por bootstrap).