14 Classificação com Máquinas de Vetores de Suporte (SVM)
As Máquinas de Vetores de Suporte (SVM) procuram o hiperplano de margem máxima para classificar dados. Neste capítulo, estudamos a geometria dos hiperplanos, a formulação do classificador de margem máxima como um problema de otimização convexa, sua forma dual e o papel dos vetores de suporte, a margem suave (soft margin) com variáveis de folga, a perda hinge, o truque do kernel para dados não lineares, as extensões para problemas multiclasse e para regressão (SVR), e a implementação prática em R e Python. Aprofundamos também a teoria: a dualidade de Lagrange e as condições KKT em detalhe, o algoritmo SMO, os espaços de Hilbert com núcleo reprodutor e o teorema do representante, as regras de construção de kernels válidos, a consistência da perda hinge, limites de generalização baseados na margem, a calibração de probabilidades de Platt, o \(\nu\)-SVM, o SVM de uma classe e a complexidade computacional do método.
14.1 A Intuição por Trás do SVM
As Máquinas de Vetores de Suporte (ou Support Vector Machines - SVM), concebidas por Vladimir Vapnik e Corinna Cortes (Cortes e Vapnik 1995), constituem uma classe extremamente poderosa e robusta de algoritmos de aprendizado de máquina supervisionado. O objetivo básico do SVM é encontrar, em um espaço \(p\)-dimensional de variáveis, o hiperplano divisor ideal que separe de forma mais limpa possível os pontos de dados de duas classes distintas.
Se tivermos dados linearmente separáveis (que podem ser divididos por uma linha no espaço bidimensional), existem infinitas linhas que conseguem dividir os pontos de forma correta. Mas qual dessas infinitas linhas é a ideal?
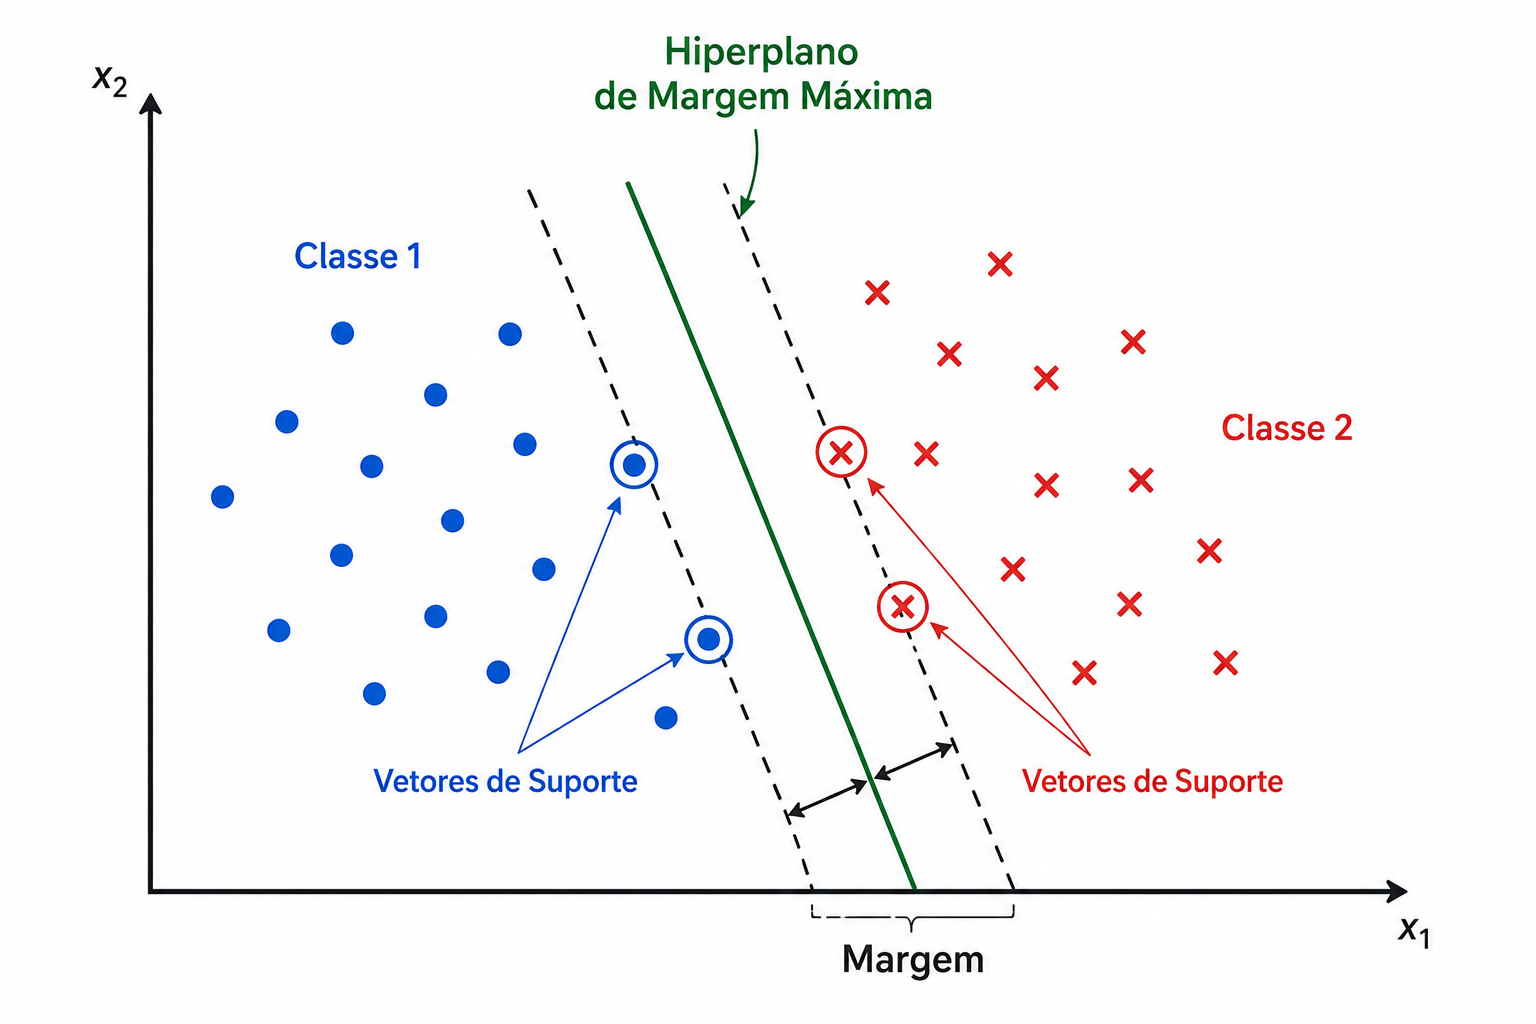
O SVM resolve isso escolhendo a linha (ou hiperplano) que maximiza a distância entre a fronteira de divisão e os pontos de dados mais próximos das duas classes. Essa distância é chamada de Margem, e a divisão ideal é denominada Hiperplano de Margem Máxima.
A ideia é intuitiva: uma fronteira que passa “rente” a alguns pontos de treinamento é frágil, pois uma pequena perturbação nos dados (ruído de medição, uma nova observação ligeiramente diferente) pode fazer com que um ponto mude de lado. Uma fronteira afastada de ambas as classes oferece uma “zona de segurança” e, por isso, tende a generalizar melhor. Essa intuição tem respaldo formal na Teoria do Aprendizado Estatístico de Vapnik (Vapnik 1995), segundo a qual classificadores com margem grande possuem menor capacidade efetiva (dimensão VC) e, consequentemente, limites mais apertados para o erro de generalização.
14.1.1 Breve Contexto Histórico
| Ano | Marco |
|---|---|
| 1909 | Mercer publica o teorema sobre núcleos positivos definidos, base matemática do truque do kernel (Mercer 1909). |
| 1963 | Vapnik e Lerner propõem o algoritmo do hiperplano generalizado (generalized portrait), precursor do classificador de margem máxima. |
| 1992 | Boser, Guyon e Vapnik combinam margem máxima e kernels, dando origem ao SVM não linear (Boser, Guyon, e Vapnik 1992). |
| 1995 | Cortes e Vapnik introduzem a margem suave (soft margin), tornando o método aplicável a dados ruidosos (Cortes e Vapnik 1995). |
| 2000s | Popularização com bibliotecas como LIBSVM (Chang e Lin 2011) e com o livro de Schölkopf e Smola (Schölkopf e Smola 2002). |
Durante a década de 2000, o SVM foi considerado por muitos o estado da arte em classificação, especialmente em problemas de alta dimensão como classificação de textos e bioinformática. Embora métodos de ensemble (Capítulo de Floresta Aleatória) e redes neurais profundas tenham ganhado espaço, o SVM continua sendo uma ferramenta de referência, sobretudo para conjuntos de dados de tamanho pequeno a moderado.
14.2 Geometria dos Hiperplanos
Antes de formalizar o SVM, precisamos de alguns fatos de álgebra linear sobre hiperplanos.
14.2.1 Definição de Hiperplano
Em \(\mathbb{R}^p\), um hiperplano é um subespaço afim de dimensão \(p-1\), definido pelo conjunto
\[ H = \{\mathbf{x} \in \mathbb{R}^p : \mathbf{w}^\top \mathbf{x} + b = 0\}, \]
em que \(\mathbf{w} \in \mathbb{R}^p\) (com \(\mathbf{w} \neq \mathbf{0}\)) é o vetor normal (perpendicular) ao hiperplano e \(b \in \mathbb{R}\) é o intercepto (bias). Em \(\mathbb{R}^2\), um hiperplano é uma reta (\(w_1 x_1 + w_2 x_2 + b = 0\)); em \(\mathbb{R}^3\), um plano.
O hiperplano divide o espaço em dois semiespaços: \(\{\mathbf{x}: \mathbf{w}^\top\mathbf{x} + b > 0\}\) e \(\{\mathbf{x}: \mathbf{w}^\top\mathbf{x} + b < 0\}\). Um classificador linear atribui a classe pelo sinal da função
\[ f(\mathbf{x}) = \mathbf{w}^\top \mathbf{x} + b, \qquad \hat{y} = \operatorname{sign}\big(f(\mathbf{x})\big). \]
No SVM, por conveniência algébrica, codificamos as classes como \(y_i \in \{-1, +1\}\) (e não \(\{0,1\}\)). Com essa codificação, uma observação está corretamente classificada se, e somente se, \(y_i f(\mathbf{x}_i) > 0\).
14.2.2 Por que \(\mathbf{w}\) é Perpendicular ao Hiperplano?
Sejam \(\mathbf{x}_A\) e \(\mathbf{x}_B\) dois pontos quaisquer de \(H\). Então \(\mathbf{w}^\top\mathbf{x}_A + b = 0\) e \(\mathbf{w}^\top\mathbf{x}_B + b = 0\). Subtraindo, \(\mathbf{w}^\top(\mathbf{x}_A - \mathbf{x}_B) = 0\), ou seja, \(\mathbf{w}\) é ortogonal a qualquer vetor contido no hiperplano.
14.2.3 Distância de um Ponto ao Hiperplano
A distância (euclidiana) de um ponto \(\mathbf{x}_0\) ao hiperplano \(H\) é
\[ d(\mathbf{x}_0, H) = \frac{|\mathbf{w}^\top \mathbf{x}_0 + b|}{\|\mathbf{w}\|}. \]
Derivação. Seja \(\mathbf{x}_H\) a projeção ortogonal de \(\mathbf{x}_0\) sobre \(H\). Como o segmento que liga \(\mathbf{x}_H\) a \(\mathbf{x}_0\) é paralelo a \(\mathbf{w}\), podemos escrever \(\mathbf{x}_0 = \mathbf{x}_H + r\,\frac{\mathbf{w}}{\|\mathbf{w}\|}\), em que \(r\) é a distância com sinal. Aplicando \(f\):
\[ f(\mathbf{x}_0) = \mathbf{w}^\top\mathbf{x}_H + b + r\,\frac{\mathbf{w}^\top\mathbf{w}}{\|\mathbf{w}\|} = 0 + r\,\|\mathbf{w}\| \quad\Longrightarrow\quad r = \frac{f(\mathbf{x}_0)}{\|\mathbf{w}\|}. \]
Tomando o valor absoluto, obtemos a fórmula. Note que \(f(\mathbf{x}_0)\) não é uma distância, mas é proporcional a ela; essa observação é central no SVM.
Considere a reta \(H: 3x_1 + 4x_2 - 10 = 0\) em \(\mathbb{R}^2\), isto é, \(\mathbf{w} = (3,4)\) e \(b = -10\), e o ponto \(\mathbf{x}_0 = (4, 3)\).
- \(f(\mathbf{x}_0) = 3\cdot 4 + 4 \cdot 3 - 10 = 14\).
- \(\|\mathbf{w}\| = \sqrt{3^2 + 4^2} = 5\).
- \(d(\mathbf{x}_0, H) = |14|/5 = 2{,}8\).
Como \(f(\mathbf{x}_0) > 0\), o ponto está no semiespaço “positivo” e seria classificado como \(\hat{y} = +1\).
14.2.4 Invariância de Escala
Para qualquer \(c > 0\), o par \((c\mathbf{w}, cb)\) define o mesmo hiperplano que \((\mathbf{w}, b)\). Essa redundância será eliminada adiante com uma normalização conveniente (o chamado hiperplano canônico).
14.3 O Classificador de Margem Máxima
14.3.1 Margem Geométrica
Suponha um conjunto de treinamento \(\{(\mathbf{x}_i, y_i)\}_{i=1}^n\), com \(\mathbf{x}_i \in \mathbb{R}^p\) e \(y_i \in \{-1,+1\}\), linearmente separável, isto é, existe \((\mathbf{w}, b)\) com \(y_i(\mathbf{w}^\top\mathbf{x}_i + b) > 0\) para todo \(i\). A margem geométrica do hiperplano em relação aos dados é a menor distância de um ponto de treinamento ao hiperplano:
\[ M(\mathbf{w}, b) = \min_{i=1,\dots,n} \frac{y_i(\mathbf{w}^\top \mathbf{x}_i + b)}{\|\mathbf{w}\|}. \]
O classificador de margem máxima (maximal margin classifier) é aquele que resolve
\[ \max_{\mathbf{w}, b} \; M(\mathbf{w}, b). \]
14.3.2 Normalização Canônica e o Problema Primal
Pela invariância de escala, podemos escolher \((\mathbf{w}, b)\) de modo que os pontos mais próximos satisfaçam \(y_i(\mathbf{w}^\top\mathbf{x}_i + b) = 1\). Com essa normalização (hiperplano canônico), todos os pontos satisfazem \(y_i(\mathbf{w}^\top\mathbf{x}_i + b) \geq 1\) e a margem vale \(M = 1/\|\mathbf{w}\|\). A largura total da “faixa” entre as duas margens, delimitada pelos hiperplanos \(\mathbf{w}^\top\mathbf{x} + b = +1\) e \(\mathbf{w}^\top\mathbf{x} + b = -1\), é \(2/\|\mathbf{w}\|\).
Maximizar \(1/\|\mathbf{w}\|\) equivale a minimizar \(\|\mathbf{w}\|\), que por sua vez equivale a minimizar \(\frac{1}{2}\|\mathbf{w}\|^2\) (função diferenciável e estritamente convexa). Chegamos ao problema primal do SVM de margem rígida (hard margin):
\[ \begin{aligned} \min_{\mathbf{w},\, b} \quad & \frac{1}{2}\|\mathbf{w}\|^2 \\ \text{s.a.} \quad & y_i(\mathbf{w}^\top \mathbf{x}_i + b) \geq 1, \quad i = 1, \dots, n. \end{aligned} \]
Trata-se de um problema de programação quadrática (objetivo quadrático, restrições lineares) convexo. Consequências importantes:
- Todo mínimo local é mínimo global — não há o problema de “ficar preso” em soluções ruins, ao contrário de redes neurais ou do K-Means (Capítulo de Agrupamento com K-Means).
- A solução \((\mathbf{w}^*, b^*)\) é única quando os dados são linearmente separáveis.
- Existem algoritmos eficientes e bem estudados para resolvê-lo (por exemplo, o SMO — Sequential Minimal Optimization — usado na LIBSVM (Chang e Lin 2011)).
14.4 O Problema Dual e os Vetores de Suporte
14.4.1 Multiplicadores de Lagrange
Problemas de otimização com restrições podem ser tratados com multiplicadores de Lagrange. Associamos a cada restrição \(y_i(\mathbf{w}^\top\mathbf{x}_i + b) \geq 1\) um multiplicador \(\alpha_i \geq 0\) e formamos o lagrangiano
\[ L(\mathbf{w}, b, \boldsymbol{\alpha}) = \frac{1}{2}\|\mathbf{w}\|^2 - \sum_{i=1}^n \alpha_i \left[ y_i(\mathbf{w}^\top\mathbf{x}_i + b) - 1 \right]. \]
Igualando a zero as derivadas parciais em relação às variáveis primais:
\[ \frac{\partial L}{\partial \mathbf{w}} = \mathbf{0} \;\Longrightarrow\; \mathbf{w} = \sum_{i=1}^n \alpha_i y_i \mathbf{x}_i, \qquad \frac{\partial L}{\partial b} = 0 \;\Longrightarrow\; \sum_{i=1}^n \alpha_i y_i = 0. \]
Substituindo essas expressões de volta em \(L\) — detalhadamente: \(\frac{1}{2}\|\mathbf{w}\|^2 = \frac{1}{2}\sum_{i,j}\alpha_i\alpha_j y_i y_j \mathbf{x}_i^\top\mathbf{x}_j\); \(\sum_i \alpha_i y_i \mathbf{w}^\top\mathbf{x}_i = \sum_{i,j}\alpha_i\alpha_j y_i y_j \mathbf{x}_i^\top\mathbf{x}_j\); e \(b\sum_i \alpha_i y_i = 0\) —, a função dual \(g(\boldsymbol{\alpha}) = \min_{\mathbf{w}, b} L(\mathbf{w}, b, \boldsymbol{\alpha})\) vale \[ g(\boldsymbol{\alpha}) = \frac{1}{2}\sum_{i,j}\alpha_i\alpha_j y_i y_j \mathbf{x}_i^\top\mathbf{x}_j - \sum_{i,j}\alpha_i\alpha_j y_i y_j \mathbf{x}_i^\top\mathbf{x}_j + \sum_i \alpha_i = \sum_i \alpha_i - \frac{1}{2}\sum_{i,j}\alpha_i\alpha_j y_i y_j \mathbf{x}_i^\top\mathbf{x}_j, \] e obtemos o problema dual:
\[ \begin{aligned} \max_{\boldsymbol{\alpha}} \quad & \sum_{i=1}^n \alpha_i - \frac{1}{2}\sum_{i=1}^n \sum_{j=1}^n \alpha_i \alpha_j y_i y_j \, \mathbf{x}_i^\top \mathbf{x}_j \\ \text{s.a.} \quad & \alpha_i \geq 0, \quad i = 1,\dots,n, \qquad \sum_{i=1}^n \alpha_i y_i = 0. \end{aligned} \]
Duas observações tornam o dual extremamente importante:
- Os dados aparecem apenas por meio de produtos internos \(\mathbf{x}_i^\top\mathbf{x}_j\). Isso é o que permitirá o truque do kernel.
- O número de variáveis do dual é \(n\) (uma por observação), independentemente da dimensão \(p\). Isso é vantajoso quando \(p \gg n\).
14.4.2 Dualidade fraca e forte
Por que maximizar \(g\) resolve o problema original? Sejam \(P^{*}\) o valor ótimo do primal e \(D^{*}\) o do dual.
Dualidade fraca (\(D^{*} \leq P^{*}\)). Seja \((\mathbf{w}, b)\) qualquer ponto viável do primal e \(\boldsymbol{\alpha} \geq \mathbf{0}\). Como cada termo \(\alpha_i[y_i(\mathbf{w}^\top\mathbf{x}_i + b) - 1]\) é não negativo, \[ g(\boldsymbol{\alpha}) = \min_{\mathbf{w}', b'} L(\mathbf{w}', b', \boldsymbol{\alpha}) \leq L(\mathbf{w}, b, \boldsymbol{\alpha}) = \frac{1}{2}\|\mathbf{w}\|^2 - \underbrace{\sum_i \alpha_i[y_i(\mathbf{w}^\top\mathbf{x}_i + b) - 1]}_{\geq 0} \leq \frac{1}{2}\|\mathbf{w}\|^2. \] Tomando o máximo à esquerda e o mínimo à direita, \(D^{*} \leq P^{*}\). Assim, todo valor dual é uma cota inferior para o valor ótimo do primal — fato que os algoritmos usam como critério de parada (a “lacuna de dualidade” \(P - D\)).
Dualidade forte (\(D^{*} = P^{*}\)). Para problemas convexos, a igualdade vale sob condições de regularidade, como a condição de Slater (existência de um ponto estritamente viável). Quando as restrições são afins, como no SVM, basta que o problema seja viável (Boyd e Vandenberghe 2004). Portanto, para dados linearmente separáveis, resolver o dual e resolver o primal são equivalentes, e as soluções se relacionam por \(\mathbf{w}^{*} = \sum_i \alpha_i^{*} y_i \mathbf{x}_i\).
Uma consequência elegante: no ótimo, \(\frac{1}{2}\|\mathbf{w}^{*}\|^2 = \sum_i\alpha_i^{*} - \frac{1}{2}\|\mathbf{w}^{*}\|^2\), ou seja, \[ \sum_{i=1}^n \alpha_i^{*} = \|\mathbf{w}^{*}\|^2 = \frac{1}{M^2}, \] em que \(M\) é a margem. Quanto menor a margem, maiores os multiplicadores. Essa identidade aparece no exemplo resolvido adiante.
14.4.3 Condições KKT e Vetores de Suporte
Para problemas convexos com dualidade forte, \((\mathbf{w}^{*}, b^{*})\) e \(\boldsymbol{\alpha}^{*}\) são ótimos se, e somente se, satisfazem as condições de Karush-Kuhn-Tucker (KKT):
| Condição | Expressão |
|---|---|
| Estacionariedade | \(\mathbf{w} = \sum_i \alpha_i y_i \mathbf{x}_i\) e \(\sum_i \alpha_i y_i = 0\) |
| Viabilidade primal | \(y_i(\mathbf{w}^\top\mathbf{x}_i + b) \geq 1\) para todo \(i\) |
| Viabilidade dual | \(\alpha_i \geq 0\) para todo \(i\) |
| Folga complementar | \(\alpha_i[y_i(\mathbf{w}^\top\mathbf{x}_i + b) - 1] = 0\) para todo \(i\) |
A folga complementar decorre diretamente da dualidade forte: na cadeia de desigualdades da dualidade fraca, a igualdade \(D^{*} = P^{*}\) só é possível se a soma \(\sum_i \alpha_i^{*}[y_i(\mathbf{w}^{*\top}\mathbf{x}_i + b^{*}) - 1]\), de termos não negativos, for zero, isto é, se cada termo for zero:
\[ \alpha_i \left[ y_i(\mathbf{w}^\top\mathbf{x}_i + b) - 1 \right] = 0, \quad i=1,\dots,n. \]
Logo, para cada observação, ou \(\alpha_i = 0\), ou o ponto está exatamente sobre a margem (\(y_i f(\mathbf{x}_i) = 1\)). Os pontos com \(\alpha_i > 0\) são os vetores de suporte. Como \(\mathbf{w} = \sum_i \alpha_i y_i \mathbf{x}_i\), apenas os vetores de suporte determinam o hiperplano; a função de decisão pode ser escrita como
\[ f(\mathbf{x}) = \sum_{i \in \mathcal{S}} \alpha_i y_i \, \mathbf{x}_i^\top \mathbf{x} + b, \]
em que \(\mathcal{S} = \{i : \alpha_i > 0\}\). O intercepto é obtido a partir de qualquer vetor de suporte \(s\): \(b = y_s - \mathbf{w}^\top\mathbf{x}_s\) (na prática, faz-se a média sobre todos os vetores de suporte para estabilidade numérica).
14.5 Vetores de Suporte e Esparsidade
Os pontos de dados que se situam exatamente na fronteira das margens paralelas de divisão são chamados de Vetores de Suporte. Eles são as instâncias críticas do conjunto de dados, pois se forem alterados, removidos ou deslocados, a posição do hiperplano divisor final mudará. Todos os outros pontos do conjunto de dados que estão mais distantes não influenciam no cálculo geométrico da linha divisória do SVM — formalmente, são exatamente os pontos com \(\alpha_i = 0\).
Essa propriedade de esparsidade distingue o SVM de métodos como a regressão logística (Capítulo de Modelos de Regressão), em que todas as observações contribuem para a estimativa dos parâmetros.
Considere os pontos em \(\mathbb{R}^2\):
| Ponto | \(x_1\) | \(x_2\) | \(y\) |
|---|---|---|---|
| A | 1 | 1 | \(-1\) |
| B | 0 | 2 | \(-1\) |
| C | 3 | 3 | \(+1\) |
| D | 4 | 2 | \(+1\) |
Os pontos da classe \(-1\) estão sobre a reta \(x_1 + x_2 = 2\) e os da classe \(+1\) sobre \(x_1 + x_2 = 6\). Por simetria, o hiperplano de margem máxima é a reta paralela equidistante \(x_1 + x_2 = 4\). Para colocá-lo na forma canônica, procuramos \(\mathbf{w} = c(1,1)\) e \(b = -4c\) tais que \(f = \pm 1\) nos pontos mais próximos. Em A: \(f(A) = c(1+1) - 4c = -2c = -1 \Rightarrow c = 1/2\). Assim:
\[ \mathbf{w}^* = (0{,}5;\; 0{,}5), \qquad b^* = -2. \]
Verificação: \(f(A) = 0{,}5 + 0{,}5 - 2 = -1\); \(f(B) = 0 + 1 - 2 = -1\); \(f(C) = 1{,}5+1{,}5-2 = 1\); \(f(D) = 2+1-2 = 1\). Todos satisfazem \(y_i f(\mathbf{x}_i) = 1\): os quatro pontos estão sobre a margem.
Margem: \(\|\mathbf{w}^*\| = \sqrt{0{,}25 + 0{,}25} = \sqrt{0{,}5} \approx 0{,}707\), logo \(M = 1/\|\mathbf{w}^*\| = \sqrt{2} \approx 1{,}414\) e a largura total da faixa é \(2\sqrt{2} \approx 2{,}83\) — exatamente a distância entre A e C.
Dual (versão com dois pontos). Se usássemos apenas A e C, a restrição \(\sum \alpha_i y_i = 0\) dá \(\alpha_A = \alpha_C = \alpha\) e \(\mathbf{w} = \alpha[(3,3) - (1,1)] = (2\alpha, 2\alpha)\). Igualando a \((0{,}5; 0{,}5)\), obtemos \(\alpha = 1/4\). Note que \(\sum_i \alpha_i = 0{,}5 = \|\mathbf{w}^*\|^2\), a identidade demonstrada na seção de dualidade. E se usarmos os quatro pontos? Escrevendo \(\mathbf{w} = -\alpha_A(1,1) - \alpha_B(0,2) + \alpha_C(3,3) + \alpha_D(4,2) = (0{,}5;\ 0{,}5)\), as duas coordenadas dão \(-\alpha_A + 3\alpha_C + 4\alpha_D = 0{,}5\) e \(-\alpha_A - 2\alpha_B + 3\alpha_C + 2\alpha_D = 0{,}5\); subtraindo, \(2\alpha_B + 2\alpha_D = 0\), e como os multiplicadores são não negativos, \(\alpha_B = \alpha_D = 0\). A restrição \(\sum_i\alpha_i y_i = 0\) dá então \(\alpha_A = \alpha_C = 1/4\): a solução dual com os quatro pontos é a mesma. Os pontos B e D estão sobre a margem, mas têm \(\alpha = 0\): a folga complementar diz que \(\alpha_i > 0\) implica estar sobre a margem, mas a recíproca não vale. Removendo B e D, o hiperplano não muda; removendo A ou C, muda.
Classificação de um novo ponto \(\mathbf{x}_0 = (2; 3)\): \(f(\mathbf{x}_0) = 1 + 1{,}5 - 2 = 0{,}5 > 0 \Rightarrow \hat{y} = +1\), a uma distância de \(0{,}5/0{,}707 \approx 0{,}71\) da fronteira.
14.6 Margem Suave (Soft Margin)
No mundo real, os dados raramente são perfeitamente separáveis. Frequentemente, há sobreposição de pontos e ruído. Nesse caso, o problema primal de margem rígida não tem solução viável. Para contornar isso, introduzimos a Margem Soft (Suave), que permite que o modelo tolere algumas classificações incorretas controladas pelo hiperparâmetro de regularização \(C\).
Formalmente, introduzimos variáveis de folga (slack variables) \(\xi_i \geq 0\), uma para cada observação, que medem o quanto o ponto viola a margem:
\[ \begin{aligned} \min_{\mathbf{w},\, b,\, \boldsymbol{\xi}} \quad & \frac{1}{2}\|\mathbf{w}\|^2 + C \sum_{i=1}^n \xi_i \\ \text{s.a.} \quad & y_i(\mathbf{w}^\top \mathbf{x}_i + b) \geq 1 - \xi_i, \quad \xi_i \geq 0, \quad i = 1, \dots, n. \end{aligned} \]
A interpretação de \(\xi_i\) é geométrica:
| Valor de \(\xi_i\) | Situação do ponto \(i\) |
|---|---|
| \(\xi_i = 0\) | Do lado correto, fora ou sobre a margem |
| \(0 < \xi_i < 1\) | Do lado correto, mas dentro da margem |
| \(\xi_i = 1\) | Exatamente sobre o hiperplano de decisão |
| \(\xi_i > 1\) | Classificado incorretamente |
Como cada erro de classificação implica \(\xi_i > 1\), a soma \(\sum_i \xi_i\) é um limite superior para o número de erros de treinamento.
O dual da margem suave é idêntico ao da margem rígida, exceto pela restrição de caixa (box constraint):
\[ 0 \leq \alpha_i \leq C, \quad i = 1, \dots, n. \]
14.6.1 Derivação do dual da margem suave
Introduzimos multiplicadores \(\alpha_i \geq 0\) para as restrições de margem e \(\mu_i \geq 0\) para as restrições \(\xi_i \geq 0\): \[ L(\mathbf{w}, b, \boldsymbol{\xi}, \boldsymbol{\alpha}, \boldsymbol{\mu}) = \frac{1}{2}\|\mathbf{w}\|^2 + C\sum_i \xi_i - \sum_i \alpha_i\left[y_i(\mathbf{w}^\top\mathbf{x}_i + b) - 1 + \xi_i\right] - \sum_i \mu_i \xi_i . \] As derivadas em relação a \(\mathbf{w}\) e \(b\) dão as mesmas condições do caso rígido. A novidade é a derivada em relação a cada folga: \[ \frac{\partial L}{\partial \xi_i} = C - \alpha_i - \mu_i = 0 \quad\Longrightarrow\quad \mu_i = C - \alpha_i . \] Substituindo, os termos em \(\xi_i\) se cancelam, pois \(C\xi_i - \alpha_i\xi_i - \mu_i\xi_i = 0\), e a função dual é exatamente a mesma do caso rígido. A única diferença está nas restrições: como \(\mu_i \geq 0\), temos \(\alpha_i = C - \mu_i \leq C\), o que dá a restrição de caixa \(0 \leq \alpha_i \leq C\). Intuitivamente, \(C\) limita a “força” com que um único ponto pode puxar o hiperplano: nenhum ponto, por mais atípico, tem influência maior que \(C\).
14.6.2 Condições KKT: os três tipos de pontos
Agora há duas condições de folga complementar: \(\alpha_i[y_i f(\mathbf{x}_i) - 1 + \xi_i] = 0\) e \(\mu_i \xi_i = (C - \alpha_i)\xi_i = 0\). Analisando os casos possíveis de \(\alpha_i\):
| Caso | Consequência das KKT | Situação geométrica |
|---|---|---|
| \(\alpha_i = 0\) | \(\mu_i = C > 0 \Rightarrow \xi_i = 0\), logo \(y_i f(\mathbf{x}_i) \geq 1\) | Bem classificado, sobre ou fora da margem; não é vetor de suporte |
| \(0 < \alpha_i < C\) | \(\mu_i > 0 \Rightarrow \xi_i = 0\), e \(\alpha_i > 0 \Rightarrow y_i f(\mathbf{x}_i) = 1\) | Vetor de suporte livre, exatamente sobre a margem |
| \(\alpha_i = C\) | \(\mu_i = 0\), \(\xi_i \geq 0\) e \(y_i f(\mathbf{x}_i) = 1 - \xi_i \leq 1\) | Vetor de suporte limitado: sobre a margem, dentro dela ou mal classificado |
14.6.3 Cálculo do intercepto \(b\)
O dual fornece \(\boldsymbol{\alpha}\), e daí \(\mathbf{w}\), mas não \(b\). Para qualquer vetor de suporte livre \(s\) (\(0 < \alpha_s < C\)), sabemos que \(y_s f(\mathbf{x}_s) = 1\); como \(y_s^2 = 1\), isso equivale a \(f(\mathbf{x}_s) = y_s\), e \[ b = y_s - \mathbf{w}^\top\mathbf{x}_s = y_s - \sum_{i \in \mathcal{S}} \alpha_i y_i \mathbf{x}_i^\top\mathbf{x}_s . \] Na prática, para reduzir erros numéricos, toma-se a média dessa expressão sobre todos os vetores de suporte livres. (Os vetores limitados não servem, pois para eles só se sabe que \(y_s f(\mathbf{x}_s) \leq 1\); se não houver vetores livres, \(b\) é escolhido no intervalo compatível com as desigualdades, como faz a LIBSVM.)
Considere cinco pontos na reta, com \(C = 1\):
| \(x_i\) | \(-2\) | \(-1\) | \(1\) | \(2\) | \(-1{,}5\) |
|---|---|---|---|---|---|
| \(y_i\) | \(-1\) | \(-1\) | \(+1\) | \(+1\) | \(+1\) |
O último ponto é um “intruso” da classe \(+1\) no meio da classe \(-1\), e os dados não são linearmente separáveis. Resolvendo o dual numericamente (por exemplo, com e1071::svm ou sklearn.svm.SVC, ver o código ao final do capítulo), obtêm-se \[
\boldsymbol{\alpha}^{*} = \left(\tfrac{7}{18};\ 1;\ \tfrac{7}{18};\ 0;\ 1\right), \qquad w^{*} = \tfrac{2}{3}, \qquad b^{*} = \tfrac{1}{3}.
\]
Verificando à mão. Suponha (como o resultado numérico indica) que \(x = -1\) e \(x = -1{,}5\) estejam no limite (\(\alpha = C = 1\)), \(x = 2\) tenha \(\alpha = 0\) e \(x = -2\) e \(x = 1\) sejam vetores livres com multiplicadores \(a_1\) e \(a_3\).
- Restrição \(\sum_i \alpha_i y_i = 0\): \(-a_1 - 1 + a_3 + 1 = 0 \Rightarrow a_1 = a_3 = a\).
- Vetores livres sobre a margem: \(f(-2) = -2w + b = -1\) e \(f(1) = w + b = 1\). Subtraindo, \(3w = 2\), logo \(w = 2/3\) e \(b = 1/3\).
- Estacionariedade: \(w = \sum_i \alpha_i y_i x_i = 2a + 1 + a + 0 - 1{,}5 = 3a - 0{,}5\). Igualando a \(2/3\): \(a = 7/18 \approx 0{,}389 \in (0, 1)\), como exigido.
Conferindo as KKT nos demais pontos:
| \(x_i\) | \(y_i\) | \(\alpha_i\) | \(f(x_i) = \frac{2}{3}x_i + \frac{1}{3}\) | \(y_i f(x_i)\) | \(\xi_i\) | Tipo |
|---|---|---|---|---|---|---|
| \(-2\) | \(-1\) | \(7/18\) | \(-1\) | \(1\) | \(0\) | livre, sobre a margem |
| \(-1\) | \(-1\) | \(1\) | \(-1/3\) | \(1/3\) | \(2/3\) | limitado, dentro da margem |
| \(1\) | \(+1\) | \(7/18\) | \(1\) | \(1\) | \(0\) | livre, sobre a margem |
| \(2\) | \(+1\) | \(0\) | \(5/3\) | \(5/3\) | \(0\) | não é vetor de suporte |
| \(-1{,}5\) | \(+1\) | \(1\) | \(-2/3\) | \(-2/3\) | \(5/3\) | limitado, mal classificado |
Todas as condições da tabela de KKT são satisfeitas, o que certifica a otimalidade. Por fim, a dualidade forte: o valor primal é \(\frac{1}{2}w^2 + C\sum_i\xi_i = \frac{2}{9} + \frac{7}{3} = \frac{23}{9}\), e o dual é \(\sum_i\alpha_i - \frac{1}{2}w^2 = \frac{25}{9} - \frac{2}{9} = \frac{23}{9}\). A lacuna de dualidade é zero. A fronteira de decisão é \(x = -b/w = -0{,}5\), e o único erro de treinamento é o intruso (\(\xi > 1\)), como esperado.
14.6.4 O Parâmetro \(C\) e o Dilema Viés-Variância
- Um valor de \(C\) alto penaliza severamente as classificações incorretas no treino, criando margens estreitas. O modelo se ajusta muito aos dados de treino, arriscando overfitting.
- Um valor de \(C\) baixo tolera mais erros de classificação locais em troca de margens de decisão mais largas, buscando melhor generalização.
Conforme visto no Capítulo de Aprendizado de Máquina e o Processo de Modelagem, este é um exemplo típico do dilema viés-variância: \(C\) grande gera baixo viés e alta variância (poucos vetores de suporte, fronteira sensível a pontos individuais); \(C\) pequeno gera alto viés e baixa variância (muitos vetores de suporte, fronteira estável). Quando \(C \to \infty\), recupera-se a margem rígida.
No livro de James et al. (James et al. 2013), o parâmetro de margem suave é apresentado como um “orçamento” de violações, também denotado por \(C\), que funciona de modo inverso: orçamento grande = margem larga. Já em e1071::svm (R) e em sklearn.svm.SVC (Python), o argumento cost/C é o da formulação acima: \(C\) grande = margem estreita. Sempre verifique a convenção da implementação utilizada.
14.7 Resolvendo o Dual: o Algoritmo SMO
O dual é um problema de programação quadrática com \(n\) variáveis e uma matriz \(\mathbf{Q}\), com \(Q_{ij} = y_i y_j K(\mathbf{x}_i, \mathbf{x}_j)\), de tamanho \(n \times n\). Solucionadores genéricos de programação quadrática precisam armazenar \(\mathbf{Q}\) (memória \(O(n^2)\)) e custam até \(O(n^3)\), o que é inviável para dezenas de milhares de observações. O algoritmo SMO (Sequential Minimal Optimization), de Platt (1998), é a base da LIBSVM e resolve o dual por uma sequência de subproblemas minúsculos, cada um com solução analítica.
Por que dois multiplicadores? A restrição de igualdade \(\sum_i \alpha_i y_i = 0\) impede que se altere um único \(\alpha_i\) mantendo os demais fixos. Com dois multiplicadores, \(\alpha_1\) e \(\alpha_2\), a restrição exige \[ y_1\alpha_1 + y_2\alpha_2 = \text{constante}, \] de modo que \(\alpha_1\) fica determinado por \(\alpha_2\), e o subproblema é a maximização de uma parábola em uma variável sobre um intervalo.
A atualização analítica. Seja \(E_i = f(\mathbf{x}_i) - y_i\) o erro atual no ponto \(i\) e \(\eta = K_{11} + K_{22} - 2K_{12} = \|\phi(\mathbf{x}_1) - \phi(\mathbf{x}_2)\|^2 \geq 0\). O máximo irrestrito da parábola é \[ \alpha_2^{\text{novo}} = \alpha_2 + \frac{y_2(E_1 - E_2)}{\eta}, \] que é então “cortado” (clipped) para o intervalo \([L, H]\) que mantém ambos os multiplicadores em \([0, C]\): \[ \text{se } y_1 \neq y_2:\ L = \max(0, \alpha_2 - \alpha_1),\ H = \min(C, C + \alpha_2 - \alpha_1); \qquad \text{se } y_1 = y_2:\ L = \max(0, \alpha_1 + \alpha_2 - C),\ H = \min(C, \alpha_1 + \alpha_2). \] Finalmente, \(\alpha_1^{\text{novo}} = \alpha_1 + y_1 y_2(\alpha_2 - \alpha_2^{\text{novo}})\), o que preserva a restrição de igualdade, e \(b\) é recalculado. O algoritmo repete o processo escolhendo, por heurísticas, pares que violam as condições KKT (por exemplo, o par de maior violação, como faz a LIBSVM (Chang e Lin 2011)), até que todas sejam satisfeitas dentro de uma tolerância.
Retome os pontos A \(= (1, 1)\), com \(y_A = -1\), e C \(= (3, 3)\), com \(y_C = +1\), do exemplo de margem máxima, com kernel linear e \(C\) grande. Partimos de \(\alpha_A = \alpha_C = 0\) e \(b = 0\), isto é, \(f \equiv 0\).
- Erros: \(E_A = f(A) - y_A = 0 - (-1) = 1\) e \(E_C = 0 - 1 = -1\).
- Kernel: \(K_{AA} = 2\), \(K_{CC} = 18\), \(K_{AC} = 6\), logo \(\eta = 2 + 18 - 2 \cdot 6 = 8\).
- Atualização: \(\alpha_C^{\text{novo}} = 0 + \frac{(+1)(1 - (-1))}{8} = 0{,}25\). Como \(y_A \neq y_C\), \(L = \max(0, 0 - 0) = 0\) e \(H = C\), e não há corte.
- \(\alpha_A^{\text{novo}} = 0 + (-1)(+1)(0 - 0{,}25) = 0{,}25\).
- \(\mathbf{w} = 0{,}25 \cdot (+1)(3, 3) + 0{,}25 \cdot (-1)(1, 1) = (0{,}5;\ 0{,}5)\) e, pelo vetor de suporte C, \(b = y_C - \mathbf{w}^\top\mathbf{x}_C = 1 - 3 = -2\).
Um único passo do SMO chega exatamente à solução \(\alpha_A = \alpha_C = 1/4\), \(\mathbf{w}^{*} = (0{,}5;\ 0{,}5)\), \(b^{*} = -2\) obtida anteriormente — o que é natural, pois com dois pontos o subproblema analítico é o problema completo.
14.8 A Perda Hinge: SVM como Regularização
O problema da margem suave pode ser reescrito sem restrições. Na solução ótima, cada folga assume o menor valor possível, \(\xi_i = \max\{0,\, 1 - y_i f(\mathbf{x}_i)\}\). Substituindo e dividindo por \(nC\) (com \(\lambda = 1/(nC)\), sem alterar o minimizador):
\[ \min_{\mathbf{w},\, b} \; \frac{1}{n}\sum_{i=1}^n \underbrace{\max\{0,\; 1 - y_i(\mathbf{w}^\top\mathbf{x}_i + b)\}}_{\text{perda hinge}} \; + \; \frac{\lambda}{2}\|\mathbf{w}\|^2. \]
Essa é a forma “perda + penalidade”, a mesma estrutura da regressão Ridge que veremos no Capítulo de Modelos de Regressão (Hastie, Tibshirani, e Friedman 2009). A perda hinge (dobradiça) \(\ell(y, f) = \max\{0, 1 - yf\}\):
- é nula quando o ponto está corretamente classificado e fora da margem (\(yf \geq 1\)) — daí a esparsidade da solução;
- cresce linearmente com a violação, o que a torna menos sensível a pontos extremos que a perda quadrática;
- é uma cota superior convexa da perda 0-1, \(\mathbf{1}\{yf \leq 0\}\), que seria a perda “ideal” mas é não convexa e intratável computacionalmente.
Comparando com a regressão logística, cuja perda é \(\log(1 + e^{-yf})\), vemos que ambas são suaves aproximações convexas da perda 0-1 e se comportam de forma parecida; a diferença essencial é que a perda logística nunca é exatamente zero, de modo que todos os pontos influenciam a solução.
Com \(\mathbf{w} = (0{,}5;\; 0{,}5)\) e \(b = -2\) (exemplo anterior), considere três novos pontos de treino:
| Ponto | \(\mathbf{x}\) | \(y\) | \(f(\mathbf{x})\) | \(yf\) | Perda hinge | Situação |
|---|---|---|---|---|---|---|
| E | (5; 4) | \(+1\) | 2,5 | 2,5 | 0 | fora da margem |
| F | (2; 2,5) | \(+1\) | 0,25 | 0,25 | 0,75 | dentro da margem |
| G | (3; 2) | \(-1\) | 0,5 | \(-0{,}5\) | 1,5 | mal classificado |
As folgas ótimas seriam \(\xi_E = 0\), \(\xi_F = 0{,}75\) e \(\xi_G = 1{,}5 > 1\).
14.8.1 Perda hinge versus perda logística
Escrevendo as perdas em função da margem funcional \(m = y f(\mathbf{x})\), a tabela compara a perda 0-1, a hinge e a logística (em base 2, para que valha 1 em \(m = 0\), e em base \(e\), como na regressão logística):
| \(m = yf\) | Perda 0-1 | Hinge \(\max(0, 1 - m)\) | Logística \(\log_2(1 + e^{-m})\) | Logística \(\ln(1 + e^{-m})\) |
|---|---|---|---|---|
| \(-2\) | 1 | 3,0 | 3,069 | 2,127 |
| \(-1\) | 1 | 2,0 | 1,895 | 1,313 |
| \(0\) | 1 | 1,0 | 1,000 | 0,693 |
| \(0{,}5\) | 0 | 0,5 | 0,684 | 0,474 |
| \(1\) | 0 | 0,0 | 0,452 | 0,313 |
| \(2\) | 0 | 0,0 | 0,183 | 0,127 |
As duas perdas convexas são cotas superiores da perda 0-1 (a logística em base 2) e crescem de forma aproximadamente linear para \(m \to -\infty\), mas a hinge é exatamente zero para \(m \geq 1\), enquanto a logística apenas decai exponencialmente.
O que cada perda estima? Fixe \(\mathbf{x}\) e seja \(\eta = P(Y = 1 \mid \mathbf{X} = \mathbf{x})\). O valor de \(f(\mathbf{x})\) que minimiza o risco condicional esperado revela o que o método está “tentando aprender”:
- Perda hinge. O risco condicional é \(\eta\max(0, 1 - f) + (1 - \eta)\max(0, 1 + f)\). Fora de \([-1, 1]\), ele só aumenta (se \(f > 1\), vale \((1 - \eta)(1 + f)\), crescente; se \(f < -1\), vale \(\eta(1 - f)\), decrescente em \(f\)). Em \([-1, 1]\), ele é linear: \[ \eta(1 - f) + (1 - \eta)(1 + f) = 1 + f(1 - 2\eta), \] e o mínimo está em uma extremidade: \(f^{*} = +1\) se \(\eta > 1/2\) e \(f^{*} = -1\) se \(\eta < 1/2\). Ou seja, \(f^{*}(\mathbf{x}) = \operatorname{sign}(2\eta(\mathbf{x}) - 1)\) — exatamente o classificador de Bayes.
- Perda logística. Derivando \(\eta\ln(1 + e^{-f}) + (1 - \eta)\ln(1 + e^{f})\) e igualando a zero, obtém-se \(f^{*} = \ln\frac{\eta}{1 - \eta}\), o logito da probabilidade.
Esse contraste explica dois fatos práticos. Primeiro, as duas perdas são consistentes para classificação (classification-calibrated): minimizar o risco convexo leva, no limite, ao risco de Bayes (Bartlett, Jordan, e McAuliffe 2006). Segundo, a regressão logística estima probabilidades (basta inverter o logito), enquanto o SVM estima apenas o sinal de \(\eta - 1/2\): a saída \(f(\mathbf{x})\) do SVM não tem interpretação probabilística, e é por isso que precisamos da calibração de Platt, discutida adiante.
14.9 O Truque do Kernel (Kernel Trick)
Quando lidamos com dados que são intrinsecamente não lineares em sua dimensão original (por exemplo, pontos da classe azul dispostos em círculo e rodeados por pontos da classe vermelha), é impossível desenhar uma linha reta divisória.
Para resolver este problema de dados não lineares de forma elegante, o SVM utiliza o chamado Truque do Kernel (Kernel Trick):
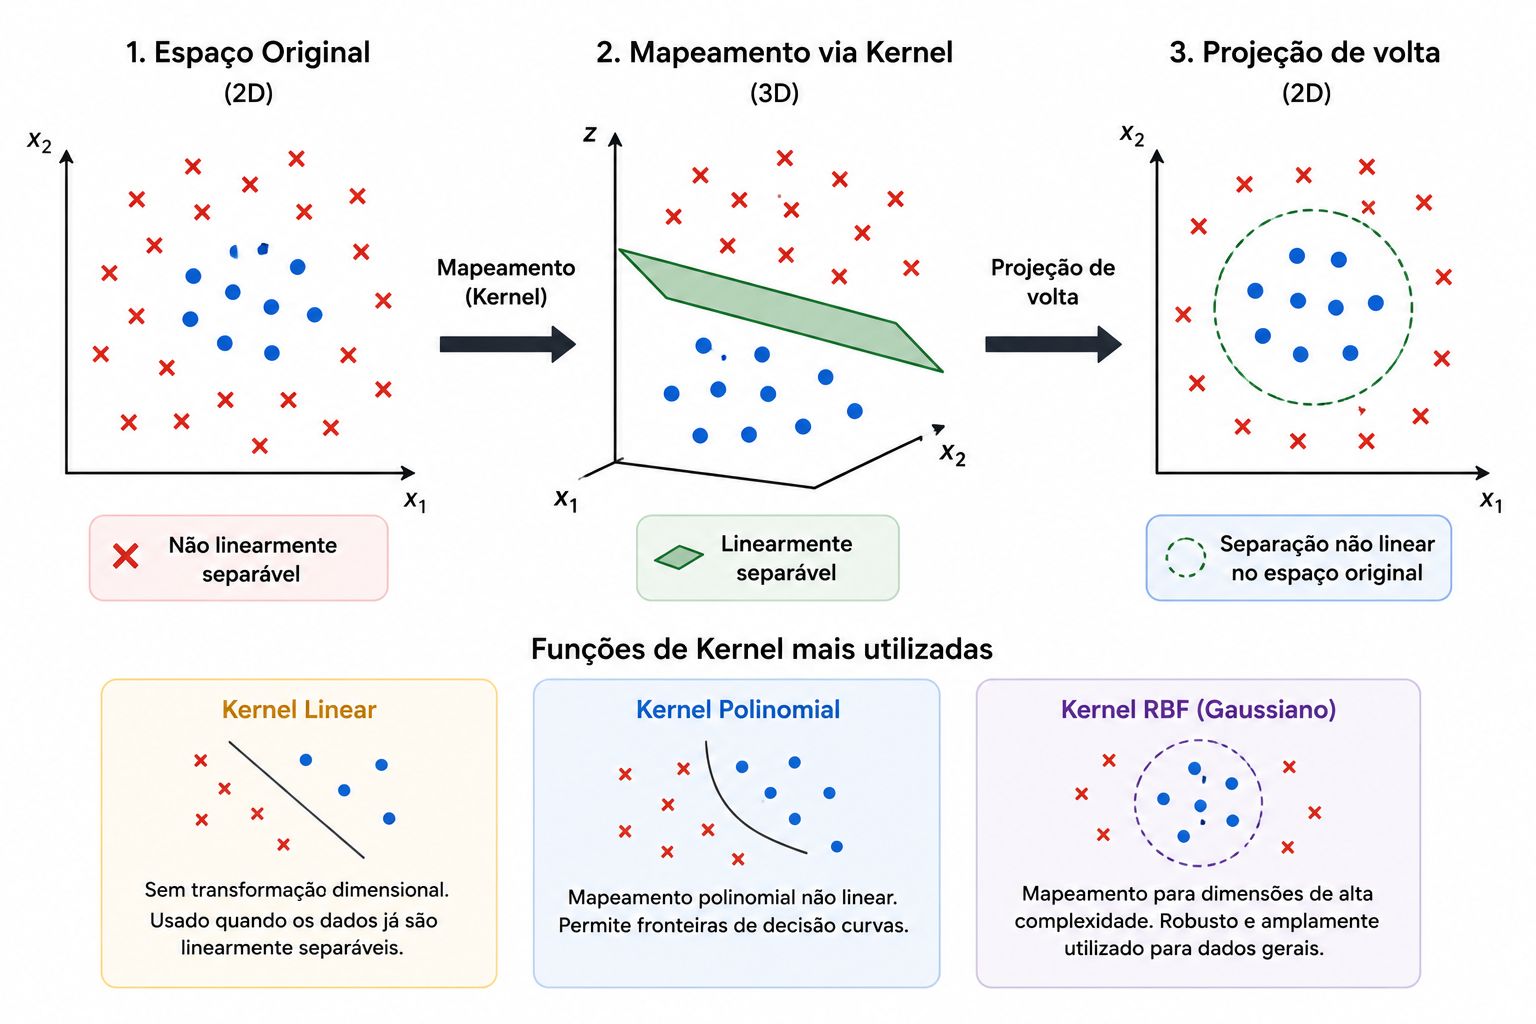
- O algoritmo mapeia os dados originais bidimensionais para um espaço de dimensão muito superior (por exemplo, tridimensional) usando funções matemáticas.
- Nesse novo espaço de dimensão superior, os pontos passam a ser linearmente separáveis por meio de um plano reto divisor.
- Ao projetar essa divisão plana tridimensional de volta para o espaço bidimensional original, a linha divisória aparece de forma curva e customizada.
14.9.1 Mapeamento de Atributos
Seja \(\phi: \mathbb{R}^p \to \mathcal{F}\) um mapeamento de atributos (feature map) para um espaço \(\mathcal{F}\) de dimensão maior (possivelmente infinita). Em vez de ajustar o SVM aos \(\mathbf{x}_i\), ajustamo-lo aos \(\phi(\mathbf{x}_i)\). Um hiperplano em \(\mathcal{F}\) corresponde a uma fronteira não linear em \(\mathbb{R}^p\).
Exemplo clássico: pontos dentro e fora de um círculo em \(\mathbb{R}^2\). Com \(\phi(x_1,x_2) = (x_1, x_2, x_1^2 + x_2^2)\), a terceira coordenada é o quadrado do raio, e o plano \(z_3 = r^2\) separa perfeitamente as classes — é exatamente a situação representada na figura acima.
O problema é que calcular \(\phi\) explicitamente pode ser caríssimo: um polinômio de grau \(d\) em \(p\) variáveis possui \(\binom{p+d}{d}\) monômios (para \(p = 100\) e \(d = 3\), são mais de 176 mil termos).
14.9.2 O Truque
Lembre-se de que, no dual, os dados aparecem somente via produtos internos. Ao trocar \(\mathbf{x}_i\) por \(\phi(\mathbf{x}_i)\), precisamos apenas de \(\phi(\mathbf{x}_i)^\top\phi(\mathbf{x}_j)\). Uma função kernel é uma função \(K: \mathbb{R}^p \times \mathbb{R}^p \to \mathbb{R}\) tal que
\[ K(\mathbf{x}, \mathbf{z}) = \phi(\mathbf{x})^\top \phi(\mathbf{z}). \]
O truque do kernel consiste em calcular \(K(\mathbf{x}, \mathbf{z})\) diretamente no espaço original, sem jamais construir \(\phi\). O dual e a função de decisão tornam-se
\[ \max_{\boldsymbol{\alpha}} \sum_{i} \alpha_i - \frac{1}{2}\sum_{i,j} \alpha_i\alpha_j y_i y_j K(\mathbf{x}_i, \mathbf{x}_j), \qquad f(\mathbf{x}) = \sum_{i \in \mathcal{S}} \alpha_i y_i K(\mathbf{x}_i, \mathbf{x}) + b. \]
14.9.3 Exemplo Explícito: Kernel Polinomial de Grau 2
Sejam \(\mathbf{x} = (x_1, x_2)\) e \(\mathbf{z} = (z_1, z_2)\), e considere \(K(\mathbf{x}, \mathbf{z}) = (\mathbf{x}^\top\mathbf{z})^2\). Expandindo:
\[ \begin{aligned} (\mathbf{x}^\top\mathbf{z})^2 &= (x_1 z_1 + x_2 z_2)^2 = x_1^2 z_1^2 + 2 x_1 x_2 z_1 z_2 + x_2^2 z_2^2 \\ &= (x_1^2,\; \sqrt{2}\,x_1x_2,\; x_2^2)^\top (z_1^2,\; \sqrt{2}\,z_1z_2,\; z_2^2) = \phi(\mathbf{x})^\top \phi(\mathbf{z}), \end{aligned} \]
com \(\phi(\mathbf{x}) = (x_1^2, \sqrt{2}\,x_1x_2, x_2^2) \in \mathbb{R}^3\).
Tome \(\mathbf{x} = (1, 2)\) e \(\mathbf{z} = (3, 1)\).
- Via kernel: \(\mathbf{x}^\top\mathbf{z} = 3 + 2 = 5\), logo \(K(\mathbf{x},\mathbf{z}) = 25\) (2 multiplicações, 1 soma, 1 quadrado).
- Via mapeamento: \(\phi(\mathbf{x}) = (1,\; 2\sqrt{2},\; 4)\), \(\phi(\mathbf{z}) = (9,\; 3\sqrt{2},\; 1)\), e \(\phi(\mathbf{x})^\top\phi(\mathbf{z}) = 9 + 2\sqrt{2}\cdot 3\sqrt{2} + 4 = 9 + 12 + 4 = 25\).
Os resultados coincidem. Em dimensões maiores, a economia do caminho via kernel é enorme.
14.9.4 Kernels Mais Utilizados
Os tipos de funções Kernel mais utilizados na prática são:
- Kernel Linear: Sem transformação dimensional (adequado se os dados originais já forem linearmente separáveis). \[K(\mathbf{x}, \mathbf{z}) = \mathbf{x}^\top\mathbf{z}.\] É o mais rápido e costuma ser suficiente quando \(p\) é grande (por exemplo, textos representados por milhares de palavras).
- Kernel Polinomial: Mapeamento polinomial não linear. \[K(\mathbf{x}, \mathbf{z}) = (\gamma\,\mathbf{x}^\top\mathbf{z} + r)^d,\] em que \(d\) é o grau, \(r \geq 0\) é um termo constante (
coef0) e \(\gamma > 0\) é um fator de escala. Corresponde implicitamente a todos os monômios de grau até \(d\) (se \(r > 0\)). - Kernel RBF (Radial Basis Function / Gaussiano): Mapeamento para dimensões de alta complexidade, sendo um dos kernels padrão mais robustos e utilizados para dados gerais. \[K(\mathbf{x}, \mathbf{z}) = \exp\left(-\gamma\,\|\mathbf{x} - \mathbf{z}\|^2\right), \quad \gamma > 0.\] O espaço de atributos associado tem dimensão infinita. \(K\) mede similaridade: vale 1 quando \(\mathbf{x} = \mathbf{z}\) e decai para 0 conforme os pontos se afastam.
- Kernel Sigmoide: inspirado em redes neurais, \[K(\mathbf{x}, \mathbf{z}) = \tanh(\gamma\,\mathbf{x}^\top\mathbf{z} + r).\] Atenção: ele não é positivo semidefinido para todos os valores de \(\gamma\) e \(r\), e por isso é pouco usado na prática.
14.9.5 O Papel de \(\gamma\) no Kernel RBF
O parâmetro \(\gamma\) controla o raio de influência de cada vetor de suporte (pode-se pensar em \(\gamma = 1/(2\sigma^2)\), como na densidade normal):
- \(\gamma\) pequeno: cada ponto influencia uma região ampla; a fronteira é suave, próxima de linear (risco de underfitting).
- \(\gamma\) grande: cada ponto influencia apenas sua vizinhança imediata; a fronteira se torna muito recortada, formando “ilhas” ao redor de pontos individuais (risco de overfitting). No limite, o SVM-RBF se comporta como um classificador de vizinho mais próximo (Capítulo de k-NN).
Na prática, \(C\) e \(\gamma\) interagem fortemente e devem ser ajustados conjuntamente, em geral por busca em grade com validação cruzada em escala logarítmica (por exemplo, \(C \in \{2^{-5}, 2^{-3}, \dots, 2^{15}\}\) e \(\gamma \in \{2^{-15}, 2^{-13}, \dots, 2^{3}\}\), como recomendam os autores da LIBSVM).
Com \(\mathbf{x} = (1, 2)\), \(\mathbf{z} = (3, 1)\): \(\|\mathbf{x} - \mathbf{z}\|^2 = 4 + 1 = 5\).
- \(\gamma = 0{,}1\): \(K = e^{-0{,}5} \approx 0{,}607\) (pontos considerados “parecidos”).
- \(\gamma = 1\): \(K = e^{-5} \approx 0{,}0067\) (praticamente “sem relação”).
14.9.6 Quando uma Função é um Kernel Válido? (Condição de Mercer)
Nem toda função \(K(\mathbf{x}, \mathbf{z})\) corresponde a um produto interno em algum espaço. O Teorema de Mercer (Mercer 1909) fornece a caracterização: \(K\) é um kernel válido se for simétrica (\(K(\mathbf{x},\mathbf{z}) = K(\mathbf{z},\mathbf{x})\)) e positiva semidefinida, isto é, para qualquer conjunto finito de pontos \(\mathbf{x}_1,\dots,\mathbf{x}_m\), a matriz de Gram \(\mathbf{K}\), com \(K_{ij} = K(\mathbf{x}_i, \mathbf{x}_j)\), satisfaz
\[ \mathbf{c}^\top \mathbf{K}\,\mathbf{c} = \sum_{i=1}^m\sum_{j=1}^m c_i c_j K(\mathbf{x}_i, \mathbf{x}_j) \geq 0 \quad \text{para todo } \mathbf{c} \in \mathbb{R}^m. \]
Essa condição garante que o problema dual continue convexo. Kernels válidos podem ser combinados: somas, produtos e múltiplos positivos de kernels válidos são kernels válidos (Schölkopf e Smola 2002). Kernels também podem ser definidos para objetos não vetoriais (sequências de DNA, textos, grafos), o que amplia muito o alcance do método.
14.9.7 Construindo kernels válidos: regras de fechamento
Verificar a condição de Mercer diretamente pode ser trabalhoso. Na prática, construímos kernels complexos a partir de kernels simples usando operações que preservam a semidefinitude positiva. Sejam \(K_1\) e \(K_2\) kernels válidos e \(\mathbf{K}_1\), \(\mathbf{K}_2\) suas matrizes de Gram em um conjunto finito qualquer de pontos.
- Escala positiva: \(cK_1\), com \(c > 0\), é kernel. Prova: \(\mathbf{c}^\top(c\mathbf{K}_1)\mathbf{c} = c\,(\mathbf{c}^\top\mathbf{K}_1\mathbf{c}) \geq 0\).
- Soma: \(K_1 + K_2\) é kernel. Prova: \(\mathbf{c}^\top(\mathbf{K}_1 + \mathbf{K}_2)\mathbf{c} = \mathbf{c}^\top\mathbf{K}_1\mathbf{c} + \mathbf{c}^\top\mathbf{K}_2\mathbf{c} \geq 0\). Em termos de atributos, corresponde a concatenar os vetores: \(\phi(\mathbf{x}) = (\phi_1(\mathbf{x}), \phi_2(\mathbf{x}))\).
- Produto: \(K_1 K_2\) é kernel. Prova: se \(K_1(\mathbf{x}, \mathbf{z}) = \sum_a \phi_a(\mathbf{x})\phi_a(\mathbf{z})\) e \(K_2(\mathbf{x}, \mathbf{z}) = \sum_b \psi_b(\mathbf{x})\psi_b(\mathbf{z})\), então \[ K_1(\mathbf{x}, \mathbf{z})K_2(\mathbf{x}, \mathbf{z}) = \sum_{a,b} \big[\phi_a(\mathbf{x})\psi_b(\mathbf{x})\big]\big[\phi_a(\mathbf{z})\psi_b(\mathbf{z})\big], \] um produto interno com atributos \(\phi_a\psi_b\) (todos os produtos dois a dois). Em termos matriciais, esse é o teorema do produto de Schur: o produto elemento a elemento de matrizes positivas semidefinidas é positivo semidefinido.
- Função de cada argumento: para qualquer \(g: \mathbb{R}^p \to \mathbb{R}\), \(K(\mathbf{x}, \mathbf{z}) = g(\mathbf{x})g(\mathbf{z})\) é kernel, pois \(\mathbf{c}^\top\mathbf{K}\mathbf{c} = \left(\sum_i c_i g(\mathbf{x}_i)\right)^2 \geq 0\).
- Limites e séries: limites pontuais de kernels são kernels (a desigualdade \(\geq 0\) passa ao limite). Em particular, um polinômio com coeficientes não negativos de um kernel, e a exponencial de um kernel, \(e^{K_1} = \sum_{m \geq 0} K_1^m/m!\), são kernels.
Aplicações. (a) O kernel polinomial \((\gamma\,\mathbf{x}^\top\mathbf{z} + r)^d\), com \(\gamma > 0\) e \(r \geq 0\), é a potência \(d\) da soma do kernel linear escalonado com a constante \(r\) (que é kernel pela regra 4, com \(g \equiv \sqrt{r}\)); é válido pelas regras 1 a 4. (b) O kernel RBF é válido. Expandindo o quadrado, \[ e^{-\gamma\|\mathbf{x} - \mathbf{z}\|^2} = \underbrace{e^{-\gamma\|\mathbf{x}\|^2}\, e^{-\gamma\|\mathbf{z}\|^2}}_{\text{regra 4}} \cdot \underbrace{e^{2\gamma\,\mathbf{x}^\top\mathbf{z}}}_{\text{regra 5}}, \] um produto de dois kernels (regra 3). A expansão em série de \(e^{2\gamma\mathbf{x}^\top\mathbf{z}}\) contém monômios de todos os graus, o que mostra por que o espaço de atributos do RBF tem dimensão infinita.
Kernel RBF. Para os pontos \((0, 0)\), \((1, 0)\) e \((0, 1)\) e \(\gamma = 1\), as distâncias ao quadrado são \(1\), \(1\) e \(2\), e \[ \mathbf{K} = \begin{bmatrix} 1 & e^{-1} & e^{-1} \\ e^{-1} & 1 & e^{-2} \\ e^{-1} & e^{-2} & 1 \end{bmatrix} \approx \begin{bmatrix} 1 & 0{,}3679 & 0{,}3679 \\ 0{,}3679 & 1 & 0{,}1353 \\ 0{,}3679 & 0{,}1353 & 1 \end{bmatrix}. \] Seus autovalores são \(0{,}543\); \(0{,}865\) e \(1{,}592\), todos positivos, como garante a teoria. (O autovalor \(1 - e^{-2} \approx 0{,}865\) corresponde ao autovetor \((0, 1, -1)\), como se verifica diretamente.)
Kernel sigmoide. Para \(\mathbf{x}_1 = (1, 0)\), \(\mathbf{x}_2 = (2, 0)\), \(\gamma = 1\) e \(r = 0\), os produtos internos são \(1\), \(2\) e \(4\), e \[ \mathbf{K} = \begin{bmatrix} \tanh 1 & \tanh 2 \\ \tanh 2 & \tanh 4 \end{bmatrix} \approx \begin{bmatrix} 0{,}7616 & 0{,}9640 \\ 0{,}9640 & 0{,}9993 \end{bmatrix}, \qquad \det \mathbf{K} \approx 0{,}7611 - 0{,}9293 = -0{,}168 < 0. \] Uma matriz \(2 \times 2\) com determinante negativo tem um autovalor negativo (aqui, \(\approx -0{,}091\)); com \(\mathbf{c} = (1, -1)\), \(\mathbf{c}^\top\mathbf{K}\mathbf{c} = 0{,}7616 + 0{,}9993 - 2(0{,}9640) \approx -0{,}167 < 0\). Logo, o kernel sigmoide não é um kernel de Mercer para esses parâmetros: não existe \(\phi\) com \(\tanh(\mathbf{x}^\top\mathbf{z}) = \phi(\mathbf{x})^\top\phi(\mathbf{z})\), e o dual pode deixar de ser convexo.
14.10 Espaços de Hilbert com Núcleo Reprodutor e o Teorema do Representante
O truque do kernel foi apresentado como um atalho computacional. Há, porém, uma teoria matemática profunda por trás dele, que explica por que a solução do SVM sempre tem a forma \(f(\mathbf{x}) = \sum_i \alpha_i y_i K(\mathbf{x}_i, \mathbf{x}) + b\), mesmo quando o espaço de atributos tem dimensão infinita.
14.10.1 O espaço de funções de um kernel
Dado um kernel válido \(K\), considere as funções da forma \[ f(\cdot) = \sum_{i=1}^{m} c_i K(\mathbf{x}_i, \cdot), \] isto é, combinações de “colinas” centradas em pontos \(\mathbf{x}_i\) (no caso RBF, literalmente gaussianas). Nesse conjunto, define-se o produto interno \[ \left\langle \sum_i c_i K(\mathbf{x}_i, \cdot),\ \sum_j d_j K(\mathbf{z}_j, \cdot) \right\rangle_{\mathcal{H}} = \sum_{i,j} c_i d_j K(\mathbf{x}_i, \mathbf{z}_j), \] que é não negativo justamente porque \(K\) é positivo semidefinido. Completando esse espaço (incluindo os limites de sequências de Cauchy), obtém-se um espaço de Hilbert \(\mathcal{H}_K\), o espaço de Hilbert com núcleo reprodutor (Reproducing Kernel Hilbert Space, RKHS) associado a \(K\) (Aronszajn 1950). Seu traço característico é a propriedade reprodutora: \[ \langle f, K(\mathbf{x}, \cdot)\rangle_{\mathcal{H}} = f(\mathbf{x}) \quad \text{para toda } f \in \mathcal{H}_K, \] e, em particular, \(\langle K(\mathbf{x}, \cdot), K(\mathbf{z}, \cdot)\rangle_{\mathcal{H}} = K(\mathbf{x}, \mathbf{z})\). Ou seja, \(\phi(\mathbf{x}) = K(\mathbf{x}, \cdot)\) é um mapeamento de atributos legítimo — cada ponto é representado por uma função —, e avaliar \(f\) em \(\mathbf{x}\) é tomar um produto interno. O teorema de Moore–Aronszajn garante que essa correspondência entre kernels positivos semidefinidos e RKHS é biunívoca.
A norma \(\|f\|_{\mathcal{H}}\) mede a “complexidade” ou “rugosidade” de \(f\); para o kernel linear, \(f(\mathbf{x}) = \mathbf{w}^\top\mathbf{x}\) e \(\|f\|_{\mathcal{H}} = \|\mathbf{w}\|\). Assim, o SVM com kernel resolve \[ \min_{f \in \mathcal{H}_K,\, b} \; \frac{1}{n}\sum_{i=1}^{n}\max\{0,\ 1 - y_i(f(\mathbf{x}_i) + b)\} + \frac{\lambda}{2}\|f\|_{\mathcal{H}}^2, \] uma generalização direta da forma “perda + penalidade” para um espaço de funções.
14.10.2 O teorema do representante
Seja \(\mathcal{H}_K\) um RKHS, \(\ell\) uma função de perda qualquer e \(\Omega: [0, \infty) \to \mathbb{R}\) uma função estritamente crescente. Então todo minimizador de \[ J(f) = \sum_{i=1}^{n} \ell\big(y_i, f(\mathbf{x}_i)\big) + \Omega\big(\|f\|_{\mathcal{H}}\big) \] sobre \(f \in \mathcal{H}_K\) admite a representação \[ f^{*}(\cdot) = \sum_{i=1}^{n} \beta_i K(\mathbf{x}_i, \cdot) \] para algum \(\boldsymbol{\beta} \in \mathbb{R}^n\).
Esboço da prova. Seja \(\mathcal{H}_0 = \operatorname{span}\{K(\mathbf{x}_1, \cdot), \ldots, K(\mathbf{x}_n, \cdot)\}\), um subespaço de dimensão finita. Toda \(f \in \mathcal{H}_K\) se decompõe de modo único como \(f = f_0 + f_\perp\), com \(f_0 \in \mathcal{H}_0\) e \(f_\perp\) ortogonal a \(\mathcal{H}_0\). Pela propriedade reprodutora, nos pontos de treinamento, \[ f(\mathbf{x}_i) = \langle f_0 + f_\perp, K(\mathbf{x}_i, \cdot)\rangle_{\mathcal{H}} = \langle f_0, K(\mathbf{x}_i, \cdot)\rangle_{\mathcal{H}} + 0 = f_0(\mathbf{x}_i), \] logo a parte \(f_\perp\) não altera a perda. Por outro lado, pelo teorema de Pitágoras, \(\|f\|_{\mathcal{H}}^2 = \|f_0\|_{\mathcal{H}}^2 + \|f_\perp\|_{\mathcal{H}}^2 \geq \|f_0\|_{\mathcal{H}}^2\), com igualdade só se \(f_\perp = 0\). Como \(\Omega\) é estritamente crescente, \(J(f_0) \leq J(f)\), com desigualdade estrita se \(f_\perp \neq 0\). Portanto, todo minimizador está em \(\mathcal{H}_0\). \(\square\)
A versão original para splines é de Kimeldorf e Wahba (1971), e a forma geral enunciada acima é de Schölkopf, Herbrich, e Smola (2001).
Consequências. (i) Um problema de otimização em um espaço possivelmente de dimensão infinita reduz-se a um problema em \(\mathbb{R}^n\) — exatamente o que o dual faz. (ii) O teorema vale para qualquer perda: com a perda hinge obtemos o SVM; com a perda quadrática, a regressão ridge com kernel (kernel ridge regression), cuja solução é \(\boldsymbol{\beta} = (\mathbf{K} + \lambda\mathbf{I})^{-1}\mathbf{y}\); com a perda logística, a regressão logística com kernel. (iii) O que distingue o SVM não é a forma da solução, mas a esparsidade de \(\boldsymbol{\beta}\), herdada da região plana da perda hinge.
14.11 Por que a Margem Grande Generaliza? Dimensão VC e Limites de Erro
Na introdução, afirmamos que a margem grande tem respaldo na teoria do aprendizado estatístico. Vejamos o argumento com um pouco mais de precisão (Vapnik 1995, 1998).
14.11.1 Dimensão VC
Uma família de classificadores fragmenta (shatters) um conjunto de \(m\) pontos se, para cada uma das \(2^m\) rotulações possíveis desses pontos, existe um classificador na família que a realiza sem erros. A dimensão de Vapnik–Chervonenkis (VC) da família, \(h\), é o maior \(m\) para o qual existe algum conjunto de \(m\) pontos fragmentável. Ela mede a capacidade da família.
Exemplo: hiperplanos em \(\mathbb{R}^2\) (retas) têm \(h = 3\). Três pontos não colineares podem receber qualquer uma das \(2^3 = 8\) rotulações e sempre há uma reta que as separa; mas nenhum conjunto de quatro pontos é fragmentável: se os quatro formam um quadrilátero convexo, a rotulação “diagonais iguais” (o problema XOR) não é linearmente separável; se um deles está dentro do triângulo formado pelos outros três, rotular o interno diferente dos externos não é separável. Em geral, hiperplanos em \(\mathbb{R}^p\) têm \(h = p + 1\).
14.11.2 O limite de Vapnik
Para uma família com dimensão VC \(h\) e uma amostra de tamanho \(n > h\), com probabilidade de pelo menos \(1 - \delta\), todo classificador \(f\) da família satisfaz \[ R(f) \;\leq\; R_{\text{emp}}(f) + \sqrt{\frac{h\left(\ln\frac{2n}{h} + 1\right) - \ln\frac{\delta}{4}}{n}}, \] em que \(R\) é o erro verdadeiro e \(R_{\text{emp}}\) o erro de treinamento. O segundo termo, a “penalidade de capacidade”, cresce com \(h\) e decresce com \(n\).
14.11.3 A margem controla a capacidade
O resultado-chave para o SVM é que hiperplanos com margem \(M\) sobre dados contidos em uma bola de raio \(R\) têm dimensão VC limitada por \[ h \;\leq\; \min\left\{\left\lceil \frac{R^2}{M^2} \right\rceil,\ p\right\} + 1, \] independentemente de \(p\) quando a margem é grande. Isso explica por que o SVM funciona bem em dimensões altíssimas (ou infinitas, com o kernel RBF): o que controla a capacidade é a razão \(R/M\), e não o número de atributos.
Exemplo resolvido. Suponha \(p = 1000\) atributos, dados contidos em uma bola de raio \(R = 10\), \(n = 10.000\) observações e \(\delta = 0{,}05\).
- Sem usar a margem, \(h = p + 1 = 1001\) e a penalidade de capacidade vale \(\sqrt{\left[1001\left(\ln\frac{20000}{1001} + 1\right) - \ln 0{,}0125\right]/10000} \approx 0{,}633\) — um limite inútil.
- Com margem \(M = 1\), \(h \leq 100 + 1 = 101\) e a penalidade cai para \(\approx 0{,}253\).
Os limites de VC são, em geral, pessimistas (valem para qualquer distribuição), e não devem ser usados para escolher hiperparâmetros na prática — para isso existe a validação cruzada. Seu valor é conceitual: eles mostram que maximizar a margem é uma forma de controlar a complexidade, o que dá suporte formal à intuição do início do capítulo.
14.11.4 Um limite pelo número de vetores de suporte
Há um resultado mais simples e de natureza combinatória. Seja \(\hat{R}_{\text{LOO}}\) o erro de validação cruzada leave-one-out do SVM de margem rígida. Então \[ \hat{R}_{\text{LOO}} \;\leq\; \frac{|\mathcal{S}|}{n}, \] em que \(|\mathcal{S}|\) é o número de vetores de suporte.
Prova. Se a observação \(i\) não é vetor de suporte (\(\alpha_i = 0\)), a solução ótima com todos os pontos continua viável e ótima sem ela: removê-la apenas elimina uma restrição inativa, e as condições KKT dos demais pontos não mudam. Assim, o modelo treinado sem \(i\) é o mesmo, e classifica \(i\) corretamente (pois \(y_i f(\mathbf{x}_i) \geq 1 > 0\)). Logo, só os vetores de suporte podem ser erros na validação leave-one-out. \(\square\)
Por exemplo, um SVM treinado com \(n = 500\) observações que resulta em 40 vetores de suporte tem erro leave-one-out de no máximo \(40/500 = 8\%\). Tomando esperança, \(\mathbb{E}[\text{erro}] \leq \mathbb{E}[|\mathcal{S}|]/n\) para amostras de tamanho \(n - 1\): soluções esparsas generalizam bem.
14.12 SVM para Problemas Multiclasse
O SVM é, por construção, um classificador binário. Para \(K > 2\) classes, as duas estratégias mais comuns são:
14.12.1 Um-contra-Um (One-versus-One, OvO)
- Treina-se um SVM para cada par de classes, totalizando \(\binom{K}{2} = K(K-1)/2\) classificadores.
- Um novo ponto é submetido a todos eles; cada classificador “vota” em uma classe e a predição é a classe mais votada.
- Cada classificador usa apenas os dados de duas classes, o que torna o treinamento individual rápido. É a estratégia usada internamente por
e1071::svme porsklearn.svm.SVC.
14.12.2 Um-contra-Todos (One-versus-Rest, OvR)
- Treina-se \(K\) classificadores, cada um separando a classe \(k\) de todas as demais agrupadas.
- A predição é a classe cujo classificador fornece o maior valor de \(f_k(\mathbf{x})\) (maior “confiança”).
- Menos classificadores, mas cada um usa todos os dados e enfrenta problemas desbalanceados. É o padrão em
sklearn.svm.LinearSVC.
Para \(K = 3\) (como na base iris), ambas as estratégias usam 3 classificadores; para \(K = 10\), OvO usa 45 e OvR usa 10.
Apesar de o OvO treinar mais classificadores, cada um usa apenas cerca de \(2n/K\) observações. Se o custo de treinamento cresce como \(n^{a}\), com \(a \approx 2\), o custo total do OvO é aproximadamente \(\binom{K}{2}(2n/K)^{a} \approx 2^{a-1}K^{2-a}n^{a}\), enquanto o do OvR é \(K n^{a}\). Para \(a = 2\), o OvO custa cerca de \(2n^2\) e o OvR \(Kn^2\): com muitas classes, o OvO costuma ser mais rápido, o que explica a escolha da LIBSVM. Existem ainda formulações multiclasse “diretas”, que resolvem um único problema de otimização com todas as classes (por exemplo, a de Crammer e Singer), mas raramente superam as estratégias acima na prática.
14.13 Probabilidades a partir do SVM: o Escalonamento de Platt
Vimos que a função \(f(\mathbf{x})\) do SVM estima o sinal de \(\eta(\mathbf{x}) - 1/2\), e não a probabilidade \(\eta(\mathbf{x})\). Em muitas aplicações, porém, precisamos de probabilidades: para combinar modelos, para escolher limiares de decisão com custos assimétricos ou para comunicar risco. Platt (1999) propôs ajustar, depois do SVM, um modelo logístico de uma variável sobre a saída \(f\): \[ \hat{P}(Y = 1 \mid f) = \frac{1}{1 + \exp(A f + B)}, \] com \(A\) (tipicamente negativo) e \(B\) estimados por máxima verossimilhança. Dois cuidados são essenciais:
- Os valores de \(f\) usados no ajuste não podem ser os de treinamento, pois o SVM empurra os pontos de treinamento para fora da margem, produzindo saídas otimistas. Usam-se valores fora da amostra, obtidos por validação cruzada (a LIBSVM usa 5 partições internas).
- Para reduzir o sobreajuste, Platt substitui os rótulos \(0/1\) por alvos suavizados: \(t_{+} = \frac{N_{+} + 1}{N_{+} + 2}\) para os positivos e \(t_{-} = \frac{1}{N_{-} + 2}\) para os negativos, em que \(N_{+}\) e \(N_{-}\) são os números de exemplos de cada classe. Uma implementação numericamente mais estável do ajuste foi proposta por Lin, Lin, e Weng (2007).
Exemplo resolvido. Suponha que o ajuste tenha produzido \(A = -2\) e \(B = 0\). Então:
| \(f(\mathbf{x})\) | \(-1\) | \(0\) | \(0{,}5\) | \(1\) | \(2\) |
|---|---|---|---|---|---|
| \(\hat{P}(Y = 1 \mid f)\) | 0,119 | 0,500 | 0,731 | 0,881 | 0,982 |
Por exemplo, para \(f = 0{,}5\): \(1/(1 + e^{-1}) \approx 0{,}731\). Um ponto exatamente sobre a margem positiva (\(f = 1\)) recebe probabilidade \(0{,}881\). Com \(B \neq 0\), o ponto de probabilidade \(1/2\) desloca-se para \(f = -B/A\), e a decisão pela maior probabilidade pode discordar da decisão pelo sinal de \(f\) — por isso, em e1071 e scikit-learn, predict e a classe de maior probabilidade ocasionalmente divergem. Para problemas multiclasse, as probabilidades dos classificadores OvO são combinadas por acoplamento de pares (pairwise coupling).
14.14 O \(\nu\)-SVM: uma Parametrização mais Interpretável
O parâmetro \(C\) não tem escala natural: seu valor ideal depende do número de observações e da escala dos dados. Schölkopf et al. (2000) propuseram substituí-lo por um parâmetro \(\nu \in (0, 1]\) com interpretação direta. O \(\nu\)-SVM resolve \[ \begin{aligned} \min_{\mathbf{w},\, b,\, \boldsymbol{\xi},\, \rho} \quad & \frac{1}{2}\|\mathbf{w}\|^2 - \nu\rho + \frac{1}{n}\sum_{i=1}^n \xi_i \\ \text{s.a.} \quad & y_i(\mathbf{w}^\top\mathbf{x}_i + b) \geq \rho - \xi_i, \quad \xi_i \geq 0, \quad \rho \geq 0, \end{aligned} \] em que a largura da margem, \(\rho/\|\mathbf{w}\|\), passa a ser otimizada (o termo \(-\nu\rho\) premia margens largas). O dual é \[ \max_{\boldsymbol{\alpha}} \; -\frac{1}{2}\sum_{i,j}\alpha_i\alpha_j y_i y_j K(\mathbf{x}_i, \mathbf{x}_j) \quad \text{s.a.} \quad 0 \leq \alpha_i \leq \frac{1}{n}, \quad \sum_i \alpha_i y_i = 0, \quad \sum_i \alpha_i \geq \nu . \]
Se a solução tem \(\rho > 0\), então:
- \(\nu\) é uma cota superior para a fração de erros de margem (pontos com \(\xi_i > 0\));
- \(\nu\) é uma cota inferior para a fração de vetores de suporte.
Esboço da prova. Na solução com \(\rho > 0\), as KKT dão \(\sum_i \alpha_i = \nu\). Todo erro de margem tem \(\xi_i > 0\) e, pela folga complementar, \(\alpha_i = 1/n\) (está no limite da caixa). Se há \(m_e\) erros de margem, então \(\nu = \sum_i \alpha_i \geq m_e/n\), o que prova (1). Como todo \(\alpha_i \leq 1/n\), para somar \(\nu\) é preciso ter pelo menos \(\nu n\) multiplicadores positivos, o que prova (2). \(\square\)
Assim, escolher \(\nu = 0{,}1\) significa, aproximadamente, “aceito até 10% de pontos violando a margem”. Os dois parâmetros estão relacionados: para cada \(\nu\) há um \(C\) que produz a mesma solução, mas \(\nu\) é mais fácil de interpretar e de escolher. Em R, use svm(..., type = "nu-classification", nu = 0.1); em Python, sklearn.svm.NuSVC.
14.15 SVM de Uma Classe e Detecção de Anomalias
Em detecção de fraudes, falhas de equipamentos ou intrusões em redes, frequentemente só dispomos de exemplos de comportamento normal. O SVM de uma classe (Schölkopf et al. 2001) estima uma região do espaço que contém a maior parte desses dados; pontos fora dela são declarados anômalos. A formulação separa os dados (mapeados por \(\phi\)) da origem com margem máxima: \[ \begin{aligned} \min_{\mathbf{w},\, \boldsymbol{\xi},\, \rho} \quad & \frac{1}{2}\|\mathbf{w}\|^2 + \frac{1}{\nu n}\sum_{i=1}^n \xi_i - \rho \\ \text{s.a.} \quad & \mathbf{w}^\top\phi(\mathbf{x}_i) \geq \rho - \xi_i, \quad \xi_i \geq 0, \end{aligned} \] e a função de decisão é \(g(\mathbf{x}) = \operatorname{sign}\left(\sum_i \alpha_i K(\mathbf{x}_i, \mathbf{x}) - \rho\right)\), com \(+1\) para “normal” e \(-1\) para “anômalo”. Com o kernel RBF, \(K(\mathbf{x}, \mathbf{x}) = 1\) para todo \(\mathbf{x}\): todos os pontos mapeados estão sobre uma esfera no espaço de atributos, e separar da origem equivale a “recortar uma calota” dessa esfera — no espaço original, uma região fechada em torno dos dados. Vale uma propriedade \(\nu\) análoga: \(\nu\) é cota superior para a fração de erros de margem (\(\xi_i > 0\)) e cota inferior para a fração de vetores de suporte; assim, a fração de pontos de treinamento declarados anômalos fica próxima de \(\nu\) (pequenas discrepâncias ocorrem por causa de pontos exatamente sobre a fronteira e da tolerância numérica do solucionador). O código ao final do capítulo ilustra o método.
14.16 Escalonamento das Variáveis: Passo Obrigatório
Assim como no k-NN, o SVM é sensível à escala das variáveis: tanto o termo \(\|\mathbf{w}\|^2\) quanto os kernels RBF e polinomial dependem de produtos internos e distâncias euclidianas. Uma variável medida em reais (por exemplo, renda de R$ 10.000,00) dominará outra medida em anos (idade de 25 anos).
Por isso, é obrigatório padronizar as variáveis, tipicamente para média 0 e desvio padrão 1:
\[ z_{ij} = \frac{x_{ij} - \bar{x}_j}{s_j}. \]
As médias \(\bar{x}_j\) e os desvios \(s_j\) devem ser calculados somente no conjunto de treinamento e então aplicados ao teste. Em Python, a forma correta é encapsular o StandardScaler e o SVC em um Pipeline, de modo que a validação cruzada reajuste o escalonamento em cada partição. Em R, e1071::svm padroniza por padrão (scale = TRUE) usando as estatísticas do treino.
14.17 Regressão por Vetores de Suporte (SVR)
A ideia do SVM se estende a respostas contínuas \(y_i \in \mathbb{R}\) por meio da Regressão por Vetores de Suporte (Support Vector Regression - SVR). Em vez da perda hinge, usa-se a perda \(\varepsilon\)-insensível:
\[ \ell_\varepsilon(y, f(\mathbf{x})) = \max\{0,\; |y - f(\mathbf{x})| - \varepsilon\}. \]
Erros menores que \(\varepsilon\) não são penalizados: busca-se uma função \(f(\mathbf{x}) = \mathbf{w}^\top\mathbf{x} + b\) que seja a mais “plana” possível (menor \(\|\mathbf{w}\|\)) e que mantenha a maior parte dos pontos dentro de um “tubo” de largura \(2\varepsilon\) ao redor de \(f\):
\[ \min_{\mathbf{w}, b} \; \frac{1}{2}\|\mathbf{w}\|^2 + C\sum_{i=1}^n \ell_\varepsilon\big(y_i, \mathbf{w}^\top\mathbf{x}_i + b\big). \]
Os vetores de suporte são agora os pontos sobre ou fora do tubo. Kernels funcionam exatamente como na classificação. Os hiperparâmetros são \(C\), \(\varepsilon\) e os do kernel. Métodos de regressão e suas métricas são o assunto do próximo capítulo.
14.17.1 Formulação com folgas e o dual do SVR
Como na classificação, a perda não diferenciável é substituída por variáveis de folga — agora duas por observação, \(\xi_i\) para pontos acima do tubo e \(\xi_i^{*}\) para pontos abaixo: \[ \begin{aligned} \min_{\mathbf{w},\, b,\, \boldsymbol{\xi},\, \boldsymbol{\xi}^{*}} \quad & \frac{1}{2}\|\mathbf{w}\|^2 + C\sum_{i=1}^n (\xi_i + \xi_i^{*}) \\ \text{s.a.} \quad & y_i - \mathbf{w}^\top\mathbf{x}_i - b \leq \varepsilon + \xi_i, \\ & \mathbf{w}^\top\mathbf{x}_i + b - y_i \leq \varepsilon + \xi_i^{*}, \\ & \xi_i,\ \xi_i^{*} \geq 0 . \end{aligned} \] No ótimo, \(\xi_i = \max\{0,\ y_i - f(\mathbf{x}_i) - \varepsilon\}\) e \(\xi_i^{*} = \max\{0,\ f(\mathbf{x}_i) - y_i - \varepsilon\}\); no máximo uma delas é positiva, e \(\xi_i + \xi_i^{*} = \ell_\varepsilon(y_i, f(\mathbf{x}_i))\), o que recupera a formulação com a perda \(\varepsilon\)-insensível.
Com multiplicadores \(\alpha_i, \alpha_i^{*} \geq 0\) para as duas primeiras restrições e \(\mu_i, \mu_i^{*} \geq 0\) para as de não negatividade, as condições de estacionariedade são \[ \mathbf{w} = \sum_{i=1}^n (\alpha_i - \alpha_i^{*})\,\mathbf{x}_i, \qquad \sum_{i=1}^n (\alpha_i - \alpha_i^{*}) = 0, \qquad C - \alpha_i - \mu_i = 0, \qquad C - \alpha_i^{*} - \mu_i^{*} = 0 . \] Substituindo no lagrangiano, chega-se ao dual do SVR (Smola e Schölkopf 2004): \[ \begin{aligned} \max_{\boldsymbol{\alpha},\, \boldsymbol{\alpha}^{*}} \quad & -\frac{1}{2}\sum_{i,j}(\alpha_i - \alpha_i^{*})(\alpha_j - \alpha_j^{*})K(\mathbf{x}_i, \mathbf{x}_j) - \varepsilon\sum_i(\alpha_i + \alpha_i^{*}) + \sum_i y_i(\alpha_i - \alpha_i^{*}) \\ \text{s.a.} \quad & \sum_i (\alpha_i - \alpha_i^{*}) = 0, \qquad 0 \leq \alpha_i,\ \alpha_i^{*} \leq C, \end{aligned} \] com função de regressão \(f(\mathbf{x}) = \sum_i (\alpha_i - \alpha_i^{*})K(\mathbf{x}_i, \mathbf{x}) + b\). As condições KKT têm leitura geométrica direta:
- pontos estritamente dentro do tubo (\(|y_i - f(\mathbf{x}_i)| < \varepsilon\)) têm \(\alpha_i = \alpha_i^{*} = 0\) e não contribuem para \(f\) — a esparsidade vem da região plana da perda, como na hinge;
- um ponto não pode estar acima e abaixo do tubo ao mesmo tempo, e de fato \(\alpha_i\alpha_i^{*} = 0\);
- pontos sobre a borda do tubo têm \(0 < \alpha_i < C\) (ou \(0 < \alpha_i^{*} < C\)) e servem para calcular \(b\); pontos fora do tubo têm \(\alpha_i = C\) (ou \(\alpha_i^{*} = C\)).
Exemplo numérico da perda \(\varepsilon\)-insensível. Com \(\varepsilon = 0{,}5\) e predição \(f(\mathbf{x}) = 3\): para \(y = 3{,}2\), o resíduo \(0{,}2\) está dentro do tubo e a perda é \(0\); para \(y = 4\), a perda é \(|1| - 0{,}5 = 0{,}5\) (com \(\xi = 0{,}5\), \(\xi^{*} = 0\)); para \(y = 1\), é \(|-2| - 0{,}5 = 1{,}5\) (com \(\xi = 0\), \(\xi^{*} = 1{,}5\)). Compare com a perda quadrática, que daria \(0{,}04\), \(1\) e \(4\): a perda \(\varepsilon\)-insensível ignora resíduos pequenos e cresce só linearmente com os grandes, o que a torna robusta a valores atípicos, como a perda absoluta (de fato, com \(\varepsilon = 0\) ela é a perda absoluta, e o SVR estima a mediana condicional).
14.18 Complexidade Computacional e SVMs em Larga Escala
O custo do SVM com kernel é dominado pela matriz de Gram \(n \times n\):
| Etapa | Custo típico | Observação |
|---|---|---|
| Cálculo do kernel completo | \(O(n^2 p)\) tempo, \(O(n^2)\) memória | Com \(n = 100.000\), são \(10^{10}\) entradas (80 GB em precisão dupla) |
| Treinamento (SMO/LIBSVM) | entre \(O(n^2)\) e \(O(n^3)\), empiricamente | Depende de \(C\) e do número de vetores de suporte; a LIBSVM usa um cache de colunas do kernel |
| Predição de um ponto | \(O(|\mathcal{S}|\, p)\) | Proporcional ao número de vetores de suporte |
| SVM linear (LIBLINEAR, gradiente estocástico) | \(O(np)\) por época | Não forma a matriz de Gram; escala a milhões de observações |
Como o número de vetores de suporte tende a crescer linearmente com \(n\) em problemas com sobreposição de classes (pois os erros de margem são vetores de suporte), também a predição fica cara em grandes bases. Para contornar essas limitações:
- Kernel linear com solucionadores especializados: quando \(p\) é grande (textos, dados esparsos), o kernel linear costuma ser suficiente, e bibliotecas como a LIBLINEAR (Fan et al. 2008) (usada por
sklearn.svm.LinearSVC) resolvem o primal ou o dual em tempo linear em \(n\). - Aproximações explícitas do kernel: as random Fourier features (Rahimi e Recht 2007) constroem um mapeamento aleatório e finito \(\mathbf{z}(\mathbf{x}) \in \mathbb{R}^D\) com \(\mathbf{z}(\mathbf{x})^\top\mathbf{z}(\mathbf{y}) \approx K(\mathbf{x}, \mathbf{y})\) para o kernel RBF, e em seguida treinam um SVM linear nesses atributos. O método de Nyström faz algo parecido usando uma submatriz da matriz de Gram. Em
scikit-learn, vejaRBFSamplereNystroem. - Subamostragem e decomposição: treinar em amostras ou subproblemas e combinar os resultados.
14.19 Vantagens e Limitações
| Vantagens | Limitações |
|---|---|
| Problema de otimização convexo: solução global e única | Custo de treinamento entre \(O(n^2)\) e \(O(n^3)\): lento para \(n\) muito grande (centenas de milhares) |
| Eficaz em alta dimensão, inclusive com \(p > n\) | Sensível à escolha de kernel, \(C\) e \(\gamma\) |
| Solução esparsa (depende só dos vetores de suporte) | Exige padronização das variáveis |
| Flexível via kernels, inclusive para dados não vetoriais | Não fornece probabilidades diretamente (requer calibração de Platt, mais custosa) |
| Base teórica sólida (teoria de Vapnik) | Modelo pouco interpretável com kernels não lineares |
14.20 Implementação Prática em R
Usaremos o pacote e1071, interface para a LIBSVM (Chang e Lin 2011), com a base iris (3 classes).
# install.packages(c("e1071", "caret"))
library(e1071)
library(caret)   # apenas para createDataPartition e confusionMatrix

data(iris)
set.seed(2024)

# 1. Divisão treino/teste estratificada (70/30)
idx    <- createDataPartition(iris$Species, p = 0.7, list = FALSE)
treino <- iris[idx, ]
teste  <- iris[-idx, ]

# 2. SVM linear (scale = TRUE é o padrão: padroniza com estatísticas do treino)
svm_lin <- svm(Species ~ ., data = treino, kernel = "linear", cost = 1)
summary(svm_lin)          # mostra número de vetores de suporte por classe
svm_lin$index             # índices (no treino) dos vetores de suporte

# 3. SVM com kernel RBF e ajuste de C e gamma por validação cruzada (10-fold)
ajuste <- tune(
  svm, Species ~ ., data = treino, kernel = "radial",
  ranges = list(cost  = 2^(-2:6),
                gamma = 2^(-6:2)),
  tunecontrol = tune.control(cross = 10)
)
summary(ajuste)
ajuste$best.parameters    # melhor combinação (cost, gamma)

melhor <- ajuste$best.model

# 4. Avaliação no conjunto de teste
pred <- predict(melhor, newdata = teste)
confusionMatrix(pred, teste$Species)

# 5. Probabilidades (calibração de Platt): exige probability = TRUE no ajuste
svm_prob <- svm(Species ~ ., data = treino, kernel = "radial",
                cost  = ajuste$best.parameters$cost,
                gamma = ajuste$best.parameters$gamma,
                probability = TRUE)
p <- predict(svm_prob, teste, probability = TRUE)
head(attr(p, "probabilities"))

# 6. Visualização da fronteira em duas variáveis
svm_2d <- svm(Species ~ Petal.Length + Petal.Width, data = treino,
              kernel = "radial", cost = 4, gamma = 0.5)
plot(svm_2d, treino, Petal.Width ~ Petal.Length)
O exemplo a seguir ilustra o efeito de \(\gamma\) no ajuste a dados com estrutura circular, onde o kernel linear falha:
set.seed(1)
n  <- 400
x1 <- runif(n, -2, 2); x2 <- runif(n, -2, 2)
y  <- factor(ifelse(x1^2 + x2^2 < 1.5, "dentro", "fora"))
df <- data.frame(x1, x2, y)

for (g in c(0.01, 1, 100)) {
  m  <- svm(y ~ ., data = df, kernel = "radial", cost = 1, gamma = g)
  cv <- svm(y ~ ., data = df, kernel = "radial", cost = 1, gamma = g, cross = 5)
  cat(sprintf("gamma = %6.2f | VS = %3d | acc treino = %.3f | acc CV = %.3f\n",
              g, m$tot.nSV, mean(predict(m) == df$y), cv$tot.accuracy / 100))
}
# Espera-se: gamma pequeno -> underfitting; gamma = 1 -> bom; gamma = 100 ->
# acurácia de treino perto de 1, mas CV pior (overfitting).
O código a seguir confere o exemplo resolvido de margem suave e ilustra o \(\nu\)-SVM. Atenção a um detalhe da LIBSVM: ela trata como classe “positiva” a classe da primeira observação, de modo que ordenamos os dados para começar por \(y = +1\).
library(e1071)
x <- c(1, 2, -1.5, -2, -1)
y <- c(1, 1, 1, -1, -1)
m <- svm(x = matrix(x), y = factor(y), kernel = "linear",
         cost = 1, scale = FALSE)
alfa_y <- numeric(length(x)); alfa_y[m$index] <- m$coefs   # alpha_i * y_i
w <- sum(alfa_y * x); b <- -m$rho
f <- w * x + b
round(c(w = w, b = b), 4)
#>      w      b
#> 0.6667 0.3333
round(data.frame(x, y, alfa = abs(alfa_y), f, xi = pmax(0, 1 - y * f)), 4)
#>      x  y   alfa       f     xi
#> 1  1.0  1 0.3889  1.0000 0.0000
#> 2  2.0  1 0.0000  1.6667 0.0000
#> 3 -1.5  1 1.0000 -0.6667 1.6667
#> 4 -2.0 -1 0.3889 -1.0000 0.0000
#> 5 -1.0 -1 1.0000 -0.3333 0.6667

# nu-SVM na base iris: nu controla a fração de vetores de suporte
for (nu in c(0.05, 0.2, 0.5)) {
  m_nu <- svm(Species ~ ., data = iris, type = "nu-classification",
              kernel = "radial", nu = nu)
  cat(sprintf("nu = %.2f | fração de VS = %.3f\n", nu, m_nu$tot.nSV / nrow(iris)))
}
14.21 Implementação Prática em Python
Em Python, usamos scikit-learn (Pedregosa et al. 2011). Observe o uso de Pipeline para evitar vazamento de dados no escalonamento.
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, GridSearchCV, StratifiedKFold
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.metrics import classification_report, confusion_matrix

# 1. Dados: diagnóstico de câncer de mama (30 variáveis, 2 classes)
X, y = load_breast_cancer(return_X_y=True)
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42
)

# 2. Pipeline: padronização + SVM
pipe = Pipeline([
    ("scaler", StandardScaler()),
    ("svm", SVC())
])

# 3. Grade de hiperparâmetros (kernels linear e RBF)
grade = [
    {"svm__kernel": ["linear"], "svm__C": [0.01, 0.1, 1, 10, 100]},
    {"svm__kernel": ["rbf"],    "svm__C": [0.1, 1, 10, 100],
     "svm__gamma": [1e-4, 1e-3, 1e-2, 1e-1, 1]},
]

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
busca = GridSearchCV(pipe, grade, cv=cv, scoring="accuracy", n_jobs=-1)
busca.fit(X_tr, y_tr)

print("Melhores hiperparâmetros:", busca.best_params_)
print(f"Acurácia média na validação cruzada: {busca.best_score_:.3f}")

# 4. Avaliação no teste
y_pred = busca.predict(X_te)
print(confusion_matrix(y_te, y_pred))
print(classification_report(y_te, y_pred))

# 5. Inspecionando os vetores de suporte do melhor modelo
modelo = busca.best_estimator_.named_steps["svm"]
print("Vetores de suporte por classe:", modelo.n_support_)
print("Coeficientes duais (alpha_i * y_i) - primeiros 5:", modelo.dual_coef_[0][:5])
Exemplo didático reproduzindo o exercício resolvido de margem máxima (um \(C\) muito grande aproxima a margem rígida):
import numpy as np
from sklearn.svm import SVC

X = np.array([[1, 1], [0, 2], [3, 3], [4, 2]])
y = np.array([-1, -1, 1, 1])

svm = SVC(kernel="linear", C=1e6).fit(X, y)
print("w =", svm.coef_[0])          #> w = [0.5 0.5]
print("b =", svm.intercept_[0])     #> b = -2.0
print("margem =", 1 / np.linalg.norm(svm.coef_[0]))   #> margem ~ 1.414
print("vetores de suporte:\n", svm.support_vectors_)
Por fim, um exemplo de SVR com kernel RBF:
import numpy as np
from sklearn.svm import SVR
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

rng = np.random.default_rng(0)
x = np.sort(rng.uniform(0, 5, 120)).reshape(-1, 1)
y = np.sin(x).ravel() + rng.normal(0, 0.15, 120)

svr = make_pipeline(StandardScaler(), SVR(kernel="rbf", C=10, epsilon=0.1, gamma=0.5))
svr.fit(x, y)
n_vs = len(svr.named_steps["svr"].support_)
print(f"Vetores de suporte: {n_vs} de {len(y)} pontos")  # pontos sobre/fora do tubo
14.21.1 Conferindo o exemplo resolvido de margem suave
import numpy as np
from sklearn.svm import SVC

x = np.array([-2, -1, 1, 2, -1.5]).reshape(-1, 1)
y = np.array([-1, -1, 1, 1, 1])
svm = SVC(kernel="linear", C=1).fit(x, y)
alfa = np.zeros(len(y)); alfa[svm.support_] = np.abs(svm.dual_coef_[0])
f = svm.decision_function(x)
print("w =", svm.coef_[0][0].round(4), "| b =", svm.intercept_[0].round(4))
print("alfa =", alfa.round(4))
print("xi   =", np.maximum(0, 1 - y * f).round(4))
#> w = 0.6667 | b = 0.3333
#> alfa = [0.3889 1.     0.3889 0.     1.    ]
#> xi   = [0.     0.6667 0.     0.     1.6667]
14.21.2 Verificando a semidefinitude de matrizes de Gram
import numpy as np

X = np.array([[0, 0], [1, 0], [0, 1.0]])
D2 = ((X[:, None, :] - X[None, :, :]) ** 2).sum(axis=-1)
K_rbf = np.exp(-1.0 * D2)                       # RBF com gamma = 1
print(np.linalg.eigvalsh(K_rbf).round(4))       #> [0.543  0.8647 1.5923]

Xs = np.array([[1, 0], [2, 0.0]])
K_sig = np.tanh(Xs @ Xs.T)                      # sigmoide com gamma = 1, r = 0
print(np.linalg.eigvalsh(K_sig).round(4))       #> [-0.0909  1.8518]  -> não é PSD
14.21.3 Propriedade \(\nu\), calibração de Platt e SVM de uma classe
import numpy as np
from sklearn.datasets import make_moons, load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import NuSVC, SVC, OneClassSVM
from sklearn.calibration import CalibratedClassifierCV
from sklearn.metrics import brier_score_loss, log_loss

# 1. nu-SVM: fração de alfas no limite <= nu <= fração de vetores de suporte
X, y = make_moons(n_samples=400, noise=0.3, random_state=0)
for nu in (0.2, 0.4, 0.6):
    m = NuSVC(nu=nu, kernel="rbf", gamma=1).fit(X, y)
    a = np.abs(m.dual_coef_[0])
    limitados = np.isclose(a, a.max(), rtol=1e-3).sum() / len(y)
    print(f"nu = {nu}: fração de VS = {len(m.support_) / len(y):.3f} | "
          f"alfas no limite = {limitados:.3f} | erro treino = {1 - m.score(X, y):.3f}")
#> nu = 0.2: fração de VS = 0.343 | alfas no limite = 0.160 | erro treino = 0.098
#> nu = 0.4: fração de VS = 0.412 | alfas no limite = 0.388 | erro treino = 0.100
#> nu = 0.6: fração de VS = 0.613 | alfas no limite = 0.590 | erro treino = 0.125

# 2. Calibração de Platt (method="sigmoid") com validação cruzada interna
X, y = load_breast_cancer(return_X_y=True)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, stratify=y, random_state=42)
svm_platt = CalibratedClassifierCV(
    make_pipeline(StandardScaler(), SVC(kernel="rbf", C=1, gamma="scale")),
    method="sigmoid", cv=5).fit(X_tr, y_tr)
p = svm_platt.predict_proba(X_te)[:, 1]
print(f"Brier = {brier_score_loss(y_te, p):.4f} | log-loss = {log_loss(y_te, p):.4f}")

# 3. SVM de uma classe para detecção de anomalias
rng = np.random.default_rng(0)
X_normal = rng.normal(0, 1, size=(500, 2))                # comportamento normal
X_novos = np.array([[0.2, -0.1], [1.5, 1.0], [4.0, 4.0], [-3.5, 0.5]])
oc = OneClassSVM(kernel="rbf", gamma=0.5, nu=0.05).fit(X_normal)
print("Fração de treino marcada como anômala:", np.mean(oc.predict(X_normal) == -1))
print("Fração de vetores de suporte:", len(oc.support_) / len(X_normal))
print("Novos pontos (+1 normal, -1 anômalo):", oc.predict(X_novos))
#> Novos pontos (+1 normal, -1 anômalo): [ 1  1 -1 -1]
Note que, no \(\nu\)-SVM, a fração de multiplicadores no limite superior (que inclui todos os erros de margem) fica abaixo de \(\nu\), e a fração de vetores de suporte, acima, exatamente como prevê a propriedade \(\nu\).
14.22 Resumo do Capítulo
- Um hiperplano em \(\mathbb{R}^p\) é \(\{\mathbf{x}: \mathbf{w}^\top\mathbf{x} + b = 0\}\); a distância de um ponto a ele é \(|\mathbf{w}^\top\mathbf{x}_0 + b|/\|\mathbf{w}\|\).
- O classificador de margem máxima resolve \(\min \frac{1}{2}\|\mathbf{w}\|^2\) sujeito a \(y_i(\mathbf{w}^\top\mathbf{x}_i + b) \geq 1\), um problema convexo com solução única; a margem é \(1/\|\mathbf{w}\|\).
- No dual, \(\mathbf{w} = \sum_i \alpha_i y_i \mathbf{x}_i\) e apenas os vetores de suporte (\(\alpha_i > 0\)) determinam a fronteira.
- A margem suave introduz folgas \(\xi_i\) e o parâmetro \(C\), que regula o equilíbrio entre viés e variância; equivalentemente, o SVM minimiza a perda hinge com penalidade \(\ell_2\).
- O truque do kernel substitui produtos internos por \(K(\mathbf{x},\mathbf{z}) = \phi(\mathbf{x})^\top\phi(\mathbf{z})\), produzindo fronteiras não lineares sem calcular \(\phi\); kernels válidos satisfazem a condição de Mercer.
- Kernels usuais: linear, polinomial, RBF (com \(\gamma\) controlando o alcance de cada ponto) e sigmoide.
- Problemas multiclasse são resolvidos por um-contra-um ou um-contra-todos; o SVR estende o método à regressão via perda \(\varepsilon\)-insensível.
- A padronização das variáveis e o ajuste conjunto de \(C\) e \(\gamma\) por validação cruzada são etapas indispensáveis.
- A dualidade fraca mostra que todo valor dual é cota inferior do primal; como as restrições são afins, vale a dualidade forte, e no ótimo \(\sum_i \alpha_i = \|\mathbf{w}^{*}\|^2 = 1/M^2\).
- Na margem suave, a derivada em relação às folgas produz a restrição de caixa \(0 \leq \alpha_i \leq C\); as KKT classificam os pontos em não suporte (\(\alpha_i = 0\)), suporte livre (\(0 < \alpha_i < C\), sobre a margem, usados para calcular \(b\)) e suporte limitado (\(\alpha_i = C\)).
- O algoritmo SMO resolve o dual otimizando dois multiplicadores por vez, com atualização analítica e corte no intervalo \([L, H]\).
- Somas, produtos, múltiplos positivos e exponenciais de kernels são kernels; daí decorre a validade do kernel RBF. O kernel sigmoide pode gerar matrizes de Gram indefinidas.
- Cada kernel define um RKHS com propriedade reprodutora; o teorema do representante garante que o minimizador de perda + penalidade crescente na norma é uma combinação de \(K(\mathbf{x}_i, \cdot)\).
- O minimizador populacional da perda hinge é o classificador de Bayes, \(\operatorname{sign}(2\eta - 1)\), enquanto o da logística é o logito; por isso o SVM não fornece probabilidades e requer a calibração de Platt.
- A margem controla a dimensão VC (\(h \leq \min\{R^2/M^2, p\} + 1\)), e o erro leave-one-out é limitado pela fração de vetores de suporte.
- O \(\nu\)-SVM troca \(C\) por \(\nu\), que limita a fração de erros de margem e de vetores de suporte; o SVM de uma classe detecta anomalias; o SVR tem dual com pares \((\alpha_i, \alpha_i^{*})\).
- O custo do SVM com kernel é dominado pela matriz de Gram (\(O(n^2)\) memória); para grandes bases, usam-se SVMs lineares, random Fourier features ou Nyström.
14.23 Exercícios Propostos
- Considere a reta \(H: x_1 - 2x_2 + 3 = 0\). Calcule a distância dos pontos \((1, 1)\), \((0, 0)\) e \((3, 3)\) a \(H\) e indique em que semiespaço cada um se encontra.
- Mostre que, para \(c > 0\), os pares \((\mathbf{w}, b)\) e \((c\mathbf{w}, cb)\) definem o mesmo hiperplano e a mesma regra de classificação. Por que essa propriedade permite impor a normalização \(\min_i y_i(\mathbf{w}^\top\mathbf{x}_i + b) = 1\)?
- Para os pontos \((2, 0)\) e \((0, 0)\) da classe \(-1\) e \((2, 4)\) e \((0, 4)\) da classe \(+1\), determine à mão o hiperplano de margem máxima na forma canônica, a margem e os vetores de suporte.
- A partir do lagrangiano do SVM de margem rígida, derive as condições \(\mathbf{w} = \sum_i\alpha_i y_i\mathbf{x}_i\) e \(\sum_i \alpha_i y_i = 0\) e explique, com base na folga complementar, por que pontos afastados da margem têm \(\alpha_i = 0\).
- Mostre que, na solução ótima da margem suave, \(\xi_i = \max\{0, 1 - y_i f(\mathbf{x}_i)\}\) e conclua a equivalência com a minimização da perda hinge penalizada.
- Esboce em um mesmo gráfico, como funções de \(m = yf(\mathbf{x})\), a perda 0-1, a perda hinge e a perda logística \(\log_2(1 + e^{-m})\). Comente as semelhanças e diferenças.
- Mostre que \(K(\mathbf{x}, \mathbf{z}) = (\mathbf{x}^\top\mathbf{z} + 1)^2\), com \(\mathbf{x}, \mathbf{z} \in \mathbb{R}^2\), corresponde a um mapeamento \(\phi: \mathbb{R}^2 \to \mathbb{R}^6\). Escreva \(\phi\) explicitamente e verifique numericamente para \(\mathbf{x} = (1, 0)\) e \(\mathbf{z} = (2, -1)\).
- Mostre que a matriz de Gram de um kernel linear, \(\mathbf{K} = \mathbf{X}\mathbf{X}^\top\), é sempre positiva semidefinida.
- Para o kernel RBF, calcule \(K(\mathbf{x}, \mathbf{z})\) para \(\mathbf{x} = (0, 0)\) e \(\mathbf{z} = (1, 1)\) com \(\gamma \in \{0{,}01;\, 0{,}5;\, 10\}\) e interprete o efeito de \(\gamma\) sobre a fronteira de decisão.
- Quantos classificadores binários são treinados nas abordagens um-contra-um e um-contra-todos para um problema com 26 classes (por exemplo, letras do alfabeto)? Discuta vantagens de cada uma.
- Usando a base
irisapenas com as classesversicolorevirginicae as variáveisPetal.LengthePetal.Width, ajuste SVMs lineares comcost\(\in \{0{,}01; 1; 100\}\). Registre o número de vetores de suporte e plote as fronteiras. Relacione com o dilema viés-variância.
- Usando a base
- (Python) Gere dados com
sklearn.datasets.make_moons(n_samples=500, noise=0.25). Compare, por validação cruzada de 5 partições, SVMs com kernels linear, polinomial (grau 3) e RBF, ajustando \(C\) e \(\gamma\) comGridSearchCV. Qual kernel vence? Por quê? - (Python) Repita o exemplo com
load_breast_cancersem oStandardScaler. Compare a acurácia e o tempo de treinamento e explique a diferença. - (R ou Python) Ajuste um SVR com kernel RBF aos dados \(y = \sin(x) + \varepsilon\) e estude o efeito de \(\varepsilon \in \{0{,}01; 0{,}1; 0{,}5\}\) sobre o número de vetores de suporte e o RMSE de teste.
- Demonstre a dualidade fraca para o SVM de margem suave e use-a para mostrar que, no ótimo, \(\sum_i \alpha_i = \|\mathbf{w}^{*}\|^2 + C\sum_i\xi_i^{*}\). Verifique a identidade no exemplo resolvido unidimensional.
- No exemplo de margem suave unidimensional, refaça os cálculos com \(C = 0{,}25\). Quais pontos passam a ser vetores de suporte limitados? (Resposta para conferência: \(w = 0{,}625\) e \(b = 0{,}3125\).)
- Execute à mão um passo do SMO para os pontos B \(= (0, 2)\), \(y = -1\), e D \(= (4, 2)\), \(y = +1\), partindo de \(\boldsymbol{\alpha} = \mathbf{0}\) e \(b = 0\). Que hiperplano resulta?
- Prove que, se \(K_1\) é um kernel válido e \(g\) é uma função positiva, então \(K(\mathbf{x}, \mathbf{z}) = g(\mathbf{x})K_1(\mathbf{x}, \mathbf{z})g(\mathbf{z})\) é um kernel válido. Use o resultado para mostrar que o kernel “normalizado” \(K_1(\mathbf{x}, \mathbf{z})/\sqrt{K_1(\mathbf{x}, \mathbf{x})K_1(\mathbf{z}, \mathbf{z})}\) é válido.
- Mostre que \(K(\mathbf{x}, \mathbf{z}) = \|\mathbf{x} - \mathbf{z}\|^2\) não é um kernel válido, encontrando dois pontos cuja matriz de Gram tem autovalor negativo.
- Usando o teorema do representante com perda quadrática, deduza a solução \(\boldsymbol{\beta} = (\mathbf{K} + \lambda\mathbf{I})^{-1}\mathbf{y}\) da regressão ridge com kernel.
- Mostre que o minimizador do risco condicional da perda quadrática \((1 - yf)^2\) é \(f^{*} = 2\eta - 1\). Essa perda é consistente para classificação?
- Mostre que retas em \(\mathbb{R}^2\) fragmentam três pontos não colineares, desenhando as 8 rotulações, e explique por que não fragmentam os quatro vértices de um quadrado.
- Um SVM treinado com \(n = 1.000\) observações tem 85 vetores de suporte. O que o limite leave-one-out garante? Por que esse limite pode ser muito frouxo em problemas com grande sobreposição de classes?
- Com os parâmetros de Platt \(A = -1{,}5\) e \(B = 0{,}3\), calcule \(\hat{P}(Y = 1 \mid f)\) para \(f \in \{-1, 0, 1\}\) e encontre o valor de \(f\) em que a probabilidade é \(1/2\).
- Demonstre a propriedade \(\nu\) a partir das condições KKT do \(\nu\)-SVM, supondo \(\rho > 0\).
- (Python) Use
OneClassSVMcom \(\nu \in \{0{,}01; 0{,}05; 0{,}2\}\) em dados normais bivariados e compare a fração de pontos de treinamento declarados anômalos com \(\nu\). - (Python) Compare tempo de treinamento e acurácia de
SVC(kernel="rbf")e de umPipelinecomRBFSampler(n_components=500)seguido deLinearSVC, para \(n \in \{2.000;\ 10.000;\ 50.000\}\) observações simuladas.
14.24 Leituras Recomendadas
- Cortes e Vapnik (1995) (Cortes e Vapnik 1995): artigo seminal que introduz a margem suave.
- Boser, Guyon e Vapnik (1992) (Boser, Guyon, e Vapnik 1992): primeira combinação de margem máxima com kernels.
- Vapnik (1995) (Vapnik 1995): fundamentos da teoria do aprendizado estatístico que justificam a maximização da margem.
- James et al. (2013) (James et al. 2013), Capítulo 9: exposição didática do SVM com laboratórios em R.
- Hastie, Tibshirani e Friedman (2009) (Hastie, Tibshirani, e Friedman 2009), Capítulo 12: tratamento mais aprofundado, incluindo a visão de perda + penalidade e o SVR.
- Schölkopf e Smola (2002) (Schölkopf e Smola 2002): referência completa sobre métodos de kernel.
- Chang e Lin (2011) (Chang e Lin 2011): descrição da LIBSVM, biblioteca utilizada por
e1071escikit-learn. - Burges (1998) (Burges 1998): tutorial clássico, com a derivação detalhada do dual e das condições KKT.
- Boyd e Vandenberghe (2004) (Boyd e Vandenberghe 2004): referência sobre otimização convexa, dualidade de Lagrange e condições KKT.
- Platt (1998) (Platt 1998) e Platt (1999) (Platt 1999): o algoritmo SMO e a calibração de probabilidades.
- Schölkopf et al. (2000, 2001) (Schölkopf et al. 2000, 2001): o \(\nu\)-SVM e o SVM de uma classe.
- Aronszajn (1950) (Aronszajn 1950) e Kimeldorf e Wahba (1971) (Kimeldorf e Wahba 1971): teoria dos núcleos reprodutores e a origem do teorema do representante; a versão geral está em Schölkopf, Herbrich, e Smola (2001).
- Smola e Schölkopf (2004) (Smola e Schölkopf 2004): tutorial sobre a regressão por vetores de suporte.
- Bartlett, Jordan e McAuliffe (2006) (Bartlett, Jordan, e McAuliffe 2006): consistência de perdas convexas, incluindo a hinge.
- Steinwart e Christmann (2008) (Steinwart e Christmann 2008): tratamento matemático completo do SVM.
- Shawe-Taylor e Cristianini (2004) (Shawe-Taylor e Cristianini 2004): métodos de kernel para análise de padrões.
- Rahimi e Recht (2007) (Rahimi e Recht 2007) e Fan et al. (2008) (Fan et al. 2008): SVMs em larga escala.