1 Conceitos de Ciência de Dados
Neste capítulo inicial, exploramos a definição e o escopo da Ciência de Dados, seus pilares essenciais e como essa disciplina se posiciona na resolução de problemas do mundo real. Além disso, estabelecemos o vocabulário básico que será utilizado ao longo de todo o livro: o que são dados, como eles se classificam, quais são as escalas de medida, como se organiza um projeto de dados do início ao fim, quais profissionais participam dele e quais cuidados éticos e legais devem acompanhá-lo.
1.1 O que é Ciência de Dados?
Nos últimos anos, você certamente se deparou com manchetes declarando que a Ciência de Dados (ou Data Science) é a área tecnológica com maior crescimento no mundo, culminando com o famoso artigo do Harvard Business Review que classificou o cientista de dados como o “emprego mais atraente (sexy) do século 21” (Davenport e Patil 2012). O tema está em alta em livros, jornais de negócios, mídias sociais, conferências acadêmicas e corporativas.
Mas como podemos, afinal, definir a Ciência de Dados?
A Ciência de Dados é um campo interdisciplinar que tem como princípio fundamental a extração de conhecimento e insights acionáveis a partir de dados estruturados e não estruturados. Para atingir esse objetivo, ela utiliza conceitos e ferramentais oriundos da matemática, estatística e ciência da computação. O propósito final é aplicar esse conhecimento para prever eventos futuros, auxiliar na tomada de decisões estratégicas e criar produtos orientados a dados.
Atualmente, o termo Data Science está associado e, por vezes, é usado como sinônimo de diversas áreas correlatas, tais como:
- Business Analytics (Análise de Negócios)
- Business Intelligence (Inteligência de Negócios)
- Pesquisa Operacional
- Competitive Intelligence (Inteligência Competitiva)
- Análise de Dados e Modelagem Preditiva
Embora muitos tratem a Ciência de Dados como uma área inteiramente nova, na verdade ela representa uma evolução natural e uma nova roupagem de campos de pesquisa e atuação que existem há muito tempo. O que mudou e deu força a essa nova nomenclatura foi o recente e estrondoso avanço no hardware e software computacionais, permitindo a coleta, o armazenamento e o processamento de volumes gigantescos de dados (Big Data) a custos extremamente baixos. É nesse contexto de interseção disciplinar que muitas vezes utilizam-se os termos Aprendizado com Estatística (Statistical Learning) e Aprendizado de Máquina (Machine Learning) para descrever algoritmos desenvolvidos para prever, classificar e agrupar a partir de grandes bases de dados (Morettin e Singer 2021).
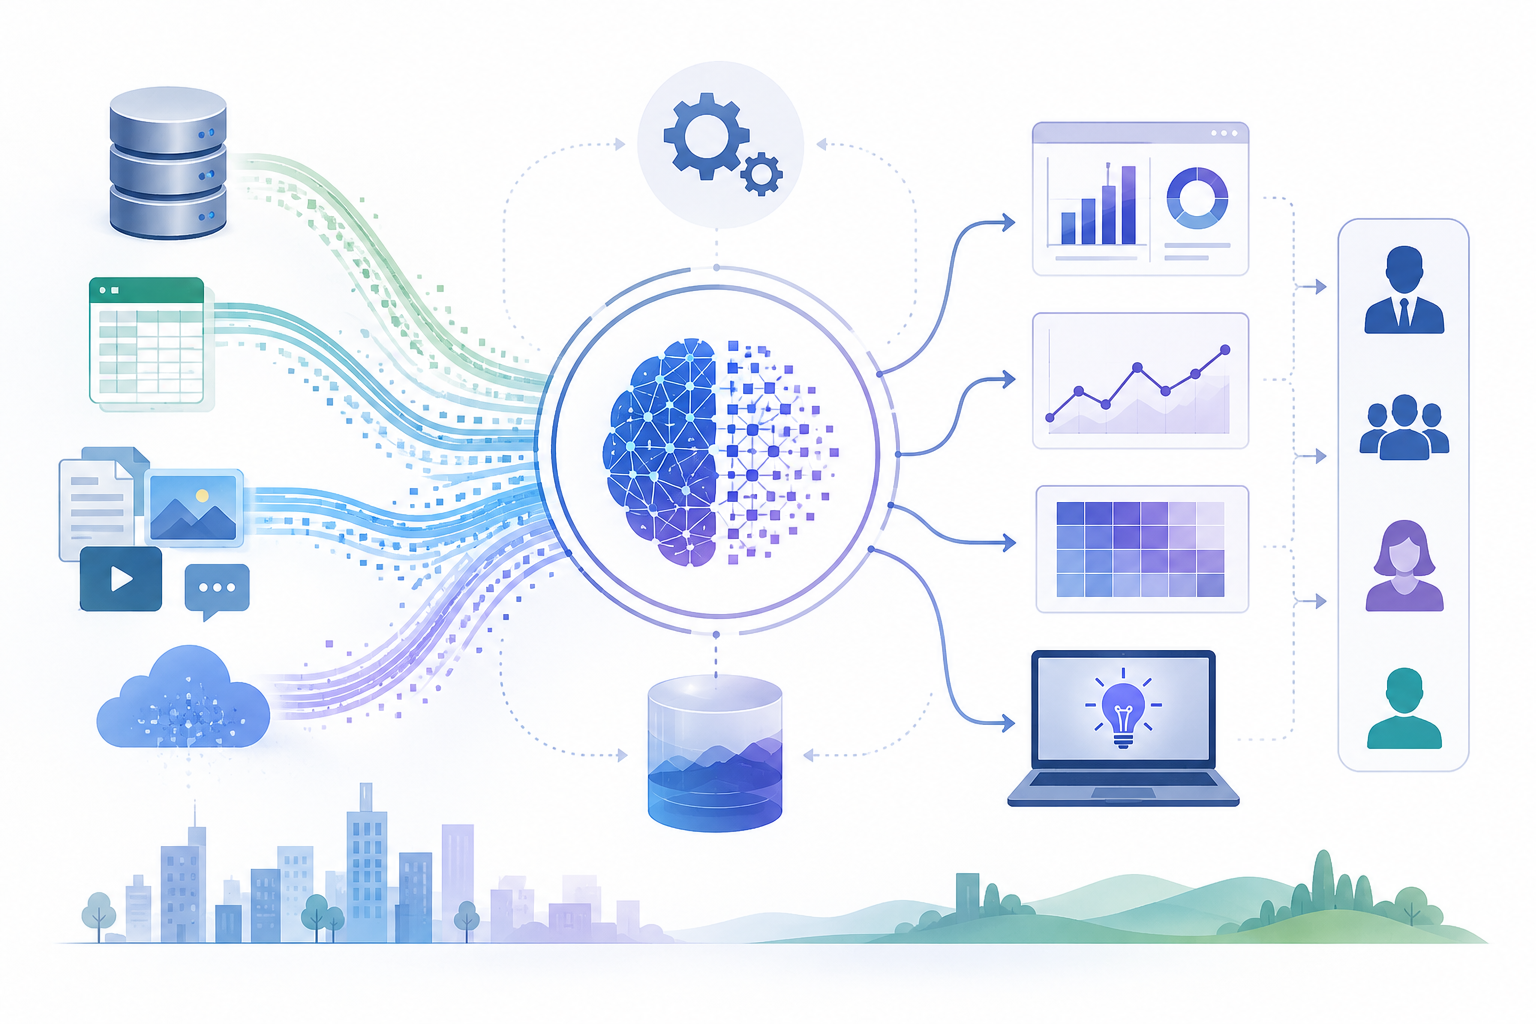
A figura acima ilustra a arquitetura clássica de Business Intelligence (BI): dados de sistemas transacionais são extraídos, transformados e carregados (processo conhecido como ETL, do inglês Extract, Transform, Load) em um repositório central — o data warehouse — a partir do qual se constroem relatórios, painéis (dashboards) e consultas analíticas. A Ciência de Dados herda essa infraestrutura, mas amplia seu objetivo: em vez de apenas responder “o que aconteceu?”, busca também responder “por que aconteceu?”, “o que vai acontecer?” e “o que devemos fazer?” (ver a seção sobre Tipos de Análise, mais adiante).
1.1.1 Uma definição operacional
Uma forma útil de pensar a Ciência de Dados, inspirada em Provost e Fawcett (2013), é como o conjunto de princípios, processos e técnicas para compreender fenômenos por meio da análise (automatizada ou não) de dados. Três elementos dessa definição merecem destaque:
- Princípios: ideias gerais que orientam o raciocínio — por exemplo, a de que um modelo avaliado nos mesmos dados em que foi ajustado tende a parecer melhor do que realmente é (o fenômeno do sobreajuste, que será estudado no Capítulo de Introdução ao Aprendizado de Máquina).
- Processos: sequências organizadas de etapas, como a metodologia CRISP-DM, que discutiremos em detalhe neste capítulo.
- Técnicas: os algoritmos e métodos propriamente ditos — regressão, árvores de decisão, k-vizinhos mais próximos, máquinas de vetores de suporte, k-médias, entre outros, todos estudados nas Partes III e IV deste livro.
O termo “ciência” não é casual. Assim como nas ciências empíricas, o trabalho com dados envolve formular perguntas, propor hipóteses, coletar evidências, testar explicações e, sobretudo, reconhecer a incerteza das conclusões. Um resultado obtido a partir de dados só tem valor científico quando é reprodutível — isto é, quando outra pessoa, com os mesmos dados e o mesmo código, chega ao mesmo resultado. Essa preocupação será retomada nos Capítulos de Git/GitHub e de Markdown/RMarkdown.
1.2 Dado, Informação, Conhecimento e Sabedoria
Antes de prosseguir, é conveniente fixar o significado da palavra mais importante do livro: dado. Na linguagem cotidiana, “dado”, “informação” e “conhecimento” são usados quase como sinônimos, mas na literatura de sistemas de informação eles ocupam níveis distintos de uma hierarquia conhecida como pirâmide DIKW (Data, Information, Knowledge, Wisdom), popularizada por Ackoff (1989).
| Nível | Definição | Exemplo (varejo) |
|---|---|---|
| Dado (data) | Registro bruto de um fato, sem contexto ou interpretação. | 2025-03-14; loja 07; SKU 18832; 3; 29.90 |
| Informação (information) | Dado organizado e contextualizado, que responde a perguntas do tipo “quem?”, “o quê?”, “quando?”, “onde?”. | “A loja 07 vendeu 3 unidades do protetor solar X por R$ 29,90 em 14/03/2025.” |
| Conhecimento (knowledge) | Padrões e relações extraídos da informação, que respondem a “como?”. | “As vendas de protetor solar crescem cerca de duas vezes nas semanas que antecedem feriados prolongados.” |
| Sabedoria (wisdom) | Capacidade de usar o conhecimento para decidir e agir, respondendo a “por quê?” e “o que fazer?”. | “Antecipar a reposição do estoque de protetor solar nas lojas litorâneas duas semanas antes de cada feriado.” |
Do ponto de vista da Ciência de Dados, o trabalho consiste precisamente em subir os degraus da pirâmide: partir de registros brutos (frequentemente desorganizados e incompletos) e chegar a decisões fundamentadas. Cada degrau exige técnicas diferentes: armazenamento e limpeza (dado → informação), análise exploratória e modelagem estatística (informação → conhecimento), e comunicação, avaliação de custos e conhecimento do domínio (conhecimento → sabedoria).
A pirâmide DIKW é um modelo conceitual didático e não uma teoria formal. Ela tem sido criticada por sugerir uma passagem linear e automática de um nível a outro. Na prática, o caminho envolve julgamento humano, iterações e, muitas vezes, retorno aos dados brutos.
1.3 Como Surgiu a Ciência de Dados? (Uma Perspectiva Histórica)
Para compreender o surgimento da Ciência de Dados, é útil fazer uma viagem pela história da estatística e da contagem de dados. Desde a antiguidade, civilizações como a Babilônia, a China e o Egito antigo realizavam censos demográficos por volta de 3.000 A.C. O intuito principal dessas contagens era a taxação e a cobrança de impostos.
A própria Bíblia traz registros históricos de recenseamento. No quarto livro do Antigo Testamento, intitulado Números, há instruções claras dadas a Moisés para realizar um levantamento dos homens de Israel aptos para a guerra. Anos mais tarde, sob o reinado do imperador romano César Augusto, foi emitido o famoso decreto para que se fizesse o censo em todo o Império Romano. Note que a própria palavra “censo” deriva do latim censere, que significa justamente “taxar”.
Na era medieval, em 1085, Guilherme, o Conquistador, ordenou a realização de um censo estatístico detalhado na Inglaterra sobre terras, gado, proprietários e trabalhadores, o qual deu origem ao famoso volume Domesday Book. Posteriormente, no século XVII, John Graunt iniciou na Inglaterra o que chamou de “aritmética política”, analisando registros de nascimentos e mortes. Graunt concluiu que o nascimento de meninos superava ligeiramente o de meninas, lançando as bases das tábuas de mortalidade utilizadas até hoje pelas seguradoras.
Nos séculos XVIII e XIX, a estatística consolidou-se como disciplina matemática: a teoria das probabilidades (Bernoulli, Laplace, Gauss), o método dos mínimos quadrados (Legendre e Gauss), a correlação e a regressão (Galton e Pearson). No século XX, Fisher, Neyman e Pearson estabeleceram as bases da inferência estatística moderna — planejamento de experimentos, testes de hipóteses e estimação por máxima verossimilhança —, enquanto o surgimento dos computadores eletrônicos, a partir da década de 1940, abriu caminho para a análise automatizada de grandes conjuntos de dados.
Embora a necessidade de dar sentido aos dados seja antiga, a evolução do termo Data Science como uma disciplina dedicada à análise de grandes volumes de dados (Big Data) seguiu uma linha do tempo marcante:
- 1962 (John Tukey): O renomado estatístico John Tukey publicou o artigo “The Future of Data Analysis” (Tukey 1962), argumentando que a análise de dados deveria ser considerada uma ciência empírica (focada na experimentação e observação) e não apenas um ramo da matemática pura. Em 1977, Tukey publicou o livro “Exploratory Data Analysis” (Tukey 1977), defendendo que a Análise Exploratória (sugerir hipóteses) e a Análise Confirmatória (testar hipóteses) devem caminhar de mãos dadas.
- 1996 (Kobe, Japão): A Federação Internacional de Sociedades Classificadoras (IFCS) realizou a conferência “Data Science, Classification, and Related Methods”, marcando a primeira vez que o termo apareceu formalmente no título de um evento internacional de destaque.
- 1996 (KDD): Fayyad, Piatetsky-Shapiro e Smyth sistematizaram o processo de Descoberta de Conhecimento em Bases de Dados (Knowledge Discovery in Databases — KDD), no qual a mineração de dados (data mining) é apenas uma das etapas (Fayyad, Piatetsky-Shapiro, e Smyth 1996).
- 2001 (William Cleveland): Cleveland propôs um plano de ação para expandir a estatística em direção à computação com dados, sugerindo explicitamente o nome Data Science para o campo ampliado (Cleveland 2001).
- 2001 (Leo Breiman): O estatístico Leo Breiman publicou o influente artigo “Statistical Modeling: The Two Cultures” (Breiman 2001). Breiman descreveu duas culturas na análise de dados: a cultura dos modelos probabilísticos estocásticos (onde se assume que os dados seguem uma distribuição conhecida) e a cultura dos modelos algorítmicos (que tratam o mecanismo gerador de dados como desconhecido, dando origem aos métodos de aprendizado de máquina não paramétricos).
- 2010 (Mike Loukides): Loukides descreveu os cientistas de dados como profissionais interdisciplinares capazes de lidar com todas as etapas de um problema, desde a coleta e tratamento até as conclusões e a construção de produtos interativos (Loukides 2010), resumindo a profissão com a célebre pergunta provocativa: “Aqui estão os dados; o que você pode fazer com eles?”
- 2012 (Davenport e Patil): O artigo da Harvard Business Review que chamou o cientista de dados de “o emprego mais sexy do século 21” popularizou a profissão no meio corporativo (Davenport e Patil 2012).
- 2017 (David Donoho): No artigo “50 Years of Data Science”, Donoho revisitou o legado de Tukey e argumentou que boa parte do que se chama Ciência de Dados é, essencialmente, a “estatística ampliada” que Tukey já defendia (Donoho 2017).
1.4 Estatística e Ciência de Dados
Para um estudante de Estatística, uma pergunta natural é: qual a diferença entre Estatística e Ciência de Dados? Não existe resposta única, mas dois textos ajudam a organizar o debate.
1.4.1 As duas culturas de Breiman
Considere uma variável resposta \(Y\) e um vetor de variáveis explicativas \(X = (X_1, X_2, \ldots, X_p)\). Em praticamente todo problema de modelagem supervisionada, supõe-se que existe uma relação da forma
\[ Y = f(X) + \varepsilon, \tag{1.1}\]
em que \(f\) é uma função fixa, porém desconhecida, que representa a informação sistemática que \(X\) fornece sobre \(Y\), e \(\varepsilon\) é um termo de erro aleatório, independente de \(X\), com \(\mathbb{E}(\varepsilon) = 0\) e \(\operatorname{Var}(\varepsilon) = \sigma^2\) (James et al. 2013).
Breiman (2001) descreveu duas maneiras de lidar com a Equação 1.1:
- Cultura da modelagem de dados (data modeling culture): assume-se que os dados são gerados por um modelo estocástico específico, por exemplo, \(f(X) = \beta_0 + \beta_1 X_1 + \cdots + \beta_p X_p\) com \(\varepsilon \sim \mathcal{N}(0, \sigma^2)\). O objetivo central é inferência: estimar os parâmetros \(\beta_j\), construir intervalos de confiança, testar hipóteses do tipo \(H_0: \beta_j = 0\) e interpretar o efeito de cada variável. A validação é feita por testes de aderência e análise de resíduos.
- Cultura da modelagem algorítmica (algorithmic modeling culture): trata-se \(f\) como uma “caixa-preta” e busca-se um algoritmo \(\hat{f}\) que produza boas previsões \(\hat{Y} = \hat{f}(X)\) para observações novas. O objetivo central é predição, e a validação é feita pela acurácia preditiva em dados não utilizados no ajuste. Árvores de decisão, florestas aleatórias, redes neurais e máquinas de vetores de suporte pertencem a essa cultura.
Breiman, que trabalhou por anos como consultor antes de retornar à academia, estimou que cerca de 98% dos estatísticos da época pertenciam à primeira cultura e criticou a comunidade estatística por se restringir a ela. Hoje a visão predominante é que as duas culturas são complementares: em muitos problemas queremos tanto prever bem quanto entender o mecanismo.
| Aspecto | Inferência | Predição |
|---|---|---|
| Pergunta típica | “Qual o efeito de \(X_j\) sobre \(Y\)?” | “Qual será o valor de \(Y\) para este novo \(X\)?” |
| Interesse em \(\hat{f}\) | Forma e parâmetros interpretáveis | Qualidade de \(\hat{Y}\); \(\hat{f}\) pode ser caixa-preta |
| Modelos típicos | Regressão linear/logística, modelos lineares generalizados | Florestas aleatórias, boosting, redes neurais, SVM |
| Validação | Testes de hipóteses, análise de resíduos | Validação cruzada, conjunto de teste |
| Exemplo | Efeito do tabagismo sobre a pressão arterial | Probabilidade de um cliente cancelar um contrato |
1.4.2 Erro redutível e erro irredutível
Quando o objetivo é predição, uma decomposição simples ajuda a entender o limite do que qualquer modelo pode alcançar. Fixe um valor \(x_0\) e considere a previsão \(\hat{Y} = \hat{f}(x_0)\), tomando \(\hat{f}\) como fixa. Usando Equação 1.1 e o fato de que \(\mathbb{E}(\varepsilon) = 0\):
\[ \begin{aligned} \mathbb{E}\left[(Y - \hat{Y})^2 \mid X = x_0\right] &= \mathbb{E}\left[(f(x_0) + \varepsilon - \hat{f}(x_0))^2\right] \\ &= [f(x_0) - \hat{f}(x_0)]^2 + 2[f(x_0) - \hat{f}(x_0)]\,\mathbb{E}(\varepsilon) + \mathbb{E}(\varepsilon^2) \\ &= \underbrace{[f(x_0) - \hat{f}(x_0)]^2}_{\text{erro redutível}} + \underbrace{\operatorname{Var}(\varepsilon)}_{\text{erro irredutível}}. \end{aligned} \]
O erro redutível pode ser diminuído escolhendo-se um método melhor para estimar \(f\); o erro irredutível \(\sigma^2\) não pode ser eliminado por nenhum modelo, pois decorre de variáveis não medidas e da variabilidade intrínseca do fenômeno (James et al. 2013).
Suponha que a verdadeira relação seja \(f(x) = 2 + 3x\) e que \(\operatorname{Var}(\varepsilon) = 4\). Um analista ajustou o modelo \(\hat{f}(x) = 2{,}5 + 2{,}8x\). Para \(x_0 = 5\):
- Valor verdadeiro da média: \(f(5) = 2 + 3 \cdot 5 = 17\).
- Previsão: \(\hat{f}(5) = 2{,}5 + 2{,}8 \cdot 5 = 16{,}5\).
- Erro redutível: \((17 - 16{,}5)^2 = 0{,}25\).
- Erro irredutível: \(4\).
- Erro quadrático esperado: \(0{,}25 + 4 = 4{,}25\).
Mesmo que o analista descobrisse exatamente \(f\), o erro quadrático esperado nunca seria menor que \(4\). Note que, para \(x_0 = 20\), o erro redutível seria \((62 - 58{,}5)^2 = 12{,}25\): o mesmo modelo pode ser bom numa região e ruim em outra.
A decomposição acima é o ponto de partida do dilema viés-variância, que será formalizado no Capítulo de Introdução ao Aprendizado de Máquina.
1.4.3 A “Ciência de Dados Ampliada” de Donoho
Donoho (2017) propõe que a Ciência de Dados ampliada (Greater Data Science) é composta por seis divisões:
- Coleta, preparação e exploração de dados.
- Representação e transformação de dados (bancos de dados, formatos, transformações matemáticas como Fourier e wavelets).
- Computação com dados (linguagens de programação, computação distribuída, workflows).
- Modelagem de dados (as duas culturas de Breiman).
- Visualização e apresentação de dados.
- Ciência sobre a ciência de dados (estudo empírico de como as análises são feitas, reprodutibilidade, meta-análise).
Segundo Donoho, a estatística acadêmica tradicional concentrou-se quase exclusivamente na divisão 4; a Ciência de Dados resgata as demais. Esse panorama justifica a organização deste livro: linguagens e computação (Parte I), exploração e visualização (Parte II) e modelagem (Partes III e IV).
1.5 O Cenário Atual: Big Data e Conectividade
Atualmente, o volume de dados gerado no mundo cresce em escala exponencial. Estima-se que existam mais de 50 bilhões de dispositivos conectados à internet e mais de 7,4 bilhões de pessoas gerando dados diariamente. Essa rede massiva gera anualmente um volume de dados estimado em zettabytes.
Para entender a grandeza desses dados, revisamos a estrutura de armazenamento:
| Unidade | Símbolo | Equivalência |
|---|---|---|
| Bit | b | Menor unidade de informação (0 ou 1) |
| Byte | B | 8 bits (representa um caractere) |
| Kilobyte | KB | \(1.024\) Bytes (uma página de texto plano) |
| Megabyte | MB | \(1.024\) KB (uma imagem de baixa resolução) |
| Gigabyte | GB | \(1.024\) MB (um filme em definição padrão) |
| Terabyte | TB | \(1.024\) GB (armazenamento de um computador moderno) |
| Petabyte | PB | \(1.024\) TB (o arquivo fotográfico de uma grande rede social) |
| Exabyte | EB | \(1.024\) PB |
| Zettabyte | ZB | \(1.024\) EB |
| Yottabyte | YB | \(1.024\) ZB (equivale a todas as centrais de dados do mundo) |
A tabela acima segue a convenção tradicional da computação, em que cada unidade vale \(2^{10} = 1.024\) vezes a anterior. Pelo Sistema Internacional (SI), porém, o prefixo quilo significa \(10^3\), e por isso a Comissão Eletrotécnica Internacional (IEC) recomenda os prefixos binários kibibyte (KiB \(= 2^{10}\) B), mebibyte (MiB \(= 2^{20}\) B), gibibyte (GiB \(= 2^{30}\) B) etc., reservando KB, MB e GB para potências de 10. Fabricantes de discos costumam usar potências de 10, enquanto muitos sistemas operacionais exibem potências de 2 — o que explica por que um disco “de 1 TB” aparece com cerca de 931 GB no computador: \(10^{12} / 2^{30} \approx 931{,}3\).
1.5.1 Exemplo resolvido: quanto ocupa uma tabela?
Um banco registra \(n = 2.000.000\) de transações com \(p = 25\) colunas numéricas, cada uma armazenada como número de ponto flutuante de precisão dupla (8 bytes). O espaço ocupado, desconsiderando índices e metadados, é
\[ n \times p \times 8 = 2 \times 10^6 \times 25 \times 8 = 4 \times 10^8 \text{ bytes}. \]
Em potências de 10, são \(400\) MB; em potências de 2, \(4 \times 10^8 / 2^{20} \approx 381{,}5\) MiB. Uma tabela desse tamanho cabe com folga na memória RAM de um computador pessoal e pode ser analisada diretamente em R ou Python. Se, porém, o banco registrar transações de 10 anos com 200 colunas, o volume cresce para dezenas de gigabytes, e passam a ser necessárias estratégias como leitura em blocos, bancos de dados ou processamento distribuído.
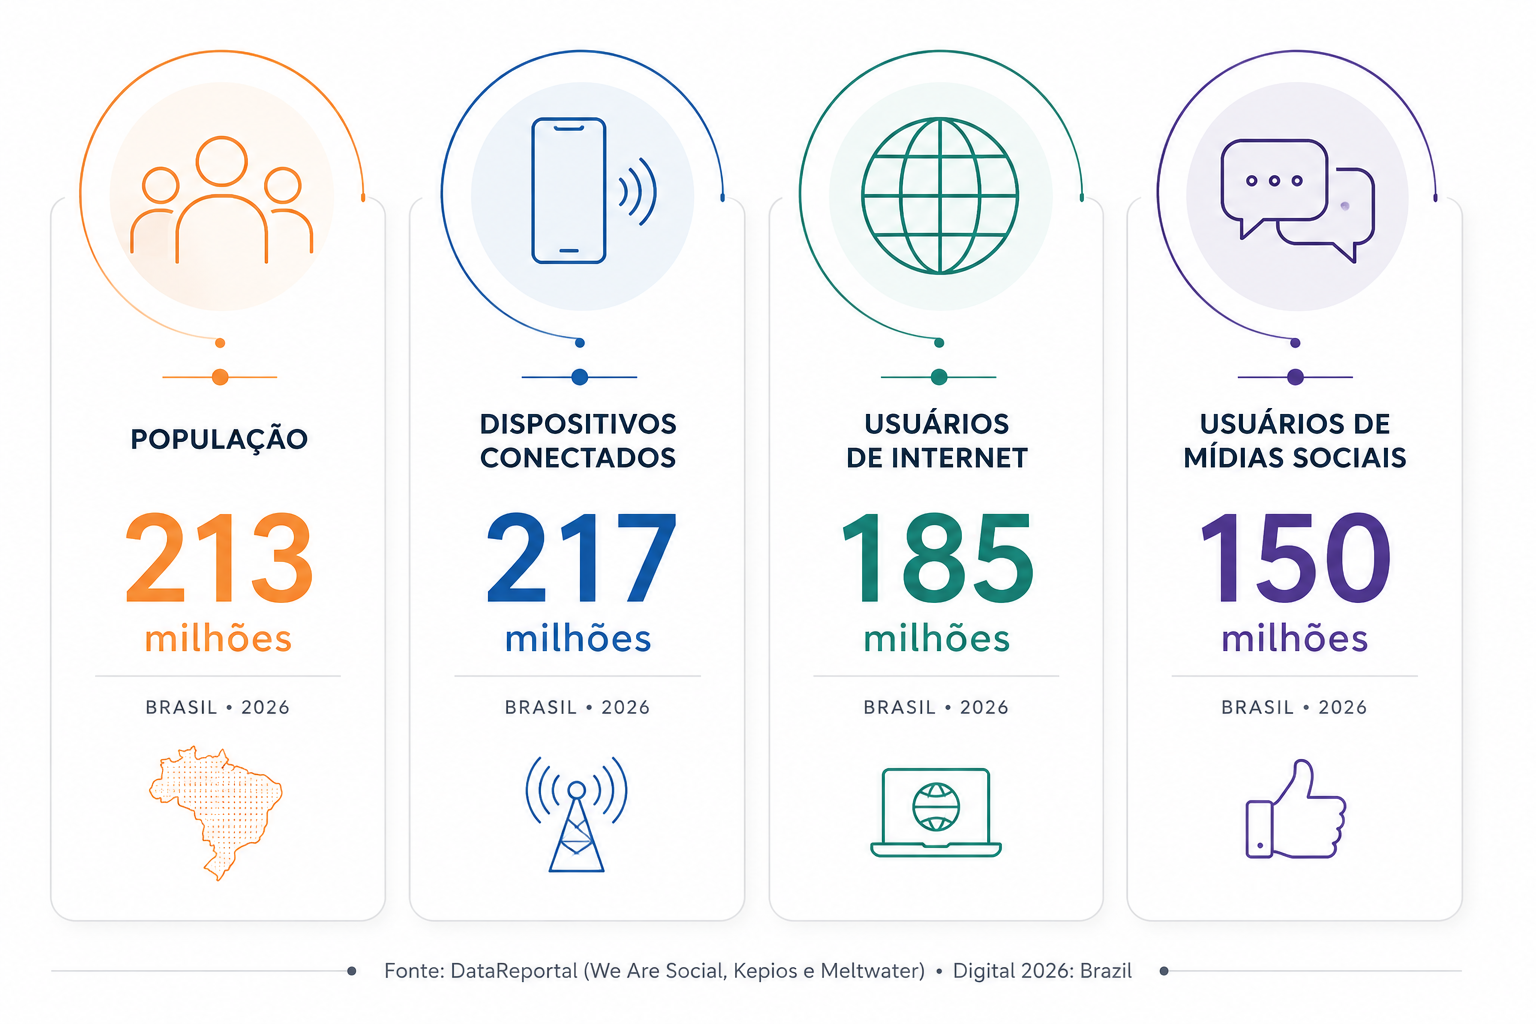
No Brasil, segundo dados do relatório We Are Social 2024, a conectividade digital atinge 92,5% dos domicílios (cerca de 72,5 milhões de lares), e 77% da população utiliza ativamente mídias sociais (Facebook, Instagram, X, YouTube), gerando e trocando quantidades monumentais de informações a cada segundo.
1.5.2 Os “Vs” do Big Data
O termo Big Data não se refere apenas a “muitos dados”. Em uma nota técnica de 2001, Doug Laney caracterizou os desafios da gestão de dados em três dimensões, que ficaram conhecidas como os três Vs (Laney 2001):
- Volume: a quantidade de dados gerados e armazenados, que pode exceder a capacidade de uma única máquina.
- Velocidade (velocity): a taxa com que os dados chegam e precisam ser processados — em lote (batch), de hora em hora, ou em fluxo contínuo (streaming), como em transações de cartão de crédito que exigem detecção de fraude em milissegundos.
- Variedade (variety): a diversidade de formatos e fontes — tabelas, textos, imagens, áudios, registros de sensores, dados de redes sociais.
Ao longo dos anos, outros “Vs” foram acrescentados por autores e empresas, sendo os mais comuns:
- Veracidade (veracity): a confiabilidade e a qualidade dos dados (erros de medição, dados faltantes, registros duplicados, fraudes).
- Valor (value): a capacidade de converter dados em benefício concreto — sem valor, o armazenamento de dados é apenas um custo.
- Variabilidade (variability): mudanças no significado ou na distribuição dos dados ao longo do tempo (por exemplo, o sentido de uma palavra em redes sociais).
Do ponto de vista estatístico, muitos dados não substituem bons dados. Um conjunto gigantesco, mas coletado de forma enviesada (por exemplo, apenas usuários de um aplicativo), pode produzir estimativas precisas, porém erradas. Se o viés de seleção é \(b\), o erro quadrático médio de uma média amostral é aproximadamente \(b^2 + \sigma^2/n\): aumentar \(n\) elimina a variância, mas não o viés.
1.6 Os Três Pilares da Ciência de Dados
Um cientista de dados de alta performance atua na interseção de três grandes áreas do conhecimento humano:
- Matemática e Estatística: Essenciais para a criação de modelos matemáticos e validação estatística de hipóteses, permitindo distinguir padrões reais de ruídos aleatórios.
- Ciência da Computação (Habilidades de Programação): Necessária para a codificação de algoritmos eficientes, estruturação e manipulação de grandes volumes de bancos de dados.
- Conhecimento de Negócio (Domínio): O cientista de dados precisa entender profundamente a área na qual está atuando (saúde, finanças, marketing) para que suas perguntas façam sentido prático e gerem valor real.
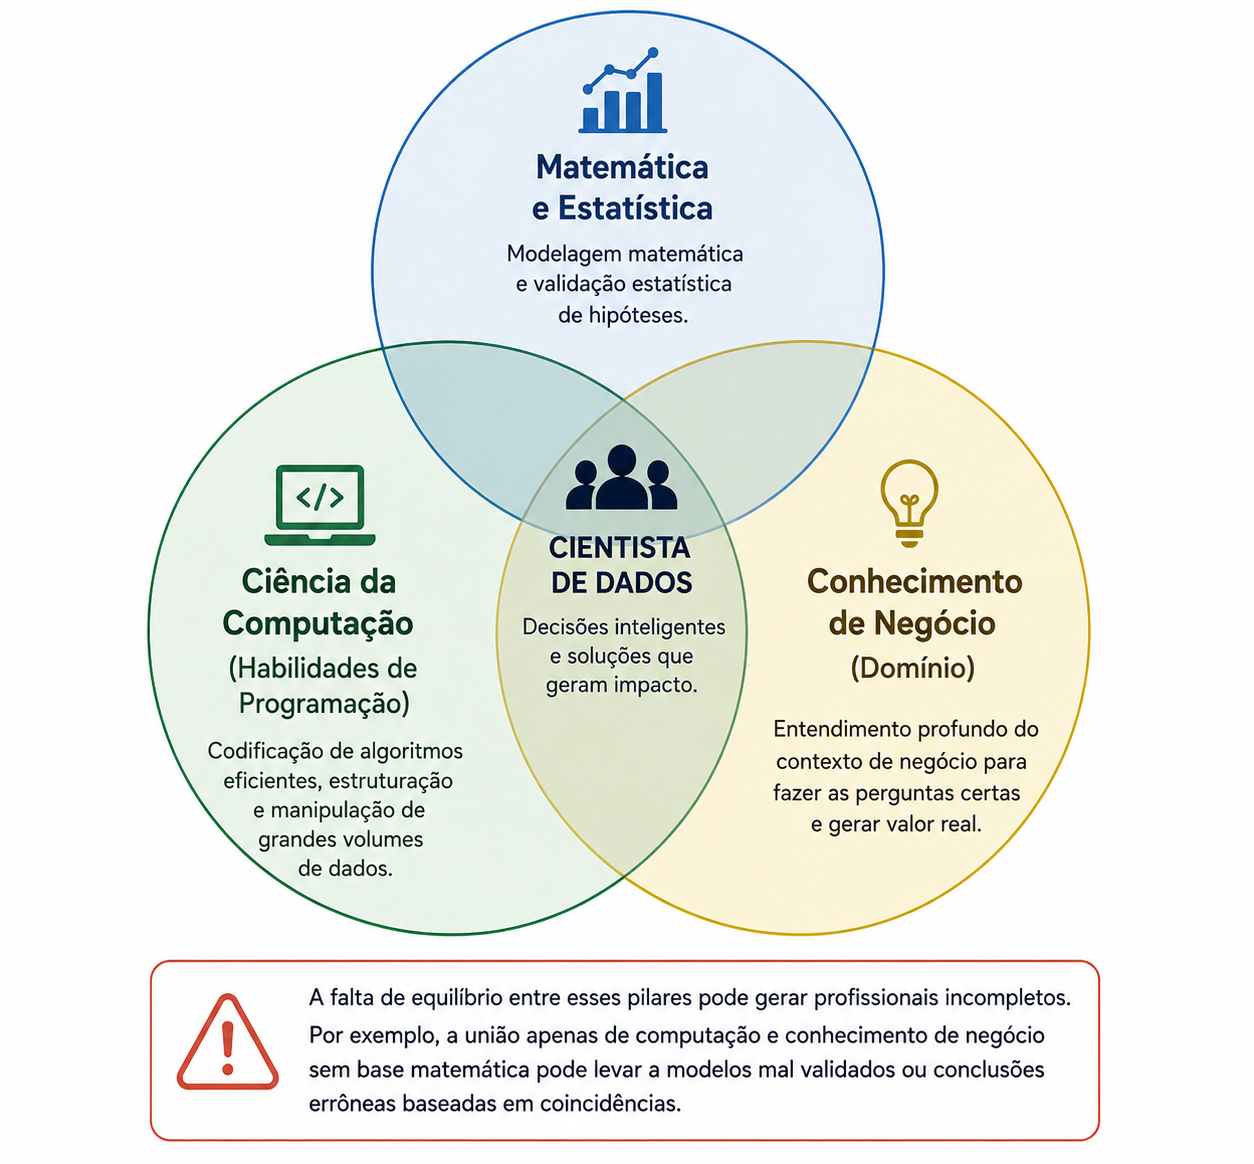
A falta de equilíbrio entre esses pilares pode gerar profissionais incompletos. Por exemplo, a união apenas de computação e conhecimento de negócio sem base matemática pode levar a modelos mal validados ou conclusões errôneas baseadas em coincidências.
As interseções parciais do diagrama costumam ser interpretadas da seguinte forma:
- Computação + Matemática/Estatística (sem domínio): aprendizado de máquina “puro” — técnicas poderosas aplicadas sem compreender o contexto, com risco de responder à pergunta errada.
- Matemática/Estatística + Domínio (sem computação): pesquisa tradicional — análises rigorosas, porém limitadas a dados pequenos e com pouca automação.
- Computação + Domínio (sem matemática/estatística): a chamada “zona de perigo” — o profissional consegue manipular dados e produzir resultados que parecem convincentes, mas não sabe avaliar sua incerteza nem distinguir sinal de ruído.
1.6.1 Exemplo: por que a estatística importa
Suponha que uma equipe teste 100 variáveis candidatas para explicar as vendas de uma loja, todas na verdade sem relação alguma com as vendas, e use um teste com nível de significância \(\alpha = 0{,}05\) para cada uma. Se os testes forem independentes, o número esperado de “descobertas” falsas é
\[ 100 \times 0{,}05 = 5, \]
e a probabilidade de encontrar ao menos uma associação “significativa” é
\[ 1 - (1 - 0{,}05)^{100} \approx 1 - 0{,}0059 = 0{,}9941. \]
Ou seja, é praticamente certo que algo “significativo” aparecerá por puro acaso. Um profissional sem formação estatística pode apresentar essas coincidências como descobertas; um estatístico reconhece o problema das comparações múltiplas e aplica correções (como a de Bonferroni, que usaria \(\alpha/100 = 0{,}0005\) em cada teste) ou valida os achados em dados novos.
1.7 Tipos de Análise de Dados
É comum classificar as análises em quatro níveis de complexidade e valor crescentes, de acordo com a pergunta que respondem:
| Tipo | Pergunta | Técnicas típicas | Exemplo |
|---|---|---|---|
| Descritiva | O que aconteceu? | Tabelas de frequência, médias, gráficos, painéis | Faturamento mensal por região |
| Diagnóstica | Por que aconteceu? | Análise exploratória, correlação, segmentação, testes de hipóteses | Queda de vendas explicada pelo aumento de preço de um concorrente |
| Preditiva | O que vai acontecer? | Regressão, classificação, séries temporais, aprendizado de máquina | Probabilidade de inadimplência de cada cliente |
| Prescritiva | O que devemos fazer? | Otimização, simulação, experimentos, aprendizado por reforço | Limite de crédito que maximiza o lucro esperado |
Esses níveis não são excludentes: um projeto prescritivo normalmente depende de boas análises descritivas e preditivas. Um alerta importante é que a análise diagnóstica com dados observacionais raramente permite conclusões causais definitivas; associações podem ser fruto de variáveis de confusão, como ilustra o paradoxo de Simpson apresentado na seção sobre viés.
1.8 O Ciclo de Vida dos Dados e o Modelo CRISP-DM
A estruturação e execução de um projeto de ciência de dados de sucesso seguem metodologias de processo consolidadas, como a CRISP-DM (Cross Industry Standard Process for Data Mining). Essa metodologia, publicada em 2000 por um consórcio de empresas europeias (Chapman et al. 2000), divide o trabalho em 6 etapas cíclicas e iterativas:
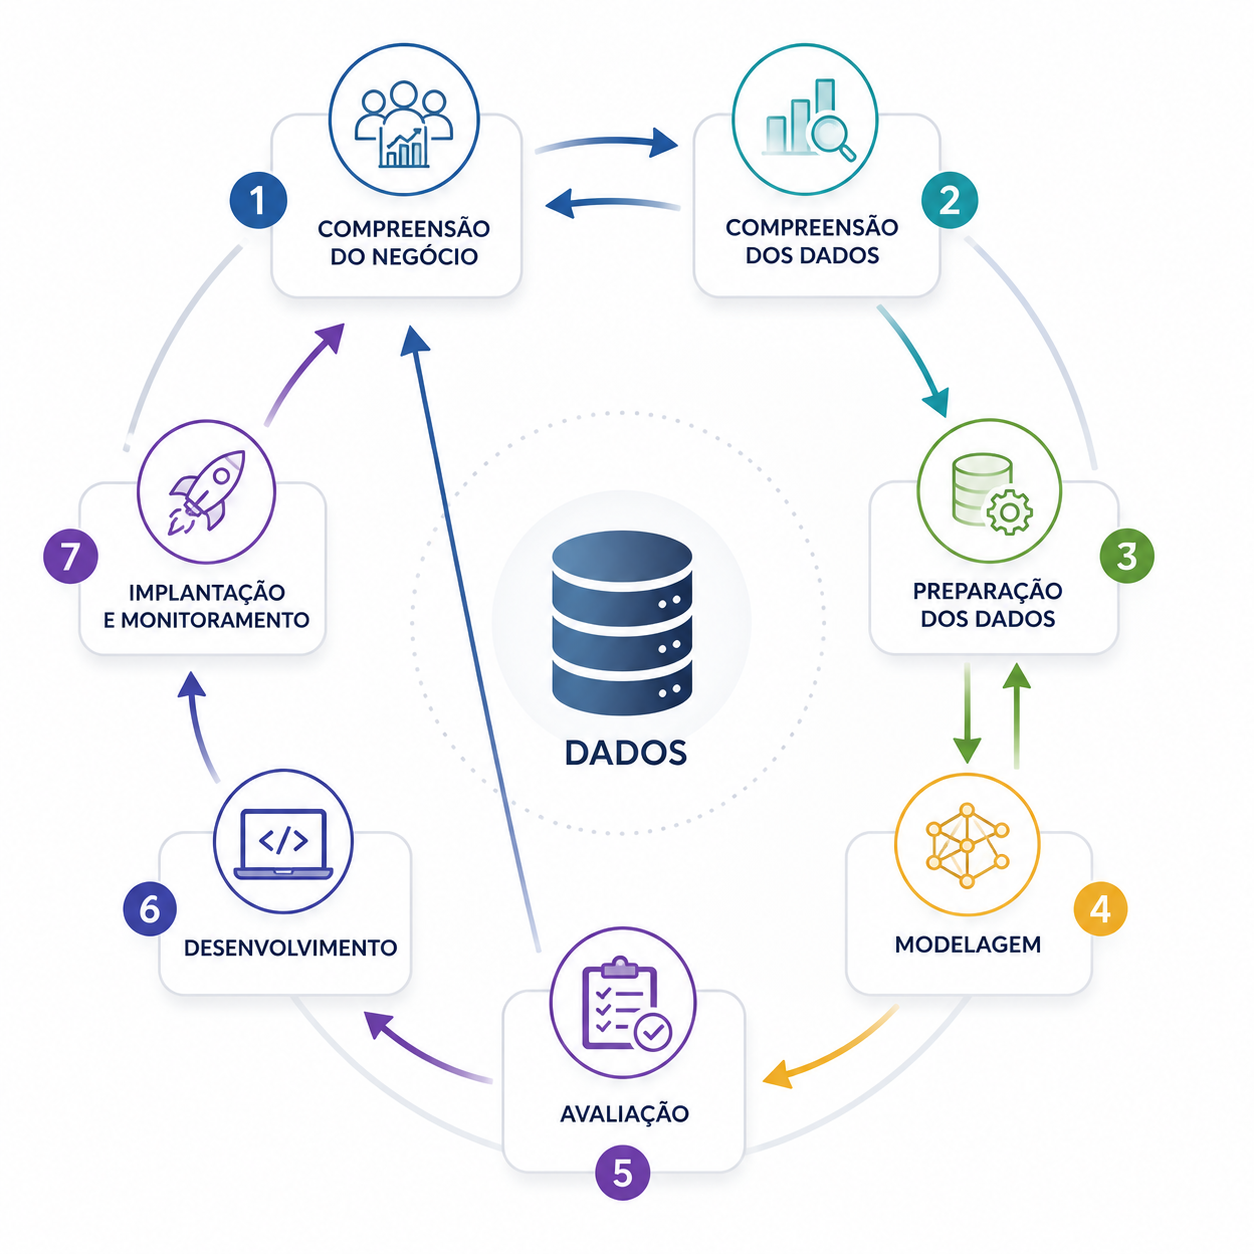
- Compreensão do Negócio: Definir claramente o problema de negócio que precisa ser resolvido e os objetivos do projeto.
- Compreensão dos Dados: Coletar os dados iniciais, explorar suas propriedades e identificar problemas de qualidade.
- Preparação dos Dados: Limpar, tratar dados nulos, selecionar atributos relevantes e transformar as variáveis para a modelagem.
- Modelagem: Selecionar e aplicar algoritmos de aprendizado de máquina e ajustar seus parâmetros.
- Avaliação: Verificar se os modelos atendem aos critérios estatísticos e se de fato respondem aos objetivos de negócio definidos na etapa 1.
- Implantação: Disponibilizar o modelo para uso em produção, criando sistemas de monitoramento contínuo.
1.8.1 Tarefas e entregáveis por fase
O guia original da CRISP-DM detalha cada fase em tarefas genéricas, cada uma com entregáveis (outputs) esperados (Chapman et al. 2000). A tabela a seguir resume essa estrutura:
| Fase | Tarefas genéricas | Entregáveis típicos |
|---|---|---|
| 1. Compreensão do negócio | Determinar objetivos de negócio; avaliar a situação (recursos, restrições, riscos, custos e benefícios); determinar os objetivos analíticos; produzir o plano do projeto | Objetivos e critérios de sucesso do negócio; inventário de recursos; objetivos e critérios de sucesso analíticos; plano do projeto |
| 2. Compreensão dos dados | Coletar os dados iniciais; descrever os dados; explorar os dados; verificar a qualidade dos dados | Relatórios de coleta, de descrição, de exploração e de qualidade dos dados |
| 3. Preparação dos dados | Selecionar; limpar; construir (criar variáveis derivadas); integrar (unir fontes); formatar | Justificativa de inclusão/exclusão; relatório de limpeza; atributos derivados; base de dados analítica |
| 4. Modelagem | Selecionar a técnica; gerar o desenho de teste (ex.: divisão treino/teste); construir o modelo; avaliar o modelo tecnicamente | Hipóteses do modelo; plano de teste; parâmetros e modelos ajustados; avaliação técnica |
| 5. Avaliação | Avaliar os resultados quanto aos critérios de negócio; revisar o processo; determinar os próximos passos | Avaliação frente aos critérios de sucesso; modelos aprovados; lista de ações e decisão (implantar, iterar ou encerrar) |
| 6. Implantação | Planejar a implantação; planejar o monitoramento e a manutenção; produzir o relatório final; revisar o projeto | Plano de implantação; plano de monitoramento; relatório e apresentação finais; documentação de lições aprendidas |
Algumas observações importantes sobre a CRISP-DM:
- As setas da figura vão nos dois sentidos. É muito comum que a compreensão dos dados revele que a pergunta de negócio estava mal formulada, ou que a modelagem exija nova preparação dos dados. Na prática, a preparação dos dados costuma consumir a maior parte do tempo de um projeto.
- O círculo externo indica que o processo não termina. Modelos implantados degradam com o tempo, pois a distribuição dos dados muda (fenômeno conhecido como data drift ou concept drift). O monitoramento pode disparar um novo ciclo.
- A avaliação (fase 5) é diferente da avaliação técnica da fase 4. Um modelo com excelente acurácia pode ser inútil se, por exemplo, suas previsões chegam tarde demais para orientar uma decisão.
- Negócio: a coordenação quer reduzir a evasão no primeiro ano. Critério de sucesso: identificar, até a 6.ª semana do semestre, ao menos 70% dos alunos que vão evadir.
- Dados: histórico acadêmico, frequência, notas da primeira avaliação, dados socioeconômicos. Verifica-se que a frequência só é registrada a partir da 3.ª semana.
- Preparação: unir as fontes pela matrícula, tratar faltantes, criar variáveis como “proporção de faltas até a semana 6”.
- Modelagem: ajustar uma regressão logística e uma floresta aleatória, comparando-as por validação cruzada.
- Avaliação: a floresta acerta mais, mas a regressão logística é mais interpretável para os coordenadores; decide-se por ela, que já atinge o critério.
- Implantação: relatório semanal automático com os alunos de maior risco, encaminhados ao serviço de apoio pedagógico; monitoramento do desempenho a cada semestre.
1.8.2 Outras metodologias: KDD e SEMMA
A CRISP-DM não é a única metodologia de referência. Duas outras merecem menção:
- KDD (Knowledge Discovery in Databases): proposta por Fayyad, Piatetsky-Shapiro, e Smyth (1996), organiza o processo em cinco etapas — seleção dos dados-alvo, pré-processamento (limpeza), transformação (redução de dimensão, construção de atributos), mineração de dados (aplicação de algoritmos para encontrar padrões) e interpretação/avaliação dos padrões encontrados. O KDD enfatiza que a mineração de dados é apenas um passo dentro de um processo maior de descoberta de conhecimento.
- SEMMA: desenvolvida pelo SAS Institute, é um acrônimo para Sample (amostrar), Explore (explorar), Modify (modificar), Model (modelar) e Assess (avaliar). É mais focada nas etapas técnicas e não inclui explicitamente a compreensão do negócio nem a implantação.
| CRISP-DM | KDD | SEMMA |
|---|---|---|
| Compreensão do negócio | — | — |
| Compreensão dos dados | Seleção | Sample, Explore |
| Preparação dos dados | Pré-processamento, Transformação | Modify |
| Modelagem | Mineração de dados | Model |
| Avaliação | Interpretação/Avaliação | Assess |
| Implantação | — (uso do conhecimento) | — |
1.8.3 Outros ciclos: PPDAC e o ciclo de Wickham e Grolemund
Duas outras representações do processo são muito usadas no ensino de Estatística e de Ciência de Dados.
O ciclo PPDAC — Problem, Plan, Data, Analysis, Conclusion — foi proposto por Wild e Pfannkuch (1999) como modelo do pensamento estatístico em investigações empíricas:
- Problema: compreender o sistema em estudo e formular a pergunta;
- Plano: decidir o que medir e como (definição de variáveis, plano amostral ou experimental, instrumentos de coleta);
- Dados: coletar, registrar e limpar os dados;
- Análise: explorar, modelar e verificar hipóteses;
- Conclusão: interpretar, comunicar e gerar novas ideias — que alimentam um novo problema.
A diferença mais importante em relação à CRISP-DM está na etapa de Plano: o PPDAC assume que, frequentemente, o analista pode decidir como os dados serão produzidos, ao passo que a CRISP-DM nasceu num contexto em que os dados já existem nos sistemas da empresa (dados secundários, ou “de oportunidade”). Essa distinção, que parece sutil, tem consequências profundas para o tipo de conclusão que se pode tirar, como veremos na seção sobre dados observacionais e experimentais.
Já Wickham e Grolemund (2017) descrevem o ciclo de um projeto de análise como uma sequência importar → arrumar → (transformar ↔︎ visualizar ↔︎ modelar) → comunicar, envolvida pela programação. O laço central, entre transformar, visualizar e modelar, é o núcleo exploratório do trabalho: cada gráfico sugere uma nova transformação ou um novo modelo, e cada modelo sugere um novo gráfico para examinar seus resíduos. Esse ciclo orienta a organização dos capítulos de R, ggplot2 e Análise Exploratória deste livro.
1.8.4 Do projeto ao produto: monitoramento e mudança de distribuição
A fase de implantação da CRISP-DM merece uma formalização mínima, porque é nela que muitos projetos fracassam. Seja \(P_t(X, Y)\) a distribuição conjunta das variáveis explicativas e da resposta no instante \(t\). Um modelo \(\hat{f}\) ajustado com dados do instante \(t_0\) foi otimizado para \(P_{t_0}\). Como \(P_t(X, Y) = P_t(Y \mid X)\, P_t(X)\), distinguem-se dois tipos principais de mudança:
- Mudança de covariáveis (covariate shift): \(P_t(X)\) muda, mas a relação \(P_t(Y \mid X)\) permanece a mesma. Exemplo: um banco passa a atender clientes mais jovens, mas, para cada perfil, o risco de inadimplência não mudou. O modelo pode continuar válido, mas é usado em regiões do espaço de \(X\) pouco representadas no treinamento.
- Mudança de conceito (concept drift): a própria relação \(P_t(Y \mid X)\) muda. Exemplo: após uma crise econômica, clientes com o mesmo perfil passam a ter risco maior de inadimplência. Nesse caso, o modelo fica sistematicamente errado e precisa ser reajustado.
Na prática, monitora-se tanto a distribuição das entradas (comparando, por exemplo, histogramas ou quantis das variáveis no treinamento e em produção) quanto o desempenho do modelo, quando a resposta verdadeira se torna disponível. O conjunto de práticas de engenharia para implantar, versionar e monitorar modelos é conhecido como MLOps (machine learning operations).
Todas as metodologias apresentadas — CRISP-DM, KDD, SEMMA, PPDAC e o ciclo de Wickham e Grolemund — são iterativas. Isso reflete uma característica epistemológica da Ciência de Dados já apontada por Tukey (1977): a análise exploratória gera hipóteses, a análise confirmatória as testa, e o resultado de um teste sugere novas perguntas. Um projeto que percorre as etapas uma única vez, de forma linear, quase sempre deixou de examinar algo importante.
1.9 Tipos de Dados: Estruturados vs. Não Estruturados
Os dados disponíveis no mundo real dividem-se em duas categorias básicas:
- Dados Estruturados: São aqueles organizados em um formato rígido e predefinido, geralmente no formato tabular de linhas e colunas (bancos de dados SQL, planilhas do Excel, arquivos CSV). Cada linha representa um registro e cada coluna representa uma variável com tipo bem definido (texto, numérico, data).
- Dados Não Estruturados: São dados que não possuem uma estrutura interna rígida ou representação tabular óbvia. Estima-se que representem mais de 80% de todos os dados do planeta. Exemplos incluem imagens, arquivos de áudio, vídeos, páginas da web em HTML, arquivos PDF de relatórios, arquivos JSON aninhados e textos livres de e-mails ou postagens.
1.9.1 Dados semiestruturados
Entre os dois extremos existe uma categoria intermediária muito importante: os dados semiestruturados (semi-structured data). Eles não seguem um esquema tabular rígido, mas possuem marcações (tags) ou pares chave-valor que indicam a organização da informação, permitindo estruturas hierárquicas e registros com campos diferentes entre si. Os formatos mais comuns são:
- JSON (JavaScript Object Notation): o formato padrão de troca de dados na web e em APIs.
- XML (eXtensible Markup Language): muito usado em sistemas corporativos e documentos oficiais (no Brasil, por exemplo, a Nota Fiscal Eletrônica é transmitida em XML).
- YAML: usado em arquivos de configuração (como o cabeçalho dos documentos Quarto, visto no Capítulo de Markdown/RMarkdown).
Um mesmo registro de aluno pode ser representado em JSON assim:
{
  "matricula": "2025001",
  "nome": "Ana",
  "curso": "Estatística",
  "disciplinas": [
    {"codigo": "EST101", "nota": 8.5},
    {"codigo": "MAT102", "nota": 7.0}
  ]
}
e em XML assim:
<aluno matricula="2025001">
  <nome>Ana</nome>
  <curso>Estatística</curso>
  <disciplinas>
    <disciplina codigo="EST101" nota="8.5"/>
    <disciplina codigo="MAT102" nota="7.0"/>
  </disciplinas>
</aluno>
Note que o campo disciplinas é uma lista aninhada: um aluno pode ter qualquer número de disciplinas. Para analisar esse dado estatisticamente, geralmente o “achatamos” em uma tabela em que cada linha é um par (aluno, disciplina). Em Python:
import json
import pandas as pd

texto = """
[
  {"matricula": "2025001", "nome": "Ana", "curso": "Estatística",
   "disciplinas": [{"codigo": "EST101", "nota": 8.5},
                   {"codigo": "MAT102", "nota": 7.0}]},
  {"matricula": "2025002", "nome": "Bruno", "curso": "Estatística",
   "disciplinas": [{"codigo": "EST101", "nota": 6.0}]}
]
"""
registros = json.loads(texto)

# Cada elemento da lista 'disciplinas' vira uma linha;
# os campos do aluno são repetidos como metadados
tabela = pd.json_normalize(registros, record_path="disciplinas",
                           meta=["matricula", "nome", "curso"])
print(tabela)
#>    codigo  nota matricula   nome        curso
#> 0  EST101   8.5   2025001    Ana  Estatística
#> 1  MAT102   7.0   2025001    Ana  Estatística
#> 2  EST101   6.0   2025002  Bruno  Estatística
E em R, com os pacotes jsonlite e tidyr:
library(jsonlite)
library(tidyr)

texto <- '[
  {"matricula": "2025001", "nome": "Ana", "curso": "Estatística",
   "disciplinas": [{"codigo": "EST101", "nota": 8.5},
                   {"codigo": "MAT102", "nota": 7.0}]},
  {"matricula": "2025002", "nome": "Bruno", "curso": "Estatística",
   "disciplinas": [{"codigo": "EST101", "nota": 6.0}]}
]'

alunos <- fromJSON(texto)   # data frame com uma coluna-lista 'disciplinas'
tabela <- unnest(alunos, cols = disciplinas)
tabela
#> # A tibble: 3 × 5
#>   matricula nome  curso       codigo  nota
#>   <chr>     <chr> <chr>       <chr>  <dbl>
#> 1 2025001   Ana   Estatística EST101   8.5
#> 2 2025001   Ana   Estatística MAT102   7
#> 3 2025002   Bruno Estatística EST101   6
1.9.2 Dados arrumados (tidy data)
A tabela resultante acima satisfaz os princípios de dados arrumados (tidy data) propostos por Wickham (2014): cada variável em uma coluna, cada observação em uma linha e cada valor em uma célula. Esses princípios serão apresentados em detalhe no Capítulo de Análise Exploratória de Dados com Python; aqui basta notar que a maioria das ferramentas de modelagem e visualização (como o ggplot2 e o pandas) pressupõe dados nesse formato. Um exemplo de tabela não arrumada é aquela em que os anos aparecem como colunas:
| município | 2022 | 2023 |
|---|---|---|
| Recife | 120 | 135 |
| Olinda | 45 | 50 |
Aqui “ano” é uma variável, mas está espalhada nos nomes das colunas. A versão arrumada tem as colunas municipio, ano e casos, com quatro linhas. Em R, a conversão é feita com tidyr::pivot_longer():
library(tidyr)
largo <- data.frame(municipio = c("Recife", "Olinda"),
                    `2022` = c(120, 45), `2023` = c(135, 50),
                    check.names = FALSE)
longo <- pivot_longer(largo, cols = c(`2022`, `2023`),
                      names_to = "ano", values_to = "casos")
longo
#> # A tibble: 4 × 3
#>   municipio ano   casos
#>   <chr>     <chr> <dbl>
#> 1 Recife    2022    120
#> 2 Recife    2023    135
#> 3 Olinda    2022     45
#> 4 Olinda    2023     50
1.10 Tipos de Variáveis e Escalas de Medida
Dentro de uma tabela de dados estruturados, cada coluna representa uma variável: uma característica medida em cada unidade observacional (pessoa, empresa, município, transação). O tipo da variável determina quais resumos, gráficos e modelos são apropriados, e por isso classificá-la corretamente é um dos primeiros passos de qualquer análise (Morettin e Singer 2021).
1.10.1 Classificação clássica
- Variáveis qualitativas (categóricas): seus valores são categorias ou atributos.
- Nominais: não há ordem natural entre as categorias. Exemplos: sexo, tipo sanguíneo, estado civil, município de residência.
- Ordinais: existe uma ordem natural entre as categorias, mas as distâncias entre elas não são necessariamente iguais. Exemplos: escolaridade (fundamental < médio < superior), classe social, grau de satisfação (muito insatisfeito, …, muito satisfeito).
- Variáveis quantitativas (numéricas): seus valores são números resultantes de contagem ou mensuração.
- Discretas: assumem um conjunto finito ou enumerável de valores, tipicamente resultantes de contagens. Exemplos: número de filhos, número de acessos a um site, número de sinistros.
- Contínuas: podem assumir, em princípio, qualquer valor em um intervalo dos números reais, tipicamente resultantes de mensurações. Exemplos: altura, peso, renda, tempo de espera.
Códigos numéricos não tornam uma variável quantitativa. CEP, CPF, número de matrícula e códigos de municípios do IBGE são variáveis nominais: não faz sentido calcular a “média dos CEPs”. Do mesmo modo, uma variável ordinal codificada como 1, 2, 3, 4, 5 (escala de Likert) não deve ser tratada automaticamente como contínua, embora essa prática seja comum e às vezes aceitável como aproximação.
1.10.2 As escalas de medida de Stevens
O psicólogo S. S. Stevens propôs, em 1946, uma classificação das escalas de medida baseada nas transformações matemáticas que preservam a informação contida na escala (Stevens 1946). Essa classificação refina a anterior e é muito útil para decidir quais operações e estatísticas são permitidas:
| Escala | Operações com significado | Transformações admissíveis | Estatísticas apropriadas | Exemplos |
|---|---|---|---|---|
| Nominal | \(=, \neq\) | Qualquer função injetora (renomear categorias) | Moda, frequências, qui-quadrado | Tipo sanguíneo, partido político |
| Ordinal | \(=, \neq, <, >\) | Funções estritamente crescentes | Mediana, quantis, correlação de Spearman | Escolaridade, ranking |
| Intervalar | Anteriores e diferenças | Afins: \(y = a + bx\), \(b > 0\) | Média, desvio padrão, correlação de Pearson | Temperatura em °C, ano do calendário |
| Razão | Anteriores e razões | Similaridades: \(y = bx\), \(b > 0\) | Todas as anteriores e média geométrica, coeficiente de variação | Altura, renda, temperatura em Kelvin |
A diferença entre as escalas intervalar e de razão está na existência de um zero absoluto, que representa ausência da grandeza. Na escala Celsius, o zero é arbitrário (ponto de congelamento da água); por isso, embora a diferença entre 10 °C e 20 °C seja a mesma que entre 20 °C e 30 °C, não é correto dizer que 20 °C é “o dobro” de 10 °C.
Converta 10 °C e 20 °C para Fahrenheit usando \(F = 32 + 1{,}8\,C\):
- \(10\ ^\circ\text{C} \mapsto 32 + 18 = 50\ ^\circ\text{F}\);
- \(20\ ^\circ\text{C} \mapsto 32 + 36 = 68\ ^\circ\text{F}\).
A razão em Celsius é \(20/10 = 2\), mas em Fahrenheit é \(68/50 = 1{,}36\). Como a razão muda sob uma transformação admissível da escala, ela não tem significado físico. Já a razão entre as diferenças se preserva: \((20 - 10)/(10 - 0) = 1\) em Celsius e \((68 - 50)/(50 - 32) = 1\) em Fahrenheit. Em Kelvin (\(K = C + 273{,}15\)), escala de razão, \(293{,}15 / 283{,}15 \approx 1{,}035\): a temperatura de 20 °C corresponde a uma energia térmica apenas cerca de 3,5% maior que a de 10 °C.
O mesmo raciocínio justifica por que a média não é adequada para variáveis ordinais: se codificamos escolaridade como 1, 2, 3 ou como 1, 2, 10 (ambas codificações estritamente crescentes, portanto admissíveis), a ordem das medianas entre dois grupos é preservada, mas a ordem das médias pode se inverter.
1.10.3 Tipos de variáveis no R e no Python
As linguagens de programação possuem tipos específicos para representar cada classe de variável. Usá-los corretamente evita erros e permite que as funções de modelagem tratem cada variável adequadamente.
pacientes <- data.frame(
  id           = c("P01", "P02", "P03", "P04"),
  tipo_sangue  = factor(c("A", "O", "B", "O")),                 # nominal
  escolaridade = factor(c("médio", "superior", "fundamental", "médio"),
                        levels = c("fundamental", "médio", "superior"),
                        ordered = TRUE),                        # ordinal
  n_consultas  = c(2L, 5L, 1L, 3L),                             # discreta
  peso_kg      = c(68.4, 81.2, 59.9, 72.5)                      # contínua
)
str(pacientes)
#> 'data.frame':    4 obs. of  5 variables:
#>  $ id          : chr  "P01" "P02" "P03" "P04"
#>  $ tipo_sangue : Factor w/ 3 levels "A","B","O": 1 3 2 3
#>  $ escolaridade: Ord.factor w/ 3 levels "fundamental"<..: 2 3 1 2
#>  $ n_consultas : int  2 5 1 3
#>  $ peso_kg     : num  68.4 81.2 59.9 72.5

table(pacientes$tipo_sangue)          # frequências (nominal)
pacientes$escolaridade > "médio"      # comparação de ordem (ordinal)
#> [1] FALSE  TRUE FALSE FALSE
mean(pacientes$peso_kg)               # média (razão)
#> [1] 70.5
Em Python, com o pandas:
import pandas as pd

pacientes = pd.DataFrame({
    "id": ["P01", "P02", "P03", "P04"],
    "tipo_sangue": pd.Categorical(["A", "O", "B", "O"]),
    "escolaridade": pd.Categorical(
        ["médio", "superior", "fundamental", "médio"],
        categories=["fundamental", "médio", "superior"], ordered=True),
    "n_consultas": [2, 5, 1, 3],
    "peso_kg": [68.4, 81.2, 59.9, 72.5],
})
print(pacientes.dtypes)
#> id                object
#> tipo_sangue     category
#> escolaridade    category
#> n_consultas        int64
#> peso_kg          float64

print(pacientes["escolaridade"] > "médio")
print(pacientes["escolaridade"].max())   # 'superior' (respeita a ordem)
print(pacientes["peso_kg"].mean())       # 70.5
1.11 Teoria da Medição: Representação, Validade e Confiabilidade
A classificação de Stevens responde à pergunta “que operações são permitidas com esta variável?”. Por trás dela existe uma teoria matemática mais geral, a teoria representacional da medição (Krantz et al. 1971), e uma preocupação prática complementar: o quanto a medida obtida reflete, de fato, aquilo que se queria medir.
1.11.1 A teoria representacional da medição
Na teoria representacional, medir é atribuir números a objetos de modo que as relações entre os números espelhem relações empíricas entre os objetos. Formalmente, considere um sistema relacional empírico \(\mathfrak{A} = \langle A, \succsim \rangle\), em que \(A\) é um conjunto de objetos (pessoas, produtos, municípios) e \(\succsim\) é uma relação empírica observável (por exemplo, “é pelo menos tão alto quanto”). Uma escala é uma função \(\varphi: A \to \mathbb{R}\) tal que
\[ a \succsim b \iff \varphi(a) \geq \varphi(b), \qquad \text{para todos } a, b \in A. \]
Dois problemas fundamentais acompanham toda escala:
- Problema da representação: existe alguma função \(\varphi\) com essa propriedade? (A resposta depende de axiomas sobre \(\succsim\), como transitividade e completude.)
- Problema da unicidade: se \(\varphi\) é uma representação, quais outras funções \(\psi\) também são? Em geral, \(\psi = g \circ \varphi\) para uma classe de funções \(g\), chamadas transformações admissíveis. É exatamente essa classe que define o tipo da escala na tabela de Stevens: funções injetoras (nominal), estritamente crescentes (ordinal), afins positivas (intervalar) e similaridades positivas (razão).
A partir daí define-se o conceito central para a análise de dados:
Definição (afirmação com significado). Uma afirmação envolvendo valores medidos tem significado (is meaningful) se seu valor-verdade (verdadeiro ou falso) não se altera quando a escala é substituída por qualquer outra obtida por uma transformação admissível.
Sejam \(x_1, \ldots, x_n\) e \(y_1, \ldots, y_m\) medidas de dois grupos em escala intervalar. A afirmação “\(\bar{x} > \bar{y}\)” tem significado.
Demonstração. Uma transformação admissível tem a forma \(g(t) = a + bt\), com \(b > 0\). As médias transformadas são \[ \frac{1}{n}\sum_{i=1}^{n} (a + b x_i) = a + b\bar{x}, \qquad \frac{1}{m}\sum_{j=1}^{m} (a + b y_j) = a + b\bar{y}. \] Como \(b > 0\), \(a + b\bar{x} > a + b\bar{y} \iff \bar{x} > \bar{y}\). \(\square\)
O mesmo argumento falha em escala ordinal, porque uma função estritamente crescente \(g\) não comuta com a média: em geral, \(\overline{g(x)} \neq g(\bar{x})\). Por outro lado, \(g\) comuta com as estatísticas de ordem: se \(x_{(k)}\) é o \(k\)-ésimo menor valor da amostra, então \(g(x)_{(k)} = g(x_{(k)})\), pois \(g\) preserva a ordem. Consequentemente, para tamanhos amostrais ímpares (em que a mediana é uma estatística de ordem), a afirmação “a mediana do grupo A é maior que a do grupo B” tem significado em escala ordinal.
A escolaridade de dois grupos foi codificada como 1 (fundamental), 2 (médio) e 3 (superior). O grupo A tem valores \(\{2, 2, 2\}\) e o grupo B, \(\{1, 1, 3\}\).
- Com a codificação \((1, 2, 3)\): \(\bar{x}_A = 2\) e \(\bar{x}_B = 5/3 \approx 1{,}67\); logo, \(\bar{x}_A > \bar{x}_B\).
- Com a codificação \((1, 2, 10)\), igualmente crescente: o grupo A continua com \(\{2, 2, 2\}\) e média \(2\), mas o grupo B passa a \(\{1, 1, 10\}\), com média \(12/3 = 4\); agora \(\bar{x}_A < \bar{x}_B\).
- As medianas, em ambas as codificações, são “médio” para A e “fundamental” para B: a conclusão “A tem escolaridade mediana maior” não depende da codificação.
A conclusão baseada em médias é, portanto, um artefato da escolha arbitrária dos códigos.
Raciocínio análogo mostra que o coeficiente de variação \(\mathrm{CV} = s/\bar{x}\) só tem significado em escala de razão: sob \(g(t) = bt\), \(s\) e \(\bar{x}\) são ambos multiplicados por \(b\) e o quociente não muda; sob \(g(t) = a + bt\) com \(a \neq 0\), o numerador é multiplicado por \(b\) mas o denominador vira \(a + b\bar{x}\), e o \(\mathrm{CV}\) se altera.
1.11.2 Validade e confiabilidade
Uma medida pode ter a escala correta e, ainda assim, ser ruim. Dois atributos de qualidade de um instrumento de medida são clássicos:
- Validade: o instrumento mede aquilo que pretende medir? Um questionário de “satisfação com o curso” que, na prática, mede o humor do aluno no dia da aplicação tem baixa validade. Distinguem-se, entre outras, a validade de conteúdo (os itens cobrem o conceito?), de critério (a medida se correlaciona com um padrão-ouro?) e de construto (a medida se comporta como a teoria prevê?).
- Confiabilidade (fidedignidade): o instrumento produz resultados consistentes quando aplicado repetidamente nas mesmas condições?
Na linguagem estatística, a validade está ligada ao viés (erro sistemático) e a confiabilidade à variância (erro aleatório). A teoria clássica dos testes formaliza a segunda ideia supondo que cada medida observada \(X\) é a soma de um escore verdadeiro \(T\) e de um erro \(E\):
\[ X = T + E, \qquad \mathbb{E}(E) = 0, \qquad \operatorname{Cov}(T, E) = 0. \]
Daí, \(\operatorname{Var}(X) = \operatorname{Var}(T) + \operatorname{Var}(E)\), e define-se a confiabilidade como a fração da variância observada que é “verdadeira”:
\[ \rho_{XX'} = \frac{\operatorname{Var}(T)}{\operatorname{Var}(X)} = 1 - \frac{\operatorname{Var}(E)}{\operatorname{Var}(X)} \in [0, 1]. \]
Sejam \(X = T_X + E_X\) e \(Y = T_Y + E_Y\), com erros de média zero, não correlacionados entre si e com os escores verdadeiros. Então \[ \operatorname{Corr}(X, Y) = \operatorname{Corr}(T_X, T_Y)\,\sqrt{\rho_{XX'}\,\rho_{YY'}}. \]
Demonstração. Pelas hipóteses, \(\operatorname{Cov}(X, Y) = \operatorname{Cov}(T_X, T_Y)\). Além disso, \(\operatorname{Var}(X) = \operatorname{Var}(T_X)/\rho_{XX'}\) e \(\operatorname{Var}(Y) = \operatorname{Var}(T_Y)/\rho_{YY'}\). Logo, \[ \operatorname{Corr}(X, Y) = \frac{\operatorname{Cov}(T_X, T_Y)}{\sqrt{\operatorname{Var}(T_X)\operatorname{Var}(T_Y)}}\sqrt{\rho_{XX'}\rho_{YY'}} = \operatorname{Corr}(T_X, T_Y)\sqrt{\rho_{XX'}\rho_{YY'}}. \qquad \square \]
Como \(\sqrt{\rho_{XX'}\rho_{YY'}} \leq 1\), o erro de medida sempre enfraquece (atenua) a correlação observada, resultado descrito por Spearman (1904). De modo semelhante, numa regressão linear simples de \(Y\) em \(X\), o coeficiente angular estimado converge para \(\beta\,\rho_{XX'}\), e não para \(\beta\): é o fenômeno da diluição da regressão.
A correlação entre a “habilidade matemática verdadeira” e o “desempenho verdadeiro em Estatística” de estudantes é \(0{,}6\). As provas usadas para medi-las têm confiabilidades \(0{,}8\) e \(0{,}7\). A correlação esperada entre as notas observadas é \[ 0{,}6 \times \sqrt{0{,}8 \times 0{,}7} = 0{,}6 \times \sqrt{0{,}56} \approx 0{,}6 \times 0{,}748 \approx 0{,}449. \] Um analista ingênuo concluiria que a associação é “moderada” (\(0{,}45\)), quando ela é substancialmente mais forte entre os construtos. Inversamente, conhecendo as confiabilidades, pode-se “desatenuar” a correlação observada: \(0{,}449/\sqrt{0{,}56} \approx 0{,}6\).
1.12 Qualidade de Dados
O ditado garbage in, garbage out (“entra lixo, sai lixo”) resume uma verdade incômoda: nenhum método de modelagem compensa dados de má qualidade. Por isso, a fase de Compreensão dos Dados da CRISP-DM inclui explicitamente a tarefa “verificar a qualidade dos dados”. Qualidade, porém, não é uma propriedade única; ela se decompõe em dimensões, cada uma com métricas próprias. A norma ISO/IEC 25012 e a literatura de gestão de dados propõem dezenas delas; as seis a seguir são as mais usadas.
| Dimensão | Pergunta | Métrica típica |
|---|---|---|
| Acurácia | O valor registrado corresponde ao valor real? | Proporção de registros que coincidem com uma fonte de referência (auditoria) |
| Completude | Os valores que deveriam existir estão presentes? | Proporção de valores não faltantes por coluna ou por registro |
| Consistência | Os dados se contradizem entre fontes ou campos? | Proporção de registros que satisfazem regras (ex.: data de alta \(\geq\) data de internação) |
| Unicidade | Cada entidade aparece uma única vez? | Número de chaves distintas dividido pelo número de registros |
| Validade | Os valores respeitam o domínio, o formato e o tipo definidos? | Proporção de valores dentro do domínio (ex.: idade entre 0 e 120; UF numa lista oficial) |
| Atualidade (timeliness) | Os dados estão disponíveis a tempo e refletem o estado atual? | Defasagem entre o evento e o registro; idade média dos registros |
Formalmente, se \(x_{ij}\) é o valor da variável \(j\) no registro \(i\) de uma tabela com \(n\) registros, a completude da coluna \(j\) é
\[ C_j = 1 - \frac{1}{n}\sum_{i=1}^{n} \mathbf{1}\{x_{ij} \text{ é faltante}\}, \]
e, dada uma regra de validade \(\mathcal{V}_j\) (um subconjunto de valores admissíveis), a validade é a proporção de valores observados que pertencem a \(\mathcal{V}_j\). Essas métricas são simples, mas, calculadas sistematicamente e acompanhadas ao longo do tempo, constituem um verdadeiro painel de saúde dos dados.
Considere o cadastro de clientes abaixo (dados fictícios):
| cpf | idade | uf | renda |
|---|---|---|---|
| 111 | 34 | PE | 3500 |
| 222 | 27 | PE | 2800 |
| 333 | — | pe | 4100 |
| 333 | — | pe | 4100 |
| 555 | 210 | PB | — |
| 666 | 45 | XX | 5200 |
| 777 | 19 | AL | 1900 |
| 888 | — | PE | 3000 |
- Completude: a idade falta em 3 dos 8 registros, logo \(C_{\text{idade}} = 5/8 = 0{,}625\); a renda falta em 1, logo \(C_{\text{renda}} = 7/8 = 0{,}875\).
- Unicidade: há 7 CPFs distintos em 8 registros: \(7/8 = 0{,}875\). O CPF 333 está duplicado.
- Validade da idade: entre os 5 valores observados, 210 está fora do intervalo \([0, 120]\): \(4/5 = 0{,}8\).
- Validade da UF: apenas 5 dos 8 valores (“PE”, “PE”, “PB”, “AL”, “PE”) estão escritos exatamente como na lista oficial: \(5/8 = 0{,}625\). Após padronizar para maiúsculas, “pe” torna-se válido e a validade sobe para \(7/8 = 0{,}875\); “XX” continua inválido.
Note que as dimensões interagem: a duplicação do CPF 333 também infla a contagem de faltantes da idade.
Em Python, essas métricas são obtidas com poucas linhas:
import pandas as pd
import numpy as np

clientes = pd.DataFrame({
    "cpf":   ["111", "222", "333", "333", "555", "666", "777", "888"],
    "idade": [34, 27, np.nan, np.nan, 210, 45, 19, np.nan],
    "uf":    ["PE", "PE", "pe", "pe", "PB", "XX", "AL", "PE"],
    "renda": [3500, 2800, 4100, 4100, np.nan, 5200, 1900, 3000],
})

# Completude: proporção de valores não faltantes por coluna
print(clientes.notna().mean().round(3))
#> cpf      1.000
#> idade    0.625
#> uf       1.000
#> renda    0.875

# Unicidade: proporção de chaves distintas
print("unicidade:", clientes["cpf"].nunique() / len(clientes))
#> unicidade: 0.875

# Validade: idade entre 0 e 120; UF pertencente a uma lista de referência
ufs_validas = {"PE", "PB", "AL", "RN", "BA"}   # lista parcial, ilustrativa
print("validade da idade:", clientes["idade"].dropna().between(0, 120).mean())
#> validade da idade: 0.8
print("validade da UF:", clientes["uf"].isin(ufs_validas).mean())
#> validade da UF: 0.625
E em R, com funções da base:
clientes <- data.frame(
  cpf   = c("111", "222", "333", "333", "555", "666", "777", "888"),
  idade = c(34, 27, NA, NA, 210, 45, 19, NA),
  uf    = c("PE", "PE", "pe", "pe", "PB", "XX", "AL", "PE"),
  renda = c(3500, 2800, 4100, 4100, NA, 5200, 1900, 3000)
)
round(colMeans(!is.na(clientes)), 3)              # completude
#>   cpf idade    uf renda
#> 1.000 0.625 1.000 0.875
length(unique(clientes$cpf)) / nrow(clientes)     # unicidade
#> [1] 0.875
idade <- na.omit(clientes$idade)
mean(idade >= 0 & idade <= 120)                   # validade da idade
#> [1] 0.8
ufs <- c("PE", "PB", "AL", "RN", "BA")
mean(clientes$uf %in% ufs)                        # validade da UF
#> [1] 0.625
mean(toupper(clientes$uf) %in% ufs)               # após padronizar
#> [1] 0.875
1.12.1 Mecanismos de dados faltantes
A completude diz quantos dados faltam; para a análise estatística, porém, importa ainda mais por que eles faltam. Seja \(Y\) o vetor completo de dados, particionado em parte observada \(Y_{\text{obs}}\) e parte faltante \(Y_{\text{mis}}\), e seja \(R\) o vetor de indicadores de resposta (\(R = 1\) se o valor foi observado). Seguindo Rubin (1976) e Little e Rubin (2019), classificam-se os mecanismos de não resposta em três tipos:
- MCAR (missing completely at random): \(P(R \mid Y_{\text{obs}}, Y_{\text{mis}}) = P(R)\). A falta não depende de nenhum dado. Exemplo: questionários perdidos por uma falha aleatória do sistema.
- MAR (missing at random): \(P(R \mid Y_{\text{obs}}, Y_{\text{mis}}) = P(R \mid Y_{\text{obs}})\). A falta depende apenas de variáveis observadas. Exemplo: jovens respondem menos à pergunta sobre renda, e a idade é conhecida para todos.
- MNAR (missing not at random): a probabilidade de falta depende do próprio valor não observado, mesmo condicionando nos dados observados. Exemplo: pessoas de renda muito alta tendem a não informar a renda.
Sob MCAR, analisar apenas os casos completos produz estimativas não viesadas (embora menos precisas). Sob MAR, a análise de casos completos pode ser viesada, mas o viés pode ser corrigido usando as variáveis observadas (por ponderação ou imputação múltipla). Sob MNAR, nenhuma correção é possível sem hipóteses adicionais, não verificáveis com os dados.
Uma população tem metade de pessoas de renda baixa (média R$ 2.000) e metade de renda alta (média R$ 8.000); a renda média verdadeira é R$ 5.000. A taxa de resposta à pergunta de renda é 90% no grupo de renda baixa e 50% no de renda alta.
- Proporção de respondentes: \(0{,}5 \times 0{,}9 + 0{,}5 \times 0{,}5 = 0{,}45 + 0{,}25 = 0{,}70\).
- Média dos respondentes: \(\dfrac{0{,}45 \times 2000 + 0{,}25 \times 8000}{0{,}70} = \dfrac{900 + 2000}{0{,}70} \approx 4142{,}86\).
- Viés da análise de casos completos: \(4142{,}86 - 5000 \approx -857\) reais.
Se o grupo de renda (baixa/alta) for observado para todos — por exemplo, inferido pelo bairro ou pela escolaridade —, o mecanismo é MAR e o viés pode ser corrigido ponderando cada respondente pelo inverso da taxa de resposta do seu grupo (\(1/0{,}9\) e \(1/0{,}5\)): \[ \frac{0{,}45 \times 2000 / 0{,}9 + 0{,}25 \times 8000 / 0{,}5}{0{,}45/0{,}9 + 0{,}25/0{,}5} = \frac{1000 + 4000}{0{,}5 + 0{,}5} = 5000. \] Se, ao contrário, a resposta dependesse da própria renda sem nenhuma variável observada que a explicasse (MNAR), essa correção não estaria disponível.
O tratamento de dados faltantes e de valores atípicos é retomado no Capítulo de Análise Exploratória de Dados com Python.
1.13 População, Amostra e Processo Gerador dos Dados
Toda análise de dados pressupõe, ainda que implicitamente, uma resposta à pergunta: sobre quem queremos concluir algo? O conjunto de todas as unidades de interesse é a população; o subconjunto efetivamente observado é a amostra. Uma característica numérica da população (a renda média dos domicílios de Pernambuco, a proporção de eleitores de um candidato) é um parâmetro; uma função dos dados da amostra (a renda média dos domicílios entrevistados) é uma estatística, e, quando usada para aproximar um parâmetro, um estimador.
1.13.1 Amostragem probabilística
Considere uma população finita \(\mathcal{U} = \{1, 2, \ldots, N\}\), com valores \(y_1, \ldots, y_N\) de uma variável de interesse, e o parâmetro total populacional \(\tau = \sum_{i=1}^N y_i\) (a média é \(\bar{Y} = \tau/N\)). Um plano amostral é uma distribuição de probabilidade \(p(s)\) sobre os subconjuntos \(s \subseteq \mathcal{U}\). A probabilidade de inclusão da unidade \(i\) é \(\pi_i = P(i \in s) = \sum_{s \ni i} p(s)\). Os planos mais comuns são (Cochran 1977; Bolfarine e Bussab 2005):
- Amostragem aleatória simples (AAS): todas as amostras de tamanho \(n\) têm a mesma probabilidade; \(\pi_i = n/N\).
- Amostragem estratificada: a população é dividida em estratos homogêneos (regiões, faixas de renda), e uma AAS é sorteada em cada estrato.
- Amostragem por conglomerados: sorteiam-se grupos de unidades (escolas, quarteirões) e observam-se todas, ou parte, das unidades dos grupos sorteados.
- Amostragem sistemática: sorteia-se um início aleatório e seleciona-se uma a cada \(k\) unidades de uma lista.
A grande vantagem da amostragem probabilística é que a aleatoriedade é introduzida pelo pesquisador e, portanto, conhecida. Isso permite construir estimadores não viesados sem qualquer hipótese sobre a distribuição de \(y\).
Se \(\pi_i > 0\) para toda unidade \(i \in \mathcal{U}\), o estimador \[ \hat{\tau}_{\text{HT}} = \sum_{i \in s} \frac{y_i}{\pi_i} \] é não viesado para o total populacional \(\tau\).
Demonstração. Defina os indicadores \(I_i = \mathbf{1}\{i \in s\}\), que são as únicas quantidades aleatórias (os \(y_i\) são fixos). Como \(\mathbb{E}(I_i) = P(i \in s) = \pi_i\), \[ \mathbb{E}(\hat{\tau}_{\text{HT}}) = \mathbb{E}\left( \sum_{i=1}^{N} I_i \frac{y_i}{\pi_i} \right) = \sum_{i=1}^{N} \frac{y_i}{\pi_i}\,\mathbb{E}(I_i) = \sum_{i=1}^{N} y_i = \tau. \qquad \square \]
A intuição é que cada unidade amostrada “representa” \(1/\pi_i\) unidades da população; esse número é o peso amostral. Na AAS, \(1/\pi_i = N/n\) e \(\hat{\tau}_{\text{HT}} = N\bar{y}\). Pesquisas oficiais, como a PNAD Contínua do IBGE, divulgam os pesos amostrais junto com os microdados — e ignorá-los ao calcular médias e proporções é um erro frequente.
Uma população tem dois estratos: \(N_1 = 6.000\) unidades com média \(\mu_1 = 50\) e desvio padrão \(S_1 = 10\), e \(N_2 = 4.000\) unidades com \(\mu_2 = 80\) e \(S_2 = 30\). Os pesos dos estratos são \(W_1 = 0{,}6\) e \(W_2 = 0{,}4\). Deseja-se estimar a média populacional \(\bar{Y} = 0{,}6 \cdot 50 + 0{,}4 \cdot 80 = 62\) com \(n = 200\) observações. Desprezando a correção para população finita:
- AAS. A variância populacional decompõe-se em variância dentro e entre estratos: \[ S^2 \approx \sum_h W_h S_h^2 + \sum_h W_h(\mu_h - \bar{Y})^2 = (0{,}6 \cdot 100 + 0{,}4 \cdot 900) + (0{,}6 \cdot 144 + 0{,}4 \cdot 324) = 420 + 216 = 636, \] e \(\operatorname{Var}(\bar{y}) = 636/200 = 3{,}18\).
- Estratificada com alocação proporcional (\(n_1 = 120\), \(n_2 = 80\)): \(\operatorname{Var}(\bar{y}_{\text{st}}) = \sum_h W_h^2 S_h^2 / n_h = 0{,}36 \cdot 100/120 + 0{,}16 \cdot 900/80 = 0{,}3 + 1{,}8 = 2{,}1\).
- Estratificada com alocação de Neyman (\(n_h \propto N_h S_h\), isto é, \(n_1 \approx 66{,}7\) e \(n_2 \approx 133{,}3\)): \(\operatorname{Var}(\bar{y}_{\text{st}}) = \left(\sum_h W_h S_h\right)^2 / n = (6 + 12)^2/200 = 1{,}62\).
A estratificação proporcional elimina a componente “entre estratos” (216) da variância; a alocação de Neyman vai além, colocando mais observações no estrato mais heterogêneo. Com a alocação de Neyman, a variância é cerca de metade da obtida pela AAS — o que equivale a dobrar o tamanho da amostra sem custo adicional.
1.13.2 O paradoxo dos grandes dados
Muitos conjuntos de dados da Ciência de Dados não vêm de amostras probabilísticas: são registros de usuários de um aplicativo, respondentes voluntários de uma enquete online, clientes que aceitaram participar de um programa. Nesses casos, a “probabilidade de inclusão” é desconhecida e pode depender da própria variável de interesse. Meng (2018) mostrou, com uma identidade algébrica simples, por que o tamanho desses conjuntos pode ser enganoso.
Seja \(R_i = 1\) se a unidade \(i\) da população está na base de dados, \(n = \sum_i R_i\) e \(f = n/N\) a fração observada. Então, a diferença entre a média observada \(\bar{y}_n\) e a média populacional \(\bar{Y}\) satisfaz
\[ \bar{y}_n - \bar{Y} = \underbrace{\rho_{R,Y}}_{\text{qualidade}} \times \underbrace{\sqrt{\frac{1-f}{f}}}_{\text{quantidade}} \times \underbrace{\sigma_Y}_{\text{dificuldade}}, \tag{1.2}\]
em que \(\rho_{R,Y}\) é a correlação, calculada na população, entre o indicador de inclusão e a variável de interesse (a correlação de defeito dos dados), e \(\sigma_Y\) é o desvio padrão populacional de \(Y\).
Esboço da demonstração. Usando médias e covariâncias populacionais (com divisor \(N\)), \(\bar{y}_n = \frac{\sum_i R_i y_i}{\sum_i R_i}\) e \(\frac{1}{N}\sum_i R_i = f\). Logo, \[ \bar{y}_n - \bar{Y} = \frac{\frac{1}{N}\sum_i R_i y_i - f\bar{Y}}{f} = \frac{\operatorname{Cov}_{\mathcal{U}}(R, Y)}{f} = \frac{\rho_{R,Y}\,\sigma_R\,\sigma_Y}{f}, \] e, como \(R\) é binário com média \(f\), \(\sigma_R = \sqrt{f(1-f)}\), o que fornece a Equação 1.2.
Numa AAS, \(\rho_{R,Y}\) é aleatória com média zero e da ordem de \(1/\sqrt{N}\); numa base auto-selecionada, ela pode ser pequena, mas fixa e não nula. Igualando o erro quadrático da base de dados ao de uma AAS de tamanho \(n_{\text{ef}}\) (variância aproximada \(\sigma_Y^2/n_{\text{ef}}\)), obtém-se o tamanho efetivo
\[ n_{\text{ef}} \approx \frac{f}{1-f} \cdot \frac{1}{\rho_{R,Y}^2}. \]
Uma enquete online coletou a opinião de \(n = 1.000.000\) de eleitores numa população de \(N = 10.000.000\) (\(f = 0{,}1\)). Suponha que a decisão de responder tenha correlação de apenas \(\rho_{R,Y} = 0{,}01\) com a opinião \(Y\) (1 = favorável, 0 = contrário) e que \(\sigma_Y = 0{,}5\) (opinião dividida ao meio).
- Erro da estimativa: \(0{,}01 \times \sqrt{0{,}9/0{,}1} \times 0{,}5 = 0{,}01 \times 3 \times 0{,}5 = 0{,}015\), ou seja, 1,5 ponto percentual.
- Tamanho efetivo: \(n_{\text{ef}} \approx \dfrac{0{,}1}{0{,}9} \times \dfrac{1}{0{,}0001} \approx 1.111\).
Um milhão de respostas auto-selecionadas fornece a mesma precisão de uma amostra aleatória simples de cerca de 1.100 pessoas — de fato, o erro-padrão desta última é \(0{,}5/\sqrt{1111} \approx 0{,}015\). E, ao contrário da amostra aleatória, o erro da enquete é um viés: não diminui com mais respostas do mesmo tipo e não é captado por intervalos de confiança usuais.
Na eleição presidencial americana de 1936, a revista Literary Digest enviou cerca de 10 milhões de cédulas a leitores, assinantes de telefone e proprietários de automóveis, recebeu aproximadamente 2,4 milhões de respostas e previu uma vitória folgada de Alf Landon sobre Franklin Roosevelt. Roosevelt venceu com ampla margem. Pesquisadores como George Gallup, com amostras muito menores mas mais bem planejadas, acertaram o vencedor. A lista de endereços favorecia pessoas de renda mais alta e a resposta era voluntária: um exemplo clássico de que qualidade do processo de coleta importa mais que o tamanho da amostra.
1.14 Fundamentos de Probabilidade e Inferência
Os pilares estatísticos da Ciência de Dados apoiam-se em alguns resultados de probabilidade que todo cientista de dados deve conhecer. Esta seção os apresenta de forma resumida; eles serão usados ao longo de todo o livro.
1.14.1 Probabilidade condicional e o teorema de Bayes
Dados eventos \(A\) e \(B\) com \(P(B) > 0\), a probabilidade condicional de \(A\) dado \(B\) é \(P(A \mid B) = P(A \cap B)/P(B)\). Se \(A_1, \ldots, A_k\) formam uma partição do espaço amostral, a lei da probabilidade total e o teorema de Bayes afirmam que
\[ P(B) = \sum_{j=1}^{k} P(B \mid A_j)\,P(A_j), \qquad P(A_i \mid B) = \frac{P(B \mid A_i)\,P(A_i)}{\sum_{j=1}^{k} P(B \mid A_j)\,P(A_j)}. \]
O teorema de Bayes é a ferramenta formal para atualizar crenças à luz de evidências: \(P(A_i)\) é a probabilidade a priori, \(P(B \mid A_i)\) a verossimilhança e \(P(A_i \mid B)\) a probabilidade a posteriori.
Um modelo de detecção de fraudes em cartões tem sensibilidade \(P(+ \mid F) = 0{,}95\) e especificidade \(P(- \mid \bar{F}) = 0{,}98\). Apenas 0,5% das transações são fraudulentas: \(P(F) = 0{,}005\). Qual a probabilidade de uma transação sinalizada ser, de fato, fraude?
- Probabilidade de sinalização (probabilidade total): \(P(+) = 0{,}95 \times 0{,}005 + 0{,}02 \times 0{,}995 = 0{,}00475 + 0{,}0199 = 0{,}02465\).
- Teorema de Bayes: \(P(F \mid +) = 0{,}00475 / 0{,}02465 \approx 0{,}193\).
Apesar de o modelo parecer excelente, apenas cerca de 19% das transações sinalizadas são fraudes; as demais 81% são alarmes falsos. Ignorar a raridade do evento (a taxa-base) é um dos erros de raciocínio mais comuns — e explica por que a acurácia, sozinha, é uma métrica enganosa em problemas desbalanceados (Capítulo de Introdução ao Aprendizado de Máquina).
1.14.2 Lei dos grandes números e teorema central do limite
Sejam \(X_1, \ldots, X_n\) variáveis aleatórias independentes e identicamente distribuídas (i.i.d.), com média \(\mu\) e variância \(\sigma^2 < \infty\), e seja \(\bar{X}_n = \frac{1}{n}\sum_{i=1}^{n} X_i\). Pela linearidade da esperança e pela independência,
\[ \mathbb{E}(\bar{X}_n) = \mu, \qquad \operatorname{Var}(\bar{X}_n) = \frac{\sigma^2}{n}. \]
A raiz dessa variância, \(\sigma/\sqrt{n}\), é o erro-padrão da média. Dois resultados fundamentais descrevem o comportamento de \(\bar{X}_n\) quando \(n\) cresce:
Para todo \(\varepsilon > 0\), \(P(|\bar{X}_n - \mu| \geq \varepsilon) \to 0\) quando \(n \to \infty\).
Demonstração. Pela desigualdade de Chebyshev, \(P(|\bar{X}_n - \mu| \geq \varepsilon) \leq \operatorname{Var}(\bar{X}_n)/\varepsilon^2 = \sigma^2/(n\varepsilon^2)\), que tende a zero. \(\square\)
Sob as mesmas hipóteses, para todo \(z \in \mathbb{R}\), \[ P\left( \frac{\bar{X}_n - \mu}{\sigma/\sqrt{n}} \leq z \right) \longrightarrow \Phi(z), \qquad n \to \infty, \] em que \(\Phi\) é a função de distribuição da normal padrão — qualquer que seja a distribuição dos \(X_i\).
A lei dos grandes números justifica o uso de médias amostrais (e de frequências relativas) como estimativas; o TCL quantifica a incerteza dessas estimativas e justifica intervalos de confiança aproximados como
\[ \bar{x} \pm z_{1-\alpha/2}\,\frac{s}{\sqrt{n}} \quad \text{(média)}, \qquad \hat{p} \pm z_{1-\alpha/2}\sqrt{\frac{\hat{p}(1-\hat{p})}{n}} \quad \text{(proporção)}, \]
com \(z_{0{,}975} \approx 1{,}96\) para 95% de confiança.
(a) Numa amostra aleatória de \(n = 400\) clientes, 220 aprovaram um novo serviço. A estimativa é \(\hat{p} = 0{,}55\), com erro-padrão \(\sqrt{0{,}55 \times 0{,}45/400} \approx 0{,}0249\). O intervalo de 95% é \[ 0{,}55 \pm 1{,}96 \times 0{,}0249 = 0{,}55 \pm 0{,}0488 \;\Rightarrow\; (0{,}501;\ 0{,}599). \]
(b) Quantos clientes seriam necessários para estimar \(p\) com margem de erro \(e = 0{,}03\) e 95% de confiança, sem informação prévia sobre \(p\)? Como \(p(1-p) \leq 1/4\), usa-se o pior caso: \[ n \geq \frac{z_{0{,}975}^2 \cdot 0{,}25}{e^2} = \frac{1{,}96^2 \times 0{,}25}{0{,}03^2} \approx 1067{,}1 \;\Rightarrow\; n = 1068. \] Esse é o motivo pelo qual tantas pesquisas eleitorais trabalham com cerca de mil entrevistas. Note que o resultado não depende do tamanho da população (desde que ela seja muito maior que a amostra).
A simulação a seguir, em R, ilustra os dois teoremas com uma população assimétrica (exponencial com média 2) e avalia a cobertura do intervalo de 95%:
set.seed(2025)
n_rep <- 10000
n     <- 30
# Distribuição das médias amostrais: centro em 2 e dispersão 2/sqrt(30)
medias <- replicate(n_rep, mean(rexp(n, rate = 1/2)))
mean(medias)
#> [1] 2.004492
sd(medias)
#> [1] 0.3650328
# Proporção de intervalos t de 95% que contêm a média verdadeira
cobre <- replicate(n_rep, {
  x  <- rexp(n, rate = 1/2)
  ic <- mean(x) + c(-1, 1) * qt(0.975, n - 1) * sd(x) / sqrt(n)
  ic[1] <= 2 && 2 <= ic[2]
})
mean(cobre)
#> [1] 0.925
A média das médias está muito próxima de \(\mu = 2\) e o desvio padrão, de \(2/\sqrt{30} \approx 0{,}365\), como prevê a teoria. A cobertura, porém, é de cerca de 92,5%, e não 95%: com \(n = 30\) e uma distribuição muito assimétrica, a aproximação normal ainda não é perfeita. A lição é que “\(n \geq 30\)” é uma regra de bolso, não um teorema.
A afirmação “o intervalo \((0{,}501;\ 0{,}599)\) contém \(p\) com probabilidade 95%” é, a rigor, incorreta na interpretação frequentista: \(p\) é fixo e o intervalo calculado contém ou não contém \(p\). O que tem probabilidade 95% é o procedimento: se repetíssemos a amostragem muitas vezes, cerca de 95% dos intervalos construídos conteriam \(p\) — exatamente o que a simulação acima estima.
1.15 Dados Observacionais e Dados Experimentais
Uma das distinções mais importantes da Estatística, e frequentemente esquecida em Ciência de Dados, diz respeito ao modo como os dados foram produzidos:
- Em um estudo experimental, o pesquisador atribui os tratamentos às unidades (de preferência, por sorteio) e observa as respostas. Exemplos: ensaios clínicos randomizados, testes A/B em sites.
- Em um estudo observacional, o pesquisador apenas registra os tratamentos que as unidades receberam por escolha própria ou por outros mecanismos. Exemplos: comparar a saúde de fumantes e não fumantes, comparar clientes que aderiram ou não a um programa de fidelidade.
1.15.1 O modelo de resultados potenciais
Uma linguagem precisa para discutir causalidade é o modelo de resultados potenciais (Rubin 1974; Holland 1986). Para cada unidade \(i\) e um tratamento binário \(T_i \in \{0, 1\}\), postulam-se dois resultados potenciais: \(Y_i(1)\), o resultado se a unidade receber o tratamento, e \(Y_i(0)\), se não receber. O efeito causal individual é \(Y_i(1) - Y_i(0)\), e o efeito causal médio (average treatment effect) é
\[ \text{ATE} = \mathbb{E}[Y(1) - Y(0)]. \]
O problema fundamental da inferência causal é que, para cada unidade, observamos apenas um dos dois resultados: \(Y_i = T_i Y_i(1) + (1 - T_i) Y_i(0)\). O outro é o contrafactual. A comparação ingênua entre tratados e não tratados pode ser decomposta, somando e subtraindo \(\mathbb{E}[Y(0) \mid T = 1]\):
\[ \underbrace{\mathbb{E}[Y \mid T = 1] - \mathbb{E}[Y \mid T = 0]}_{\text{diferença observada}} = \underbrace{\mathbb{E}[Y(1) - Y(0) \mid T = 1]}_{\text{efeito nos tratados}} + \underbrace{\mathbb{E}[Y(0) \mid T = 1] - \mathbb{E}[Y(0) \mid T = 0]}_{\text{viés de seleção}}. \]
O viés de seleção mede o quanto os tratados já diferiam dos não tratados antes do tratamento.
Se o tratamento é atribuído por sorteio, independentemente dos resultados potenciais — isto é, \(T \perp\!\!\!\perp (Y(0), Y(1))\) —, então \(\mathbb{E}[Y \mid T = 1] - \mathbb{E}[Y \mid T = 0] = \text{ATE}\).
Demonstração. Pela independência, \(\mathbb{E}[Y(t) \mid T = 1] = \mathbb{E}[Y(t) \mid T = 0] = \mathbb{E}[Y(t)]\) para \(t \in \{0, 1\}\). Logo, o viés de seleção é zero e o efeito nos tratados é igual a \(\mathbb{E}[Y(1)] - \mathbb{E}[Y(0)] = \text{ATE}\). \(\square\)
Em estudos observacionais, essa independência raramente vale: quem escolhe o tratamento costuma diferir sistematicamente de quem não escolhe. É por isso que o paradoxo de Simpson e as variáveis de confusão, discutidos na seção de ética, aparecem com tanta frequência em dados observacionais.
Seis alunos têm os resultados potenciais abaixo (nota sem e com uma monitoria). O efeito é exatamente \(+1\) para todos, logo \(\text{ATE} = 1\).
| Aluno | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| \(Y(0)\) | 2 | 3 | 4 | 6 | 7 | 8 |
| \(Y(1)\) | 3 | 4 | 5 | 7 | 8 | 9 |
- Autosseleção. Suponha que os três melhores alunos (4, 5 e 6) procurem a monitoria. Observamos \(Y(1)\) para eles, com média \((7 + 8 + 9)/3 = 8\), e \(Y(0)\) para os demais, com média \((2 + 3 + 4)/3 = 3\). A diferença observada é \(8 - 3 = 5\). Pela decomposição, o efeito nos tratados é \(1\) e o viés de seleção é \((6 + 7 + 8)/3 - 3 = 7 - 3 = 4\).
- Sorteio. Há \(\binom{6}{3} = 20\) maneiras de escolher três alunos para a monitoria. Calculando a diferença observada para cada uma delas, a média das 20 diferenças é exatamente 1: o estimador é não viesado. Note, porém, que as diferenças individuais variam de \(-3\) a \(5\): com apenas seis unidades, a variância é enorme. A randomização elimina o viés; o tamanho da amostra controla a variância.
A verificação do item 2 pode ser feita por enumeração, em Python:
from itertools import combinations
import numpy as np

y0 = np.array([2, 3, 4, 6, 7, 8])
y1 = y0 + 1
diferencas = []
for tratados in combinations(range(6), 3):
    controles = [i for i in range(6) if i not in tratados]
    diferencas.append(y1[list(tratados)].mean() - y0[controles].mean())

print(len(diferencas), np.mean(diferencas), min(diferencas), max(diferencas))
#> 20 1.0 -3.0 5.0
1.15.2 Testes A/B
Em plataformas digitais, experimentos randomizados são chamados de testes A/B: os usuários são sorteados para ver a versão atual (A, controle) ou a nova versão (B, tratamento) de uma página, e compara-se uma métrica como a taxa de conversão. Pela proposição anterior, a diferença das taxas estima o efeito causal da mudança.
Na versão A, 120 de 2.000 usuários fizeram uma compra (\(\hat{p}_A = 0{,}060\)); na versão B, 150 de 2.000 (\(\hat{p}_B = 0{,}075\)).
- Diferença estimada: \(\hat{p}_B - \hat{p}_A = 0{,}015\) (1,5 ponto percentual).
- Erro-padrão: \(\sqrt{\dfrac{0{,}06 \times 0{,}94}{2000} + \dfrac{0{,}075 \times 0{,}925}{2000}} \approx 0{,}00793\).
- Estatística: \(z = 0{,}015/0{,}00793 \approx 1{,}89\), com valor-p bilateral \(\approx 0{,}059\).
- Intervalo de 95%: \(0{,}015 \pm 1{,}96 \times 0{,}00793 \Rightarrow (-0{,}0005;\ 0{,}0305)\).
O intervalo inclui o zero (por pouco): a evidência de que B é melhor é sugestiva, mas não conclusiva ao nível de 5%. Uma decisão bem fundamentada exigiria planejar o tamanho da amostra antes do experimento, a partir do menor efeito que teria importância prática — e não interromper o teste assim que o valor-p “ficar significativo”, prática que infla a taxa de falsos positivos.
A maior parte dos dados usados em Ciência de Dados é observacional. Modelos preditivos ajustados a esses dados podem prever muito bem e, ainda assim, sugerir intervenções erradas: um modelo pode “aprender” que pacientes com asma têm menor risco de morrer de pneumonia simplesmente porque esses pacientes recebem tratamento mais intensivo. Sempre que a pergunta for “o que acontece se intervirmos?”, é preciso um experimento ou métodos de inferência causal com hipóteses explícitas.
1.16 Profissionais da Área de Dados
À medida que a área amadureceu, as funções se especializaram. Embora os limites variem muito entre organizações, é comum distinguir os seguintes papéis:
| Papel | Foco principal | Ferramentas e competências típicas |
|---|---|---|
| Analista de dados (data analyst) | Análises descritivas e diagnósticas, relatórios e painéis para apoiar decisões | SQL, planilhas, ferramentas de BI, estatística descritiva, visualização |
| Cientista de dados (data scientist) | Formulação de perguntas, modelagem estatística e preditiva, experimentos | R/Python, inferência, aprendizado de máquina, comunicação |
| Engenheiro de dados (data engineer) | Infraestrutura: coleta, armazenamento, pipelines de ETL, qualidade e disponibilidade dos dados | SQL, bancos de dados, computação distribuída, nuvem, orquestração |
| Engenheiro de aprendizado de máquina (ML engineer) | Levar modelos à produção: escalabilidade, latência, versionamento, monitoramento | Engenharia de software, contêineres, APIs, MLOps |
| Estatístico | Planejamento amostral e de experimentos, inferência rigorosa, quantificação de incerteza | Teoria estatística, R, SAS, métodos de amostragem |
Na fase de Compreensão do Negócio da CRISP-DM, participam ainda os especialistas do domínio e os gestores que tomarão as decisões. Um bacharel em Estatística tem formação privilegiada para os papéis de cientista de dados e estatístico, e pode atuar nos demais desenvolvendo habilidades computacionais — que são o foco da Parte I deste livro.
1.17 Ética, Privacidade e Viés em Dados
Dados frequentemente descrevem pessoas. Por isso, decisões tomadas a partir deles podem afetar o acesso a crédito, emprego, saúde e justiça. A ética não é uma etapa separada do projeto: ela permeia todas as fases da CRISP-DM, desde a escolha da pergunta até o monitoramento do modelo implantado.
1.17.1 A Lei Geral de Proteção de Dados (LGPD)
No Brasil, o tratamento de dados pessoais é regulado pela Lei Geral de Proteção de Dados Pessoais (Lei n.º 13.709, de 14 de agosto de 2018), inspirada no Regulamento Geral sobre a Proteção de Dados (GDPR) da União Europeia. Alguns conceitos centrais da lei:
- Dado pessoal: informação relacionada a pessoa natural identificada ou identificável.
- Dado pessoal sensível: dado sobre origem racial ou étnica, convicção religiosa, opinião política, filiação a sindicato ou organização de caráter religioso, filosófico ou político, dado referente à saúde ou à vida sexual, dado genético ou biométrico.
- Dado anonimizado: dado relativo a titular que não possa ser identificado, considerando a utilização de meios técnicos razoáveis disponíveis na ocasião de seu tratamento. Dados anonimizados, em regra, não são considerados dados pessoais pela lei.
- Titular, controlador e operador: respectivamente, a pessoa a quem os dados se referem, quem toma as decisões sobre o tratamento e quem realiza o tratamento em nome do controlador.
- Bases legais: o tratamento só pode ocorrer em hipóteses previstas na lei, como o consentimento do titular, o cumprimento de obrigação legal, a execução de contrato, a realização de estudos por órgão de pesquisa e o legítimo interesse.
- Princípios: entre eles, finalidade, adequação, necessidade (limitação ao mínimo necessário), transparência, segurança, prevenção e não discriminação.
A fiscalização cabe à Autoridade Nacional de Proteção de Dados (ANPD). Para o cientista de dados, o princípio da necessidade tem uma consequência prática direta: não se deve coletar ou manter variáveis pessoais “só porque podem ser úteis um dia”.
1.17.2 Anonimização e o risco de reidentificação
Remover nome e CPF não garante anonimato. Combinações de atributos aparentemente inofensivos — data de nascimento, sexo e CEP, por exemplo — podem identificar unicamente uma grande parte das pessoas de uma população. Esses atributos são chamados quase-identificadores. Um critério clássico para avaliar o risco é a \(k\)-anonimidade (Sweeney 2002): uma tabela é \(k\)-anônima se cada combinação de valores dos quase-identificadores aparece em pelo menos \(k\) registros. Técnicas para alcançá-la incluem a generalização (trocar a idade exata por faixas etárias, o CEP completo pelos primeiros dígitos) e a supressão de registros raros.
Considere os quase-identificadores (faixa etária, sexo, CEP de 3 dígitos):
| Faixa etária | Sexo | CEP (3 díg.) | Diagnóstico |
|---|---|---|---|
| 20–29 | F | 504 | Gripe |
| 20–29 | F | 504 | Asma |
| 20–29 | F | 504 | Gripe |
| 30–39 | M | 520 | Diabetes |
| 30–39 | M | 520 | Gripe |
Os grupos de equivalência têm tamanhos 3 e 2. Logo a tabela é \(2\)-anônima (o menor grupo tem 2 registros), mas não \(3\)-anônima. Observe uma limitação: se todos os registros de um grupo tivessem o mesmo diagnóstico, bastaria saber que alguém pertence ao grupo para descobrir seu diagnóstico, mesmo com \(k\) grande. Por isso foram propostos critérios complementares, como a \(\ell\)-diversidade.
1.17.3 Privacidade por desenho: resposta aleatorizada e privacidade diferencial
A \(k\)-anonimidade protege uma tabela depois que os dados foram coletados. Uma alternativa, de forte fundamentação estatística, é introduzir aleatoriedade controlada na coleta ou na divulgação dos dados, de modo que nenhuma resposta individual revele com certeza a informação de uma pessoa, mas as estimativas agregadas continuem possíveis.
Resposta aleatorizada. Proposta por Warner (1965) para reduzir respostas evasivas em perguntas sensíveis (uso de drogas, sonegação), a técnica funciona assim: cada entrevistado sorteia, de forma privada, qual de duas afirmações vai responder — “eu pertenço ao grupo sensível \(G\)”, com probabilidade \(p\), ou “eu não pertenço ao grupo \(G\)”, com probabilidade \(1 - p\) (\(p \neq 1/2\)) — e responde apenas “sim” ou “não”. O entrevistador não sabe qual afirmação foi sorteada. Se \(\pi\) é a proporção da população em \(G\), a probabilidade de uma resposta “sim” é
\[ \lambda = p\,\pi + (1 - p)(1 - \pi) \quad\Longrightarrow\quad \pi = \frac{\lambda - (1 - p)}{2p - 1}. \]
Substituindo \(\lambda\) pela proporção amostral de “sim”, \(\hat{\lambda}\), obtém-se o estimador não viesado \(\hat{\pi} = [\hat{\lambda} - (1-p)]/(2p - 1)\), com variância
\[ \operatorname{Var}(\hat{\pi}) = \frac{\lambda(1 - \lambda)}{n(2p - 1)^2}. \]
Numa pesquisa com \(n = 1.000\) estudantes e \(p = 0{,}7\), foram obtidas 380 respostas “sim” (\(\hat{\lambda} = 0{,}38\)).
- Estimativa: \(\hat{\pi} = (0{,}38 - 0{,}3)/(2 \times 0{,}7 - 1) = 0{,}08/0{,}4 = 0{,}20\).
- Erro-padrão: \(\sqrt{0{,}38 \times 0{,}62 / (1000 \times 0{,}16)} = \sqrt{0{,}0014725} \approx 0{,}0384\).
- Se a pergunta fosse feita diretamente (e todos respondessem com sinceridade), o erro-padrão seria \(\sqrt{0{,}2 \times 0{,}8/1000} \approx 0{,}0126\).
A variância da resposta aleatorizada é cerca de \(0{,}0014725/0{,}00016 \approx 9{,}2\) vezes maior: seriam necessários cerca de nove vezes mais entrevistados para a mesma precisão. Esse é o custo estatístico da privacidade — que pode valer a pena se a pergunta direta produzir respostas mentirosas, isto é, viés.
Privacidade diferencial. A ideia da resposta aleatorizada foi generalizada pela privacidade diferencial (Dwork et al. 2006), hoje o padrão teórico de referência em proteção de dados — adotada, por exemplo, na divulgação dos resultados do censo americano de 2020. Dois conjuntos de dados \(D\) e \(D'\) são vizinhos se diferem em um único registro. Um mecanismo aleatório \(\mathcal{M}\) satisfaz \(\varepsilon\)-privacidade diferencial se, para todos os pares de vizinhos e todo conjunto de resultados \(S\),
\[ P\big(\mathcal{M}(D) \in S\big) \leq e^{\varepsilon}\, P\big(\mathcal{M}(D') \in S\big). \]
Em palavras: a presença ou ausência de qualquer pessoa na base altera pouco (no máximo por um fator \(e^{\varepsilon}\)) a distribuição do que é divulgado. Quanto menor \(\varepsilon\), maior a privacidade. A resposta aleatorizada com \(p = 0{,}7\), por exemplo, satisfaz essa definição com \(\varepsilon = \ln(0{,}7/0{,}3) \approx 0{,}85\), pois a razão entre as probabilidades de responder “sim” com e sem a característica é, no máximo, \(0{,}7/0{,}3\).
O mecanismo de Laplace é a forma mais simples de obter privacidade diferencial para consultas numéricas. Se \(q(D)\) é uma consulta (por exemplo, uma contagem) cuja sensibilidade \(\Delta = \max |q(D) - q(D')|\) sobre vizinhos é conhecida, divulga-se
\[ \mathcal{M}(D) = q(D) + L, \qquad L \sim \text{Laplace}(0,\ \Delta/\varepsilon), \]
em que a densidade da Laplace com escala \(b\) é \(\frac{1}{2b}e^{-|x|/b}\). A razão entre as densidades de \(\mathcal{M}(D)\) e \(\mathcal{M}(D')\) em qualquer ponto \(x\) é \(\exp\{(|x - q(D')| - |x - q(D)|)\varepsilon/\Delta\} \leq \exp\{|q(D) - q(D')|\varepsilon/\Delta\} \leq e^{\varepsilon}\), pela desigualdade triangular — o que demonstra a propriedade.
Uma secretaria de saúde quer divulgar o número de casos de uma doença rara em um bairro. Uma contagem tem sensibilidade \(\Delta = 1\) (uma pessoa altera a contagem em no máximo uma unidade). Com \(\varepsilon = 0{,}5\), o ruído tem escala \(b = 1/0{,}5 = 2\), variância \(2b^2 = 8\) e desvio padrão \(\sqrt{8} \approx 2{,}83\). A probabilidade de o ruído ultrapassar 5 casos em valor absoluto é \(P(|L| > 5) = e^{-5/2} \approx 0{,}082\). Para uma contagem de cerca de 200 casos, o erro é irrelevante; para um bairro com 3 casos, ele é da mesma ordem do valor divulgado — e é exatamente isso que protege as pessoas desse bairro.
import numpy as np

rng = np.random.default_rng(42)
n, p, pi_verdadeiro = 1000, 0.7, 0.2

pertence = rng.random(n) < pi_verdadeiro       # característica sensível (oculta)
pergunta_direta = rng.random(n) < p            # sorteio privado da afirmação
resposta_sim = np.where(pergunta_direta, pertence, ~pertence)

lam = resposta_sim.mean()
pi_hat = (lam - (1 - p)) / (2 * p - 1)
ep = np.sqrt(lam * (1 - lam) / (n * (2 * p - 1) ** 2))
print(f"proporção de 'sim': {lam:.3f}; estimativa de pi: {pi_hat:.3f} (EP = {ep:.3f})")
#> proporção de 'sim': 0.384; estimativa de pi: 0.210 (EP = 0.038)

# Mecanismo de Laplace para uma contagem (sensibilidade 1)
def contagem_privada(x, epsilon, rng):
    return x.sum() + rng.laplace(loc=0.0, scale=1.0 / epsilon)

print(pertence.sum(), [round(float(contagem_privada(pertence, 0.5, rng)), 1)
                       for _ in range(3)])
1.17.4 Viés em dados
Um modelo aprende os padrões presentes nos dados — inclusive os indesejáveis. Algumas fontes comuns de viés:
- Viés de seleção: a amostra não representa a população de interesse (ex.: pesquisa de opinião realizada apenas pela internet).
- Viés de sobrevivência: analisam-se apenas os casos que “sobreviveram” a um filtro (ex.: estudar apenas empresas bem-sucedidas para descobrir os fatores de sucesso).
- Viés de medição: o instrumento mede de forma diferente em grupos distintos (ex.: oxímetros que funcionam pior em determinados tons de pele).
- Viés histórico: os dados refletem decisões passadas discriminatórias (ex.: um modelo de contratação treinado com contratações antigas que favoreciam um grupo).
- Variáveis de confusão: uma terceira variável influencia simultaneamente a variável explicativa e a resposta, criando associações espúrias.
Dois hospitais tratam pacientes com uma mesma doença. Os números de sobreviventes por gravidade são:
| Hospital | Casos leves | Casos graves | Total |
|---|---|---|---|
| A | 90/100 (90%) | 240/400 (60%) | 330/500 (66%) |
| B | 340/400 (85%) | 50/100 (50%) | 390/500 (78%) |
Olhando apenas a coluna “Total”, o hospital B parece melhor (\(78\% > 66\%\)). No entanto, o hospital A tem taxa de sobrevivência maior em cada estrato: \(90\% > 85\%\) nos casos leves e \(60\% > 50\%\) nos graves. A inversão ocorre porque A recebe muito mais casos graves (400 de 500), e a gravidade é uma variável de confusão. Formalmente, a taxa total é uma média ponderada das taxas por estrato:
\[ p_A = 0{,}2 \times 0{,}90 + 0{,}8 \times 0{,}60 = 0{,}66, \qquad p_B = 0{,}8 \times 0{,}85 + 0{,}2 \times 0{,}50 = 0{,}78, \]
e os pesos (a composição de gravidade) são muito diferentes entre os hospitais. Uma comparação justa deve controlar a gravidade, por exemplo, padronizando as taxas para uma mesma distribuição de gravidade: com pesos \(0{,}5\) e \(0{,}5\), obtemos \(0{,}75\) para A e \(0{,}675\) para B.
Em R, a verificação é imediata:
dados <- data.frame(
  hospital    = c("A", "A", "B", "B"),
  gravidade   = c("leve", "grave", "leve", "grave"),
  pacientes   = c(100, 400, 400, 100),
  sobreviventes = c(90, 240, 340, 50)
)
# Taxa por estrato
dados$taxa <- dados$sobreviventes / dados$pacientes
dados
# Taxa agregada (ignora a gravidade)
aggregate(cbind(sobreviventes, pacientes) ~ hospital, data = dados, FUN = sum) |>
  transform(taxa = sobreviventes / pacientes)
#>   hospital sobreviventes pacientes taxa
#> 1        A           330       500 0.66
#> 2        B           390       500 0.78
# Taxa padronizada (pesos iguais para leve e grave)
tapply(dados$taxa, dados$hospital, mean)
#>     A     B
#> 0.750 0.675
1.17.5 Boas práticas éticas
- Questionar se a pergunta de negócio é legítima e se o uso dos dados é compatível com a finalidade para a qual foram coletados.
- Minimizar a coleta de dados pessoais e proteger os que forem necessários (controle de acesso, criptografia, pseudonimização).
- Avaliar o desempenho do modelo separadamente por grupos (sexo, faixa etária, região), e não apenas no agregado.
- Documentar as fontes, as decisões de limpeza e as limitações dos dados.
- Comunicar a incerteza dos resultados com honestidade, evitando apresentar associações como relações causais.
1.18 Reprodutibilidade e Governança de Dados
1.18.1 Reprodutibilidade e replicabilidade
Seguindo a terminologia do relatório das Academias Nacionais americanas (National Academies of Sciences, Engineering, and Medicine 2019):
- Reprodutibilidade significa obter resultados consistentes usando os mesmos dados, o mesmo código e as mesmas condições de análise;
- Replicabilidade significa obter resultados consistentes em um novo estudo, com novos dados, que procura responder à mesma pergunta.
A reprodutibilidade é uma exigência mínima: se nem o próprio autor consegue reobter seus números, nenhuma conclusão pode ser confiável. Peng (2011) descreve um espectro de reprodutibilidade, que vai da publicação apenas do texto (não reprodutível), passando pela publicação do código e depois do código e dos dados, até o “padrão-ouro” de código, dados e ambiente computacional ligados e executáveis.
Fontes comuns de irreprodutibilidade em Ciência de Dados incluem: etapas manuais não registradas (como editar uma planilha “à mão”); sementes aleatórias não fixadas; versões diferentes de pacotes; caminhos de arquivos específicos de um computador; e dados alterados após a análise. Boas práticas, como as “dez regras simples” de Sandve et al. (2013) e as “práticas suficientemente boas” de Wilson et al. (2017), incluem automatizar todas as etapas com código, controlar versões com Git (Capítulo de Git/GitHub), registrar as versões dos pacotes e gerar relatórios dinâmicos que combinam texto e código (Capítulo de Markdown/RMarkdown).
set.seed(123)            # fixa a semente do gerador de números aleatórios
amostra <- sample(1:100, 5)
sessionInfo()            # registra versão do R, sistema e pacotes carregados
# renv::init(); renv::snapshot()   # "congela" as versões dos pacotes do projeto
import sys, random
import numpy as np, pandas as pd
random.seed(123)
rng = np.random.default_rng(123) # gerador local e explícito
print(sys.version, np.__version__, pd.__version__)
# pip freeze > requirements.txt # registra as versões dos pacotes1.18.2 Por que tantos resultados não se replicam?
A replicabilidade depende não só de boas práticas computacionais, mas de boa estatística. Um argumento clássico, formalizado por Ioannidis (2005), aplica o teorema de Bayes ao próprio processo científico. Suponha que, entre as hipóteses testadas em uma área, a razão entre hipóteses verdadeiras e falsas seja \(R\); que os testes tenham nível \(\alpha\) e poder \(1 - \beta\). A probabilidade de um resultado “significativo” corresponder a um efeito real — o valor preditivo positivo (VPP) — é
\[ \text{VPP} = \frac{(1 - \beta)R}{(1 - \beta)R + \alpha}. \]
Derivação. Entre \(R + 1\) hipóteses (na escala de chances), \(R\) são verdadeiras, e delas uma fração \(1 - \beta\) dá resultado significativo; das hipóteses falsas (1 na mesma escala), uma fração \(\alpha\) dá significância por acaso. O VPP é a fração de verdadeiros entre os significativos.
- Área com hipóteses plausíveis (\(R = 0{,}25\), isto é, 1 verdadeira para cada 4 falsas) e estudos bem planejados (\(1 - \beta = 0{,}8\), \(\alpha = 0{,}05\)): \(\text{VPP} = 0{,}2/(0{,}2 + 0{,}05) = 0{,}80\).
- Área exploratória, com muitas variáveis candidatas (\(R = 0{,}1\)) e estudos pequenos (\(1 - \beta = 0{,}2\)): \(\text{VPP} = 0{,}02/(0{,}02 + 0{,}05) \approx 0{,}29\).
No segundo cenário — típico de quem “garimpa” grandes bases de dados em busca de associações —, cerca de 71% dos achados significativos seriam falsos. A conexão com o exemplo das comparações múltiplas visto anteriormente não é coincidência: ambos mostram que significância estatística, isoladamente, não é evidência suficiente.
1.18.3 Governança de dados
Governança de dados é o conjunto de políticas, papéis, processos e padrões que garantem que os dados de uma organização sejam confiáveis, seguros, bem documentados e usados de forma legal e ética. Seus componentes principais incluem:
- Papéis e responsabilidades: o proprietário dos dados (data owner) responde pelo uso de um domínio de dados; o curador (data steward) zela pela sua qualidade e documentação no dia a dia; na LGPD, o encarregado faz a ponte entre o controlador, os titulares e a ANPD.
- Metadados e dicionário de dados: descrição de cada variável — nome, significado, tipo, unidade, domínio de valores válidos, origem e responsável. Sem um dicionário de dados, uma coluna chamada
statuscom valores 1, 2 e 3 é indecifrável. - Linhagem dos dados (data lineage): o registro de onde cada dado veio e de todas as transformações pelas quais passou até chegar a um relatório ou modelo.
- Gestão da qualidade: métricas como as da seção de Qualidade de Dados, monitoradas continuamente.
- Segurança e ciclo de vida: controle de acesso, criptografia, políticas de retenção e descarte.
| Variável | Descrição | Tipo | Unidade/Domínio | Origem |
|---|---|---|---|---|
cpf |
CPF do cliente (pseudonimizado) | Texto (nominal) | 11 dígitos | Sistema de cadastro |
idade |
Idade na data da extração | Inteiro (razão) | anos, de 18 a 120 | Calculada a partir da data de nascimento |
uf |
Unidade da federação de residência | Categórica (nominal) | Siglas oficiais do IBGE | Sistema de cadastro |
renda |
Renda mensal declarada | Real (razão) | R$, \(\geq 0\) | Formulário de proposta |
Para dados científicos, os princípios FAIR (Wilkinson et al. 2016) estabelecem que os dados devem ser localizáveis (Findable: identificadores persistentes e metadados ricos), acessíveis (Accessible: protocolos abertos de acesso), interoperáveis (Interoperable: formatos e vocabulários padronizados) e reutilizáveis (Reusable: licença clara e proveniência documentada). Na mesma linha, propostas como as fichas técnicas de conjuntos de dados (datasheets for datasets) (Gebru et al. 2021) e os cartões de modelo (model cards) (Mitchell et al. 2019) recomendam que todo conjunto de dados e todo modelo sejam acompanhados de documentação padronizada sobre sua motivação, composição, processo de coleta, usos recomendados, limitações e desempenho por subgrupos.
Para o cientista de dados, a governança é o que torna possível responder, meses depois, a perguntas como: “de onde veio este número?”, “esta variável podia ser usada para esta finalidade?”, “o modelo em produção foi treinado com qual versão dos dados?”. Em projetos regulados (crédito, saúde, setor público), essas respostas são exigidas por auditores e pela lei.
1.19 Aplicações da Ciência de Dados por Setor
A Ciência de Dados está presente em praticamente todos os setores. Alguns exemplos representativos:
| Setor | Aplicações típicas | Técnicas frequentes |
|---|---|---|
| Saúde | Apoio ao diagnóstico por imagem, previsão de readmissões, vigilância epidemiológica | Classificação, análise de sobrevivência, séries temporais |
| Finanças | Concessão de crédito (credit scoring), detecção de fraudes, gestão de risco | Regressão logística, árvores, detecção de anomalias |
| Varejo | Sistemas de recomendação, previsão de demanda, precificação, segmentação de clientes | Filtragem colaborativa, séries temporais, agrupamento |
| Setor público | Alocação de recursos, detecção de irregularidades em compras públicas, avaliação de políticas | Amostragem, inferência causal, mineração de textos |
| Agronegócio | Previsão de safras, agricultura de precisão com imagens de satélite e sensores | Regressão, visão computacional, estatística espacial |
| Esportes | Avaliação de desempenho de atletas, estratégias de jogo, prevenção de lesões | Modelos de regressão, agrupamento, simulação |
| Indústria | Manutenção preditiva, controle estatístico de qualidade | Séries temporais, controle de processos, classificação |
Em todos esses setores, o padrão se repete: uma pergunta de negócio, dados que precisam ser compreendidos e preparados, um modelo (ou uma simples análise descritiva bem feita) e uma decisão que precisa ser tomada e monitorada.
1.20 Resumo do Capítulo
- A Ciência de Dados é um campo interdisciplinar que combina estatística, computação e conhecimento de domínio para extrair conhecimento e apoiar decisões a partir de dados; ela é uma evolução de áreas antigas impulsionada pela queda dos custos de coleta, armazenamento e processamento.
- A pirâmide DIKW organiza a passagem de dados brutos para informação, conhecimento e sabedoria.
- Historicamente, a área tem raízes nos censos antigos e na estatística, e seu nome e escopo foram moldados por Tukey, Cleveland, Breiman, Loukides e Donoho.
- Breiman distinguiu a cultura da modelagem de dados (foco em inferência) da cultura algorítmica (foco em predição). No modelo \(Y = f(X) + \varepsilon\), o erro de previsão decompõe-se em erro redutível e irredutível.
- Big Data é caracterizado pelos Vs (volume, velocidade, variedade, e também veracidade e valor); mais dados não eliminam o viés.
- As análises podem ser descritivas, diagnósticas, preditivas e prescritivas.
- A CRISP-DM organiza um projeto em seis fases iterativas, com tarefas e entregáveis definidos; KDD, SEMMA, PPDAC e o ciclo de Wickham e Grolemund são representações alternativas. Em produção, modelos sofrem com mudanças de covariáveis e mudanças de conceito, o que exige monitoramento contínuo.
- Os dados podem ser estruturados, semiestruturados (JSON, XML) ou não estruturados; para análise, busca-se o formato tidy.
- As variáveis classificam-se em qualitativas (nominais, ordinais) e quantitativas (discretas, contínuas); as escalas de Stevens (nominal, ordinal, intervalar, razão) determinam as operações e estatísticas admissíveis.
- Na teoria representacional da medição, uma escala é um homomorfismo entre relações empíricas e numéricas; uma afirmação tem significado se for invariante às transformações admissíveis. O erro de medida, formalizado por \(X = T + E\), reduz a confiabilidade e atenua correlações e coeficientes de regressão.
- A qualidade de dados decompõe-se em dimensões mensuráveis (acurácia, completude, consistência, unicidade, validade, atualidade). Os mecanismos de dados faltantes (MCAR, MAR, MNAR) determinam se a análise de casos completos é válida.
- Na amostragem probabilística, as probabilidades de inclusão são conhecidas e o estimador de Horvitz–Thompson é não viesado; a estratificação pode reduzir muito a variância. Em bases auto-selecionadas, o erro é governado pela correlação de defeito dos dados, e um grande \(n\) pode equivaler a uma pequena amostra aleatória.
- O teorema de Bayes, a lei dos grandes números e o teorema central do limite fundamentam a quantificação de incerteza: erros-padrão, intervalos de confiança e cálculo de tamanho de amostra.
- Pelo modelo de resultados potenciais, a diferença observada entre grupos é a soma do efeito causal e de um viés de seleção, que a randomização elimina; testes A/B são experimentos randomizados.
- Projetos de dados envolvem diferentes profissionais e exigem atenção à ética, à LGPD, à anonimização e aos diversos tipos de viés, como ilustra o paradoxo de Simpson.
- A resposta aleatorizada e a privacidade diferencial protegem indivíduos introduzindo aleatoriedade controlada, ao custo de maior variância.
- Reprodutibilidade (mesmos dados e código) e replicabilidade (novos dados) são distintas; a baixa probabilidade a priori das hipóteses e o baixo poder reduzem o valor preditivo de achados significativos. A governança de dados (papéis, dicionários, linhagem, princípios FAIR) sustenta projetos confiáveis.
1.21 Exercícios Propostos
- Explique, com suas palavras, a diferença entre Business Intelligence e Ciência de Dados, relacionando-a aos quatro tipos de análise (descritiva, diagnóstica, preditiva e prescritiva).
- Para um aplicativo de transporte urbano, dê um exemplo de dado, informação, conhecimento e sabedoria, seguindo a pirâmide DIKW.
- Classifique as variáveis a seguir em nominal, ordinal, quantitativa discreta ou quantitativa contínua, e indique a escala de Stevens correspondente: (a) número de gols em uma partida; (b) CEP; (c) classificação de risco de crédito (AAA, AA, A, B, C); (d) tempo de atendimento em minutos; (e) ano de nascimento; (f) índice de massa corporal; (g) cor dos olhos.
- Mostre que, se a temperatura em Celsius é transformada por \(F = 32 + 1{,}8\,C\), a razão \((C_3 - C_2)/(C_2 - C_1)\) entre diferenças é preservada, mas a razão \(C_2/C_1\) não é. Que conclusão isso traz sobre a escala intervalar?
- Considere \(Y = f(X) + \varepsilon\) com \(f(x) = 10 - 2x\), \(\operatorname{Var}(\varepsilon) = 1\) e o modelo ajustado \(\hat{f}(x) = 9 - 1{,}5x\). Calcule o erro redutível, o erro irredutível e o erro quadrático esperado em \(x_0 = 0\), \(x_0 = 2\) e \(x_0 = 6\). Em que ponto o modelo é perfeito?
- Uma equipe testou 40 variáveis independentes e sem efeito real, cada uma ao nível \(\alpha = 0{,}05\). Calcule o número esperado de falsos positivos e a probabilidade de ao menos um falso positivo. Qual nível de significância por teste a correção de Bonferroni usaria para manter o nível global em \(0{,}05\)?
- Uma tabela possui 5 milhões de linhas e 40 colunas numéricas de 8 bytes. Calcule seu tamanho em MB (potências de 10) e em MiB (potências de 2).
- Escolha um problema real (por exemplo, prever a demanda de leitos de UTI em um hospital) e descreva, para cada fase da CRISP-DM, uma tarefa e um entregável concreto.
- Compare CRISP-DM, KDD e SEMMA, apontando uma vantagem e uma limitação de cada metodologia.
- Escreva o registro de dois livros (título, ano e uma lista de autores) em JSON. Em seguida, usando R (
jsonlite+tidyr) ou Python (pandas.json_normalize), converta-o em uma tabela com uma linha por par (livro, autor). - Crie, em R ou em Python, um data frame com cinco observações e uma variável de cada tipo (nominal, ordinal, discreta, contínua), usando os tipos adequados (
factor/orderedouCategorical). Mostre que a comparação>funciona na variável ordinal e não faz sentido na nominal. - Construa um exemplo numérico (com dados hipotéticos) de paradoxo de Simpson envolvendo a taxa de aprovação de dois cursinhos em duas disciplinas. Verifique a inversão calculando as taxas por estrato e as agregadas.
- Explique por que remover nome e CPF de uma base não basta para anonimizá-la. Dada uma tabela com os quase-identificadores (idade exata, sexo, bairro), proponha generalizações para torná-la 3-anônima.
- Segundo a LGPD, o que são dados pessoais sensíveis? Dê dois exemplos de projetos de Ciência de Dados que envolveriam esse tipo de dado e discuta os cuidados necessários.
- Leia o artigo de Breiman (2001) e escreva um texto de uma página posicionando-se sobre a afirmação: “a predição é mais importante que a interpretação”.
- Mostre, com as temperaturas 10 °C, 20 °C e 30 °C, que o coeficiente de variação muda quando os valores são convertidos para Fahrenheit, mas não muda quando uma variável em escala de razão (por exemplo, peso) é convertida de quilogramas para libras. Relacione o resultado à definição de afirmação com significado.
- Seja \(g\) uma função estritamente crescente. Prove que \(g(x)_{(k)} = g(x_{(k)})\) para toda estatística de ordem. Em seguida, mostre com um exemplo que a mediana de uma amostra de tamanho par, definida como a média dos dois valores centrais, pode não comutar com \(g\).
- Na teoria clássica dos testes, um instrumento tem \(\operatorname{Var}(T) = 36\) e \(\operatorname{Var}(E) = 12\). (a) Calcule sua confiabilidade. (b) A correlação observada entre esse instrumento e um segundo, de confiabilidade \(0{,}9\), foi \(0{,}5\). Estime a correlação entre os escores verdadeiros.
- Para o cadastro de clientes da seção de Qualidade de Dados, proponha uma regra de consistência envolvendo duas colunas, implemente-a em R ou Python e calcule a proporção de registros que a satisfazem. Em seguida, remova a duplicata do CPF 333 e recalcule a completude da idade.
- Classifique cada situação como MCAR, MAR ou MNAR, justificando: (a) amostras de sangue perdidas porque um congelador quebrou; (b) idosos deixam mais frequentemente de responder a uma pesquisa online, e a idade de todos é conhecida pelo cadastro; (c) pacientes com sintomas mais graves abandonam um estudo antes da avaliação final; (d) a pergunta sobre consumo de álcool é deixada em branco com mais frequência por quem bebe muito.
- Mostre que, na amostragem aleatória simples, o estimador de Horvitz–Thompson da média, \(\hat{\tau}_{\text{HT}}/N\), coincide com a média amostral \(\bar{y}\). Numa amostragem estratificada com \(N_1 = 800\), \(n_1 = 40\), \(N_2 = 200\) e \(n_2 = 40\), calcule as probabilidades de inclusão e os pesos amostrais de cada estrato.
- Uma população tem três estratos com \((N_h, S_h)\) iguais a \((5.000; 4)\), \((3.000; 8)\) e \((2.000; 20)\). Para \(n = 300\), calcule a variância da média estratificada com alocação proporcional e com alocação de Neyman (desprezando a correção para população finita).
- Usando a Equação 1.2, calcule o erro e o tamanho efetivo de uma base de dados que contém 1% de uma população (\(f = 0{,}01\)), com \(\rho_{R,Y} = 0{,}005\) e \(\sigma_Y = 0{,}5\). Discuta o resultado à luz do caso da Literary Digest.
- Um teste diagnóstico tem sensibilidade \(0{,}90\) e especificidade \(0{,}95\), e a doença tem prevalência de 1%. Calcule a probabilidade de doença dado um resultado positivo. Repita para prevalência de 20% e comente.
- Quantas entrevistas são necessárias para estimar uma proporção com margem de erro de 2 pontos percentuais e 95% de confiança, no pior caso? E com margem de 1 ponto percentual? Qual a relação entre a margem de erro e o tamanho da amostra?
- Construa uma tabela de resultados potenciais com seis unidades em que o efeito causal médio seja positivo, mas a diferença observada entre tratados e não tratados, sob uma certa autosseleção, seja negativa. Calcule o viés de seleção.
- Em Python ou R, simule 10.000 amostras de tamanho \(n = 30\) de uma Bernoulli com \(p = 0{,}05\) e estime a cobertura do intervalo \(\hat{p} \pm 1{,}96\sqrt{\hat{p}(1-\hat{p})/n}\). Repita para \(n = 300\). O que você conclui sobre a aproximação normal para proporções pequenas?
- Numa pesquisa por resposta aleatorizada com \(p = 0{,}8\) e \(n = 500\), houve 260 respostas “sim”. Estime \(\pi\), calcule seu erro-padrão e o valor de \(\varepsilon\) da privacidade diferencial correspondente.
- Uma prefeitura quer divulgar, com o mecanismo de Laplace, a renda média de um bairro em que as rendas estão limitadas ao intervalo \([0, 20.000]\) e há 400 domicílios. Qual a sensibilidade da média (supondo o número de domicílios conhecido)? Qual a escala do ruído para \(\varepsilon = 1\)?
- Calcule o valor preditivo positivo de um achado significativo quando \(R = 1\), \(1 - \beta = 0{,}8\) e \(\alpha = 0{,}05\), e quando \(R = 0{,}01\), \(1 - \beta = 0{,}5\) e \(\alpha = 0{,}05\). Que tipo de pesquisa cada cenário representa?
- Escolha um conjunto de dados público (por exemplo, do portal de dados abertos do governo federal ou do IBGE) e elabore um dicionário de dados para cinco de suas variáveis, indicando também sua escala de Stevens e possíveis problemas de qualidade.
1.22 Leituras Recomendadas
- Morettin e Singer (2021) — introdução em português ao aprendizado estatístico, com ótima discussão sobre a relação entre Estatística e Ciência de Dados.
- James et al. (2013) — referência clássica para o modelo \(Y = f(X) + \varepsilon\), a distinção entre inferência e predição e o dilema viés-variância.
- Breiman (2001) — o artigo das “duas culturas”, leitura obrigatória para estatísticos.
- Donoho (2017) — panorama histórico e crítico de 50 anos de Ciência de Dados, a partir de Tukey.
- Tukey (1962) e Tukey (1977) — as origens da análise de dados como ciência e da análise exploratória.
- Provost e Fawcett (2013) — princípios de Ciência de Dados voltados ao contexto de negócios.
- Chapman et al. (2000) — o guia oficial da metodologia CRISP-DM, com o detalhamento de tarefas e entregáveis.
- Fayyad, Piatetsky-Shapiro, e Smyth (1996) — o artigo que sistematizou o processo KDD.
- Wickham (2014) — o artigo que define os princípios de dados arrumados (tidy data).
- Stevens (1946) — o artigo original sobre as escalas de medida.
- Schutt e O’Neil (2013) — relatos práticos de como a Ciência de Dados é feita na indústria.
- Wild e Pfannkuch (1999) — o ciclo PPDAC e uma análise profunda do pensamento estatístico em investigações empíricas.
- Krantz et al. (1971) — tratamento matemático rigoroso da teoria representacional da medição.
- Cochran (1977) e Bolfarine e Bussab (2005) — referências clássicas (a segunda em português) sobre amostragem probabilística.
- Little e Rubin (2019) — a referência sobre dados faltantes, incluindo os mecanismos MCAR, MAR e MNAR introduzidos por Rubin (1976).
- Meng (2018) — o paradoxo dos grandes dados e a correlação de defeito dos dados, com aplicação às pesquisas eleitorais de 2016.
- Holland (1986) — apresentação clássica do modelo de resultados potenciais e do problema fundamental da inferência causal.
- Dwork et al. (2006) — o artigo que introduziu a privacidade diferencial e o mecanismo de Laplace.
- National Academies of Sciences, Engineering, and Medicine (2019) e Peng (2011) — definições e boas práticas de reprodutibilidade e replicabilidade.
- Wilkinson et al. (2016) — os princípios FAIR para gestão de dados científicos.