6 Documentos Dinâmicos com Markdown e RMarkdown
Aprenda a estruturar relatórios dinâmicos, apresentações e artigos combinando código R, Python e texto formatado de forma elegante com Markdown e RMarkdown. Neste capítulo, discutimos primeiro os fundamentos conceituais (reprodutibilidade, replicabilidade, compêndios de pesquisa, o ambiente computacional e a programação literária), depois estudamos em detalhe a sintaxe do Markdown, sua especificação formal e o conversor Pandoc, com sua árvore sintática e seus filtros e, por fim, os recursos de RMarkdown e Quarto: cabeçalho YAML, opções de chunks, cache, código inline, tabelas, formatos de saída, projetos (livros, sites e apresentações), referências bibliográficas, referências cruzadas, relatórios parametrizados e acessibilidade. O próprio livro que você está lendo foi escrito em Quarto.
6.1 O Princípio da Reprodutibilidade na Ciência de Dados
Na ciência moderna e no ambiente empresarial, a reprodutibilidade é um requisito crítico. Um estudo ou relatório é considerado reprodutível se outro analista puder pegar os mesmos dados de origem e o mesmo código computacional e obter exatamente os mesmos resultados apresentados.
Tradicionalmente, a geração de relatórios era feita de forma manual e segmentada:
- O analista rodava o código no R ou Python para gerar tabelas e gráficos.
- Copiava as saídas numéricas e salvava as imagens dos gráficos no disco.
- Abria um processador de texto (como o Microsoft Word) e colava manualmente as saídas, correndo o risco de cometer erros de digitação ou colar gráficos desatualizados.
- Caso novos dados fossem adicionados, todo esse processo manual precisava ser repetido.
Para solucionar esse problema, surgiram os documentos dinâmicos. A ideia é simples e elegante: unir em um único arquivo de texto plano o texto narrativo explicativo, a sintaxe de formatação simples (Markdown) e as linhas de código de computação (em R, Python, SQL) que de fato processam os dados. Ao compilar o arquivo, o computador executa o código, insere os resultados (tabelas, gráficos) no local exato e gera o documento final (PDF, Word ou HTML).
6.1.1 Reprodutibilidade versus replicabilidade
Os termos “reprodutível” e “replicável” são frequentemente usados como sinônimos, mas a literatura distingue os dois conceitos. Adotaremos as definições do relatório das Academias Nacionais de Ciências dos Estados Unidos (National Academies of Sciences, Engineering, and Medicine 2019):
- Reprodutibilidade (reproducibility): obter resultados consistentes usando os mesmos dados, os mesmos passos computacionais, o mesmo código e as mesmas condições de análise. É, essencialmente, uma propriedade computacional.
- Replicabilidade (replicability): obter resultados consistentes em estudos diferentes que buscam responder à mesma pergunta científica, cada um com seus próprios dados. É uma propriedade científica do fenômeno estudado.
As duas noções podem ser organizadas em uma matriz, cruzando dados e análise:
| Mesma análise (código) | Análise diferente | |
|---|---|---|
| Mesmos dados | Reprodutível | Robusto |
| Dados diferentes | Replicável | Generalizável |
A reprodutibilidade é o padrão mínimo: se nem mesmo os autores, com os próprios dados e código, conseguem obter os números publicados, nenhuma conclusão científica pode ser sustentada. Ela não garante que o resultado esteja correto (um código reprodutível pode conter um erro reprodutível), mas permite que o erro seja encontrado.
Peng (2011) propõe enxergar a reprodutibilidade como um espectro, e não como uma propriedade binária. Do pior para o melhor:
- Apenas a publicação: o artigo descreve os métodos em prosa; não é reprodutível.
- Publicação + código: é possível inspecionar o procedimento, mas não executá-lo integralmente.
- Publicação + código + dados: o leitor pode, em princípio, refazer a análise.
- Código e dados vinculados e executáveis: o documento final é gerado diretamente pelo código a partir dos dados.
- Replicação completa (full replication): o padrão-ouro, em que um estudo independente, com novos dados, confirma o resultado.
Os documentos dinâmicos estudados neste capítulo levam uma análise ao nível 4 do espectro de Peng.
Um exemplo frequentemente citado é o de um influente estudo de macroeconomia sobre dívida pública e crescimento econômico, publicado em 2010 por Carmen Reinhart e Kenneth Rogoff (Reinhart e Rogoff 2010). Em 2013, um estudante de pós-graduação da Universidade de Massachusetts, ao tentar reproduzir os resultados a partir da planilha original, encontrou um erro em uma fórmula que deixava alguns países fora de uma média, além de outras escolhas metodológicas questionáveis (Herndon, Ash, e Pollin 2014). O episódio ilustra como análises feitas em planilhas, com resultados copiados manualmente para o texto, dificultam a auditoria — e como o acesso aos dados e ao procedimento permite encontrar os problemas.
6.1.2 Regras práticas para pesquisa reprodutível
Sandve et al. (2013) resumem a prática da pesquisa computacional reprodutível em dez regras simples, entre as quais destacamos:
- para cada resultado, registre como ele foi produzido;
- evite etapas manuais de manipulação de dados;
- registre as versões exatas de todos os programas e pacotes utilizados;
- use controle de versão para todos os scripts (veja o Capítulo de Controle de Versão com Git e GitHub);
- em análises com aleatoriedade, registre as sementes (seeds) do gerador de números pseudoaleatórios;
- conecte declarações textuais aos resultados subjacentes (exatamente o que o código inline faz, como veremos adiante).
6.1.3 O artigo como “propaganda” e o compêndio de pesquisa
O movimento pela pesquisa reprodutível em estatística tem uma frase fundadora. Inspirados pelo geofísico Jon Claerbout, Buckheit e Donoho (1995) escreveram:
“Um artigo sobre ciência computacional em uma publicação científica não é a produção acadêmica em si; é apenas a propaganda da produção acadêmica. A produção acadêmica de fato é o ambiente de desenvolvimento completo e o conjunto completo de instruções que geraram as figuras.”
A consequência prática é que o produto de uma análise não é apenas o PDF, mas o conjunto texto + código + dados + ambiente. Gentleman e Temple Lang (2007) formalizaram essa ideia no conceito de compêndio de pesquisa (research compendium): um contêiner que reúne os documentos dinâmicos, o código auxiliar e os dados, a partir do qual qualquer leitor pode regenerar o artigo e também explorar alternativas (mudar um parâmetro, outro modelo). Marwick, Boettiger, e Mullen (2018) mostram como organizar um compêndio usando as convenções de um pacote R, com uma estrutura de pastas como:
compendio/
|-- DESCRIPTION          # metadados e dependências (convenção de pacote R)
|-- LICENSE
|-- README.md            # como reproduzir a análise
|-- R/                   # funções auxiliares, documentadas e testadas
|-- dados/
|   |-- brutos/          # somente leitura
|   `-- derivados/       # gerados por código
|-- analise/
|   |-- artigo.qmd       # o documento dinâmico principal
|   `-- referencias.bib
|-- renv.lock            # versões exatas dos pacotes
`-- Dockerfile           # opcional: o ambiente completo
Donoho (2010) resume a motivação em termos de qualidade científica: pesquisadores que trabalham de forma reprodutível encontram mais erros antes de publicar, colaboram melhor e conseguem reaproveitar o próprio trabalho anos depois.
6.1.4 A “crise de reprodutibilidade”
A preocupação não é apenas teórica. Em uma pesquisa com cerca de 1 500 cientistas publicada pela revista Nature, mais de 70% dos respondentes afirmaram já ter tentado, sem sucesso, reproduzir experimentos de outros pesquisadores, e mais da metade não conseguiu reproduzir os próprios experimentos (Baker 2016). As causas são variadas (desenho experimental, pressão por publicação, análise estatística inadequada), mas parte delas é puramente computacional: código indisponível, etapas manuais não documentadas, versões de programas não registradas. Essa parte é inteiramente evitável com as ferramentas deste capítulo e do Capítulo de Controle de Versão com Git e GitHub.
Para os dados, um conjunto de diretrizes muito adotado são os princípios FAIR (Wilkinson et al. 2016): os dados devem ser localizáveis (Findable, com identificadores persistentes como DOIs e metadados ricos), acessíveis (Accessible, por protocolos abertos), interoperáveis (Interoperable, em formatos e vocabulários padronizados) e reutilizáveis (Reusable, com licença clara e procedência documentada).
6.1.5 O ambiente computacional e seus níveis
Mesmo com código e dados idênticos, os resultados podem mudar se o ambiente mudar. Podemos pensar o ambiente como uma pilha de camadas, cada uma das quais pode afetar o resultado:
| Camada | Exemplos de fonte de variação | Como registrar ou fixar |
|---|---|---|
| Código do projeto | Edições não registradas | Git |
| Dados | Arquivo de origem atualizado | Dados brutos somente leitura, checksums, DVC |
| Pacotes | Mudança de comportamento entre versões | renv.lock, requirements.txt, environment.yml |
| Linguagem | Mudança em funções básicas ou no gerador aleatório | Versão do R/Python registrada |
| Sistema operacional | Bibliotecas numéricas (BLAS/LAPACK), locale, codificação de texto | Contêineres (Docker) |
| Hardware | Paralelismo, instruções de ponto flutuante | Documentação; resultados com tolerância numérica |
Dois exemplos concretos mostram que essas camadas importam. Primeiro, na versão 3.6.0 do R, o algoritmo usado por sample() foi alterado para corrigir um pequeno viés; com a mesma semente, o resultado mudou:
set.seed(42)
sample(10, 3)                                  # R >= 3.6.0 (padrão atual)
#> [1]  1  5 10

RNGkind(sample.kind = "Rounding")   # algoritmo anterior ao R 3.6.0 (emite um aviso)
set.seed(42)
sample(10, 3)
#> [1] 10  9  3
Uma análise de 2018 com amostragem aleatória, refeita hoje sem esse cuidado, produziria outra amostra. Segundo, a aritmética de ponto flutuante não é associativa:
(0.1 + 0.2) + 0.3 == 0.1 + (0.2 + 0.3)
#> False
print((0.1 + 0.2) + 0.3, 0.1 + (0.2 + 0.3))
#> 0.6000000000000001 0.6
Formalmente, se \(\operatorname{fl}(\cdot)\) denota o arredondamento para o número de máquina mais próximo, em geral \(\operatorname{fl}(\operatorname{fl}(a + b) + c) \neq \operatorname{fl}(a + \operatorname{fl}(b + c))\). Como somas em paralelo podem ocorrer em ordens diferentes, bibliotecas numéricas distintas (ou o mesmo código com número diferente de núcleos) podem produzir resultados que diferem nas últimas casas decimais. Por isso, ao comparar resultados reproduzidos, usamos uma tolerância (como all.equal() no R ou numpy.isclose() no Python), e não igualdade exata.
As ferramentas para fixar o ambiente formam uma escada de rigor crescente:
- Registrar: incluir
sessionInfo()(R) ou as versões dos pacotes (Python) no final do relatório. - Isolar e fixar pacotes:
renvno R (renv::init(),renv::snapshot(),renv::restore()),venv+pip freezeou Conda no Python. - Encapsular o sistema inteiro em um contêiner: um contêiner (Docker é a ferramenta mais popular) empacota o sistema operacional, as bibliotecas, a linguagem e os pacotes em uma imagem descrita por um arquivo de texto, o
Dockerfile(Boettiger 2015). Diferentemente de uma máquina virtual, o contêiner compartilha o núcleo do sistema hospedeiro, o que o torna leve.
# Dockerfile: ambiente fixo para renderizar o relatório
FROM rocker/r-ver:4.4.1
RUN apt-get update && apt-get install -y --no-install-recommends pandoc
RUN R -e "install.packages('renv')"
WORKDIR /projeto
COPY renv.lock renv.lock
RUN R -e "renv::restore()"
COPY . .
CMD ["R", "-e", "rmarkdown::render('analise/relatorio.Rmd')"]
docker build -t relatorio-evasao . # constrói a imagem a partir do Dockerfile
docker run --rm -v "$PWD/saida:/projeto/saida" relatorio-evasaoAs imagens do projeto Rocker fixam a versão do R e uma data de instantâneo do repositório de pacotes, de modo que FROM rocker/r-ver:4.4.1 produz o mesmo ambiente hoje e daqui a alguns anos. O Dockerfile é texto plano e deve ser versionado com o Git.
Nem todo trabalho precisa de um contêiner. Para um trabalho da disciplina, registrar o sessionInfo() e usar renv costuma bastar. Para um artigo, uma tese ou um relatório que embasa decisões importantes, vale subir até o nível do contêiner e da integração contínua, que renderiza o documento do zero a cada alteração.
6.2 Programação Literária: a Origem dos Documentos Dinâmicos
A ideia de entrelaçar texto e código tem uma origem precisa. Em 1984, o cientista da computação Donald Knuth (criador do sistema tipográfico TeX) publicou o artigo Literate Programming (Knuth 1984), em que propunha uma mudança de atitude:
“Em vez de imaginar que nossa principal tarefa é instruir um computador sobre o que fazer, concentremo-nos em explicar a seres humanos o que queremos que o computador faça.”
Na programação literária (literate programming), o programa é escrito como uma obra expositiva, na ordem mais adequada à compreensão humana, com trechos de código embutidos no texto. Knuth criou o sistema WEB, a partir do qual duas ferramentas extraíam produtos diferentes do mesmo arquivo-fonte:
- tangle (emaranhar): extraía apenas o código, na ordem exigida pelo compilador;
- weave (tecer): produzia o documento tipografado, com texto e código formatados.
Os documentos dinâmicos de análise de dados herdam essa ideia com uma diferença fundamental: além de exibir o código, eles o executam e inserem os resultados no documento. A linha evolutiva no ecossistema estatístico é:
| Ano | Ferramenta | Contribuição |
|---|---|---|
| 1984 | WEB (Knuth) | Programação literária: tangle e weave |
| 2002 | Sweave (Friedrich Leisch) | Código R embutido em documentos LaTeX (Leisch 2002) |
| 2012 | knitr (Yihui Xie) | Motor de execução moderno e extensível, com suporte a vários formatos (Xie 2015) |
| 2012 | R Markdown (RStudio) | Combinação de knitr com Markdown e Pandoc (Xie, Allaire, e Grolemund 2018) |
| 2014 | Jupyter (projeto derivado do IPython) | Notebooks interativos multilíngues |
| 2022 | Quarto (Posit) | Sistema de publicação multilíngue sucessor do R Markdown |
O nome knitr (de knit, tricotar) é, aliás, uma homenagem direta ao weave de Knuth.
6.3 O que é Markdown e suas Características
O Markdown é uma linguagem de marcação leve (lightweight markup language), criada em 2004 por John Gruber e Aaron Swartz, com o objetivo primordial de ser extremamente simples de escrever e de se ler em formato de texto plano (sem formatação oculta).
Ao contrário de linguagens de marcação pesadas (como o HTML purista ou XML), o Markdown é projetado com foco nas seguintes cinco características:
- Sintaxe Simples: A formatação é feita com pouquíssimos caracteres especiais, não exigindo decorar tags complexas.
- Legibilidade: Mesmo o código-fonte (texto plano) sem estar compilado é facilmente compreensível e agradável aos olhos humanos.
- Conversão Fácil: O texto em Markdown pode ser perfeitamente exportado e renderizado para HTML, PDF, Word, etc.
- Foco no Conteúdo: O autor não precisa se distrair com botões, caixas de diálogo e menus de formatação complexos; basta focar no que importa: a escrita.
- Portabilidade: Como é texto plano, o arquivo Markdown pode ser aberto, lido e editado em qualquer sistema operacional (Windows, Mac, Linux) e em qualquer editor de texto.
Há ainda uma sexta vantagem, decisiva para a ciência de dados: por ser texto plano, o Markdown funciona perfeitamente com o controle de versão — as diferenças entre duas versões de um relatório aparecem linha a linha, ao contrário do que ocorre com arquivos binários .docx.
A especificação original de Gruber era informal e deixava casos ambíguos, o que levou ao surgimento de diversos “dialetos”. Em 2014 foi lançada a especificação CommonMark, que define o comportamento de forma rigorosa, e plataformas como o GitHub adotaram extensões próprias (GitHub Flavored Markdown). O R Markdown e o Quarto utilizam o Pandoc Markdown, um dialeto bastante rico, que inclui tabelas, notas de rodapé, citações bibliográficas e equações.
A seguir, destacamos as formatações sintáticas básicas mais utilizadas e, em seguida, os recursos mais avançados.
6.3.1 Cabeçalhos (Títulos)
Usamos o símbolo de cerquilha (#) para definir níveis de títulos:
# Título Principal (H1)
## Seção do Capítulo (H2)
### Subseção (H3)
São seis níveis possíveis (de # a ######). Deve haver um espaço após as cerquilhas e, por segurança, uma linha em branco antes do cabeçalho. É possível atribuir um identificador a um cabeçalho para referenciá-lo depois, como em ## Metodologia {#sec-metodologia}, e impedir sua numeração com a classe {.unnumbered}.
6.3.2 Parágrafos e Quebras de Linha
Parágrafos são separados por uma linha em branco. Uma simples quebra de linha no arquivo-fonte não cria um novo parágrafo: as linhas são unidas no documento final. Isso permite escrever uma frase por linha no código-fonte, o que facilita a leitura de diferenças no Git. Para forçar uma quebra de linha dentro de um parágrafo, termine a linha com uma barra invertida (\) ou com dois espaços.
6.3.3 Formatação de Texto
- Negrito: Envolver o texto em dois asteriscos:
**texto em negrito**. - Itálico: Envolver o texto em um asterisco:
*texto em itálico*. - Código Inline: Envolver em crases simples para termos técnicos ou de programação:
`meu_codigo_R`.
Outros recursos de formatação em linha do Pandoc Markdown:
| Sintaxe | Resultado |
|---|---|
***negrito e itálico*** |
negrito e itálico |
~~tachado~~ |
|
H~2~O (subscrito) |
H2O |
x^2^ (sobrescrito) |
x2 |
[texto]{.smallcaps} |
texto |
\*literal\* (escape) |
*literal* |
O escape com barra invertida é necessário sempre que se deseja exibir literalmente um caractere especial do Markdown, como *, _, # ou o cifrão $ (que, como veremos, delimita equações). Por exemplo, um valor monetário deve ser escrito como R\$ 10,00.
6.3.4 Listas
# Lista não ordenada
* Primeiro item
* Segundo item
  * Subitem indentado com dois espaços

# Lista ordenada
1. Primeiro passo
2. Segundo passo
Em listas ordenadas, apenas o primeiro número importa: escrever 1., 1., 1. produz 1, 2, 3, o que facilita reordenar itens. Também existem listas de tarefas e listas de definição:
- [x] Coletar os dados
- [ ] Ajustar o modelo

Viés
: Diferença entre o valor esperado do estimador e o parâmetro.

Variância
: Dispersão do estimador em torno do seu valor esperado.
6.3.5 Links e Imagens
# Links clicáveis: [texto link](URL)
Acesse a página da [UFPE](https://www.ufpe.br/).
# Imagens: 
Uma imagem isolada em um parágrafo vira uma figura, e o texto entre colchetes torna-se a legenda. Atributos entre chaves controlam tamanho, alinhamento e identificação: {#fig-renda width=70%}. Links também podem apontar para seções internas, como [veja a metodologia](#sec-metodologia), e URLs podem ser escritas diretamente entre sinais de menor e maior: <https://www.ufpe.br>.
6.3.6 Citações em Bloco
Linhas iniciadas pelo sinal > formam um bloco de citação, útil para destacar a fala de um autor:
> Todos os modelos estão errados, mas alguns são úteis.
>
> --- George Box
6.3.7 Blocos de Código
Para exibir código com destaque de sintaxe, usamos uma cerca (fence) de três crases seguida do nome da linguagem. Note a diferença: r (sem chaves) apenas exibe o código, enquanto {r} (com chaves, em documentos dinâmicos) indica um bloco que será executado.
```r
modelo <- lm(mpg ~ wt, data = mtcars)
```
Este livro usa exclusivamente blocos do primeiro tipo, ou seja, o código é exibido mas não executado durante a compilação.
6.3.8 Tabelas
O formato mais usado é a tabela de barras verticais (pipe table). A segunda linha separa o cabeçalho do corpo, e a posição dos dois-pontos define o alinhamento de cada coluna:
| Variável  | Média | Desvio-padrão |
|:----------|------:|:-------------:|
| Idade     |  34,2 |      9,8      |
| Renda     |  4520 |     2310      |

: Estatísticas descritivas da amostra {#tbl-descritivas}| Sintaxe do separador | Alinhamento |
|---|---|
:--- |
À esquerda |
---: |
À direita (recomendado para números) |
:---: |
Centralizado |
As colunas não precisam estar visualmente alinhadas no código-fonte, mas alinhá-las melhora a legibilidade. Em documentos dinâmicos, raramente escrevemos tabelas à mão: elas são geradas a partir de data frames por funções como knitr::kable() ou pelos pacotes gt e flextable.
6.3.9 Notas de Rodapé
Notas de rodapé podem ser escritas com uma marca e uma definição separada, ou diretamente em linha:
O teste foi bicaudal.[^1] A amostra foi estratificada.^[Por região geográfica.]

[^1]: Com nível de significância de 5%.
O Pandoc numera as notas automaticamente; no HTML elas aparecem no fim do documento ou como janelas flutuantes, e no PDF no pé da página.1
6.3.10 Equações Matemáticas com LaTeX
Um dos recursos mais valiosos para estatísticos é a escrita de equações usando a sintaxe do LaTeX. Um par de cifrões delimita uma equação em linha e um par de cifrões duplos, uma equação em destaque (display):
A média amostral é $\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i$.

$$
s^2 = \frac{1}{n-1}\sum_{i=1}^{n}\left(x_i - \bar{x}\right)^2
$$ {#eq-variancia}

Conforme a @eq-variancia, a variância amostral usa $n-1$ no denominador.
O resultado renderizado é: a média amostral é \(\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i\), e
\[ s^2 = \frac{1}{n-1}\sum_{i=1}^{n}\left(x_i - \bar{x}\right)^2 . \]
No HTML, as equações são desenhadas pela biblioteca MathJax (ou KaTeX); no PDF, pelo próprio LaTeX. Alguns comandos frequentes:
| Objetivo | Código LaTeX | Resultado |
|---|---|---|
| Fração | \frac{a}{b} |
\(\frac{a}{b}\) |
| Índices e expoentes | x_i^2 |
\(x_i^2\) |
| Somatório | \sum_{i=1}^{n} |
\(\sum_{i=1}^{n}\) |
| Integral | \int_{-\infty}^{\infty} |
\(\int_{-\infty}^{\infty}\) |
| Letras gregas | \mu, \sigma, \beta |
\(\mu, \sigma, \beta\) |
| Chapéu e barra | \hat{\beta}, \bar{y} |
\(\hat{\beta}, \bar{y}\) |
| Vetores e matrizes | \mathbf{X}^\top \mathbf{y} |
\(\mathbf{X}^\top \mathbf{y}\) |
| Conjuntos de números | \mathbb{R}^p |
\(\mathbb{R}^p\) |
| Esperança e variância | \mathbb{E}[X], \operatorname{Var}(X) |
\(\mathbb{E}[X], \operatorname{Var}(X)\) |
| Distribuição | X \sim \mathcal{N}(\mu, \sigma^2) |
\(X \sim \mathcal{N}(\mu, \sigma^2)\) |
Para equações em várias linhas alinhadas, usamos o ambiente aligned, que alinha as linhas pelo símbolo &. Por exemplo, a derivação do estimador de mínimos quadrados:
$$
\begin{aligned}
S(\boldsymbol\beta) &= (\mathbf{y} - \mathbf{X}\boldsymbol\beta)^\top(\mathbf{y} - \mathbf{X}\boldsymbol\beta) \\
\frac{\partial S}{\partial \boldsymbol\beta} &= -2\mathbf{X}^\top\mathbf{y} + 2\mathbf{X}^\top\mathbf{X}\boldsymbol\beta = \mathbf{0} \\
\hat{\boldsymbol\beta} &= (\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\mathbf{y}
\end{aligned}
$$
que é renderizada como
\[ \begin{aligned} S(\boldsymbol\beta) &= (\mathbf{y} - \mathbf{X}\boldsymbol\beta)^\top(\mathbf{y} - \mathbf{X}\boldsymbol\beta) \\ \frac{\partial S}{\partial \boldsymbol\beta} &= -2\mathbf{X}^\top\mathbf{y} + 2\mathbf{X}^\top\mathbf{X}\boldsymbol\beta = \mathbf{0} \\ \hat{\boldsymbol\beta} &= (\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\mathbf{y}. \end{aligned} \]
- Não deixe espaço logo após o cifrão de abertura nem logo antes do cifrão de fechamento de uma equação em linha (
$ x $não é reconhecido). (ii) Prefira comandos padrão do LaTeX: pacotes exóticos podem funcionar no PDF e falhar no HTML (ou vice-versa). (iii) Em textos com valores monetários, escape o cifrão (R\$), caso contrário o trecho até o próximo cifrão será interpretado como matemática.
6.3.11 Mais Recursos de LaTeX Matemático
O LaTeX foi criado por Leslie Lamport sobre o TeX de Knuth (Lamport 1994), e seu modo matemático é, de fato, a linguagem franca para escrever matemática no computador. Alguns recursos adicionais aparecem com frequência em textos de Estatística:
| Objetivo | Código LaTeX | Resultado |
|---|---|---|
| Delimitadores que crescem | \left( \frac{a}{b} \right) |
\(\left( \frac{a}{b} \right)\) |
| Texto dentro da equação | x_i \text{ para todo } i |
\(x_i \text{ para todo } i\) |
| Operadores com nome | \operatorname{Cov}(X, Y) |
\(\operatorname{Cov}(X, Y)\) |
| Operadores com limites | \arg\max_{\theta} |
\(\arg\max_{\theta}\) |
| Limites e convergência | \xrightarrow{d} |
\(\xrightarrow{d}\) |
| Chaves explicativas | \underbrace{a + b}_{n} |
\(\underbrace{a + b}_{n}\) |
| Relações | \le, \ge, \neq, \approx, \propto |
\(\le, \ge, \neq, \approx, \propto\) |
| Espaçamentos | a\,b \quad c \qquad d |
\(a\,b \quad c \qquad d\) |
| Independência | X \perp Y |
\(X \perp Y\) |
| Estimador com chapéu largo | \widehat{\operatorname{Var}}(X) |
\(\widehat{\operatorname{Var}}(X)\) |
Três ambientes completam o repertório. O ambiente cases define funções por partes, pmatrix (ou bmatrix, com colchetes) escreve matrizes, e aligned, já visto, alinha derivações:
$$
f(x) =
\begin{cases}
\lambda e^{-\lambda x}, & x \ge 0,\\
0, & x < 0,
\end{cases}
\qquad
\boldsymbol\Sigma =
\begin{pmatrix}
\sigma_1^2 & \rho\,\sigma_1\sigma_2\\
\rho\,\sigma_1\sigma_2 & \sigma_2^2
\end{pmatrix}.
$$
que é renderizado como
\[ f(x) = \begin{cases} \lambda e^{-\lambda x}, & x \ge 0,\\ 0, & x < 0, \end{cases} \qquad \boldsymbol\Sigma = \begin{pmatrix} \sigma_1^2 & \rho\,\sigma_1\sigma_2\\ \rho\,\sigma_1\sigma_2 & \sigma_2^2 \end{pmatrix}. \]
Exemplo resolvido: da notação ao código LaTeX. Queremos escrever a função de log-verossimilhança de uma amostra \(x_1, \ldots, x_n\) de uma distribuição normal e o estimador de máxima verossimilhança de \(\mu\). Procedemos por partes:
- A densidade de uma observação é \(f(x_i \mid \mu, \sigma^2) = (2\pi\sigma^2)^{-1/2} \exp\{-(x_i - \mu)^2/(2\sigma^2)\}\); em LaTeX, a barra condicional é
\mid, a exponencial é\expe as chaves literais são\{e\}. - A verossimilhança é o produto das densidades (
\prod_{i=1}^{n}), e o logaritmo transforma o produto em soma (\sum_{i=1}^{n}). - Usamos
alignedpara alinhar as igualdades pelo&e\\para quebrar as linhas.
$$
\begin{aligned}
\ell(\mu, \sigma^2)
  &= \log \prod_{i=1}^{n} f(x_i \mid \mu, \sigma^2) \\
  &= -\frac{n}{2}\log(2\pi\sigma^2) - \frac{1}{2\sigma^2}\sum_{i=1}^{n}(x_i - \mu)^2, \\
\frac{\partial \ell}{\partial \mu}
  &= \frac{1}{\sigma^2}\sum_{i=1}^{n}(x_i - \mu) = 0
  \quad\Longrightarrow\quad
  \hat{\mu} = \bar{x}.
\end{aligned}
$$ {#eq-mv-normal}
O resultado é:
\[ \begin{aligned} \ell(\mu, \sigma^2) &= \log \prod_{i=1}^{n} f(x_i \mid \mu, \sigma^2) \\ &= -\frac{n}{2}\log(2\pi\sigma^2) - \frac{1}{2\sigma^2}\sum_{i=1}^{n}(x_i - \mu)^2, \\ \frac{\partial \ell}{\partial \mu} &= \frac{1}{\sigma^2}\sum_{i=1}^{n}(x_i - \mu) = 0 \quad\Longrightarrow\quad \hat{\mu} = \bar{x}. \end{aligned} \]
Duas recomendações de estilo: (i) use \log, \exp, \max, \operatorname{Var} em vez de escrever log em itálico (o LaTeX interpretaria \(log\) como o produto das variáveis \(l\), \(o\) e \(g\)); (ii) defina toda a notação no texto antes de usá-la, e mantenha-a consistente no documento inteiro (por exemplo, vetores sempre em negrito).
6.3.12 Linhas Horizontais, Divs e Spans
Três ou mais hífens em uma linha isolada (---) produzem uma linha horizontal. O Pandoc Markdown permite ainda agrupar conteúdo em blocos com atributos, as divs, delimitadas por três ou mais sinais de dois-pontos, e aplicar atributos a trechos de texto, os spans, com colchetes seguidos de chaves. O Quarto usa divs para criar caixas de destaque (callouts), layouts em colunas e abas:
::: {.callout-tip}
## Dica
Sempre fixe a semente com `set.seed()` antes de sortear amostras.
:::

Este texto tem uma [palavra destacada]{.mark}.

:::: {.columns}
::: {.column width="50%"}
Coluna da esquerda.
:::
::: {.column width="50%"}
Coluna da direita.
:::
::::
Note que, para aninhar divs, a div externa usa mais sinais de dois-pontos (::::) do que as internas (:::), de modo que cada fechamento seja associado sem ambiguidade à abertura correta.
6.3.13 Especificação Formal: CommonMark e as Ambiguidades do Markdown
A descrição original do Markdown, publicada por Gruber em 2004, era um texto em prosa acompanhado de um script em Perl. Ela não respondia a muitas perguntas: uma lista pode começar logo após um parágrafo, sem linha em branco? Quantos espaços de indentação definem uma sublista? Como interpretar *a **b** c*? Cada implementação respondeu de um jeito, e o mesmo arquivo passou a produzir documentos diferentes em ferramentas diferentes.
A especificação CommonMark (2014) resolveu o problema da forma como linguagens de programação costumam fazê-lo: com uma especificação detalhada, centenas de exemplos que servem como testes de conformidade e implementações de referência. A análise é feita em duas fases: (1) a estrutura de blocos (parágrafos, listas, citações, cabeçalhos, blocos de código) é determinada linha a linha; (2) o conteúdo em linha de cada bloco (ênfase, links, código) é então analisado com regras precisas de “delimitadores” para asteriscos e sublinhados.
Exemplo resolvido. O Pandoc permite escolher o dialeto de entrada com a opção -f. Considere o arquivo lista.md, em que a lista começa imediatamente após um parágrafo:
Os passos são:
1. coletar
2. analisar
pandoc -f commonmark -t html lista.md
#> <p>Os passos são:</p>
#> <ol type="1">
#> <li>coletar</li>
#> <li>analisar</li>
#> </ol>
pandoc -f markdown -t html lista.md # Pandoc Markdown (usado pelo Quarto)
#> <p>Os passos são: 1. coletar 2. analisar</p>O CommonMark (e o GitHub Flavored Markdown, que é uma extensão dele) reconhece a lista; o Pandoc Markdown exige uma linha em branco antes da lista e, sem ela, trata as linhas como continuação do parágrafo. A decisão do Pandoc evita que um parágrafo cuja linha seguinte, por acaso, comece com um número seguido de ponto (como “1984. Nesse ano…”) vire acidentalmente uma lista. A lição prática para quem escreve em Quarto: sempre deixe uma linha em branco antes de listas, cabeçalhos, tabelas e blocos de código.
Outro caso é o aninhamento de ênfases, resolvido pelas regras de delimitadores do CommonMark:
printf '*a **b** c*\n' | pandoc -f commonmark -t html
#> <p><em>a <strong>b</strong> c</em></p>
printf 'var_a_b e var*a*b\n' | pandoc -f commonmark -t html
#> <p>var_a_b e var<em>a</em>b</p>
O segundo exemplo mostra uma regra útil para quem escreve nomes de variáveis: sublinhados no meio de palavras não produzem ênfase (var_a_b permanece literal), mas asteriscos produzem. Ainda assim, nomes de variáveis e funções devem ser escritos como código em linha (`var_a_b`), o que elimina qualquer ambiguidade.
6.4 Pandoc: o Conversor Universal
Por trás do R Markdown e do Quarto está o Pandoc, criado pelo filósofo John MacFarlane (Universidade da Califórnia em Berkeley), descrito como um “conversor universal de documentos”. O Pandoc lê dezenas de formatos (Markdown, HTML, LaTeX, docx, Jupyter, entre outros) e escreve outras dezenas.
O segredo da sua versatilidade é uma arquitetura em três etapas:
\[ \text{documento de entrada} \xrightarrow{\text{leitor}} \text{AST} \xrightarrow{\text{filtros}} \text{AST}' \xrightarrow{\text{escritor}} \text{documento de saída}. \]
O leitor (reader) converte o arquivo de entrada em uma árvore sintática abstrata (Abstract Syntax Tree, AST): uma representação estruturada e independente de formato, em que o documento é uma lista de blocos (cabeçalhos, parágrafos, listas, tabelas, blocos de código), e cada bloco contém elementos em linha (texto, ênfase, links, citações, equações). Filtros opcionais (escritos em Lua, por exemplo) podem transformar a árvore, e o escritor (writer) a converte para o formato de destino. Assim, com \(m\) leitores e \(n\) escritores, o Pandoc suporta \(m \times n\) conversões mantendo apenas \(m + n\) componentes, em vez de \(m \times n\) conversores especializados.
O Pandoc pode ser usado diretamente na linha de comando:
# Markdown para Word
pandoc relatorio.md -o relatorio.docx

# Markdown para PDF (via LaTeX), com bibliografia e numeração de seções
pandoc relatorio.md --citeproc --bibliography=refs.bib --number-sections -o relatorio.pdf

# Word para Markdown (útil para migrar documentos antigos)
pandoc antigo.docx -t markdown -o antigo.md

# Visualiza a AST de um pequeno trecho
echo '*Olá*, **mundo**!' | pandoc -t native
#> [ Para
#>     [ Emph [ Str "Ol\225" ]
#>     , Str ","
#>     , Space
#>     , Strong [ Str "mundo" ]
#>     , Str "!"
#>     ]
#> ]
6.4.1 A Árvore Sintática Abstrata em Detalhe
A saída acima revela a estrutura da AST: o documento é uma lista de blocos (aqui, um único Para, de parágrafo), e cada bloco contém uma lista de elementos em linha (Str para palavras, Space para espaços, Emph para itálico, Strong para negrito). Formalmente, a AST do Pandoc é definida por um tipo de dados algébrico (escrito na linguagem Haskell), que podemos resumir como uma gramática:
\[ \begin{aligned} \text{Documento} &::= \text{Meta} \times \text{Bloco}^{*}\\ \text{Bloco} &::= \texttt{Para}(\text{Inline}^{*}) \mid \texttt{Header}(n, \text{Attr}, \text{Inline}^{*}) \mid \texttt{CodeBlock}(\text{Attr}, \text{texto})\\ &\qquad \mid \texttt{BulletList}((\text{Bloco}^{*})^{*}) \mid \texttt{Div}(\text{Attr}, \text{Bloco}^{*}) \mid \cdots\\ \text{Inline} &::= \texttt{Str}(\text{texto}) \mid \texttt{Space} \mid \texttt{Emph}(\text{Inline}^{*}) \mid \texttt{Strong}(\text{Inline}^{*})\\ &\qquad \mid \texttt{Math}(\text{tipo}, \text{texto}) \mid \texttt{Cite}(\ldots) \mid \texttt{Link}(\ldots) \mid \cdots \end{aligned} \]
em que \(X^{*}\) denota uma lista (possivelmente vazia) de elementos do tipo \(X\), e \(\text{Attr}\) é o trio (identificador, classes, atributos chave-valor) que escrevemos entre chaves, como em {#fig-renda .classe largura=50%}. A definição é recursiva: um Emph contém outros elementos em linha, que podem conter outro Emph, e uma Div contém blocos, que podem conter outras Div. É por isso que a AST é uma árvore.
A mesma árvore pode ser exportada em JSON (pandoc -t json), o formato usado para a comunicação com filtros escritos em qualquer linguagem:
echo '*Olá*, **mundo**!' | pandoc -t json | python3 -m json.tool
#> {
#>     "pandoc-api-version": [1, 23, 1],
#>     "meta": {},
#>     "blocks": [
#>         {
#>             "t": "Para",
#>             "c": [
#>                 {"t": "Emph", "c": [{"t": "Str", "c": "Olá"}]},
#>                 {"t": "Str", "c": ","},
#>                 {"t": "Space"},
#>                 ...
Cada nó tem um tipo ("t") e um conteúdo ("c"). (A saída real tem um elemento por linha; ela foi condensada aqui.)
6.4.2 Filtros Lua
Um filtro é uma função que recebe a AST e devolve uma AST modificada: \(\phi: \text{AST} \to \text{AST}\). Como os filtros operam sobre a representação intermediária, um único filtro funciona para todos os formatos de saída. Vários filtros podem ser compostos: aplicar \(\phi_1\) e depois \(\phi_2\) corresponde à composição \(\phi_2 \circ \phi_1\), e a ordem importa.
O Pandoc embute um interpretador da linguagem Lua, e os filtros Lua são a forma mais simples e rápida de escrever filtros (as extensões do Quarto, por exemplo, são em grande parte filtros Lua). Um filtro Lua define funções com os nomes dos tipos de nós; o Pandoc percorre a árvore e chama a função correspondente em cada nó daquele tipo. Se a função retorna um novo elemento, ele substitui o original; se não retorna nada, o nó é mantido.
Exemplo resolvido. O filtro abaixo converte o texto de todos os cabeçalhos para maiúsculas e conta as palavras (elementos Str) do documento:
-- maiusculas.lua
local palavras = 0

function Header(el)
  return pandoc.walk_block(el, {
    Str = function(s) return pandoc.Str(pandoc.text.upper(s.text)) end
  })
end

function Str(el)
  palavras = palavras + 1
end

function Pandoc(doc)
  io.stderr:write("Total de palavras: " .. palavras .. "\n")
  return doc
end
Aplicando-o a um arquivo t.md com o cabeçalho # Introdução à análise e o parágrafo Este é um *teste* com sete palavras.:
pandoc t.md --lua-filter=maiusculas.lua -t markdown
#> Total de palavras: 10
#> # INTRODUÇÃO À ANÁLISE
#>
#> Este é um *teste* com sete palavras.
Por que 10 palavras, se o parágrafo tem 7? Porque a contagem inclui as 3 palavras do cabeçalho. Por padrão, o Pandoc faz um percurso por tipos (typewise traversal): primeiro visita todos os elementos em linha do documento inteiro, depois todos os blocos e, por fim, chama a função Pandoc com o documento completo. Assim, quando Pandoc é chamada, a contagem já está completa. Note também o uso de pandoc.text.upper, que trata corretamente caracteres acentuados codificados em UTF-8 (a função string.upper padrão da linguagem Lua não o faz).
No Quarto, filtros são declarados no YAML:
filters:
  - maiusculas.lua
6.5 RMarkdown e Quarto: A Estrutura dos Arquivos
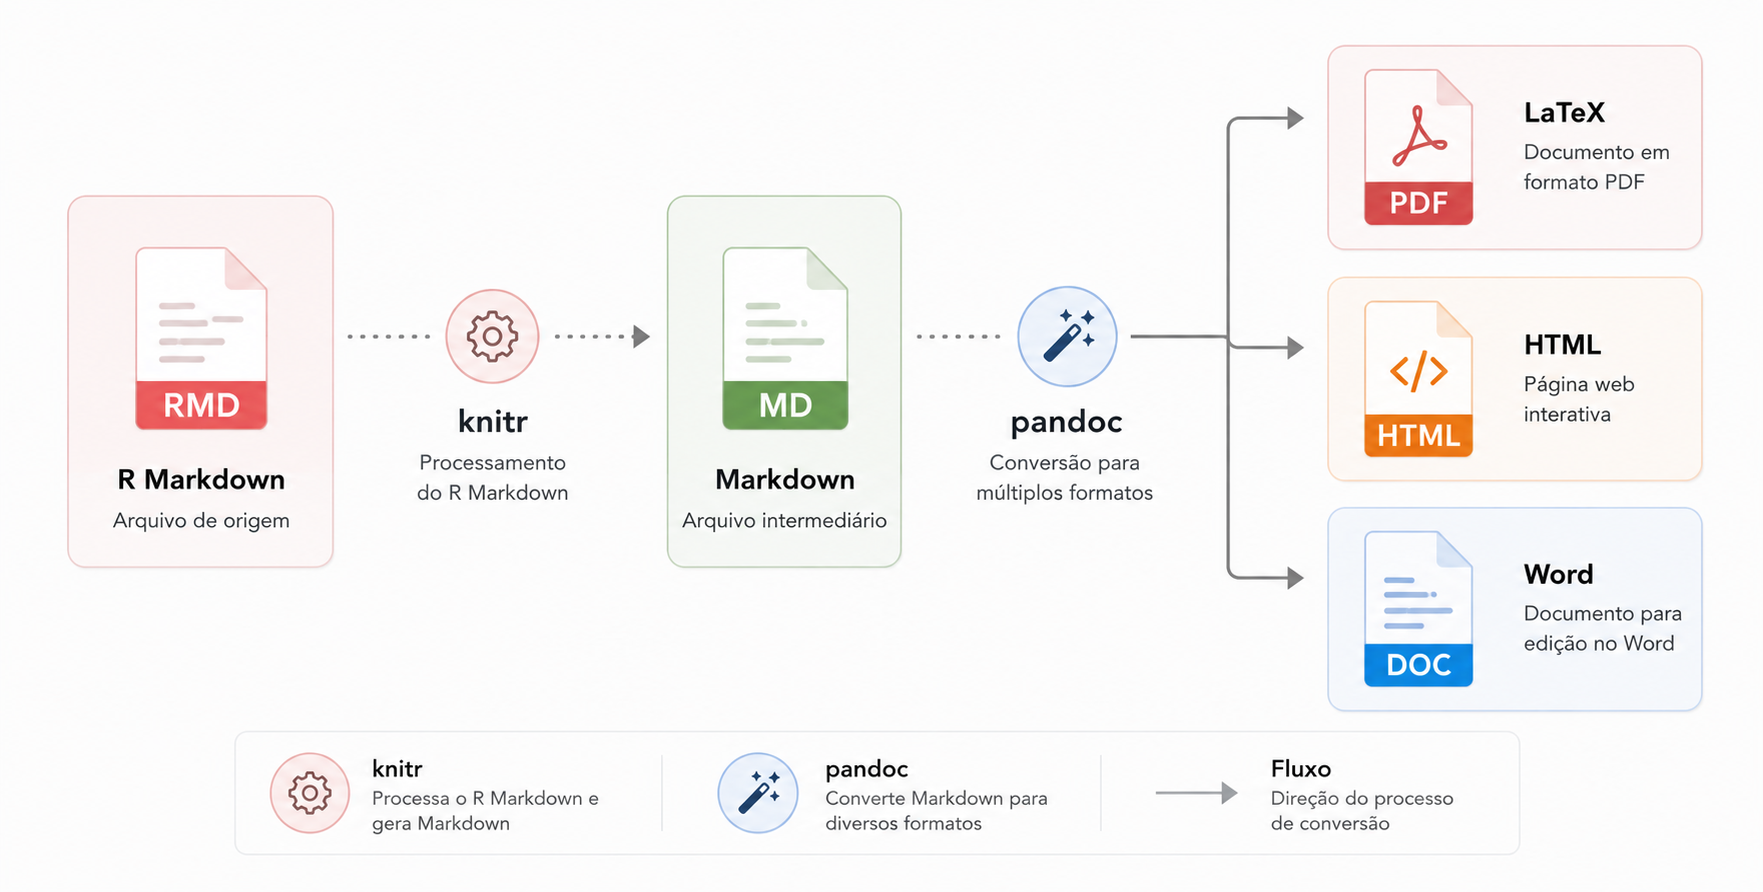
Tanto os arquivos .Rmd (RMarkdown) (Xie, Allaire, e Grolemund 2018) quanto os novos .qmd (Quarto, o sucessor moderno do RMarkdown que suporta nativamente múltiplas linguagens de programação, incluindo Python de forma mais amigável) são compostos por três blocos estruturais de código interligados em um único arquivo:
6.5.1 O Processo de Compilação
Compreender o que acontece quando clicamos em Knit (R Markdown) ou Render (Quarto) ajuda a diagnosticar erros. O processo tem duas grandes etapas:
- Execução do código. Um motor de computação (engine) percorre o documento, executa cada bloco de código em ordem, numa sessão nova e limpa, e substitui os blocos por seus resultados (texto, tabelas, caminhos de figuras), produzindo um arquivo Markdown intermediário (
.md). No R Markdown, o motor é sempre o knitr; no Quarto, pode ser o knitr (para R) ou o Jupyter (para Python, Julia e outras linguagens). - Conversão. O Pandoc converte o Markdown intermediário no formato final. Para PDF, há um passo adicional: o Pandoc gera um arquivo LaTeX, que é compilado por um motor como
pdflatexouxelatex.
Em símbolos: \[ \texttt{.qmd} \xrightarrow{\text{knitr ou Jupyter}} \texttt{.md} \xrightarrow{\text{Pandoc}} \{\texttt{.html}, \texttt{.docx}, \texttt{.tex} \xrightarrow{\text{LaTeX}} \texttt{.pdf}\}. \]
Uma consequência importante: a compilação ocorre em uma sessão limpa. Objetos que existem no seu ambiente interativo, mas que não foram criados por código do documento, não estão disponíveis. Isso é uma virtude, pois garante que o documento seja autocontido, mas é a causa mais comum do erro “objeto não encontrado” em iniciantes.
6.5.2 Cabeçalho YAML
Fica no topo do documento, delimitado por três traços (---). É usado para definir o título, autor, data e as configurações de saída do arquivo compilado.
YAML (acrônimo recursivo de YAML Ain’t Markup Language) é uma linguagem para representar dados estruturados de forma legível. Suas regras básicas são:
- pares chave: valor, com um espaço após os dois-pontos;
- hierarquia por indentação com espaços (nunca tabulações); o nível de indentação define a quem uma chave pertence;
- listas com hífens ou entre colchetes;
- textos com caracteres especiais (como
:ou#) devem ficar entre aspas; - valores lógicos são escritos como
true/false.
Um cabeçalho completo de um relatório em Quarto:
---
title: "Análise da Evasão no Curso de Estatística"
subtitle: "Relatório técnico"
author:
  - name: "Maria da Silva"
    affiliation: "UFPE"
  - name: "João Souza"
    affiliation: "UFPE"
date: today
lang: pt
abstract: |
  Este relatório analisa os fatores associados à evasão
  de estudantes entre 2015 e 2024.
format:
  html:
    toc: true
    toc-depth: 3
    number-sections: true
    code-fold: true
    theme: cosmo
    embed-resources: true
  pdf:
    documentclass: article
    papersize: a4
    geometry: margin=2.5cm
    fig-pos: "H"
  docx:
    reference-doc: modelo_ufpe.docx
execute:
  echo: false
  warning: false
  message: false
bibliography: referencias.bib
csl: abnt.csl
---
Observe a hierarquia: toc pertence a html, que pertence a format. A chave execute define opções globais para todos os blocos de código (que podem ser sobrescritas bloco a bloco), e a barra vertical em abstract: | indica um texto de várias linhas que preserva as quebras.
No R Markdown, a sintaxe equivalente usa output em vez de format e nomes de funções do pacote rmarkdown:
---
title: "Análise da Evasão"
output:
  html_document:
    toc: true
    toc_float: true
  pdf_document:
    number_sections: true
---A maioria dos erros de compilação em iniciantes vem do YAML: indentação inconsistente, uso de tabulação, falta de espaço após os dois-pontos ou títulos contendo dois-pontos sem aspas (por exemplo, title: Estudo: parte 1 é inválido; o correto é title: "Estudo: parte 1").
6.5.3 Blocos de Código (Chunks)
São os blocos onde a computação acontece. Eles iniciam com três crases seguidas pela linguagem entre chaves (ex: ```{r} ou ```{python}) e terminam com três crases.
Podemos controlar o comportamento de exibição desses blocos usando opções especiais inseridas no topo dos chunks:
echo: false(ouecho = FALSEno RMarkdown): Executa o código e mostra os resultados/gráficos, mas oculta as linhas de código no documento final compilado. Excelente para gerar relatórios para gerentes não técnicos.eval: false: Mostra o código de forma elegante na página, mas não o executa. Útil para documentação ou tutoriais.warning: falseemessage: false: Evita que mensagens de alerta internas do R poluam a leitura do seu relatório final.
No R Markdown, as opções são escritas dentro das chaves, separadas por vírgulas, com a sintaxe de argumentos do R. No Quarto, a forma recomendada são comentários especiais iniciados por #| no topo do bloco, com a sintaxe do YAML. Os dois blocos a seguir são equivalentes:
```{r grafico-dispersao, echo=FALSE, fig.cap="Peso versus consumo", fig.width=6}
plot(mtcars$wt, mtcars$mpg)
```

```{r}
#| label: fig-dispersao
#| echo: false
#| fig-cap: "Peso versus consumo"
#| fig-width: 6
plot(mtcars$wt, mtcars$mpg)
```
A forma do Quarto tem a vantagem de ser válida também para Python e de manter as opções legíveis quando são muitas. Note também a convenção de nomes: o R Markdown usa pontos (fig.cap), o Quarto usa hífens (fig-cap).
As opções mais importantes estão resumidas a seguir:
| Opção (Quarto) | Valores | Efeito |
|---|---|---|
label |
texto | Nome do bloco; com prefixo fig- ou tbl- permite referência cruzada |
echo |
true/false/fenced |
Exibe ou oculta o código-fonte |
eval |
true/false |
Executa ou não o código |
include |
true/false |
Se false, executa mas não mostra nada (nem código nem saída) |
output |
true/false/asis |
Controla a exibição dos resultados; asis insere a saída como Markdown bruto |
warning, message |
true/false |
Exibe avisos e mensagens |
error |
true/false |
Se true, a compilação continua mesmo que o bloco gere erro |
fig-cap |
texto | Legenda da figura |
fig-alt |
texto | Texto alternativo para leitores de tela (acessibilidade) |
fig-width, fig-height |
polegadas | Dimensões da figura gerada |
fig-align |
left/center/right |
Alinhamento da figura |
tbl-cap |
texto | Legenda da tabela |
cache |
true/false |
Reaproveita resultados se o código não mudou (útil para modelos demorados) |
code-fold |
true/false |
No HTML, recolhe o código em um botão “Código” |
As combinações mais usadas formam um pequeno “vocabulário” do relatório:
| Objetivo | echo |
eval |
include |
|---|---|---|---|
| Tutorial: mostrar código e resultado | true |
true |
true |
| Relatório gerencial: só o resultado | false |
true |
true |
| Mostrar código sem executar | true |
false |
true |
| Carregar pacotes e dados silenciosamente | — | true |
false |
Um bloco típico de configuração, no início do documento, carrega pacotes e dados sem poluir o relatório:
```{r}
#| label: setup
#| include: false
library(tidyverse)
library(knitr)
dados <- read_csv("dados/evasao.csv")
set.seed(2024)
```Com cache: true, o knitr guarda os resultados de um bloco e só o reexecuta se o código do bloco mudar. Isso acelera documentos com modelos demorados, mas pode gerar resultados desatualizados se o bloco depender de dados ou de outros blocos que mudaram. Na dúvida, apague a pasta de cache antes da versão final.
6.5.4 Opções de Chunk em Profundidade
Além das opções básicas, algumas outras resolvem problemas frequentes:
| Opção (Quarto) | Exemplo | Efeito |
|---|---|---|
fig-dpi |
300 |
Resolução das figuras em pontos por polegada (importante para impressão) |
out-width |
"70%" |
Largura com que a figura é exibida, independentemente do tamanho com que foi gerada |
layout-ncol |
2 |
Dispõe as várias figuras geradas por um bloco em colunas |
fig-subcap |
lista de textos | Legendas das subfiguras (referenciáveis como @fig-painel-1) |
code-summary |
"Mostrar código" |
Texto do botão quando code-fold: true |
code-line-numbers |
true |
Numera as linhas do código exibido |
echo |
fenced |
Exibe o bloco com a linha de abertura e as opções (útil em tutoriais, como este capítulo) |
results |
asis |
(knitr) Insere a saída como Markdown bruto, que será formatado |
dependson |
"setup" |
(knitr, com cache) Invalida o cache se o bloco indicado mudar |
child |
"secao.qmd" |
(knitr) Insere e executa outro documento no lugar do bloco |
O tamanho de uma figura tem duas dimensões distintas que convém não confundir: fig-width e fig-height (em polegadas) definem o “papel” em que o gráfico é desenhado, e portanto o tamanho relativo de textos e pontos; out-width define o tamanho com que a imagem pronta é exibida. Um gráfico desenhado com fig-width: 10 e exibido com out-width: "50%" terá letras muito pequenas. A resolução em pixels de um PNG é \(\text{fig-width} \times \text{fig-dpi}\); por exemplo, \(6 \times 300 = 1800\) pixels de largura.
Com layout-ncol e fig-subcap, um único bloco produz um painel de figuras com legenda geral e sublegendas:
```{r}
#| label: fig-painel
#| fig-cap: "Consumo dos automóveis."
#| fig-subcap:
#|   - "Histograma"
#|   - "Dispersão"
#| layout-ncol: 2
hist(mtcars$mpg)
plot(mtcars$wt, mtcars$mpg)
```

Veja a @fig-painel-1 e o painel completo na @fig-painel.
No documento final, @fig-painel-1 vira “Figura 1(a)” e @fig-painel, “Figura 1”.
A opção results: asis merece um exemplo, pois permite que o código escreva o próprio texto Markdown do documento:
```{r}
#| echo: false
#| results: asis
for (k in c(4, 6, 8)) {
  m <- mean(mtcars$mpg[mtcars$cyl == k])
  cat("- Carros com", k, "cilindros: consumo médio de",
      format(m, digits = 4, decimal.mark = ","), "mpg\n")
}
```
A saída, interpretada como Markdown, vira uma lista formatada com três itens. Isso é útil para gerar seções repetitivas (uma por região, uma por variável) a partir de um laço.
6.5.5 Cache e Freeze: a Teoria da Invalidação
Toda técnica de cache enfrenta o mesmo problema: decidir quando um resultado guardado ainda é válido. A estratégia do knitr é a do endereçamento por conteúdo, a mesma ideia do Git: para cada bloco com cache: true, calcula-se uma assinatura \[
k = h(\text{código do bloco},\ \text{opções do bloco}),
\] em que \(h\) é uma função hash (o knitr usa o MD5). Os objetos criados pelo bloco são salvos em disco com o nome derivado de \(k\). Na próxima renderização, se a assinatura for a mesma, os objetos são carregados em vez de recalculados; se o código ou as opções mudarem, a assinatura muda e o bloco é reexecutado.
O ponto fraco é que \(k\) só enxerga o texto do bloco. Se o bloco lê um arquivo de dados que foi atualizado, ou usa um objeto criado em um bloco anterior que mudou, a assinatura continua igual e o cache devolve um resultado desatualizado. Há duas soluções:
dependson: declara que o bloco depende de outros; se algum deles mudar, o cache é invalidado.cache.extra: acrescenta informações à assinatura. Por exemplo,cache.extra = tools::md5sum("dados/vendas.csv")faz com que o cache seja invalidado sempre que o conteúdo do arquivo de dados mudar.
```{r}
#| label: modelo-pesado
#| cache: true
#| cache.extra: !expr tools::md5sum("dados/vendas.csv")
modelo <- randomForest::randomForest(vendas ~ ., data = dados, ntree = 5000)
```
(A marcação !expr indica ao Quarto que o valor da opção é uma expressão do R a ser avaliada, e não um texto.)
Em projetos Quarto (livros e sites), há um mecanismo complementar e mais grosseiro, o congelamento (freeze), declarado no _quarto.yml:
execute:
  freeze: auto    # reexecuta um arquivo apenas se o seu código-fonte mudou
Com freeze: auto, o Quarto guarda os resultados de cada documento na pasta _freeze/, junto com o hash do arquivo-fonte, e só reexecuta o código de um documento quando o arquivo muda; com freeze: true, nunca reexecuta durante a renderização do projeto completo (apenas quando o arquivo é renderizado individualmente). A pasta _freeze/ deve ser versionada no Git: assim, um colaborador ou um servidor de integração contínua que não tenha os dados ou os pacotes pode renderizar o site usando os resultados congelados.
| Mecanismo | Granularidade | Chave de invalidação | Onde fica |
|---|---|---|---|
cache: true (knitr) |
Bloco | Hash do código e das opções do bloco (mais cache.extra) |
Pasta *_cache/ |
freeze: auto (Quarto) |
Documento | Hash do arquivo-fonte | Pasta _freeze/ |
Salvar com saveRDS() |
Manual | Decisão do analista | Arquivo .rds |
Um documento só é verdadeiramente reprodutível se puder ser renderizado do zero, com o cache vazio. Antes de entregar a versão final, apague as pastas de cache (ou use quarto render --cache-refresh) e renderize novamente.
6.5.6 Código Inline
Além dos blocos, é possível inserir resultados no meio de uma frase. No R Markdown, usa-se uma crase seguida da letra r, da expressão e de outra crase; no Quarto, a forma recomendada inclui a linguagem entre chaves, o que permite usar também Python:
A amostra contém `r nrow(dados)` estudantes, com idade média de
`r round(mean(dados$idade), 1)` anos.

A taxa de evasão estimada foi de `{python} f"{taxa:.1%}"`.
Esse recurso é o coração da reprodutibilidade em relatórios: se os dados forem atualizados, todos os números do texto se atualizam automaticamente. Nunca digite à mão um número que pode ser calculado.
Use funções de formatação para que os números apareçam com o padrão brasileiro: format(1234567.891, big.mark = ".", decimal.mark = ",", nsmall = 2) produz 1.234.567,89; o pacote scales oferece scales::percent(0.1234, accuracy = 0.1, decimal.mark = ","), que produz 12,3%.
6.5.7 Python no Quarto
No Quarto, documentos com blocos Python são executados pelo Jupyter. O cabeçalho pode especificar o motor e o kernel:
---
title: "Análise com Python"
jupyter: python3
---

```{python}
#| label: fig-histograma
#| fig-cap: "Distribuição das notas"
import pandas as pd
import matplotlib.pyplot as plt

notas = pd.read_csv("dados/notas.csv")
notas["nota"].hist(bins=20)
plt.xlabel("Nota final")
plt.show()
```
Um mesmo arquivo .ipynb também pode ser renderizado diretamente pelo Quarto (quarto render analise.ipynb), e um .qmd pode ser convertido em notebook (quarto convert analise.qmd).
6.5.8 RMarkdown versus Quarto
| Aspecto | R Markdown | Quarto |
|---|---|---|
| Natureza | Pacote do R | Programa independente (linha de comando) |
| Linguagens | Principalmente R (Python via reticulate) |
R, Python, Julia, Observable JS |
| Motores | knitr | knitr ou Jupyter |
| Opções de chunk | Dentro das chaves, sintaxe R (fig.cap) |
Comentários especiais no topo do bloco, sintaxe YAML (fig-cap) |
| Livros, sites, apresentações | Pacotes separados (bookdown, blogdown, xaringan) |
Integrados (type: book, website, revealjs) |
| Referências cruzadas | Via bookdown |
Nativas |
| Situação atual | Mantido, estável | Desenvolvimento ativo |
Para novos projetos, o Quarto é a escolha recomendada; documentos R Markdown existentes, em geral, podem ser renderizados pelo Quarto com mínimas alterações.
6.6 Formatos de Saída
Um dos maiores benefícios dos documentos dinâmicos é escrever uma única vez e publicar em vários formatos:
- HTML (
html): o formato mais versátil; permite interatividade (gráficosplotly, tabelas pesquisáveis, mapasleaflet), código recolhível e navegação lateral. Comembed-resources: true, gera um único arquivo autocontido, fácil de enviar por e-mail. - PDF (
pdf): gerado via LaTeX, com qualidade tipográfica superior, ideal para artigos, dissertações e documentos impressos. Requer uma distribuição LaTeX (o Quarto instala uma versão leve comquarto install tinytex). - Word (
docx): útil quando os colaboradores precisam editar o texto ou quando um periódico exige esse formato. O estilo é controlado por um documento de referência (reference-doc). - Apresentações:
revealjs(HTML),beamer(PDF) epptx(PowerPoint). Cada slide começa em um cabeçalho de nível 2. - Projetos: livros (
type: book), sites (type: website) e painéis (dashboards), compostos por vários arquivos e com navegação integrada.
A renderização pode ser feita pelo botão Render do RStudio ou pela linha de comando:
quarto render relatorio.qmd               # todos os formatos do YAML
quarto render relatorio.qmd --to pdf      # apenas PDF
quarto preview relatorio.qmd              # pré-visualização com atualização automática
No R, o pacote rmarkdown oferece a função equivalente para arquivos .Rmd:
rmarkdown::render("relatorio.Rmd", output_format = "html_document")6.7 Tabelas Geradas por Código
Tabelas digitadas à mão sofrem do mesmo problema dos números copiados: ficam desatualizadas. Em documentos dinâmicos, tabelas são funções dos dados. As três ferramentas mais usadas no R são:
knitr::kable(): simples e leve; gera tabelas em Markdown, HTML ou LaTeX conforme o formato de saída. O pacotekableExtraacrescenta estilos.gt: baseado em uma “gramática de tabelas”, em analogia à gramática de gráficos doggplot2: uma tabela é composta de partes (cabeçalho, rótulos de colunas, corpo, notas de rodapé, fonte) que são construídas e formatadas camada por camada.flextable: especialmente bom para saída em Word.
Exemplo resolvido. Queremos uma tabela do consumo médio por número de cilindros, com vírgula decimal e cabeçalhos em português:
resumo <- aggregate(mpg ~ cyl, data = mtcars, FUN = mean)
knitr::kable(
  resumo,
  digits = 2,
  col.names = c("Cilindros", "Consumo médio (mpg)"),
  format.args = list(decimal.mark = ",")
)
#> | Cilindros| Consumo médio (mpg)|
#> |---------:|-------------------:|
#> |         4|               26,66|
#> |         6|               19,74|
#> |         8|               15,10|
A saída é uma pipe table do Markdown, exatamente como as que escrevemos à mão, só que gerada a partir dos dados. Dentro de um bloco com label: tbl-... e tbl-cap, ela ganha legenda e número. A mesma tabela com o gt:
library(gt)
resumo |>
  gt() |>
  tab_header(title = "Consumo por número de cilindros") |>
  cols_label(cyl = "Cilindros", mpg = "Consumo médio (mpg)") |>
  fmt_number(columns = mpg, decimals = 2, dec_mark = ",", sep_mark = ".") |>
  tab_source_note("Fonte: conjunto de dados mtcars.")
No Python, um DataFrame do pandas pode ser convertido em Markdown com df.to_markdown() (que requer o pacote tabulate), e o pacote great_tables oferece uma interface semelhante à do gt.
Arredonde os números para a precisão que faz sentido (raramente mais de duas ou três casas decimais), alinhe números à direita, use unidades nos cabeçalhos, evite linhas verticais e coloque a fonte dos dados em nota. Uma tabela de coeficientes com dez casas decimais transmite uma falsa sensação de precisão.
6.8 Projetos Quarto: Livros, Sites e Apresentações
Um documento isolado é suficiente para um relatório. Para conjuntos de documentos (um livro com capítulos, um site com várias páginas, o material de uma disciplina), o Quarto oferece projetos: uma pasta com um arquivo de configuração _quarto.yml, cujas opções valem para todos os documentos. O comando quarto render, executado na raiz, renderiza o projeto inteiro.
6.8.1 Livros
Este livro é um projeto do tipo book. Um _quarto.yml mínimo é:
project:
  type: book
  output-dir: _book

book:
  title: "Introdução à Ciência de Dados"
  author: "Prof. Dr. Jodavid Ferreira"
  chapters:
    - index.qmd
    - part: "Parte I: Fundamentos"
      chapters:
        - 01_intro.qmd
        - 02_git.qmd
    - references.qmd

bibliography: references.bib

format:
  html:
    theme: cosmo
  pdf:
    documentclass: book
Cada arquivo listado em chapters é um capítulo; o primeiro cabeçalho de nível 1 de cada arquivo é o título do capítulo. A numeração de figuras, tabelas e equações passa a ser por capítulo (Figura 3.2 é a segunda figura do capítulo 3), e as referências cruzadas funcionam entre capítulos. A partir das mesmas fontes, o Quarto gera um site navegável e um único PDF.
6.8.2 Sites
Com type: website, cada arquivo .qmd vira uma página, e a seção website define a barra de navegação:
project:
  type: website

website:
  title: "Disciplina de Ciência de Dados"
  navbar:
    left:
      - href: index.qmd
        text: Início
      - href: aulas.qmd
        text: Aulas
      - href: listas.qmd
        text: Listas

execute:
  freeze: auto
Sites e livros são publicados facilmente no GitHub Pages com quarto publish gh-pages (veja o Capítulo de Controle de Versão com Git e GitHub).
6.8.3 Apresentações com Reveal.js
O formato revealjs produz apresentações em HTML. As regras são simples: cada cabeçalho de nível 2 inicia um novo slide; cabeçalhos de nível 1 criam slides de seção; e divs especiais controlam o comportamento:
---
title: "Regressão Linear"
author: "Maria da Silva"
format:
revealjs:
slide-number: true
incremental: false
---
## Motivação
::: {.incremental}
- Queremos explicar uma variável resposta $y$
- a partir de preditores $x_1, \ldots, x_p$
:::
::: {.notes}
Lembrar de perguntar à turma exemplos de aplicações.
:::
## Modelo e gráfico
:::: {.columns}
::: {.column width="50%"}
$$y_i = \beta_0 + \beta_1 x_i + \varepsilon_i$$
:::
::: {.column width="50%"}

:::
::::A div .incremental faz os itens aparecerem um a um; a div .notes contém notas do apresentador, visíveis apenas no modo de apresentação (tecla S); e as colunas dividem o slide. Blocos de código executáveis funcionam normalmente, de modo que os gráficos de uma aula sempre refletem o código mostrado. Para PDF, o formato equivalente é o beamer (LaTeX), e para PowerPoint, o pptx.
6.9 Referências Bibliográficas com BibTeX
Um trabalho acadêmico exige citações e lista de referências consistentes. Gerenciá-las manualmente é tedioso e propenso a erros; o Pandoc automatiza o processo a partir de um banco de referências no formato BibTeX (.bib), originalmente criado para o LaTeX.
6.9.1 Anatomia de uma entrada BibTeX
Cada referência é uma entrada com um tipo, uma chave de citação única e um conjunto de campos:
@article{peng2011,
  title   = {Reproducible Research in Computational Science},
  author  = {Peng, Roger D.},
  journal = {Science},
  volume  = {334},
  number  = {6060},
  pages   = {1226--1227},
  year    = {2011}
}

@book{xie2018,
  title     = {R Markdown: The Definitive Guide},
  author    = {Xie, Yihui and Allaire, J. J. and Grolemund, Garrett},
  year      = {2018},
  publisher = {CRC Press}
}
Os tipos mais comuns são @article, @book, @inproceedings (trabalhos em congressos), @phdthesis, @mastersthesis, @techreport e @misc. Autores múltiplos são separados pela palavra and, no formato Sobrenome, Nome. Gerenciadores de referências como Zotero (com a extensão Better BibTeX), Mendeley e JabRef exportam arquivos .bib, e o Google Acadêmico fornece entradas BibTeX prontas (que devem ser conferidas).
6.9.2 Sintaxe de citação
O arquivo .bib é declarado no YAML (bibliography: referencias.bib) e as citações são feitas no texto com @ seguido da chave:
| Sintaxe no texto | Resultado aproximado (estilo autor-data) |
|---|---|
[@peng2011] |
(Peng 2011) |
@peng2011 |
Peng (2011) |
[@peng2011; @xie2018] |
(Peng 2011; Xie, Allaire e Grolemund 2018) |
[@xie2018, p. 45] |
(Xie, Allaire e Grolemund 2018, 45) |
[-@peng2011] |
(2011) — suprime o nome do autor |
[veja @peng2011] |
(veja Peng 2011) |
Por exemplo, a frase “a reprodutibilidade deve ser vista como um espectro (Peng 2011)” é renderizada como: a reprodutibilidade deve ser vista como um espectro (Peng 2011). A lista de referências é gerada automaticamente ao final do documento, contendo apenas as obras efetivamente citadas.
O estilo da citação e da lista é definido por um arquivo CSL (Citation Style Language). Existem milhares de estilos prontos no repositório oficial do projeto CSL, inclusive versões da norma ABNT, que podem ser declarados com csl: abnt.csl no YAML.
6.9.3 Como o Processamento de Citações Funciona
O processamento de citações separa rigorosamente conteúdo de forma, em três componentes:
- Os dados (o arquivo
.bib): quem escreveu o quê, quando e onde. Nada sobre formatação. - As citações no texto (
[@chave]): onde cada obra é mencionada. Na AST do Pandoc, cada uma vira um nóCite. - O estilo (o arquivo
.csl): um documento XML que descreve, por meio de regras, como formatar a citação no texto e a entrada na lista final (ordem dos nomes, abreviações, pontuação, uso de itálico, ordenação da lista).
O processador citeproc, embutido no Pandoc (ativado pela opção --citeproc ou automaticamente pelo Quarto quando há bibliography no YAML), percorre a AST, substitui cada nó Cite pelo texto formatado e acrescenta a lista de referências ao fim do documento. Trocar de estilo não exige alterar uma única linha do texto: basta trocar o arquivo CSL.
Os estilos se dividem em três famílias principais:
| Família | Citação no texto | Exemplos de estilos |
|---|---|---|
| Autor-data | (Peng, 2011) | ABNT (autor-data), APA, Chicago autor-data |
| Numérica | [1] ou número sobrescrito | IEEE, Vancouver, Nature |
| Nota | Nota de rodapé com a referência | Chicago (notas), comum em Humanidades |
Algumas opções úteis do YAML relacionadas às citações:
bibliography: referencias.bib
csl: abnt.csl
link-citations: true     # cada citação vira um link para a entrada na lista
nocite: |
  @xie2020, @wilson2017  # inclui na lista obras não citadas no texto
Usando nocite: "@*", todas as obras do arquivo .bib entram na lista. Para controlar onde a lista de referências aparece, coloca-se uma div com o identificador refs no ponto desejado (::: {#refs} seguido de :::); sem ela, a lista vai para o final do documento.
6.10 Referências Cruzadas
Em documentos longos, referimo-nos a figuras, tabelas, equações e seções por número (“conforme a Figura 3”). Numerar à mão é inviável: basta inserir uma figura nova para que toda a numeração se desloque. O Quarto resolve isso com rótulos e referências:
- Atribua um rótulo com o prefixo adequado ao objeto:
fig-(figuras),tbl-(tabelas),eq-(equações),sec-(seções),thm-(teoremas), entre outros. - Refira-se ao objeto com
@rotulono texto.
## Metodologia {#sec-metodologia}

A relação entre peso e consumo aparece na @fig-consumo.

```{r}
#| label: fig-consumo
#| fig-cap: "Consumo de combustível em função do peso."
plot(mtcars$wt, mtcars$mpg)
```

```{r}
#| label: tbl-resumo
#| tbl-cap: "Médias por número de cilindros."
knitr::kable(aggregate(mpg ~ cyl, data = mtcars, FUN = mean))
```

A @tbl-resumo mostra as médias. O modelo da @eq-linear foi descrito na @sec-metodologia.

$$
y_i = \beta_0 + \beta_1 x_i + \varepsilon_i
$$ {#eq-linear}
No documento final, @fig-consumo é substituído por “Figura 1” (com link), @tbl-resumo por “Tabela 1” e assim por diante; a numeração é mantida automaticamente, inclusive por capítulo em livros. Para documentos em português, a declaração lang: pt no YAML traduz os prefixos (“Figura”, “Tabela”, “Equação”, “Seção”). Note que a sintaxe é a mesma das citações bibliográficas: o Quarto distingue as duas coisas pelo prefixo.
Além de figuras, tabelas e equações, o Quarto oferece ambientes matemáticos numerados e referenciáveis, muito úteis em notas de aula e dissertações. Eles são escritos como divs cujo identificador tem o prefixo do ambiente:
| Prefixo | Ambiente | Nome exibido (com lang: pt) |
|---|---|---|
thm- |
Teorema | Teorema |
lem- |
Lema | Lema |
cor- |
Corolário | Corolário |
prp- |
Proposição | Proposição |
def- |
Definição | Definição |
exm- |
Exemplo | Exemplo |
exr- |
Exercício | Exercício |
::: {#thm-tlc}
## Teorema Central do Limite

Sejam $X_1, \ldots, X_n$ variáveis aleatórias independentes e identicamente
distribuídas, com média $\mu$ e variância $0 < \sigma^2 < \infty$. Então
$$
\frac{\sqrt{n}\,(\bar{X}_n - \mu)}{\sigma} \xrightarrow{d} \mathcal{N}(0, 1).
$$
:::

::: {.proof}
Ver um livro de Probabilidade.
:::

Pelo @thm-tlc, a média amostral é aproximadamente normal para $n$ grande.
O cabeçalho ## dentro da div torna-se o nome do teorema (“Teorema 1 (Teorema Central do Limite)”), e a div .proof produz uma demonstração com o símbolo de fim de prova (sem numeração). A referência @thm-tlc é substituída por “Teorema 1”, com link.
Como a numeração automática funciona. O mecanismo é um exemplo de processamento em duas passagens sobre a AST: na primeira, o Quarto percorre o documento em ordem e atribui a cada objeto rotulado o próximo número disponível do seu tipo (um contador por prefixo e, em livros, também por capítulo), construindo uma tabela \(\text{rótulo} \mapsto \text{número}\); na segunda, substitui cada referência @rótulo pelo texto correspondente. A primeira passagem é necessária porque uma referência pode aparecer antes do objeto referenciado. O LaTeX resolve o mesmo problema de outra forma: grava os rótulos em um arquivo auxiliar (.aux) e exige que o documento seja compilado duas vezes, o que explica as mensagens do tipo “rerun to get cross-references right”.
6.11 Relatórios Parametrizados
Frequentemente precisamos gerar o mesmo relatório para diferentes recortes dos dados: um por estado, um por curso, um por mês. Copiar o arquivo e alterar manualmente o filtro seria uma regressão ao trabalho manual. A solução são os parâmetros: variáveis declaradas no YAML que podem ser alteradas no momento da renderização.
---
title: "Relatório de Desempenho"
params:
  curso: "Estatística"
  ano: 2024
---

```{r}
#| include: false
library(dplyr)
notas <- read.csv("dados/notas.csv") |>
  filter(curso == params$curso, ano == params$ano)
```

Este relatório apresenta o desempenho do curso de `r params$curso`
no ano de `r params$ano`, com `r nrow(notas)` estudantes avaliados.
No R, os parâmetros ficam disponíveis na lista params. Para gerar relatórios para vários cursos em um laço:
cursos <- c("Estatística", "Matemática", "Ciência da Computação")

for (c in cursos) {
  quarto::quarto_render(
    input = "relatorio.qmd",
    execute_params = list(curso = c, ano = 2024),
    output_file = paste0("relatorio_", gsub(" ", "_", c), ".html")
  )
}
Pela linha de comando, usa-se a opção -P:
quarto render relatorio.qmd -P curso:Matemática -P ano:2023Em documentos com Python, os parâmetros são definidos em um bloco com a etiqueta (tag) parameters, seguindo a convenção do pacote papermill. Os valores do bloco funcionam como padrões; na renderização com -P, o Quarto (por meio do papermill, que precisa estar instalado no ambiente Python) insere logo depois dele um novo bloco que redefine as variáveis com os valores passados:
```{python}
#| tags: [parameters]
curso = "Estatística"
ano = 2024
```

```{python}
import pandas as pd
notas = pd.read_csv("dados/notas.csv")
notas = notas[(notas["curso"] == curso) & (notas["ano"] == ano)]
```
quarto render relatorio_py.qmd -P curso:Matemática -P ano:2023Do ponto de vista conceitual, um relatório parametrizado é uma função: \(R: \Theta \to \mathcal{D}\), que leva cada valor do espaço de parâmetros \(\Theta\) (por exemplo, o conjunto de pares curso e ano) a um documento. Gerar a família completa de relatórios é avaliar \(R\) em cada ponto de \(\Theta\), o que é exatamente o que o laço anterior faz. Esse ponto de vista sugere duas boas práticas: validar os parâmetros no início do documento (por exemplo, com stopifnot(params$ano >= 2015)), como faríamos com os argumentos de uma função; e garantir que o documento não dependa de nada além dos parâmetros e dos dados, para que o mesmo \(\theta\) produza sempre o mesmo documento.
6.12 Um Exemplo Completo
O arquivo a seguir reúne os principais elementos discutidos: YAML, bloco de configuração, texto com código inline, figura e tabela com referência cruzada, equação e citação.
---
title: "Consumo de Combustível dos Automóveis"
author: "Maria da Silva"
date: today
lang: pt
format:
  html:
    toc: true
    code-fold: true
  pdf: default
execute:
  warning: false
  message: false
bibliography: referencias.bib
---

```{r}
#| label: setup
#| include: false
library(ggplot2)
modelo <- lm(mpg ~ wt, data = mtcars)
b1 <- coef(modelo)[["wt"]]
r2 <- summary(modelo)$r.squared
```

## Introdução

Analisamos `r nrow(mtcars)` modelos de automóveis do conjunto `mtcars`,
seguindo princípios de pesquisa reprodutível [@peng2011].

## Resultados

Ajustamos o modelo da @eq-modelo:

$$
\text{mpg}_i = \beta_0 + \beta_1\,\text{peso}_i + \varepsilon_i,
\qquad \varepsilon_i \sim \mathcal{N}(0, \sigma^2).
$$ {#eq-modelo}

Cada 1000 libras adicionais de peso reduzem o consumo em
`r round(abs(b1), 2)` milhas por galão, em média ($R^2 =$
`r round(r2, 3)`), como ilustra a @fig-dispersao.

```{r}
#| label: fig-dispersao
#| fig-cap: "Relação entre peso e consumo, com reta de mínimos quadrados."
#| fig-alt: "Gráfico de dispersão com tendência decrescente."
ggplot(mtcars, aes(wt, mpg)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE) +
  labs(x = "Peso (1000 libras)", y = "Milhas por galão")
```

```{r}
#| label: tbl-coef
#| tbl-cap: "Coeficientes estimados."
knitr::kable(summary(modelo)$coefficients, digits = 3)
```

## Referências
Ao renderizar esse arquivo, o leitor verá os números calculados (por exemplo, a redução de aproximadamente 5,34 milhas por galão e o \(R^2 \approx 0{,}753\) para os dados mtcars), a figura numerada, a tabela, a equação e a lista de referências formatada, sem nenhuma etapa manual.
6.13 Acessibilidade em Documentos Dinâmicos
Um relatório só cumpre seu papel se puder ser lido por todo o público, incluindo pessoas com deficiência visual que usam leitores de tela (programas que leem o conteúdo em voz alta ou em braile), pessoas com baixa visão ou com daltonismo. No Brasil, a Lei Brasileira de Inclusão (Lei n.º 13.146/2015) estabelece a acessibilidade de conteúdos digitais como direito. Documentos gerados por Quarto em HTML partem de uma boa base, pois o HTML é estruturado: o leitor de tela sabe o que é um título, uma lista ou uma tabela. Cabe ao autor não destruir essa estrutura e completá-la:
- Texto alternativo em todas as figuras (
fig-altem blocos de código,{fig-alt="..."}em imagens). O texto alternativo deve descrever a mensagem do gráfico, e não apenas o seu tipo: em vez de “gráfico de dispersão”, escreva “gráfico de dispersão mostrando que o consumo diminui à medida que o peso aumenta, de cerca de 30 para 10 milhas por galão”. - Hierarquia de títulos correta: não pule níveis (de
##direto para####) e não use títulos apenas para obter letras grandes; leitores de tela usam os títulos para navegar. - Idioma declarado (
lang: pt): permite que o leitor de tela use a pronúncia correta. - Cores com contraste suficiente e paletas seguras para daltonismo (por exemplo,
viridis), e nunca a cor como único canal de informação; combine cor com forma, rótulos ou padrões. - Tabelas de verdade, e não imagens de tabelas: uma tabela gerada por
kable()ougté legível por leitores de tela; uma captura de tela de uma planilha não é. - Links descritivos: “veja o relatório de 2024” em vez de “clique aqui”.
- Equações em LaTeX, e não como imagens: o MathJax, usado no HTML, oferece recursos de leitura de fórmulas para tecnologias assistivas.
6.14 Boas Práticas em Documentos Dinâmicos
- Um documento, uma sessão limpa: o documento deve rodar do início ao fim sem depender do ambiente interativo. Reinicie o R com frequência e renderize para testar.
- Caminhos relativos: use caminhos relativos à pasta do projeto (
dados/vendas.csv), nunca absolutos (C:/Users/maria/...). Pacotes comohereajudam. - Rótulos em todos os blocos: facilitam a navegação, a depuração (“erro no bloco
fig-renda”) e as referências cruzadas. - Sementes fixas para qualquer procedimento aleatório (amostragem, validação cruzada, florestas aleatórias).
- Registre o ambiente: inclua ao final do documento a saída de
sessionInfo()(R) ou as versões dos pacotes (Python), ou userenv/ambientes virtuais. - Separe cálculo pesado da apresentação: modelos que levam horas devem ser ajustados em scripts separados que salvam os resultados (
saveRDS()), lidos depois pelo documento; ou usecachee a opçãofreezedo Quarto em projetos. - Texto alternativo nas figuras (
fig-alt), para acessibilidade. - Versione o
.qmd, não o resultado: os arquivos gerados podem ser recriados a qualquer momento. - Renderize do zero antes de entregar: com o cache vazio e, idealmente, em outra máquina ou na integração contínua.
- Uma frase por linha no código-fonte: torna os diffs do Git mais precisos e as revisões mais fáceis.
6.15 Resumo do Capítulo
- Reprodutibilidade (mesmos dados e código, mesmos resultados) e replicabilidade (novos dados, mesma conclusão) são conceitos distintos; a reprodutibilidade é um espectro (Peng 2011) e é o padrão mínimo de uma análise confiável.
- Os documentos dinâmicos descendem da programação literária de Knuth, passando por Sweave, knitr, R Markdown e Quarto: texto, código e resultados convivem em um único arquivo-fonte.
- O Markdown é uma linguagem de marcação leve; o dialeto do Pandoc acrescenta tabelas, notas de rodapé, equações LaTeX, citações, divs e spans.
- O Pandoc converte documentos usando uma árvore sintática abstrata intermediária; na compilação, o motor (knitr ou Jupyter) executa o código e o Pandoc gera HTML, PDF, Word ou apresentações.
- O cabeçalho YAML configura metadados, formatos e opções globais; as opções de chunk (
echo,eval,include,warning,fig-cap,label,cache) controlam o que é executado e exibido; o código inline insere resultados calculados no texto. - BibTeX e CSL automatizam citações e referências; rótulos com prefixos (
fig-,tbl-,eq-,sec-) automatizam as referências cruzadas; parâmetros permitem gerar famílias de relatórios a partir de um único modelo. - O produto de uma análise é o compêndio (texto, código, dados e ambiente) (Buckheit e Donoho 1995; Gentleman e Temple Lang 2007). O ambiente computacional é uma pilha de camadas (pacotes, linguagem, sistema, hardware) registrada com
sessionInfo(), fixada comrenv/venvou encapsulada em contêineres Docker; resultados de ponto flutuante devem ser comparados com tolerância. - O CommonMark especificou formalmente o Markdown; dialetos diferem em casos ambíguos (como listas sem linha em branco antes), por isso convém escrever de forma inequívoca.
- A AST do Pandoc é uma árvore definida recursivamente por blocos e elementos em linha; filtros Lua transformam a árvore e valem para todos os formatos de saída.
- O cache do knitr usa endereçamento por conteúdo (hash do código e das opções), com invalidação controlada por
dependsonecache.extra; em projetos, o freeze guarda resultados por documento na pasta_freeze/. - Tabelas devem ser geradas por código (
kable,gt); projetos Quarto produzem livros, sites e apresentações revealjs; ambientes comothm-edef-são numerados e referenciáveis. - Acessibilidade (texto alternativo, hierarquia de títulos, contraste, idioma declarado) é parte da qualidade de um documento.
6.16 Exercícios Propostos
Diferencie reprodutibilidade de replicabilidade. Dê um exemplo de estudo reprodutível porém não replicável, e explique por que isso pode acontecer.
Classifique, segundo o espectro de Peng (2011), cada situação: (a) artigo com seção de métodos detalhada, sem código; (b) relatório em Quarto disponível no GitHub com os dados brutos; (c) artigo com link para os scripts, mas cujos dados são confidenciais.
Explique os papéis das operações tangle e weave na programação literária de Knuth e indique o que corresponde a cada uma no ecossistema R Markdown/Quarto (dica: pesquise a função
knitr::purl()).Escreva, em Markdown, uma tabela com as colunas Variável (alinhada à esquerda), Mínimo, Média e Máximo (alinhadas à direita), contendo três variáveis do conjunto
iris, com legenda e rótulo para referência cruzada.Escreva em LaTeX: (a) a função densidade da distribuição normal; (b) o estimador de máxima verossimilhança da média de uma Poisson, com a derivação da log-verossimilhança em um ambiente
aligned; (c) a definição de variância como \(\mathbb{E}[(X - \mu)^2]\).Identifique e corrija os erros no cabeçalho YAML abaixo:
title: Relatório: vendas
format:
html:
  toc: True
   number-sections: true
Para cada situação, indique os valores de
echo,evaleinclude: (a) bloco que carrega pacotes; (b) gráfico em um relatório para a diretoria; (c) exemplo de código que leva 3 horas para rodar em um tutorial; (d) exercício resolvido em uma apostila.Crie um documento Quarto que leia o conjunto
mtcars, ajuste uma regressão dempgemhpe escreva, usando apenas código inline, uma frase com o coeficiente estimado, o \(R^2\) e o número de observações. Altere os dados (por exemplo, removendo os carros com 8 cilindros) e verifique que o texto se atualiza.Crie um arquivo
.bibcom três referências (um livro, um artigo e um trabalho em congresso) e um documento que as cite usando as formas[@chave],@chavee[-@chave]. Renderize com e sem um arquivo CSL da ABNT e compare.Construa um documento com duas figuras, uma tabela e duas equações numeradas, todas citadas no texto por referência cruzada. Em seguida, insira uma nova figura no início e verifique o que acontece com a numeração.
Transforme o relatório do exercício 8 em um relatório parametrizado pelo número de cilindros e gere, com um laço em R, um arquivo HTML para cada valor de
cyl.Use o Pandoc na linha de comando para converter um mesmo arquivo
.mdem HTML, Word e PDF. Em seguida, usepandoc -t nativeem um parágrafo com ênfase e um link e descreva a estrutura da AST obtida.Compare R Markdown e Quarto em pelo menos cinco aspectos e argumente qual você escolheria para (a) um pacote R legado e (b) um novo projeto em Python.
Explique a frase de Buckheit e Donoho (1995) segundo a qual o artigo é “apenas a propaganda” da produção acadêmica. Organize um trabalho seu de outra disciplina na estrutura de compêndio de pesquisa apresentada no capítulo.
Para cada camada do ambiente computacional (pacotes, linguagem, sistema operacional, hardware), descreva um exemplo de como ela poderia alterar o resultado de uma análise e uma ferramenta para controlá-la.
Execute
set.seed(123); sample(100, 5)no R com o algoritmo atual e comRNGkind(sample.kind = "Rounding"). Explique o que isso implica para a reprodução de análises antigas e como você documentaria esse cuidado em um relatório.Mostre, com um exemplo numérico em R ou Python, que a soma em ponto flutuante não é associativa. Por que, então, testes de reprodutibilidade devem usar
all.equal()ounumpy.isclose()?Escreva um
Dockerfileque parta derocker/r-ver, restaure os pacotes de umrenv.locke renderize um relatório. Que camadas do ambiente ficam fixadas por ele?Converta o mesmo arquivo Markdown com
pandoc -f markdown,pandoc -f commonmarkepandoc -f gfm, criando ao menos dois casos em que os resultados diferem. Reescreva o arquivo de modo que os três dialetos concordem.Escreva um filtro Lua que transforme todo texto em negrito (
Strong) em texto em versalete (SmallCaps) e outro que conte o número de figuras do documento. Teste-os compandoc --lua-filter.Descreva, usando o conceito de função hash, quando o cache do knitr fornece um resultado desatualizado. Mostre como
cache.extraedependsonresolvem o problema em um exemplo concreto.Crie um pequeno site Quarto com três páginas (início, análise e referências), com
freeze: auto, e publique-o no GitHub Pages. Verifique o conteúdo da pasta_freeze/e explique por que ela deve ser versionada.Prepare uma apresentação
revealjsde cinco slides sobre um conjunto de dados, com uma lista incremental, notas do apresentador, um slide em duas colunas e um gráfico gerado por código.Escreva um documento com uma definição (
def-), um teorema (thm-) com demonstração e um exemplo (exm-) sobre a Lei dos Grandes Números, referenciando-os no texto.Avalie a acessibilidade de um relatório que você produziu: os gráficos têm texto alternativo que descreve a mensagem? A hierarquia de títulos está correta? As cores são distinguíveis por daltônicos? Proponha melhorias.
6.17 Leituras Recomendadas
- Xie, Allaire, e Grolemund (2018) — R Markdown: The Definitive Guide: referência completa do ecossistema R Markdown, disponível gratuitamente online.
- Xie, Dervieux, e Riederer (2020) — R Markdown Cookbook: coleção de receitas práticas para problemas específicos (tabelas, figuras, formatação, LaTeX).
- Xie (2015) — Dynamic Documents with R and knitr: o livro do criador do knitr, com a fundamentação dos documentos dinâmicos.
- Knuth (1984) — o artigo seminal sobre programação literária.
- Peng (2011) — artigo curto e influente que propõe o espectro de reprodutibilidade.
- National Academies of Sciences, Engineering, and Medicine (2019) — relatório abrangente sobre reprodutibilidade e replicabilidade na ciência, com definições e recomendações.
- Sandve et al. (2013) e Wilson et al. (2017) — regras práticas para pesquisa computacional reprodutível.
- Buckheit e Donoho (1995) e Donoho (2010) — textos fundadores do movimento pela pesquisa reprodutível em Estatística.
- Gentleman e Temple Lang (2007) e Marwick, Boettiger, e Mullen (2018) — o conceito de compêndio de pesquisa e sua implementação prática com as convenções de pacotes R.
- Boettiger (2015) — introdução ao Docker voltada à pesquisa reprodutível.
- Baker (2016) — a pesquisa da revista Nature sobre a crise de reprodutibilidade.
- Wilkinson et al. (2016) — os princípios FAIR para gestão de dados científicos.
- Herndon, Ash, e Pollin (2014) — a reanálise do estudo de Reinhart e Rogoff (2010), um estudo de caso sobre reprodutibilidade e erros em planilhas.
- Leisch (2002) — o artigo de apresentação do Sweave, precursor direto do knitr.
- Lamport (1994) — o manual do LaTeX escrito pelo seu criador.
- A especificação CommonMark (https://spec.commonmark.org) e a documentação de filtros Lua do Pandoc (https://pandoc.org/lua-filters.html).
- A documentação oficial do Quarto (https://quarto.org) e o manual do Pandoc (https://pandoc.org/MANUAL.html) são as referências definitivas para a sintaxe apresentada neste capítulo.
Assim como esta nota, que foi escrita diretamente em linha.↩︎