10 Aprendizado de Máquina e o Processo de Modelagem
Entenda o processo de aprendizado estatístico, a diferença entre tarefas supervisionadas e não supervisionadas, e como avaliar os modelos utilizando conceitos de generalização. Este capítulo é a base teórica de toda a Parte III do livro: aqui formalizamos o problema de aprendizado supervisionado (funções de perda, risco esperado e risco empírico), relacionamos as perdas à máxima verossimilhança, apresentamos os elementos da teoria do aprendizado estatístico (limites de generalização, aprendizado PAC, dimensão VC e o teorema “não há almoço grátis”), discutimos a otimização por gradiente descendente, derivamos a decomposição viés-variância, estudamos os procedimentos de validação (divisão treino/validação/teste, validação cruzada simples e aninhada, bootstrap) e as armadilhas mais comuns (como o vazamento de dados), e detalhamos as métricas de avaliação de classificadores, a calibração de probabilidades e a comparação estatística entre modelos. Os algoritmos específicos — árvores de decisão, florestas aleatórias, k-NN e SVM — são estudados nos capítulos seguintes.
10.1 O que é Aprendizado de Máquina?
O Aprendizado de Máquina (ou Machine Learning) é um subcampo da Inteligência Artificial (IA) focado no desenvolvimento e análise de algoritmos capazes de aprender e melhorar seu desempenho a partir da exposição a dados históricos. É importante notar que, a partir do final dos anos 1990, o campo de Machine Learning (fortemente enraizado na Computação) cruzou-se de forma profunda com a Estatística, tornando-se uma disciplina amplamente interdisciplinar. Não por acaso, muitos autores preferem a expressão aprendizado estatístico (statistical learning) (Hastie, Tibshirani, e Friedman 2009; James et al. 2013).
Em termos de formulação matemática geral, assumimos que existe uma função desconhecida \(f\) que representa a solução ideal para descrever um fenômeno. Os algoritmos de Machine Learning buscam encontrar uma função aproximada \(g\), baseada nos dados disponíveis, tal que \(g \approx f\).
Duas definições clássicas guiam este campo:
- Arthur Samuel (1959): “O campo de estudo que dá aos computadores a habilidade de aprender sem serem explicitamente programados.” Samuel foi pioneiro ao programar um computador para jogar damas, fazendo a máquina aprender jogando milhares de partidas contra si mesma (Samuel 1959).
- Tom Mitchell (1997): Mitchell propôs uma definição matemática precisa: “Diz-se que um programa de computador aprende a partir da experiência \(E\), com respeito a alguma classe de tarefas \(T\) e medida de desempenho \(P\), se o seu desempenho em tarefas em \(T\), medido por \(P\), melhora com a experiência \(E\).” (Mitchell 1997)
A definição de Mitchell é útil porque nos obriga a especificar três elementos em qualquer problema. Para um filtro de spam, por exemplo:
- Tarefa \(T\): classificar cada e-mail recebido como spam ou não spam;
- Experiência \(E\): um histórico de e-mails rotulados pelos usuários;
- Desempenho \(P\): a proporção de e-mails corretamente classificados (ou, melhor, a revocação e a precisão na classe spam, como veremos adiante).
Se o filtro classifica melhor à medida que recebe mais e-mails rotulados, ele “aprende” no sentido de Mitchell.
10.2 A Divisão Clássica do Aprendizado de Máquina
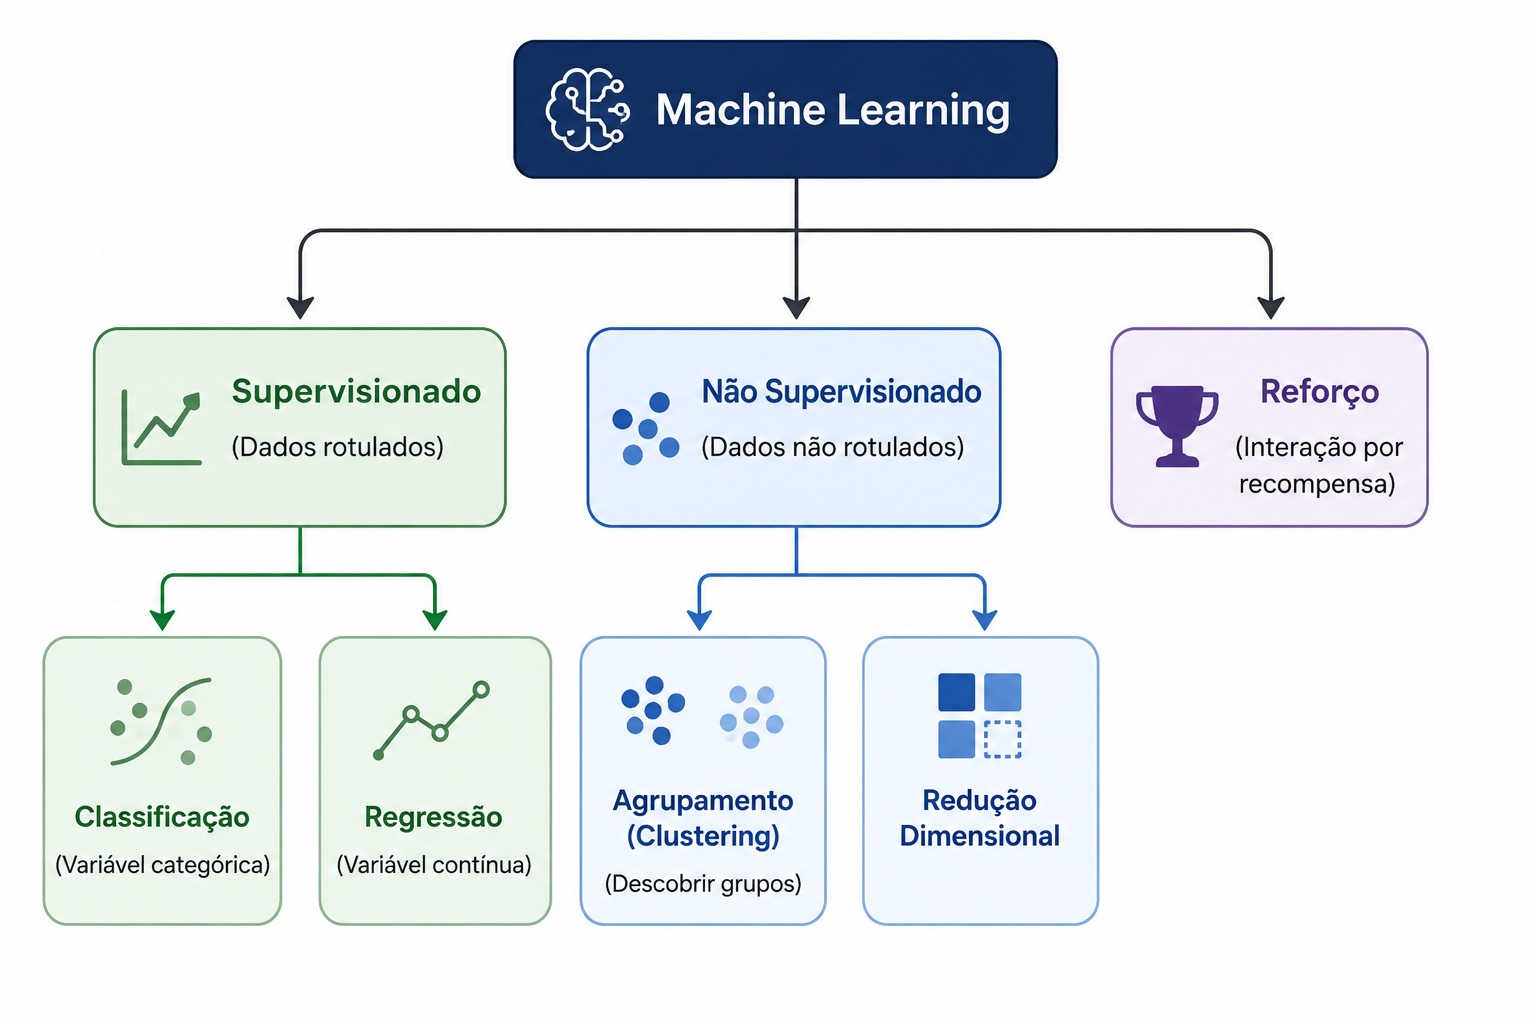
Os problemas de aprendizado de máquina são comumente classificados em três grandes categorias de acordo com o sinal de supervisão fornecido ao algoritmo durante o treinamento:
10.2.1 1. Aprendizado Supervisionado (Supervised Learning)
O algoritmo é alimentado com um conjunto de treinamento onde cada registro possui uma resposta correta rotulada associada (um “alvo” ou target \(y\)). O objetivo é mapear a função matemática que relaciona os dados de entrada \(X\) ao rótulo \(y\). Divide-se em:
- Classificação: A variável de resposta \(y\) é categórica ou discreta (ex: aprovar ou reprovar crédito, identificar se um e-mail é spam ou não).
- Regressão: A variável de resposta \(y\) é contínua ou numérica (ex: prever o preço de venda de uma casa, estimar o faturamento diário).
As variáveis de entrada recebem diversos nomes na literatura: preditores, variáveis explicativas, atributos (features) ou covariáveis; a variável de saída é chamada de resposta, alvo ou rótulo (label).
10.2.2 2. Aprendizado Não Supervisionado (Unsupervised Learning)
O algoritmo recebe dados brutos sem qualquer rótulo ou resposta correta (\(y\) não existe). O objetivo é encontrar padrões internos, estruturas intrínsecas ou agrupamentos naturais escondidos nos próprios dados. O principal exemplo é a tarefa de Agrupamento (ou Clustering), estudada no Capítulo do k-means. Outras tarefas não supervisionadas incluem a redução de dimensionalidade (como a análise de componentes principais) e a detecção de anomalias.
10.2.3 3. Aprendizado por Reforço (Reinforcement Learning)
O algoritmo (agente) interage com um ambiente dinâmico e aprende a tomar decisões sequenciais através de tentativa e erro, buscando maximizar uma recompensa acumulada ou minimizar uma punição. Muito utilizado em robótica e programação de jogos complexos (como o AlphaGo).
Entre o supervisionado e o não supervisionado existem ainda o aprendizado semissupervisionado (poucos exemplos rotulados e muitos não rotulados) e o aprendizado autossupervisionado (self-supervised), no qual os próprios dados geram os rótulos — por exemplo, prever a próxima palavra de um texto, estratégia usada no pré-treinamento dos grandes modelos de linguagem.
10.3 Formalização do Aprendizado Supervisionado
10.3.1 O Modelo Geral
Seja \(X = (X_1, \dots, X_p) \in \mathcal{X}\) o vetor de \(p\) preditores e \(Y \in \mathcal{Y}\) a resposta, com \((X, Y)\) seguindo uma distribuição conjunta \(P_{X,Y}\) desconhecida. Na regressão, é usual escrever
\[ Y = f(X) + \varepsilon, \qquad \mathbb{E}[\varepsilon \mid X] = 0, \qquad \operatorname{Var}(\varepsilon \mid X) = \sigma^2, \]
em que \(f\) é a parte sistemática da relação e \(\varepsilon\) é um erro aleatório que representa tudo o que \(X\) não explica: variáveis não medidas, erros de medição e variabilidade intrínseca do fenômeno.
Dispomos de uma amostra de treinamento \(\mathcal{D} = \{(x_1, y_1), \dots, (x_n, y_n)\}\), supostamente formada por observações independentes e identicamente distribuídas (i.i.d.) de \(P_{X,Y}\). Um algoritmo de aprendizado é um procedimento que recebe \(\mathcal{D}\) e devolve uma função \(\hat{f}: \mathcal{X} \to \mathcal{Y}\) (o \(g\) da seção anterior), escolhida dentro de uma classe de hipóteses \(\mathcal{H}\) (por exemplo, todas as funções lineares, ou todas as árvores de decisão com até 5 níveis).
10.3.2 Funções de Perda
Para medir a qualidade de uma previsão, definimos uma função de perda \(L(y, \hat{y}) \ge 0\), que quantifica o custo de prever \(\hat{y}\) quando o valor verdadeiro é \(y\):
| Perda | Fórmula | Uso típico |
|---|---|---|
| Quadrática | \(L(y, \hat{y}) = (y - \hat{y})^2\) | Regressão (penaliza muito erros grandes) |
| Absoluta | \(L(y, \hat{y}) = \lvert y - \hat{y} \rvert\) | Regressão robusta |
| 0-1 | \(L(y, \hat{y}) = \mathbf{1}(y \neq \hat{y})\) | Classificação (conta erros) |
| Logarítmica (entropia cruzada) | \(L(y, \hat{p}) = -[y \log \hat{p} + (1-y)\log(1 - \hat{p})]\) | Classificação probabilística, \(y \in \{0,1\}\) |
10.3.3 Funções de Perda e Verossimilhança
As funções de perda não são escolhas arbitrárias: as mais usadas correspondem a modelos probabilísticos para o erro, e minimizar o risco empírico equivale, nesses casos, a maximizar uma verossimilhança. Essa ligação é importante para o estatístico, pois mostra que boa parte do aprendizado de máquina clássico é estimação por máxima verossimilhança com outro nome.
Perda quadrática e erros gaussianos. Suponha \(y_i = f(x_i) + \varepsilon_i\), com \(\varepsilon_i \sim N(0, \sigma^2)\) independentes. A log-verossimilhança de \(f\) é \[ \ell(f) = \sum_{i=1}^n \log\left[\frac{1}{\sqrt{2\pi\sigma^2}}\exp\left(-\frac{(y_i - f(x_i))^2}{2\sigma^2}\right)\right] = -\frac{n}{2}\log(2\pi\sigma^2) - \frac{1}{2\sigma^2}\sum_{i=1}^n \big(y_i - f(x_i)\big)^2. \] Como o primeiro termo não depende de \(f\), maximizar \(\ell(f)\) equivale a minimizar a soma dos quadrados dos resíduos, isto é, o risco empírico sob perda quadrática.
Perda absoluta e erros de Laplace. Se os erros seguem a distribuição de Laplace (exponencial dupla), com densidade \(\frac{1}{2b}\exp(-\lvert \varepsilon \rvert / b)\), a log-verossimilhança é \(-n\log(2b) - \frac{1}{b}\sum_i \lvert y_i - f(x_i) \rvert\), e maximizá-la equivale a minimizar a soma dos erros absolutos. Como a distribuição de Laplace tem caudas mais pesadas que a normal, a perda absoluta é menos sensível a valores extremos — daí o seu uso em regressão robusta.
Perda logarítmica e o modelo de Bernoulli. Em classificação binária, se \(Y \mid X = x \sim \text{Bernoulli}(p(x))\), a verossimilhança é \(\prod_i p(x_i)^{y_i}[1 - p(x_i)]^{1 - y_i}\) e \[ -\ell(p) = -\sum_{i=1}^n \Big[y_i \log p(x_i) + (1 - y_i)\log\big(1 - p(x_i)\big)\Big], \] que é exatamente a soma das perdas logarítmicas. A regressão logística é o caso em que \(p(x) = 1/(1 + e^{-\mathbf{x}^\top\boldsymbol{\beta}})\).
A perda logarítmica pune severamente a confiança equivocada: se \(y = 1\) e o modelo previu \(\hat{p} = 0{,}9\), a perda é \(-\ln 0{,}9 \approx 0{,}105\); se previu \(\hat{p} = 0{,}1\), a perda é \(-\ln 0{,}1 \approx 2{,}303\), quase 22 vezes maior; e se previu \(\hat{p} = 0\), a perda é infinita.
Regras de pontuação próprias. Uma função de perda para probabilidades é própria (proper scoring rule) se o seu valor esperado é minimizado quando a probabilidade prevista é igual à verdadeira (Gneiting e Raftery 2007). Para a perda logarítmica, se \(Y \sim \text{Bernoulli}(q)\) e prevemos \(p\), \[ \mathbb{E}[L] = -q\log p - (1 - q)\log(1 - p), \qquad \frac{d\,\mathbb{E}[L]}{dp} = -\frac{q}{p} + \frac{1-q}{1-p} = 0 \iff p = q. \] Para o escore de Brier, \(L = (p - Y)^2\), tem-se \(\mathbb{E}[(p - Y)^2] = (p - q)^2 + q(1 - q)\), também minimizado em \(p = q\). Regras próprias incentivam o modelo a reportar probabilidades honestas; a perda 0-1, por outro lado, só se importa com o lado do limiar em que a probabilidade cai.
10.3.4 Risco Esperado e a Função Ótima
O risco esperado (ou erro de generalização) de uma função \(g\) é a perda média sobre toda a população:
\[ R(g) = \mathbb{E}_{X,Y}\big[L(Y, g(X))\big]. \]
A melhor função possível é aquela que minimiza \(R\). Para a perda quadrática, condicionando em \(X = x\) e escrevendo \(\mu(x) = \mathbb{E}[Y \mid X = x]\):
\[ \mathbb{E}\big[(Y - c)^2 \mid X = x\big] = \operatorname{Var}(Y \mid X = x) + \big(\mu(x) - c\big)^2, \]
que é minimizado em \(c = \mu(x)\). Logo, a função de regressão \(f^*(x) = \mathbb{E}[Y \mid X = x]\) é a previsão ótima sob perda quadrática, e o menor risco atingível é \(\mathbb{E}[\operatorname{Var}(Y \mid X)] = \sigma^2\) no modelo acima.
Para a perda 0-1 em classificação com classes \(k = 1, \dots, K\), o risco condicional de prever a classe \(c\) é \(P(Y \neq c \mid X = x) = 1 - P(Y = c \mid X = x)\), minimizado por
\[ f^*(x) = \arg\max_{k} \; P(Y = k \mid X = x), \]
o classificador de Bayes. Seu risco, o erro de Bayes, é o menor erro de classificação possível — um limite inferior que nenhum algoritmo consegue superar.
Pelo teorema de Bayes, \(P(Y = k \mid X = x) \propto \pi_k\, p_k(x)\), em que \(\pi_k = P(Y = k)\) é a probabilidade a priori da classe e \(p_k\) é a densidade de \(X\) na classe \(k\). O erro de Bayes pode ser escrito como \[ R^* = \mathbb{E}_X\Big[1 - \max_k P(Y = k \mid X)\Big]. \] Ele é zero apenas quando as classes não se sobrepõem no espaço dos preditores; quando há sobreposição, nenhum classificador, por mais sofisticado, consegue errar menos que \(R^*\).
Suponha que, na classe 0, \(X \sim N(0, 1)\) e, na classe 1, \(X \sim N(2, 1)\), com probabilidades a priori \(\pi_0\) e \(\pi_1\). O classificador de Bayes decide pela classe 1 quando \(\pi_1\,\phi(x - 2) > \pi_0\,\phi(x)\), em que \(\phi\) é a densidade normal padrão. Tomando logaritmos, \[ \log \pi_1 - \frac{(x-2)^2}{2} > \log \pi_0 - \frac{x^2}{2} \iff 2x - 2 > \log\frac{\pi_0}{\pi_1} \iff x > t = 1 + \frac{1}{2}\log\frac{\pi_0}{\pi_1}. \]
Classes equiprováveis (\(\pi_0 = \pi_1 = 0{,}5\)): o limiar é \(t = 1\), o ponto médio entre as médias. O erro de Bayes é \[ R^* = 0{,}5\,P(X > 1 \mid Y = 0) + 0{,}5\,P(X < 1 \mid Y = 1) = 0{,}5\,[1 - \Phi(1)] + 0{,}5\,\Phi(-1) = \Phi(-1) \approx 0{,}1587. \]
Classes desbalanceadas (\(\pi_0 = 0{,}7\), \(\pi_1 = 0{,}3\)): \(t = 1 + \tfrac{1}{2}\ln(0{,}7/0{,}3) \approx 1 + 0{,}4236 = 1{,}4236\). O limiar se desloca em direção à classe minoritária, e \[ R^* = 0{,}7\,[1 - \Phi(1{,}4236)] + 0{,}3\,\Phi(1{,}4236 - 2) \approx 0{,}7 \times 0{,}0773 + 0{,}3 \times 0{,}2822 \approx 0{,}1387. \] Nenhum classificador baseado apenas em \(X\) pode ter erro menor que cerca de 16% (primeiro caso) ou 14% (segundo caso). Na prática, as densidades são desconhecidas, e os algoritmos de classificação podem ser vistos como diferentes maneiras de aproximar o classificador de Bayes.
10.3.5 Risco Empírico e sua Minimização
O problema é que \(P_{X,Y}\) é desconhecida, e portanto \(R(g)\) não pode ser calculado. A ideia natural é substituí-lo pela média amostral da perda, o risco empírico:
\[ \hat{R}_n(g) = \frac{1}{n}\sum_{i=1}^n L\big(y_i, g(x_i)\big), \]
e escolher
\[ \hat{f} = \arg\min_{g \in \mathcal{H}} \hat{R}_n(g). \]
Esse é o princípio da Minimização do Risco Empírico (Empirical Risk Minimization, ERM), formalizado por Vapnik (Vapnik 1995). A regressão linear por mínimos quadrados é um caso particular: \(\mathcal{H}\) é a classe das funções lineares e \(L\) é a perda quadrática.
Pela Lei dos Grandes Números, para uma \(g\) fixa, \(\hat{R}_n(g) \to R(g)\) quando \(n \to \infty\). Porém, \(\hat{f}\) não é fixa: ela foi escolhida justamente por ter \(\hat{R}_n\) pequeno nos dados de treino. Se a classe \(\mathcal{H}\) for muito rica, sempre existirá uma função que “decora” os dados — por exemplo, uma função que vale \(y_i\) em cada \(x_i\) e zero no resto tem risco empírico nulo e péssimo risco esperado. Por isso,
\[ \hat{R}_n(\hat{f}) \quad \text{é, em geral, uma estimativa otimista de} \quad R(\hat{f}). \]
Essa diferença entre o erro de treino e o erro de generalização é o cerne do sobreajuste, e a teoria do aprendizado estatístico estuda condições sobre \(\mathcal{H}\) (sua “capacidade” ou “complexidade”) sob as quais a ERM generaliza bem (Vapnik 1995).
10.3.6 Erro Redutível e Erro Irredutível
Dada uma estimativa \(\hat{f}\) e considerando-a fixa, o erro quadrático esperado de previsão em um ponto \(X = x\) se decompõe como (James et al. 2013):
\[ \mathbb{E}\big[(Y - \hat{f}(x))^2 \mid X = x\big] = \underbrace{\big[f(x) - \hat{f}(x)\big]^2}_{\text{redutível}} + \underbrace{\operatorname{Var}(\varepsilon)}_{\text{irredutível}}. \]
O erro redutível pode ser diminuído com melhores modelos e mais dados; o irredutível é um limite fundamental — mesmo conhecendo \(f\) perfeitamente, não prevemos \(\varepsilon\).
10.4 Elementos de Teoria do Aprendizado Estatístico
Vimos que o risco empírico \(\hat{R}_n(\hat{f})\) é otimista. Mas quão otimista? E sob que condições podemos garantir que um modelo com erro de treino pequeno terá também erro de generalização pequeno? Essas são as perguntas centrais da teoria do aprendizado estatístico, desenvolvida a partir dos anos 1960 por Vapnik e Chervonenkis (Vapnik e Chervonenkis 1971; Vapnik 1995) e, na Ciência da Computação, a partir do modelo PAC de Valiant (1984). Nesta seção apresentamos os resultados básicos para a perda 0-1 (classificação), seguindo a exposição de Shalev-Shwartz e Ben-David (2014).
10.4.1 Uma única hipótese: a desigualdade de Hoeffding
Fixe um classificador \(g\) antes de ver os dados. As perdas \(Z_i = \mathbf{1}(y_i \neq g(x_i))\) são variáveis de Bernoulli i.i.d. com média \(R(g)\), e \(\hat{R}_n(g) = \bar{Z}\). A desigualdade de Hoeffding (Hoeffding 1963) afirma que, para variáveis independentes limitadas em \([0, 1]\) e qualquer \(\varepsilon > 0\), \[ P\Big(\big\lvert \hat{R}_n(g) - R(g) \big\rvert > \varepsilon\Big) \le 2\,e^{-2n\varepsilon^2}. \] A probabilidade de o erro de treino se afastar do erro verdadeiro em mais de \(\varepsilon\) decai exponencialmente com \(n\). Igualando o lado direito a um nível \(\delta\) e isolando \(\varepsilon\), obtemos: com probabilidade pelo menos \(1 - \delta\), \[ R(g) \le \hat{R}_n(g) + \sqrt{\frac{\ln(2/\delta)}{2n}}. \] Com \(n = 1.000\) e \(\delta = 0{,}05\), a margem é \(\sqrt{\ln 40/2000} = \sqrt{3{,}689/2000} \approx 0{,}043\). Esse é exatamente o raciocínio que justifica o conjunto de teste: como o modelo final é fixado antes de olharmos o teste, o erro de teste está, com alta probabilidade, a poucos pontos percentuais do erro verdadeiro.
10.4.2 Classes finitas: a cota da união
O problema é que o classificador \(\hat{f}\) escolhido pela ERM depende dos dados. Suponha que a classe \(\mathcal{H}\) seja finita, com \(\lvert\mathcal{H}\rvert\) elementos. O evento “existe alguma \(g \in \mathcal{H}\) com \(\lvert \hat{R}_n(g) - R(g) \rvert > \varepsilon\)” é a união de \(\lvert\mathcal{H}\rvert\) eventos e, pela cota da união (desigualdade de Boole), \(P(\cup_j A_j) \le \sum_j P(A_j)\): \[ P\Big(\max_{g \in \mathcal{H}} \big\lvert \hat{R}_n(g) - R(g) \big\rvert > \varepsilon\Big) \le 2\,\lvert\mathcal{H}\rvert\, e^{-2n\varepsilon^2}. \] Como a desigualdade vale uniformemente sobre \(\mathcal{H}\), ela vale em particular para a hipótese escolhida \(\hat{f}\), qualquer que seja o critério de escolha. Assim, com probabilidade pelo menos \(1 - \delta\), \[ R(\hat{f}) \le \hat{R}_n(\hat{f}) + \sqrt{\frac{\ln\lvert\mathcal{H}\rvert + \ln(2/\delta)}{2n}}. \]
Essa cota é a versão mais simples de um limite de generalização, e já contém a mensagem central da teoria: o otimismo do erro de treino cresce com a complexidade da classe (aqui, \(\ln\lvert\mathcal{H}\rvert\)) e diminui com o tamanho da amostra (à taxa \(1/\sqrt{n}\)).
Uma equipe compara \(\lvert\mathcal{H}\rvert = 1.000\) regras de classificação candidatas e escolhe a de menor erro de treino. Com \(\delta = 0{,}05\), temos \(\ln 1000 \approx 6{,}908\) e \(\ln(2/0{,}05) = \ln 40 \approx 3{,}689\).
- Com \(n = 1.000\): a margem é \(\sqrt{(6{,}908 + 3{,}689)/2000} = \sqrt{0{,}0053} \approx 0{,}073\). Se o erro de treino da regra escolhida for 10%, podemos garantir (com 95% de confiança) apenas que o erro verdadeiro é no máximo cerca de 17,3%.
- Com \(n = 10.000\): a margem cai para \(\sqrt{10{,}597/20000} \approx 0{,}023\).
- Para garantir margem \(\varepsilon = 0{,}02\), isolamos \(n\): \[ n \ge \frac{\ln\lvert\mathcal{H}\rvert + \ln(2/\delta)}{2\varepsilon^2} = \frac{10{,}597}{2 \times 0{,}0004} \approx 13.246. \]
Compare com o caso de uma única hipótese (\(\lvert\mathcal{H}\rvert = 1\), \(n = 1.000\)), cuja margem era 0,043: o preço de escolher entre mil regras é aumentar a margem em cerca de 70%. Note que a dependência em \(\lvert\mathcal{H}\rvert\) é apenas logarítmica: multiplicar o número de candidatas por 1.000 soma apenas \(\ln 1000 \approx 6{,}9\) ao numerador.
10.4.3 Aprendizado PAC
Valiant (1984) formalizou a noção de “aprender” no modelo PAC (Probably Approximately Correct, “provavelmente aproximadamente correto”). Uma classe \(\mathcal{H}\) é aprendível no sentido PAC (na versão agnóstica, que não supõe que a função verdadeira pertença a \(\mathcal{H}\)) se existem um algoritmo e uma função \(n_{\mathcal{H}}(\varepsilon, \delta)\) tais que, para qualquer distribuição \(P_{X,Y}\) e quaisquer \(\varepsilon, \delta \in (0,1)\), com \(n \ge n_{\mathcal{H}}(\varepsilon, \delta)\) observações o algoritmo devolve \(\hat{f}\) satisfazendo \[ P\Big(R(\hat{f}) \le \min_{g \in \mathcal{H}} R(g) + \varepsilon\Big) \ge 1 - \delta. \] “Aproximadamente correto” refere-se à tolerância \(\varepsilon\); “provavelmente”, à confiança \(1 - \delta\). A função \(n_{\mathcal{H}}\) é a complexidade amostral. O resultado da seção anterior mostra que toda classe finita é PAC-aprendível pela ERM, com \(n_{\mathcal{H}}(\varepsilon, \delta) = \lceil 2[\ln\lvert\mathcal{H}\rvert + \ln(2/\delta)]/\varepsilon^2 \rceil\) (o fator 2 a mais aparece porque precisamos de margem \(\varepsilon/2\) tanto para \(\hat{f}\) quanto para a melhor hipótese da classe).
10.4.4 Classes infinitas: a dimensão VC
A maioria das classes de interesse é infinita (por exemplo, todas as retas do plano), e a cota com \(\ln\lvert\mathcal{H}\rvert\) torna-se inútil. Vapnik e Chervonenkis perceberam que o que importa não é quantas funções existem, mas quantas rotulações distintas elas conseguem produzir em uma amostra finita (Vapnik e Chervonenkis 1971).
Diz-se que \(\mathcal{H}\) fragmenta (shatters) um conjunto de pontos \(\{x_1, \dots, x_m\}\) se, para cada uma das \(2^m\) atribuições de rótulos 0/1 a esses pontos, existe uma \(g \in \mathcal{H}\) que as reproduz exatamente. A dimensão VC de \(\mathcal{H}\), \(d_{VC}(\mathcal{H})\), é o maior \(m\) para o qual algum conjunto de \(m\) pontos é fragmentado.
- Intervalos na reta (\(g(x) = 1\) se \(a \le x \le b\)): fragmentam quaisquer 2 pontos distintos, mas nenhum conjunto de 3 pontos \(x_1 < x_2 < x_3\), pois a rotulação \((1, 0, 1)\) é impossível. Logo, \(d_{VC} = 2\).
- Semiplanos no plano (classificadores lineares em \(\mathbb{R}^2\)): fragmentam 3 pontos não colineares, mas nenhum conjunto de 4 pontos (se os 4 formam um quadrilátero convexo, a rotulação “diagonais iguais” é impossível — o problema do XOR; se um está dentro do triângulo dos outros, o ponto interno não pode ter rótulo diferente dos três vértices; casos com três pontos colineares são análogos). Logo, \(d_{VC} = 3\).
- Classificadores lineares em \(\mathbb{R}^p\): \(d_{VC} = p + 1\), o número de parâmetros (coeficientes mais intercepto).
A dimensão VC nem sempre coincide com o número de parâmetros: a família \(g(x) = \mathbf{1}(\sin(\omega x) > 0)\), com um único parâmetro \(\omega\), tem dimensão VC infinita.
O resultado fundamental, cuja demonstração usa o lema de Sauer–Shelah (o número de rotulações distintas de \(n\) pontos é no máximo \(\sum_{i=0}^{d}\binom{n}{i} \le (en/d)^d\), polinomial em \(n\), em vez de \(2^n\)), é que uma classe com dimensão VC finita \(d\) satisfaz, com probabilidade pelo menos \(1 - \delta\) (Vapnik 1995), \[ R(g) \le \hat{R}_n(g) + \sqrt{\frac{d\,\big[\ln(2n/d) + 1\big] + \ln(4/\delta)}{n}} \qquad \text{para toda } g \in \mathcal{H}. \] O teorema fundamental do aprendizado estatístico afirma, de forma ainda mais forte, que uma classe é PAC-aprendível se, e somente se, sua dimensão VC é finita (Shalev-Shwartz e Ben-David 2014).
Um classificador linear com \(p = 10\) preditores tem \(d = 11\). Com \(n = 10.000\) e \(\delta = 0{,}05\): \[ \sqrt{\frac{11\,[\ln(20000/11) + 1] + \ln 80}{10000}} = \sqrt{\frac{11 \times 8{,}506 + 4{,}382}{10000}} \approx \sqrt{0{,}00979} \approx 0{,}099. \] Com \(n = 100.000\), a margem cai para cerca de 0,035. As cotas VC são conservadoras (valem para qualquer distribuição dos dados) e, na prática, o erro de generalização costuma ser bem menor do que elas garantem; por isso, para estimar o erro, usamos conjuntos de teste e validação cruzada. O valor das cotas é qualitativo: elas explicam por que modelos de capacidade controlada generalizam e fundamentam a regularização e o princípio de minimização do risco estrutural, em que se minimiza o risco empírico mais uma penalidade de complexidade.
10.4.5 Erro de aproximação e erro de estimação
Seja \(f^*\) o classificador de Bayes, com risco \(R^*\), e \(g^*_{\mathcal{H}} = \arg\min_{g \in \mathcal{H}} R(g)\) a melhor função da classe. O excesso de risco da hipótese aprendida se decompõe em \[ R(\hat{f}) - R^* = \underbrace{\big[R(\hat{f}) - R(g^*_{\mathcal{H}})\big]}_{\text{erro de estimação}} + \underbrace{\big[R(g^*_{\mathcal{H}}) - R^*\big]}_{\text{erro de aproximação}}. \] O erro de aproximação depende apenas da classe: diminui quando \(\mathcal{H}\) é mais rica. O erro de estimação decorre de termos uma amostra finita: cresce com a complexidade da classe (por exemplo, com \(d_{VC}\)) e diminui com \(n\). Essa é a versão “teoria do aprendizado” do dilema viés-variância, estudado adiante: classes pobres têm erro de aproximação (viés) grande; classes ricas têm erro de estimação (variância) grande.
10.4.6 O teorema “não há almoço grátis”
Se existisse um algoritmo de aprendizado universalmente superior, bastaria usá-lo sempre. O teorema “não há almoço grátis” (No Free Lunch) de Wolpert (1996) mostra que isso é impossível: em média sobre todos os problemas possíveis, todos os algoritmos têm o mesmo desempenho fora da amostra de treino.
A ideia pode ser vista em um exemplo simples. Suponha três preditores binários, de modo que \(\mathcal{X}\) tem \(2^3 = 8\) pontos, e que observamos os rótulos de 5 deles. Os 3 pontos não observados podem ter \(2^3 = 8\) rotulações. Se todas as funções-alvo são igualmente plausíveis a priori, cada rotulação dos pontos não vistos tem probabilidade \(1/8\); qualquer previsão que o algoritmo faça para um ponto não visto acerta em exatamente metade das rotulações. O erro esperado fora da amostra é, portanto, \(1/2\) para qualquer algoritmo — inclusive para um que “chute” ao acaso.
A lição não é que aprender é impossível, mas que todo aprendizado depende de suposições (o chamado viés indutivo): suavidade da função, linearidade, poucos preditores relevantes, invariâncias. Um algoritmo é bom em um problema quando suas suposições combinam com a estrutura daquele problema. É por isso que comparamos vários algoritmos empiricamente, por validação cruzada, em vez de escolher um “melhor” de antemão.
10.5 Otimização: Gradiente Descendente
A ERM transforma o aprendizado em um problema de otimização: encontrar os parâmetros \(\boldsymbol{\theta}\) que minimizam \(\hat{R}_n(\boldsymbol{\theta})\). Em poucos casos há solução fechada (mínimos quadrados, por exemplo); na maioria — regressão logística, redes neurais, muitos modelos regularizados — a minimização é feita por métodos iterativos, dos quais o mais importante é o gradiente descendente.
10.5.1 O algoritmo
O gradiente \(\nabla \hat{R}_n(\boldsymbol{\theta})\) aponta na direção de maior crescimento da função; caminhar no sentido oposto, com um passo pequeno, diminui o risco. A partir de um ponto inicial \(\boldsymbol{\theta}^{(0)}\), iteramos \[ \boldsymbol{\theta}^{(k+1)} = \boldsymbol{\theta}^{(k)} - \eta\, \nabla \hat{R}_n\big(\boldsymbol{\theta}^{(k)}\big), \] em que \(\eta > 0\) é a taxa de aprendizado (learning rate), um hiperparâmetro. Para a regressão linear com \(\hat{R}_n(\boldsymbol{\beta}) = \frac{1}{2n}\lVert \mathbf{y} - \mathbf{X}\boldsymbol{\beta} \rVert^2\), o gradiente é \(-\frac{1}{n}\mathbf{X}^\top(\mathbf{y} - \mathbf{X}\boldsymbol{\beta})\).
Convergência. Se \(\hat{R}_n\) é convexa e seu gradiente é \(L\)-Lipschitz (a função é “\(L\)-suave”, isto é, sua curvatura é limitada por \(L\)), o gradiente descendente com \(\eta \le 1/L\) satisfaz \[ \hat{R}_n\big(\boldsymbol{\theta}^{(k)}\big) - \hat{R}_n(\boldsymbol{\theta}^*) \le \frac{L\,\lVert \boldsymbol{\theta}^{(0)} - \boldsymbol{\theta}^* \rVert^2}{2k}, \] isto é, o erro de otimização decai como \(1/k\); se, além disso, a função é fortemente convexa, a convergência é geométrica (Bottou, Curtis, e Nocedal 2018). Se \(\eta\) é grande demais, porém, o algoritmo pode oscilar e divergir.
Considere a regressão sem intercepto \(y = \beta x\) com os dados \(x = (1, 2, 3)\) e \(y = (2, 3, 7)\). O risco empírico é \(\hat{R}(\beta) = \frac{1}{6}\sum_i (y_i - \beta x_i)^2\), e \[ \hat{R}'(\beta) = -\frac{1}{3}\sum_i x_i(y_i - \beta x_i) = L\beta - c, \qquad L = \frac{1}{3}\sum_i x_i^2 = \frac{14}{3} \approx 4{,}667, \quad c = \frac{1}{3}\sum_i x_i y_i = \frac{29}{3} \approx 9{,}667. \] O mínimo é \(\beta^* = c/L = 29/14 \approx 2{,}0714\). Subtraindo \(\beta^*\) dos dois lados da iteração \(\beta^{(k+1)} = \beta^{(k)} - \eta(L\beta^{(k)} - c)\), obtemos \[ \beta^{(k+1)} - \beta^* = (1 - \eta L)\,\big(\beta^{(k)} - \beta^*\big), \] de modo que o erro é multiplicado por \((1 - \eta L)\) a cada passo. O algoritmo converge se, e somente se, \(\lvert 1 - \eta L \rvert < 1\), ou seja, \(0 < \eta < 2/L \approx 0{,}4286\). Partindo de \(\beta^{(0)} = 0\):
| Iteração | \(\eta = 0{,}1\) (fator 0,53) | \(\eta = 0{,}3\) (fator \(-0{,}40\)) | \(\eta = 0{,}45\) (fator \(-1{,}10\)) |
|---|---|---|---|
| 1 | 0,967 | 2,900 | 4,350 |
| 2 | 1,482 | 1,740 | \(-0{,}435\) |
| 3 | 1,757 | 2,204 | 4,829 |
| 4 | 1,904 | 2,018 | \(-0{,}961\) |
| 5 | 1,982 | 2,093 | 5,408 |
Com \(\eta = 0{,}1\), o algoritmo se aproxima monotonamente de 2,0714; com \(\eta = 0{,}3\), oscila em torno do mínimo, mas converge; com \(\eta = 0{,}45 > 2/L\), oscila com amplitude crescente e diverge. Em várias dimensões, \(L\) é o maior autovalor da matriz hessiana \(\frac{1}{n}\mathbf{X}^\top\mathbf{X}\), e preditores em escalas muito diferentes tornam essa matriz mal condicionada, obrigando o uso de \(\eta\) pequeno e tornando a convergência lenta. Esse é outro motivo para padronizar os preditores.
10.5.2 Gradiente descendente estocástico
Calcular o gradiente exato exige percorrer as \(n\) observações a cada passo, o que é caro quando \(n\) é da ordem de milhões. O gradiente descendente estocástico (SGD, stochastic gradient descent) substitui o gradiente completo pelo gradiente calculado em uma única observação ou em um pequeno lote (mini-batch) \(B\) sorteado: \[ \boldsymbol{\theta}^{(t+1)} = \boldsymbol{\theta}^{(t)} - \eta_t\, \frac{1}{\lvert B \rvert}\sum_{i \in B} \nabla L\big(y_i, g_{\boldsymbol{\theta}^{(t)}}(x_i)\big). \] Como o lote é sorteado ao acaso, esse gradiente é um estimador não viesado do gradiente completo, mas ruidoso. Para que o ruído não impeça a convergência, a taxa de aprendizado deve diminuir ao longo das iterações; as condições clássicas de Robbins e Monro (1951) são \[ \sum_{t=1}^{\infty} \eta_t = \infty \qquad \text{e} \qquad \sum_{t=1}^{\infty} \eta_t^2 < \infty, \] satisfeitas, por exemplo, por \(\eta_t = \eta_0/t\). A primeira condição garante que o algoritmo consegue percorrer qualquer distância; a segunda, que o ruído acumulado é finito. O SGD e suas variantes (com momento, Adam, RMSProp) são os algoritmos de treinamento de praticamente todas as redes neurais modernas (Bottou, Curtis, e Nocedal 2018; Goodfellow, Bengio, e Courville 2016). Uma passagem completa pelos dados é chamada de época.
import numpy as np

def gradiente_descendente(X, y, eta=0.1, n_iter=1000):
    n, p = X.shape
    beta = np.zeros(p)
    for _ in range(n_iter):
        grad = -X.T @ (y - X @ beta) / n
        beta = beta - eta * grad
    return beta

def sgd(X, y, eta0=0.1, n_epocas=50, tam_lote=16, seed=0):
    rng = np.random.default_rng(seed)
    n, p = X.shape
    beta = np.zeros(p)
    t = 0
    for epoca in range(n_epocas):
        idx = rng.permutation(n)                  # embaralha a cada época
        for inicio in range(0, n, tam_lote):
            lote = idx[inicio:inicio + tam_lote]
            grad = -X[lote].T @ (y[lote] - X[lote] @ beta) / len(lote)
            t += 1
            beta = beta - eta0 / np.sqrt(t) * grad  # taxa decrescente
    return beta

rng = np.random.default_rng(42)
n = 1000
x = rng.normal(size=n)
X = np.column_stack([np.ones(n), x])
y = 1.0 + 2.0 * x + rng.normal(scale=0.5, size=n)

print("Mínimos quadrados:", np.linalg.lstsq(X, y, rcond=None)[0].round(3))
print("Gradiente:        ", gradiente_descendente(X, y).round(3))
print("SGD:              ", sgd(X, y).round(3))
#> Mínimos quadrados: [0.959 1.996]
#> Gradiente:         [0.959 1.996]
#> SGD:               [0.959 1.997]
O esquema \(\eta_t = \eta_0/\sqrt{t}\) usado no código decai mais lentamente que \(\eta_0/t\) e é comum na prática; em problemas convexos ele também conduz a soluções próximas do ótimo.
10.6 Predição versus Inferência
Há dois grandes motivos para estimar \(f\) (James et al. 2013):
- Predição: interessa apenas que \(\hat{Y} = \hat{f}(X)\) seja próximo de \(Y\). O modelo pode ser uma “caixa-preta”. Exemplo: prever a demanda de energia elétrica para a próxima hora.
- Inferência: interessa entender como \(Y\) depende de \(X\): quais preditores importam, qual o sinal e a magnitude de cada efeito, se a relação é linear. Exemplo: quanto o aumento de um ano de escolaridade está associado ao salário, mantidas as demais variáveis.
Essa distinção ecoa o famoso ensaio de Leo Breiman sobre as duas culturas da modelagem estatística (Breiman 2001): a cultura da modelagem de dados, que supõe um modelo estocástico para os dados e prioriza a interpretação dos parâmetros, e a cultura da modelagem algorítmica, que trata o mecanismo gerador como desconhecido e prioriza a acurácia preditiva. Em geral, há um compromisso entre interpretabilidade e flexibilidade: modelos lineares são fáceis de interpretar, mas pouco flexíveis; florestas aleatórias e redes neurais são muito flexíveis, mas difíceis de interpretar.
10.7 Métodos Paramétricos e Não Paramétricos
- Métodos paramétricos supõem uma forma funcional para \(f\) descrita por um número fixo de parâmetros, por exemplo \(f(X) = \beta_0 + \beta_1 X_1 + \dots + \beta_p X_p\). O problema de estimar uma função se reduz a estimar \(p+1\) números. Vantagens: simplicidade, interpretabilidade, poucos dados necessários. Limitação: se a forma suposta estiver errada, o modelo terá viés que nenhuma quantidade de dados corrige.
- Métodos não paramétricos não supõem uma forma funcional explícita; a complexidade do modelo cresce com os dados. Exemplos: k-vizinhos mais próximos, árvores de decisão, splines e métodos de kernel. Vantagem: flexibilidade para capturar relações complexas. Limitações: exigem muito mais dados (especialmente em dimensão alta — a chamada maldição da dimensionalidade), maior risco de sobreajuste e menor interpretabilidade.
10.7.1 A Maldição da Dimensionalidade
A expressão maldição da dimensionalidade foi cunhada por Bellman (1961) para descrever o crescimento explosivo do volume do espaço quando a dimensão aumenta. Para métodos não paramétricos, que estimam \(f(x)\) a partir de observações próximas de \(x\), as consequências são severas.
Vizinhanças locais deixam de ser locais. Suponha preditores uniformemente distribuídos no hipercubo unitário \([0,1]^p\) e que queiramos uma vizinhança cúbica em torno de um ponto contendo uma fração \(r\) das observações. O volume do subcubo é \(e^p\), em que \(e\) é o comprimento da aresta; para que \(e^p = r\), é preciso \[ e_p(r) = r^{1/p}. \]
| Dimensão \(p\) | Aresta para capturar 10% dos dados | Aresta para capturar 1% dos dados |
|---|---|---|
| 1 | 0,10 | 0,01 |
| 2 | 0,32 | 0,10 |
| 3 | 0,46 | 0,22 |
| 10 | 0,79 | 0,63 |
| 100 | 0,98 | 0,95 |
Em dimensão 10, uma vizinhança que contém apenas 1% dos dados precisa cobrir 63% do intervalo de cada preditor: ela já não é “local”, e a média dos vizinhos passa a ter viés grande (Hastie, Tibshirani, e Friedman 2009).
Quase todo o volume fica perto da borda. A fração do volume de \([0,1]^p\) que está a uma distância menor que \(\varepsilon\) da fronteira é \(1 - (1 - 2\varepsilon)^p\). Para a casca de espessura \(\varepsilon = 0{,}005\) em cada lado (isto é, \(1 - 2\varepsilon = 0{,}99\)) e \(p = 500\), essa fração é \(1 - 0{,}99^{500} \approx 0{,}993\): mais de 99% dos pontos estão “na borda”, onde a previsão é uma extrapolação.
As distâncias se concentram. Em dimensão alta, sob condições gerais, a razão entre a distância ao vizinho mais distante e ao mais próximo tende a 1 (Beyer et al. 1999): todos os pontos ficam aproximadamente à mesma distância uns dos outros, e a própria noção de “vizinho mais próximo” perde o sentido. O Capítulo de k-vizinhos mais próximos retoma esse fenômeno.
Para manter a mesma densidade de observações que \(n = 100\) pontos proporcionam em uma dimensão, seriam necessários \(100^p\) pontos em dimensão \(p\) — um número astronômico já para \(p = 10\). A saída é impor estrutura: modelos aditivos, suposições de linearidade, regularização, seleção de variáveis ou redução de dimensionalidade. Dados reais costumam ter dimensão “intrínseca” bem menor que o número de colunas, o que explica por que métodos flexíveis ainda funcionam em muitos problemas de alta dimensão.
10.8 O Ciclo de Avaliação de Modelos e Divisão de Dados
Um dos conceitos mais importantes em Machine Learning é a Generalização: a capacidade de um modelo treinado de realizar previsões corretas em dados novos e nunca antes vistos pelo algoritmo durante a fase de treinamento.
Para simular esse comportamento de forma honesta, nunca devemos avaliar a acurácia de um modelo usando a mesma base de dados na qual ele foi treinado. Fazemos isso dividindo nossos dados brutos em duas partes:
- Conjunto de Treinamento (Training Set): Representa a maior fatia dos dados (geralmente entre 70% a 80%). É a base utilizada pelo algoritmo para aprender as relações e pesos do modelo.
- Conjunto de Teste (Test Set): Representa a fatia restante (20% a 30%). Fica guardada em “segredo” e é utilizada no final do processo apenas para avaliar a acurácia real de generalização do modelo em condições realistas.
Do ponto de vista teórico, o conjunto de teste fornece uma estimativa não viesada do risco esperado: como o modelo \(\hat{f}\) foi ajustado sem usar as \(m\) observações de teste \((x^{te}_j, y^{te}_j)\), elas são independentes de \(\hat{f}\) e
\[ \widehat{\operatorname{Err}}_{teste} = \frac{1}{m}\sum_{j=1}^m L\big(y^{te}_j, \hat{f}(x^{te}_j)\big) \]
é uma média de variáveis i.i.d. com esperança \(R(\hat{f})\).
10.8.1 Treino, Validação e Teste
Na prática, quase todo algoritmo possui hiperparâmetros — escolhas que não são aprendidas diretamente pela minimização do risco empírico, como a profundidade máxima de uma árvore, o número \(k\) de vizinhos no k-NN ou a constante de regularização \(\lambda\). Se escolhermos os hiperparâmetros olhando para o desempenho no conjunto de teste, o teste deixa de ser “secreto” e a estimativa final volta a ser otimista. A solução é uma divisão em três partes:
- Treinamento: ajustar os parâmetros de cada modelo candidato;
- Validação: comparar candidatos e escolher hiperparâmetros;
- Teste: avaliar uma única vez o modelo final escolhido.
Uma proporção comum é 60/20/20. Quando os dados são escassos, reservar 40% para validação e teste é caro; a validação cruzada, descrita a seguir, faz um uso mais eficiente das observações.
- Estratificação: em classificação, a divisão deve preservar a proporção das classes em cada parte (
stratify=yno scikit-learn,stratano tidymodels), especialmente com classes desbalanceadas. - Dados temporais: se o objetivo é prever o futuro, o treino deve conter apenas observações anteriores às do teste. Embaralhar séries temporais produz estimativas otimistas.
- Dados agrupados: se há várias observações do mesmo paciente, cliente ou escola, todas devem ficar do mesmo lado da divisão (validação por grupos), caso contrário o modelo é avaliado sobre “quase as mesmas” observações em que foi treinado.
10.8.2 Validação Cruzada k-Fold
Na validação cruzada com \(k\) partes (k-fold cross-validation) (Kohavi 1995), os dados de treinamento são particionados aleatoriamente em \(k\) subconjuntos (folds) \(F_1, \dots, F_k\) de tamanhos aproximadamente iguais. Para cada \(j = 1, \dots, k\):
- ajusta-se o modelo \(\hat{f}^{(-j)}\) com todas as partes, exceto \(F_j\);
- calcula-se o erro na parte deixada de fora: \(\operatorname{Err}_j = \frac{1}{|F_j|}\sum_{i \in F_j} L\big(y_i, \hat{f}^{(-j)}(x_i)\big)\).
A estimativa de validação cruzada é a média
\[ \operatorname{CV}_{(k)} = \frac{1}{k}\sum_{j=1}^{k} \operatorname{Err}_j, \]
e o desvio padrão dos \(\operatorname{Err}_j\) dá uma ideia da sua variabilidade. Cada observação é usada exatamente uma vez para validação e \(k-1\) vezes para treinamento.
Um classificador é avaliado por validação cruzada com \(k = 5\) sobre 500 observações (100 por parte). As acurácias obtidas em cada parte foram \(0{,}82\); \(0{,}85\); \(0{,}79\); \(0{,}84\) e \(0{,}80\). Então
\[ \operatorname{CV}_{(5)} = \frac{0{,}82 + 0{,}85 + 0{,}79 + 0{,}84 + 0{,}80}{5} = \frac{4{,}10}{5} = 0{,}82, \]
e o desvio padrão amostral das cinco acurácias é
\[ s = \sqrt{\frac{0^2 + 0{,}03^2 + 0{,}03^2 + 0{,}02^2 + 0{,}02^2}{4}} = \sqrt{\frac{0{,}0026}{4}} \approx 0{,}025. \]
Reportamos: acurácia estimada de \(0{,}82 \pm 0{,}025\) (média \(\pm\) desvio padrão entre as partes).
Validação cruzada leave-one-out (LOOCV). É o caso extremo \(k = n\): cada observação é deixada de fora uma vez,
\[ \operatorname{CV}_{(n)} = \frac{1}{n}\sum_{i=1}^{n} L\big(y_i, \hat{f}^{(-i)}(x_i)\big). \]
O LOOCV usa quase todos os dados em cada ajuste (viés pequeno) e é determinístico (não depende da partição aleatória), mas exige \(n\) ajustes e suas estimativas tendem a ter variância alta, pois os \(n\) modelos são treinados em conjuntos quase idênticos e seus erros são fortemente correlacionados. Para a regressão linear por mínimos quadrados há um atalho notável: o LOOCV pode ser calculado com um único ajuste,
\[ \operatorname{CV}_{(n)} = \frac{1}{n}\sum_{i=1}^n \left(\frac{y_i - \hat{y}_i}{1 - h_{ii}}\right)^2, \]
em que \(h_{ii}\) é a alavancagem (leverage) da \(i\)-ésima observação, o \(i\)-ésimo elemento da diagonal da matriz chapéu \(\mathbf{H} = \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\) (James et al. 2013).
Escolha de \(k\). Valores pequenos de \(k\) treinam modelos com menos dados e tendem a superestimar o erro (viés pessimista); valores grandes reduzem esse viés, mas aumentam o custo computacional e a variância da estimativa. Na prática, \(k = 5\) ou \(k = 10\) oferecem um bom compromisso (Kohavi 1995; Hastie, Tibshirani, e Friedman 2009). Variações úteis incluem a validação cruzada estratificada, a repetida (repete-se o k-fold com partições diferentes e tira-se a média) e a aninhada (nested), em que um laço interno escolhe hiperparâmetros e um laço externo estima o erro do procedimento completo.
10.8.3 Validação Cruzada Aninhada
Quando a validação cruzada é usada para escolher hiperparâmetros (ou para escolher entre vários algoritmos), o melhor erro de validação cruzada encontrado é, ele próprio, uma estimativa otimista do erro do modelo escolhido. O motivo é o mesmo que torna o erro de treino otimista: escolhemos a configuração justamente porque ela teve o menor erro estimado, e parte dessa vantagem é sorte (Varma e Simon 2006; Cawley e Talbot 2010).
Suponha que testemos 50 configurações de hiperparâmetros, todas com acurácia verdadeira igual a 0,80, e que cada uma seja avaliada em um conjunto de validação de 200 observações. A acurácia estimada de cada configuração tem desvio padrão aproximado \(\sqrt{0{,}8 \times 0{,}2/200} \approx 0{,}028\). Se os erros das 50 estimativas fossem independentes, a maior delas teria valor esperado de aproximadamente 0,861 (resultado obtido por simulação de Monte Carlo com 100.000 repetições), cerca de dois desvios padrão acima da verdade. Reportar 0,86 como desempenho esperado do modelo escolhido seria um erro, embora nenhuma configuração seja melhor que as outras. Na prática, as estimativas das configurações são correlacionadas (usam os mesmos dados), e o otimismo é menor, mas não desaparece.
A solução é a validação cruzada aninhada (nested cross-validation), que trata todo o procedimento de seleção como parte do algoritmo a ser avaliado:
- Laço externo: divide os dados em \(K\) partes. Para cada parte externa \(j\):
- Laço interno: usando apenas os dados fora da parte \(j\), executa uma validação cruzada completa (por exemplo, 5-fold) para escolher os hiperparâmetros;
- ajusta o modelo com os hiperparâmetros escolhidos em todos os dados fora da parte \(j\);
- avalia esse modelo na parte \(j\), que não participou de nenhuma escolha.
- A média dos \(K\) erros externos estima o erro de generalização do procedimento “busca em grade + ajuste”.
Note que, em cada iteração externa, os hiperparâmetros escolhidos podem ser diferentes; a validação cruzada aninhada não produz um modelo, mas avalia o processo que o produz. Depois da avaliação, o modelo final é obtido aplicando a busca em grade a todos os dados. No scikit-learn, basta passar o objeto GridSearchCV para cross_val_score:
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import GridSearchCV, StratifiedKFold, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

X, y = load_breast_cancer(return_X_y=True)
pipe = Pipeline([("padronizar", StandardScaler()), ("modelo", SVC())])
grade = {"modelo__C": [0.1, 1, 10, 100], "modelo__gamma": [0.001, 0.01, 0.1]}

cv_interna = StratifiedKFold(n_splits=5, shuffle=True, random_state=1)
cv_externa = StratifiedKFold(n_splits=5, shuffle=True, random_state=2)

busca = GridSearchCV(pipe, grade, cv=cv_interna, scoring="accuracy")

# Estimativa ingênua: o melhor escore da própria busca (otimista)
busca.fit(X, y)
print(f"CV não aninhada: {busca.best_score_:.3f}")

# Estimativa honesta: a busca inteira é repetida dentro de cada parte externa
notas = cross_val_score(busca, X, y, cv=cv_externa, scoring="accuracy")
print(f"CV aninhada:     {notas.mean():.3f} ± {notas.std():.3f}")
#> CV não aninhada: 0.982
#> CV aninhada:     0.974 ± 0.024
Neste conjunto de dados, com uma grade pequena, a diferença é modesta (0,982 contra 0,974). Com grades grandes, muitos algoritmos candidatos ou amostras pequenas, o otimismo da estimativa não aninhada pode ser muito maior. No tidymodels, a função nested_cv() do pacote rsample cria as partições aninhadas.
10.8.4 Estimadores Bootstrap do Erro
O bootstrap (Efron 1979) oferece uma alternativa à validação cruzada. Uma amostra bootstrap é obtida sorteando \(n\) observações com reposição dos dados originais. A probabilidade de que uma observação específica não seja sorteada em nenhuma das \(n\) extrações é \[ \left(1 - \frac{1}{n}\right)^n \xrightarrow[n \to \infty]{} e^{-1} \approx 0{,}368. \] Para \(n = 10\), o valor é \(0{,}349\); para \(n = 100\), \(0{,}366\); para \(n = 1.000\), \(0{,}368\). Portanto, cada amostra bootstrap contém, em média, cerca de 63,2% das observações distintas, e as demais 36,8% ficam fora da amostra (out-of-bag, OOB) e podem servir como conjunto de validação — a mesma ideia é usada nas florestas aleatórias.
Sejam \(B\) amostras bootstrap, \(\hat{f}^{*b}\) o modelo ajustado na amostra \(b\) e \(C^{-i}\) o conjunto das amostras que não contêm a observação \(i\). O estimador leave-one-out bootstrap é \[ \widehat{\operatorname{Err}}^{(1)} = \frac{1}{n}\sum_{i=1}^{n} \frac{1}{\lvert C^{-i} \rvert}\sum_{b \in C^{-i}} L\big(y_i, \hat{f}^{*b}(x_i)\big). \] Como cada modelo é treinado com apenas cerca de 63,2% das observações distintas, \(\widehat{\operatorname{Err}}^{(1)}\) tende a ser pessimista — comporta-se aproximadamente como uma validação cruzada com \(k \approx 2\) ou 3. O erro de treino \(\overline{\operatorname{err}}\), por outro lado, é otimista. Efron (1983) propôs combinar os dois no estimador .632: \[ \widehat{\operatorname{Err}}^{(.632)} = 0{,}368\,\overline{\operatorname{err}} + 0{,}632\,\widehat{\operatorname{Err}}^{(1)}. \] O peso 0,632 decorre de um argumento sobre a distância média entre os pontos de teste e os de treino nas amostras bootstrap. O estimador .632 funciona bem quando o modelo não sobreajusta muito, mas é otimista para modelos que decoram o treino (com \(\overline{\operatorname{err}} = 0\), ele dá peso 0,368 a um erro nulo). Para corrigir isso, Efron e Tibshirani (1997) propuseram o estimador .632+, que aumenta o peso de \(\widehat{\operatorname{Err}}^{(1)}\) de acordo com a taxa relativa de sobreajuste \[ \hat{R} = \frac{\widehat{\operatorname{Err}}^{(1)} - \overline{\operatorname{err}}}{\hat{\gamma} - \overline{\operatorname{err}}}, \qquad \hat{w} = \frac{0{,}632}{1 - 0{,}368\,\hat{R}}, \qquad \widehat{\operatorname{Err}}^{(.632+)} = (1 - \hat{w})\,\overline{\operatorname{err}} + \hat{w}\,\widehat{\operatorname{Err}}^{(1)}, \] em que \(\hat{\gamma}\) é o erro sem informação (no-information error rate): o erro que se obteria se preditores e respostas fossem independentes, estimado avaliando o modelo em todas as combinações \((x_i, y_j)\).
Um classificador tem erro de treino \(\overline{\operatorname{err}} = 0{,}05\) e erro leave-one-out bootstrap \(\widehat{\operatorname{Err}}^{(1)} = 0{,}20\). Então \[ \widehat{\operatorname{Err}}^{(.632)} = 0{,}368 \times 0{,}05 + 0{,}632 \times 0{,}20 = 0{,}0184 + 0{,}1264 = 0{,}1448. \] Se o erro sem informação for \(\hat{\gamma} = 0{,}50\) (duas classes equilibradas), \(\hat{R} = (0{,}20 - 0{,}05)/(0{,}50 - 0{,}05) = 1/3\) e \(\hat{w} = 0{,}632/(1 - 0{,}368/3) \approx 0{,}720\), de modo que \[ \widehat{\operatorname{Err}}^{(.632+)} = 0{,}280 \times 0{,}05 + 0{,}720 \times 0{,}20 \approx 0{,}158. \] O estimador .632+ fica entre o .632 (0,145) e o leave-one-out bootstrap (0,200), mais próximo deste quanto maior o sobreajuste relativo.
O código a seguir implementa o estimador .632 em R para uma regressão logística que separa as espécies versicolor e virginica do conjunto iris usando apenas as medidas da sépala:
set.seed(123)
dados <- subset(iris, Species != "setosa")
dados$y <- as.integer(dados$Species == "virginica")
n <- nrow(dados)
B <- 200

erro <- function(treino, teste) {
  ajuste <- glm(y ~ Sepal.Length + Sepal.Width, family = binomial, data = treino)
  prev <- as.integer(predict(ajuste, newdata = teste, type = "response") > 0.5)
  mean(prev != teste$y)
}

err_treino <- erro(dados, dados)
err_oob <- numeric(B)
for (b in 1:B) {
  idx  <- sample(n, n, replace = TRUE)
  fora <- setdiff(1:n, idx)                 # observações out-of-bag
  err_oob[b] <- erro(dados[idx, ], dados[fora, ])
}
err_boot1 <- mean(err_oob)  # aproximação simples do Err(1), média por amostra
err_632 <- 0.368 * err_treino + 0.632 * err_boot1
round(c(treino = err_treino, oob = err_boot1, e632 = err_632), 3)
#> treino    oob   e632
#>  0.250  0.310  0.288
Por simplicidade, o código calcula a média dos erros OOB por amostra bootstrap, e não por observação como na definição de \(\widehat{\operatorname{Err}}^{(1)}\); as duas versões costumam produzir valores próximos. Em estudos comparativos, Kohavi (1995) recomendou a validação cruzada 10-fold estratificada como opção padrão, e o bootstrap .632+ é uma alternativa competitiva em amostras pequenas.
10.9 Underfitting vs. Overfitting: O Dilema Viés-Variância
Durante a modelagem, enfrentamos um equilíbrio delicado de complexidade do modelo que envolve dois grandes problemas:
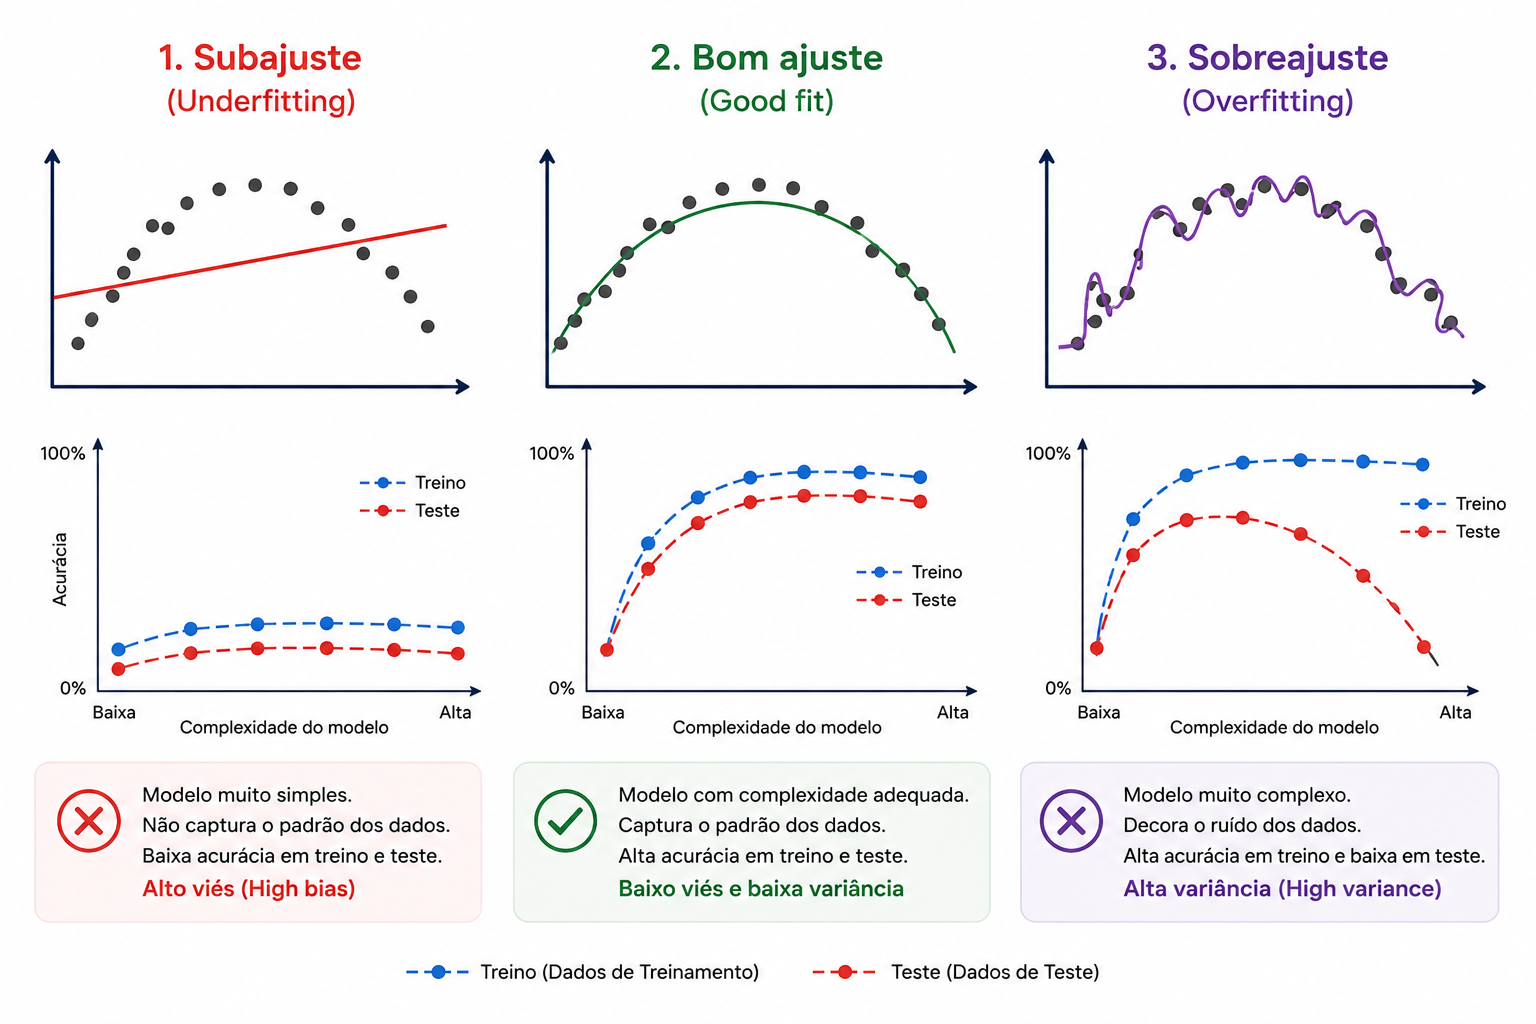
- Subajuste (Underfitting): Ocorre quando o modelo é excessivamente simples para capturar a complexidade matemática real dos dados. Ele apresenta baixa acurácia tanto no conjunto de treino quanto no de teste. Apresenta alto viés (high bias).
- Sobreajuste (Overfitting): Ocorre quando o modelo é excessivamente complexo e acaba “decorando” o ruído e as oscilações específicas dos dados de treinamento, em vez de aprender a tendência geral. Ele apresenta acurácia perfeita (ou quase perfeita) nos dados de treino, mas falha gravemente no conjunto de teste. Apresenta alta variância (high variance).
À medida que a complexidade (flexibilidade) do modelo aumenta, o erro de treino diminui monotonamente, enquanto o erro de teste costuma ter forma de “U”: diminui enquanto o modelo ganha capacidade de capturar a estrutura real e volta a crescer quando passa a ajustar o ruído. O ponto de mínimo do erro de teste corresponde ao ajuste ideal.
10.9.1 A Decomposição Viés-Variância
A formalização desse dilema (Geman, Bienenstock, e Doursat 1992; Hastie, Tibshirani, e Friedman 2009) considera o modelo \(Y = f(X) + \varepsilon\), com \(\mathbb{E}[\varepsilon] = 0\) e \(\operatorname{Var}(\varepsilon) = \sigma^2\), e um ponto fixo \(x_0\). A estimativa \(\hat{f}(x_0)\) é uma variável aleatória, pois depende da amostra de treinamento \(\mathcal{D}\) sorteada. Seja \(y_0 = f(x_0) + \varepsilon_0\) uma nova observação, com \(\varepsilon_0\) independente de \(\mathcal{D}\). Escrevendo \(\bar{f}(x_0) = \mathbb{E}_{\mathcal{D}}[\hat{f}(x_0)]\), temos:
\[ \begin{aligned} \mathbb{E}\big[(y_0 - \hat{f}(x_0))^2\big] &= \mathbb{E}\big[(f(x_0) + \varepsilon_0 - \hat{f}(x_0))^2\big] \\ &= \mathbb{E}[\varepsilon_0^2] + 2\,\mathbb{E}[\varepsilon_0]\,\mathbb{E}\big[f(x_0) - \hat{f}(x_0)\big] + \mathbb{E}\big[(f(x_0) - \hat{f}(x_0))^2\big] \\ &= \sigma^2 + \mathbb{E}\big[(f(x_0) - \hat{f}(x_0))^2\big], \end{aligned} \]
pois \(\varepsilon_0\) é independente de \(\hat{f}(x_0)\) e tem média zero. Somando e subtraindo \(\bar{f}(x_0)\) no último termo:
\[ \begin{aligned} \mathbb{E}\big[(f(x_0) - \hat{f}(x_0))^2\big] &= \mathbb{E}\big[(f(x_0) - \bar{f}(x_0) + \bar{f}(x_0) - \hat{f}(x_0))^2\big] \\ &= \big(f(x_0) - \bar{f}(x_0)\big)^2 + \mathbb{E}\big[(\hat{f}(x_0) - \bar{f}(x_0))^2\big] \\ &\quad + 2\big(f(x_0) - \bar{f}(x_0)\big)\,\mathbb{E}\big[\bar{f}(x_0) - \hat{f}(x_0)\big], \end{aligned} \]
e o termo cruzado se anula porque \(\mathbb{E}[\bar{f}(x_0) - \hat{f}(x_0)] = 0\). Concluímos:
\[ \boxed{\;\mathbb{E}\big[(y_0 - \hat{f}(x_0))^2\big] = \underbrace{\operatorname{Var}\big(\hat{f}(x_0)\big)}_{\text{variância}} + \underbrace{\big[\operatorname{Viés}\big(\hat{f}(x_0)\big)\big]^2}_{\text{viés}^2} + \underbrace{\sigma^2}_{\text{irredutível}}\;} \]
com \(\operatorname{Viés}(\hat{f}(x_0)) = \bar{f}(x_0) - f(x_0)\).
- O viés mede o erro sistemático: quanto a previsão média (sobre todas as amostras de treino possíveis) se afasta do valor verdadeiro. Modelos rígidos demais (por exemplo, uma reta para uma relação curva) têm viés alto.
- A variância mede a instabilidade: quanto a previsão muda quando o modelo é ajustado com outra amostra. Modelos muito flexíveis (por exemplo, o k-NN com \(k = 1\) ou uma árvore muito profunda) têm variância alta.
- O termo \(\sigma^2\) não depende do modelo.
Aumentar a complexidade normalmente reduz o viés e aumenta a variância; o objetivo é encontrar o ponto de equilíbrio que minimiza a soma. Nos capítulos seguintes, veremos como cada algoritmo controla esse equilíbrio: a poda de árvores, o número de vizinhos no k-NN, a média de muitas árvores nas florestas aleatórias (que reduz a variância) e o parâmetro de custo no SVM.
Suponha \(X_1, \dots, X_n\) i.i.d. com média \(\mu = 2\) e variância \(\sigma^2 = 4\), \(n = 4\), e considere estimar \(\mu\) pela família de estimadores “encolhidos” \(\hat{\mu}_c = c\,\bar{X}\), com \(0 \le c \le 1\).
- Viés: \(\mathbb{E}[c\bar{X}] - \mu = (c - 1)\mu = 2(c-1)\);
- Variância: \(c^2\,\sigma^2/n = c^2 \cdot 4/4 = c^2\);
- Erro quadrático médio: \(\operatorname{EQM}(c) = 4(c-1)^2 + c^2\).
Para \(c = 1\) (a média amostral, não viesada): \(\operatorname{EQM} = 1\). Derivando, \(8(c-1) + 2c = 0 \Rightarrow c = 0{,}8\), e \(\operatorname{EQM}(0{,}8) = 4(0{,}04) + 0{,}64 = 0{,}80\). Aceitar um pequeno viés reduziu o erro em 20%, porque a variância caiu mais do que o viés ao quadrado aumentou. Essa é exatamente a ideia por trás da regularização.
10.9.2 Regularização
Regularizar é restringir ou penalizar a complexidade do modelo para reduzir a variância, aceitando algum viés. Na regressão linear, em vez de minimizar apenas o risco empírico, minimizamos
\[ \hat{\boldsymbol{\beta}}_\lambda = \arg\min_{\boldsymbol{\beta}} \left\{ \sum_{i=1}^n \big(y_i - \beta_0 - \mathbf{x}_i^\top\boldsymbol{\beta}\big)^2 + \lambda\, P(\boldsymbol{\beta}) \right\}, \]
em que \(\lambda \ge 0\) é um hiperparâmetro e \(P\) é uma penalidade:
- Ridge (Hoerl e Kennard 1970): \(P(\boldsymbol{\beta}) = \sum_{j=1}^p \beta_j^2\); encolhe os coeficientes em direção a zero, sendo útil com preditores correlacionados;
- Lasso (Tibshirani 1996): \(P(\boldsymbol{\beta}) = \sum_{j=1}^p |\beta_j|\); além de encolher, zera alguns coeficientes, realizando seleção de variáveis;
- Elastic net: combinação das duas penalidades.
Com \(\lambda = 0\) recuperamos os mínimos quadrados; com \(\lambda \to \infty\), todos os coeficientes tendem a zero. Como a penalidade depende da escala dos coeficientes, os preditores devem ser padronizados antes do ajuste. O valor de \(\lambda\) é escolhido por validação cruzada. A mesma ideia aparece em praticamente todos os algoritmos: profundidade máxima e poda em árvores, o parâmetro \(C\) no SVM, weight decay e dropout em redes neurais.
10.10 Hiperparâmetros e Busca em Grade
Parâmetros são aprendidos a partir dos dados durante o ajuste (os coeficientes \(\beta_j\) de uma regressão, os cortes de uma árvore). Hiperparâmetros são definidos antes do ajuste e controlam o processo de aprendizado ou a complexidade do modelo (\(k\) no k-NN, \(\lambda\) no lasso, profundidade máxima de uma árvore).
A forma mais simples de escolher hiperparâmetros é a busca em grade (grid search): define-se um conjunto finito de valores candidatos para cada hiperparâmetro, avalia-se cada combinação por validação cruzada e escolhe-se a de melhor desempenho médio. Com \(h\) hiperparâmetros e \(v\) valores cada, são \(v^h\) combinações, cada uma exigindo \(k\) ajustes — o custo cresce exponencialmente. A busca aleatória (random search), que sorteia combinações de uma distribuição, costuma ser mais eficiente quando apenas alguns hiperparâmetros são realmente importantes (Bergstra e Bengio 2012).
Uma heurística útil é a regra de um erro padrão: entre os modelos cujo erro de validação cruzada está a até um erro padrão do melhor, escolher o mais simples (Hastie, Tibshirani, e Friedman 2009).
10.11 Pré-processamento de Dados
Muitos algoritmos exigem que os dados sejam transformados antes do ajuste:
- Padronização (standardization): \(z_{ij} = (x_{ij} - \bar{x}_j)/s_j\). Essencial para métodos baseados em distâncias (k-NN, k-means, SVM com kernel radial) e para modelos regularizados, pois sem ela variáveis medidas em escalas grandes dominam o cálculo.
- Normalização min-max: \(x'_{ij} = (x_{ij} - \min_j)/(\max_j - \min_j)\), que leva os valores ao intervalo \([0, 1]\).
- Codificação one-hot de variáveis categóricas: uma variável com \(K\) categorias é substituída por \(K\) variáveis indicadoras (0/1). Em modelos lineares com intercepto, usar as \(K\) indicadoras gera colinearidade perfeita (elas somam 1, assim como a coluna do intercepto) — a chamada armadilha das variáveis dummy; por isso usa-se \(K - 1\) indicadoras, tomando uma categoria como referência.
- Imputação de dados faltantes e transformações (log, Box–Cox), discutidas no Capítulo de Análise Exploratória de Dados com Python.
Por exemplo, a variável ilha com categorias {Biscoe, Dream, Torgersen} é codificada em one-hot como:
| ilha | ilha_Biscoe | ilha_Dream | ilha_Torgersen |
|---|---|---|---|
| Biscoe | 1 | 0 | 0 |
| Dream | 0 | 1 | 0 |
| Torgersen | 0 | 0 | 1 |
e, com a categoria Biscoe como referência, apenas as duas últimas colunas são mantidas.
10.11.1 Engenharia de Atributos
A engenharia de atributos (feature engineering) é a construção de novos preditores a partir dos existentes, usando conhecimento do problema. Em muitos projetos, ela contribui mais para o desempenho do que a escolha do algoritmo. Do ponto de vista teórico, a motivação é clara: um modelo de classe \(\mathcal{H}\) restrita (por exemplo, linear) só consegue representar relações que sejam lineares nos atributos fornecidos; transformar os atributos amplia, de forma controlada, a classe de funções efetivamente disponível, reduzindo o erro de aproximação sem a explosão de variância de um modelo totalmente flexível.
Transformações comuns:
- Transformações não lineares: \(\log x\) para variáveis assimétricas e positivas (renda, preços), \(\sqrt{x}\) para contagens, polinômios e splines para relações curvas.
- Razões e diferenças com significado: razão dívida/renda, densidade populacional (habitantes/área), tempo desde o último evento. Um modelo linear não consegue “descobrir” uma razão a partir das duas variáveis separadas.
- Interações: o produto \(x_1 x_2\) permite que o efeito de \(x_1\) dependa do nível de \(x_2\).
- Variáveis de data e hora: dia da semana, mês, feriado, hora do dia.
- Codificação cíclica: variáveis periódicas, como a hora \(h \in \{0, \dots, 23\}\), devem ser representadas de modo que 23h e 0h fiquem próximas. A codificação \[ \big(\sin(2\pi h/24),\ \cos(2\pi h/24)\big) \] coloca as horas sobre um círculo: a distância euclidiana entre 23h e 0h é \(2\sin(\pi/24) \approx 0{,}26\), enquanto entre 0h e 12h é 2 (o diâmetro). Com a codificação numérica ingênua, 23h e 0h estariam à distância 23, a maior possível.
A discretização de variáveis contínuas em faixas (por exemplo, idade em “jovem”, “adulto”, “idoso”) deve ser usada com cautela: ela descarta informação, introduz descontinuidades artificiais nos pontos de corte e raramente melhora o desempenho preditivo, embora possa facilitar a comunicação.
10.11.2 Codificação de Variáveis Categóricas
A escolha da codificação depende do tipo e da cardinalidade (número de categorias) da variável:
| Codificação | Ideia | Quando usar | Cuidado |
|---|---|---|---|
| Ordinal (inteiros) | Categorias viram \(1, 2, \dots, K\) | Variáveis ordinais (escolaridade); árvores | Em modelos lineares e de distância, impõe ordem e espaçamento iguais |
| One-hot / dummy | Uma indicadora por categoria (\(K\) ou \(K-1\)) | Baixa cardinalidade | Com \(K\) grande, cria muitas colunas esparsas |
| Hashing | Uma função hash mapeia as categorias em \(m\) colunas fixas | Cardinalidade enorme ou categorias novas em produção | Colisões: categorias diferentes podem compartilhar a coluna |
| Codificação pelo alvo (target encoding) | Cada categoria é substituída pela média da resposta naquela categoria | Alta cardinalidade (CEP, município, produto) | Alto risco de vazamento e sobreajuste |
A codificação pelo alvo (Micci-Barreca 2001) merece atenção especial. A versão ingênua substitui a categoria \(c\) pela média \(\bar{y}_c\) da resposta nas \(n_c\) observações dessa categoria. Para categorias raras, porém, \(\bar{y}_c\) é muito instável (com \(n_c = 1\), é a própria resposta da observação!). A solução é encolher a média da categoria em direção à média global \(\bar{y}\): \[ \tilde{y}_c = \frac{n_c\,\bar{y}_c + m\,\bar{y}}{n_c + m} = \lambda_c\,\bar{y}_c + (1 - \lambda_c)\,\bar{y}, \qquad \lambda_c = \frac{n_c}{n_c + m}, \] em que \(m > 0\) é um hiperparâmetro de suavização. Essa fórmula tem uma interpretação bayesiana: é a média a posteriori de uma proporção com distribuição a priori Beta de média \(\bar{y}\) e “tamanho amostral equivalente” \(m\). Categorias com muitas observações (\(n_c \gg m\)) mantêm aproximadamente sua própria média; categorias raras recebem um valor próximo da média global.
Em um problema de previsão de inadimplência, a taxa global é \(\bar{y} = 0{,}30\) e usamos \(m = 10\).
- Olinda: \(n_c = 4\) clientes, dos quais 3 inadimplentes (\(\bar{y}_c = 0{,}75\)). Então \(\tilde{y}_c = (4 \times 0{,}75 + 10 \times 0{,}30)/(4 + 10) = 6/14 \approx 0{,}429\). Com apenas 4 observações, a codificação é puxada fortemente para a média global.
- Recife: \(n_c = 400\), com \(\bar{y}_c = 0{,}35\). Então \(\tilde{y}_c = (400 \times 0{,}35 + 10 \times 0{,}30)/410 = 143/410 \approx 0{,}349\), praticamente a média da própria categoria.
Mesmo suavizada, a codificação usa a resposta, e por isso deve ser calculada apenas no treino e, idealmente, fora da parte (out-of-fold): o valor atribuído a cada observação de treino é calculado sem usar a própria observação, por exemplo com uma validação cruzada interna. Caso contrário, a codificação “vaza” a resposta para o preditor.
10.12 Vazamento de Dados (Data Leakage)
O vazamento de dados ocorre quando informação que não estaria disponível no momento da previsão é usada, direta ou indiretamente, no treinamento ou na avaliação do modelo (Kaufman et al. 2012). O resultado é um modelo com desempenho espetacular na validação e decepcionante em produção. As formas mais comuns são:
- Contaminação treino-teste no pré-processamento: calcular médias, desvios padrão, medianas de imputação, seleção de variáveis ou balanceamento de classes usando todos os dados antes da divisão. O conjunto de teste “vaza” para o treino por meio dessas estatísticas.
- Vazamento do alvo (target leakage): incluir preditores que são consequência da resposta ou só são conhecidos depois dela. Exemplo: usar “recebeu tratamento com antibiótico” para prever “teve pneumonia”, ou “número de dias de atraso” para prever “inadimplência”.
- Vazamento temporal: usar informação do futuro para prever o passado, por exemplo ao embaralhar séries temporais ou ao calcular médias móveis centradas.
- Duplicatas e grupos: a mesma entidade (paciente, cliente, imagem duplicada) aparecendo no treino e no teste.
A regra de ouro é: toda operação que aprende algo com os dados (inclusive o pré-processamento) deve ser ajustada apenas no conjunto de treinamento — e, dentro da validação cruzada, apenas nas partes de treino de cada iteração. Os objetos Pipeline do scikit-learn e workflow/recipe do tidymodels existem justamente para garantir isso automaticamente.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline

X, y = load_breast_cancer(return_X_y=True)

# ERRADO: o padronizador "vê" todas as observações, inclusive as que
# serão usadas para validação em cada fold
X_padronizado = StandardScaler().fit_transform(X)
cv_errado = cross_val_score(LogisticRegression(max_iter=1000), X_padronizado, y, cv=5)

# CORRETO: a padronização é reajustada dentro de cada fold
pipe = Pipeline([
    ("padronizar", StandardScaler()),
    ("modelo", LogisticRegression(max_iter=1000)),
])
cv_correto = cross_val_score(pipe, X, y, cv=5)
Com uma simples padronização, a diferença numérica costuma ser pequena; com seleção de variáveis supervisionada, imputação ou balanceamento feitos antes da divisão, o otimismo pode ser enorme (Hastie, Tibshirani, e Friedman 2009, seç. 7.10.2).
O exemplo a seguir, inspirado em Hastie, Tibshirani, e Friedman (2009) (seção 7.10.2), gera \(n = 50\) observações com \(p = 5.000\) preditores de ruído puro e uma resposta binária sorteada independentemente deles. Nenhum modelo pode acertar mais que 50% em dados novos. Se selecionarmos as 20 variáveis mais correlacionadas com a resposta usando todos os dados e só depois fizermos a validação cruzada, a acurácia estimada é altíssima; colocando a seleção dentro do pipeline, a estimativa volta a ser honesta.
import numpy as np
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import Pipeline

rng = np.random.default_rng(0)
X = rng.normal(size=(50, 5000))
y = rng.integers(0, 2, size=50)        # resposta independente de X

# ERRADO: seleção usando todas as observações, antes da validação cruzada
X_sel = SelectKBest(f_classif, k=20).fit_transform(X, y)
print(cross_val_score(LogisticRegression(max_iter=1000), X_sel, y, cv=5).mean())
#> 0.96

# CORRETO: a seleção é refeita dentro de cada parte de treino
pipe = Pipeline([("selecionar", SelectKBest(f_classif, k=20)),
                 ("modelo", LogisticRegression(max_iter=1000))])
print(cross_val_score(pipe, X, y, cv=5).mean())
#> 0.52
Com 5.000 preditores, algumas dezenas estarão, por puro acaso, fortemente associadas à resposta nesta amostra; ao selecioná-las com todos os dados, as observações de validação participaram da escolha, e a validação cruzada mede apenas a capacidade de reproduzir esse acaso.
10.13 Métricas de Avaliação para Classificação
A forma correta de avaliar modelos de classificação vai muito além da acurácia simples. Iniciamos estruturando uma Matriz de Confusão:
| Previsto Positivo | Previsto Negativo | |
|---|---|---|
| Real Positivo | Verdadeiro Positivo (VP) | Falso Negativo (FN) |
| Real Negativo | Falso Positivo (FP) | Verdadeiro Negativo (VN) |
- Verdadeiro Positivo (VP): O dado era de fato positivo e o modelo acertou prevendo positivo.
- Falso Positivo (FP) - Erro Tipo I: O dado era negativo, mas o modelo erroneamente o classificou como positivo.
- Falso Negativo (FN) - Erro Tipo II: O dado era positivo, mas o modelo erroneamente o classificou como negativo.
- Verdadeiro Negativo (VN): O dado era negativo e o modelo acertou prevendo negativo.
A partir desses quatro valores da matriz, derivamos as principais métricas de avaliação:
Acurácia (Accuracy): Mede a proporção geral de acertos do modelo em relação ao total de dados: \[\text{Acurácia} = \frac{VP + VN}{VP + VN + FP + FN}\] Cuidado: A acurácia pode ser uma métrica enganosa em conjuntos de dados altamente desbalanceados (ex: uma base onde 99% das transações são normais e apenas 1% são fraudes; um modelo que prevê que todas as transações são normais sem fazer qualquer análise terá 99% de acurácia, mas falhará em capturar as fraudes).
Precisão (Precision): Mede a proporção de acertos positivos entre todas as previsões que o modelo classificou como positivas: \[\text{Precisão} = \frac{VP}{VP + FP}\] Uso: Crítica quando queremos minimizar os falsos positivos (ex: aprovação automatizada de crédito).
Sensibilidade ou Revocação (Recall / Sensitivity): Mede a proporção de acertos positivos entre todas as amostras reais que de fato eram positivas: \[\text{Recall} = \frac{VP}{VP + FN}\] Uso: Crítica quando queremos minimizar os falsos negativos (ex: diagnósticos médicos de doenças graves, detecção de fraudes).
F1-Score: Representa a média harmônica entre a Precisão e a Sensibilidade, fornecendo uma métrica única e balanceada para dados desbalanceados: \[\text{F1-Score} = 2 \times \frac{\text{Precisão} \times \text{Recall}}{\text{Precisão} + \text{Recall}}\]
Outras métricas derivadas da matriz de confusão completam o quadro:
- Especificidade (specificity, taxa de verdadeiros negativos): proporção de negativos reais corretamente identificados, \[\text{Especificidade} = \frac{VN}{VN + FP}.\] Seu complemento é a taxa de falsos positivos, \(\text{TFP} = FP/(FP + VN) = 1 - \text{Especificidade}\).
- Acurácia balanceada: média entre sensibilidade e especificidade, \((\text{Recall} + \text{Especificidade})/2\); vale 0,5 para um classificador que prevê sempre a mesma classe, independentemente do desbalanceamento.
- \(F_\beta\): generalização do F1 que pondera a revocação \(\beta\) vezes mais do que a precisão, \[F_\beta = (1 + \beta^2)\,\frac{\text{Precisão} \times \text{Recall}}{\beta^2\,\text{Precisão} + \text{Recall}}.\] Com \(\beta = 2\), privilegia-se a revocação (por exemplo, em triagens médicas).
Por que a média harmônica no F1? Ela é dominada pelo menor dos dois valores: um modelo com precisão 1,0 e revocação 0,01 tem média aritmética 0,505, mas F1 \(\approx 0{,}02\). Assim, o F1 só é alto quando ambas as métricas são altas.
Note também a relação com a terminologia dos testes de hipóteses: a taxa de falsos positivos corresponde ao nível de significância \(\alpha\) (probabilidade do erro tipo I) e a revocação corresponde ao poder do teste, \(1 - \beta\).
Um modelo de triagem é aplicado a 1.000 pacientes, dos quais 100 têm a doença (positivos). O resultado foi:
| Previsto Positivo | Previsto Negativo | Total | |
|---|---|---|---|
| Real Positivo | VP = 80 | FN = 20 | 100 |
| Real Negativo | FP = 45 | VN = 855 | 900 |
| Total | 125 | 875 | 1.000 |
- Acurácia: \((80 + 855)/1000 = 0{,}935\);
- Precisão: \(80/125 = 0{,}64\) — de cada 100 alarmes, 64 são doentes de fato;
- Revocação: \(80/100 = 0{,}80\) — o modelo detecta 80% dos doentes;
- Especificidade: \(855/900 = 0{,}95\);
- F1: \(2 \times 0{,}64 \times 0{,}80 / (0{,}64 + 0{,}80) = 1{,}024 / 1{,}44 \approx 0{,}711\);
- Acurácia balanceada: \((0{,}80 + 0{,}95)/2 = 0{,}875\).
Compare com o classificador trivial que declara todos saudáveis: acurácia \(900/1000 = 0{,}90\) (quase a mesma do modelo!), mas revocação 0, precisão indefinida e acurácia balanceada 0,5. A acurácia, sozinha, esconde que o classificador trivial é inútil.
10.13.1 Limiar de Decisão, Curva ROC e AUC
A maioria dos classificadores produz um escore \(\hat{s}(x)\) — frequentemente uma estimativa de \(P(Y = 1 \mid X = x)\) — e a classe é obtida comparando-o com um limiar \(t\): prevê-se positivo se \(\hat{s}(x) \ge t\). O limiar padrão \(t = 0{,}5\) não é obrigatório: reduzir \(t\) aumenta a revocação e a taxa de falsos positivos; aumentá-lo tem o efeito contrário. A escolha deve refletir os custos de cada tipo de erro no problema.
O limiar ótimo sob custos assimétricos. Suponha que um falso negativo custe \(c_{FN}\) e um falso positivo custe \(c_{FP}\), e que \(p(x) = P(Y = 1 \mid X = x)\) seja conhecida. Prever positivo tem custo esperado \((1 - p(x))\,c_{FP}\) (erramos se \(Y = 0\)); prever negativo tem custo esperado \(p(x)\,c_{FN}\). A decisão de Bayes é prever positivo quando \(p(x)\,c_{FN} > (1 - p(x))\,c_{FP}\), ou seja, \[ p(x) > t^* = \frac{c_{FP}}{c_{FP} + c_{FN}}. \] Com custos iguais, \(t^* = 0{,}5\), recuperando o classificador de Bayes da perda 0-1. Se, em uma triagem, deixar de detectar um doente custa 10 vezes mais do que encaminhar um saudável para exames adicionais (\(c_{FN} = 10\), \(c_{FP} = 1\)), o limiar ótimo é \(t^* = 1/11 \approx 0{,}091\): basta uma probabilidade estimada de cerca de 9% para justificar o encaminhamento. Esse resultado só é útil se as probabilidades estimadas forem calibradas, como discutido adiante.
A curva ROC (Receiver Operating Characteristic), originada na teoria de detecção de sinais em radares durante a Segunda Guerra Mundial, mostra esse compromisso para todos os limiares possíveis: é o gráfico da taxa de verdadeiros positivos (revocação, eixo \(y\)) contra a taxa de falsos positivos (\(1 -\) especificidade, eixo \(x\)) à medida que \(t\) varia de \(+\infty\) a \(-\infty\) (Fawcett 2006). A curva vai de \((0, 0)\) (nada é classificado como positivo) a \((1, 1)\) (tudo é positivo). Um classificador aleatório produz a diagonal; um classificador perfeito passa pelo canto \((0, 1)\).
A área sob a curva ROC (AUC) resume a curva em um número entre 0 e 1 e tem uma interpretação probabilística elegante: é a probabilidade de que um positivo sorteado ao acaso receba escore maior do que um negativo sorteado ao acaso,
\[ \text{AUC} = P\big(\hat{s}(X^+) > \hat{s}(X^-)\big), \]
(com empates contando 1/2), o que a relaciona à estatística de Mann–Whitney. AUC = 0,5 corresponde ao acaso e AUC = 1 à separação perfeita. A AUC não depende do limiar nem da proporção de classes, avaliando apenas a capacidade do modelo de ordenar positivos acima de negativos.
Seis observações de teste receberam os escores abaixo (P = positivo, N = negativo), já ordenados do maior para o menor:
| Escore | 0,9 | 0,8 | 0,7 | 0,4 | 0,3 | 0,2 |
|---|---|---|---|---|---|---|
| Classe real | P | P | N | P | N | N |
Há 3 positivos e 3 negativos. Baixando o limiar de escore em escore, cada positivo acrescenta \(1/3\) à TVP e cada negativo acrescenta \(1/3\) à TFP. Os pontos (TFP, TVP) são:
\[ (0, 0) \to (0, \tfrac{1}{3}) \to (0, \tfrac{2}{3}) \to (\tfrac{1}{3}, \tfrac{2}{3}) \to (\tfrac{1}{3}, 1) \to (\tfrac{2}{3}, 1) \to (1, 1). \]
Área (trapézios): de TFP \(= 0\) a \(1/3\) a curva está na altura \(2/3\) (área \(2/9\)); de \(1/3\) a \(1\), na altura \(1\) (área \(6/9\)). Total: AUC \(= 8/9 \approx 0{,}889\).
Interpretação por pares: há \(3 \times 3 = 9\) pares (positivo, negativo). O positivo 0,9 supera os três negativos; o 0,8 também; o 0,4 supera 0,3 e 0,2, mas não 0,7. São \(3 + 3 + 2 = 8\) pares corretamente ordenados: AUC \(= 8/9\), como esperado.
10.13.2 Curva Precisão-Revocação
A curva precisão-revocação (PR) mostra a precisão (eixo \(y\)) contra a revocação (eixo \(x\)) para todos os limiares. Diferentemente da curva ROC, cuja linha de base (classificador aleatório) é sempre a diagonal, a linha de base da curva PR é uma reta horizontal na altura da prevalência \(\pi = P(Y = 1)\): um classificador aleatório tem precisão igual à proporção de positivos, qualquer que seja o limiar.
A curva PR costuma ser resumida pela precisão média (average precision, AP). Ordenando as observações pelo escore e denotando por \(P_k\) e \(R_k\) a precisão e a revocação quando as \(k\) primeiras são classificadas como positivas, \[ \text{AP} = \sum_{k} (R_k - R_{k-1})\,P_k, \] isto é, a média das precisões nos pontos em que a revocação aumenta (a cada positivo encontrado). Davis e Goadrich (2006) mostraram que existe uma correspondência um a um entre curvas ROC e PR para um mesmo conjunto de dados, e que uma curva domina outra no espaço ROC se, e somente se, a domina no espaço PR; ainda assim, as duas enfatizam aspectos diferentes do desempenho, e a interpolação linear entre pontos, válida no espaço ROC, não é válida no espaço PR.
Retome as seis observações do exemplo da curva ROC (escores \(0{,}9; 0{,}8; 0{,}7; 0{,}4; 0{,}3; 0{,}2\) com classes P, P, N, P, N, N). Classificando como positivas as \(k\) primeiras:
| \(k\) | Classe da \(k\)-ésima | VP | Precisão \(P_k\) | Revocação \(R_k\) |
|---|---|---|---|---|
| 1 | P | 1 | \(1/1 = 1{,}000\) | \(1/3\) |
| 2 | P | 2 | \(2/2 = 1{,}000\) | \(2/3\) |
| 3 | N | 2 | \(2/3 \approx 0{,}667\) | \(2/3\) |
| 4 | P | 3 | \(3/4 = 0{,}750\) | \(1\) |
| 5 | N | 3 | \(3/5 = 0{,}600\) | \(1\) |
| 6 | N | 3 | \(3/6 = 0{,}500\) | \(1\) |
A revocação aumenta apenas em \(k = 1, 2, 4\), cada vez em \(1/3\). Logo, \[ \text{AP} = \tfrac{1}{3}(1) + \tfrac{1}{3}(1) + \tfrac{1}{3}(0{,}75) = \tfrac{2{,}75}{3} \approx 0{,}917. \] A linha de base é a prevalência, \(3/6 = 0{,}5\).
A diferença entre as curvas fica evidente com classes muito desbalanceadas. No exemplo abaixo, com 2% de positivos, a AUC-ROC é alta, mas a AP é modesta: o modelo ordena bem a maioria dos pares, mas, entre as observações com escores altos, ainda há muitos negativos, porque eles são muito numerosos.
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (roc_auc_score, average_precision_score,
                             PrecisionRecallDisplay)

X, y = make_classification(n_samples=10000, weights=[0.98, 0.02],
                           flip_y=0, random_state=3)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.5,
                                          stratify=y, random_state=0)
prob = LogisticRegression(max_iter=1000).fit(X_tr, y_tr).predict_proba(X_te)[:, 1]

print(f"AUC-ROC     = {roc_auc_score(y_te, prob):.3f}")
print(f"AP          = {average_precision_score(y_te, prob):.3f}")
print(f"Prevalência = {y_te.mean():.3f}")
#> AUC-ROC     = 0.963
#> AP          = 0.291
#> Prevalência = 0.020
PrecisionRecallDisplay.from_predictions(y_te, prob)
Uma AP de 0,291 é cerca de 15 vezes a linha de base (0,020), o que indica um modelo útil, mas mostra que, em uma lista de alertas, a maioria ainda seria de falsos positivos. A AUC-ROC de 0,963, sozinha, daria uma impressão excessivamente otimista para quem vai lidar com esses alertas.
10.13.3 Calibração de Probabilidades
Um classificador probabilístico é calibrado se, entre todas as observações às quais ele atribui probabilidade \(p\), a proporção de positivos é de fato \(p\): \[ P\big(Y = 1 \mid \hat{p}(X) = p\big) = p \quad \text{para todo } p \in [0, 1]. \] Se um modelo de previsão de chuva diz “70%” em 100 dias, deve chover em cerca de 70 deles. Discriminação (capacidade de ordenar, medida pela AUC) e calibração são propriedades distintas: multiplicar todos os escores por 0,5 não altera a AUC, mas destrói a calibração. Probabilidades calibradas são essenciais sempre que a probabilidade é usada como número — para calcular custos esperados, escolher limiares pela fórmula \(t^* = c_{FP}/(c_{FP} + c_{FN})\) ou comunicar riscos a pacientes.
Escore de Brier. A medida mais usada da qualidade de probabilidades é o escore de Brier (Brier 1950), o erro quadrático médio das probabilidades: \[ \text{BS} = \frac{1}{n}\sum_{i=1}^{n} (\hat{p}_i - y_i)^2 \in [0, 1]. \] Quanto menor, melhor. Como vimos, ele é uma regra de pontuação própria. Para avaliar se o escore é bom, compara-se com o de uma previsão de referência que sempre prevê a prevalência \(\bar{y}\), cujo escore é \(\bar{y}(1 - \bar{y})\); o escore de habilidade de Brier é \(\text{BSS} = 1 - \text{BS}/\text{BS}_{\text{ref}}\).
Diagrama de confiabilidade. Agrupam-se as previsões em faixas (por exemplo, decis de \(\hat{p}\)) e, em cada faixa, compara-se a probabilidade média prevista com a frequência observada de positivos. Um modelo calibrado tem pontos sobre a diagonal; pontos abaixo da diagonal indicam superconfiança nas previsões altas (o modelo diz 90%, mas só 70% são positivos).
Oito observações receberam as probabilidades e têm as classes:
| \(\hat{p}_i\) | 0,9 | 0,8 | 0,7 | 0,6 | 0,4 | 0,3 | 0,2 | 0,1 |
|---|---|---|---|---|---|---|---|---|
| \(y_i\) | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| \((\hat{p}_i - y_i)^2\) | 0,01 | 0,04 | 0,49 | 0,16 | 0,16 | 0,49 | 0,04 | 0,01 |
A soma dos quadrados é 1,40 e \(\text{BS} = 1{,}40/8 = 0{,}175\). A prevalência é \(\bar{y} = 4/8 = 0{,}5\), logo \(\text{BS}_{\text{ref}} = 0{,}5 \times 0{,}5 = 0{,}25\) e \(\text{BSS} = 1 - 0{,}175/0{,}25 = 0{,}30\): o modelo é 30% melhor que prever sempre 50%.
Para a confiabilidade, usamos duas faixas. Na faixa \(\hat{p} < 0{,}5\) (quatro observações), a probabilidade média prevista é \((0{,}4 + 0{,}3 + 0{,}2 + 0{,}1)/4 = 0{,}25\) e a frequência observada é \(1/4 = 0{,}25\). Na faixa \(\hat{p} \ge 0{,}5\), a média prevista é \(0{,}75\) e a frequência observada é \(3/4 = 0{,}75\). Com essa resolução grosseira, o modelo parece perfeitamente calibrado. A log-perda média dessas previsões é aproximadamente 0,511.
Recalibração. Muitos algoritmos produzem escores mal calibrados: o naive Bayes tende a empurrar as probabilidades para 0 e 1; SVMs e boosting produzem escores que não são probabilidades; florestas aleatórias tendem a evitar valores extremos (Niculescu-Mizil e Caruana 2005). Duas técnicas de recalibração, ajustadas em dados não usados no treino do modelo (por validação cruzada ou em um conjunto separado), são as mais comuns:
- Escalonamento de Platt (Platt 1999): ajusta uma regressão logística do rótulo sobre o escore, \(\hat{p}_{\text{cal}} = 1/\big(1 + e^{-(a\,s + b)}\big)\); adequado quando a distorção tem forma sigmoide e há poucos dados.
- Regressão isotônica: ajusta uma função monótona não decrescente qualquer do escore; mais flexível, mas exige mais dados.
Como ambas são transformações monótonas, preservam a ordenação e, portanto, a AUC.
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.linear_model import LogisticRegression
from sklearn.calibration import CalibratedClassifierCV, CalibrationDisplay
from sklearn.metrics import brier_score_loss, log_loss, roc_auc_score
import matplotlib.pyplot as plt

X, y = make_classification(n_samples=20000, n_features=20, n_informative=5,
                           n_redundant=10, random_state=0)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.5, random_state=0)

modelos = {
    "Naive Bayes": GaussianNB(),
    "NB + isotônica": CalibratedClassifierCV(GaussianNB(), method="isotonic", cv=5),
    "Logística": LogisticRegression(max_iter=1000),
}
fig, ax = plt.subplots(figsize=(6, 6))
for nome, m in modelos.items():
    m.fit(X_tr, y_tr)
    p = m.predict_proba(X_te)[:, 1]
    print(f"{nome:15s} Brier = {brier_score_loss(y_te, p):.3f}  "
          f"log-loss = {log_loss(y_te, p):.3f}  AUC = {roc_auc_score(y_te, p):.3f}")
    CalibrationDisplay.from_predictions(y_te, p, n_bins=10, name=nome, ax=ax)
#> Naive Bayes     Brier = 0.070  log-loss = 0.347  AUC = 0.974
#> NB + isotônica  Brier = 0.061  log-loss = 0.206  AUC = 0.974
#> Logística       Brier = 0.050  log-loss = 0.188  AUC = 0.977
A recalibração isotônica reduziu o escore de Brier e, sobretudo, a log-perda do naive Bayes (que pune as probabilidades extremas erradas), sem alterar a AUC. Em R, o pacote probably (do ecossistema tidymodels) oferece funções para diagramas de calibração e recalibração.
10.13.4 Classes Desbalanceadas
Quando uma classe é rara (fraudes, doenças raras, falhas de equipamento), vários cuidados são necessários:
- Métricas: prefira revocação, precisão, F1, acurácia balanceada e a curva precisão-revocação (precision-recall), que é mais informativa que a ROC quando os positivos são raros, pois a precisão é diretamente afetada pelo grande número de negativos;
- Divisão estratificada dos dados e da validação cruzada;
- Ponderação de classes: atribuir maior peso às observações da classe rara na função de perda (
class_weight="balanced"no scikit-learn); - Reamostragem: subamostrar a classe majoritária, sobreamostrar a minoritária ou gerar exemplos sintéticos, como no SMOTE (Chawla et al. 2002) — sempre apenas no conjunto de treino, para não causar vazamento;
- Ajuste do limiar de decisão de acordo com os custos dos erros.
10.13.5 Métricas para Regressão
Para problemas de regressão, as métricas mais usadas — erro médio absoluto (MAE), raiz do erro quadrático médio (RMSE) e coeficiente de determinação (\(R^2\)) — são apresentadas no Capítulo de Modelos de Regressão com Árvores e Florestas. Note que o RMSE é a raiz do risco empírico sob perda quadrática, e o MAE, o risco empírico sob perda absoluta.
10.14 Comparação Estatística de Classificadores
Suponha que dois classificadores A e B tenham acurácias de 90% e 93% no mesmo conjunto de teste. A diferença é real ou pode ser atribuída ao acaso da amostra de teste? Como os dois modelos são avaliados nas mesmas observações, as duas acurácias não são independentes, e um teste para proporções independentes seria inadequado. O teste apropriado é o teste de McNemar (McNemar 1947), recomendado por Dietterich (1998) quando cada algoritmo pode ser treinado apenas uma vez.
10.14.1 O teste de McNemar
Organizam-se as previsões em uma tabela de contingência pareada:
| B acerta | B erra | |
|---|---|---|
| A acerta | \(n_{11}\) | \(n_{10}\) |
| A erra | \(n_{01}\) | \(n_{00}\) |
As células da diagonal (\(n_{11}\) e \(n_{00}\)) não trazem informação sobre qual modelo é melhor: nelas, os dois concordam. Sob a hipótese nula de que os dois classificadores têm a mesma taxa de erro, cada observação discordante tem a mesma probabilidade de favorecer A ou B, isto é, \(n_{10} \sim \text{Binomial}(n_{10} + n_{01},\ 1/2)\). A estatística com correção de continuidade é \[ \chi^2 = \frac{\big(\lvert n_{10} - n_{01} \rvert - 1\big)^2}{n_{10} + n_{01}}, \] que, sob \(H_0\), tem distribuição aproximadamente qui-quadrado com 1 grau de liberdade. Quando \(n_{10} + n_{01}\) é pequeno (digamos, menor que 25), usa-se o teste binomial exato.
Em um conjunto de teste com 500 observações: ambos acertam em 440; A acerta e B erra em \(n_{10} = 10\); A erra e B acerta em \(n_{01} = 25\); ambos erram em 25. As acurácias são \((440 + 10)/500 = 0{,}90\) para A e \((440 + 25)/500 = 0{,}93\) para B. Há \(10 + 25 = 35\) observações discordantes, e \[ \chi^2 = \frac{(\lvert 10 - 25 \rvert - 1)^2}{35} = \frac{196}{35} = 5{,}6, \qquad \text{valor-}p = P(\chi^2_1 > 5{,}6) \approx 0{,}018. \] O teste binomial exato, \(2\,P(\text{Binomial}(35;\ 0{,}5) \le 10)\), dá valor-\(p \approx 0{,}017\). Ao nível de 5%, rejeitamos a hipótese de desempenho igual: há evidência de que B erra menos que A. Observe que toda a informação vem das 35 observações discordantes, e não das 500.
tabela <- matrix(c(440, 25, 10, 25), nrow = 2,
                 dimnames = list(A = c("acerta", "erra"),
                                 B = c("acerta", "erra")))
mcnemar.test(tabela)              # com correção de continuidade
#> McNemar's chi-squared = 5.6, df = 1, p-value = 0.01796
binom.test(10, 35, p = 0.5)       # versão exata
#> p-value = 0.01667
import numpy as np
from statsmodels.stats.contingency_tables import mcnemar
tabela = np.array([[440, 10],
[25, 25]]) # linhas: A acerta/erra; colunas: B acerta/erra
print(mcnemar(tabela, exact=False, correction=True)) # statistic 5.6, pvalue 0.018
print(mcnemar(tabela, exact=True)) # pvalue 0.016710.14.2 Comparações com validação cruzada
É tentador comparar dois algoritmos aplicando um teste \(t\) pareado aos \(k\) erros obtidos nas partes da validação cruzada. Esse procedimento, porém, subestima a variância da diferença: os conjuntos de treino de diferentes partes compartilham a maior parte das observações, de modo que os \(k\) erros não são independentes, e o teste rejeita a hipótese nula com frequência muito maior que o nível nominal (Dietterich 1998). Alternativas propostas incluem o teste 5×2cv de Dietterich (cinco repetições de validação cruzada com 2 partes) e o teste \(t\) com reamostragem corrigida de Nadeau e Bengio (2003), que multiplica a variância estimada por um fator \(\big(\frac{1}{J} + \frac{n_{\text{teste}}}{n_{\text{treino}}}\big)\) em vez de \(\frac{1}{J}\), em que \(J\) é o número de reamostragens. De modo geral, diferenças pequenas entre algoritmos em um único conjunto de dados devem ser interpretadas com cautela, lembrando também do otimismo de seleção discutido na seção sobre validação cruzada aninhada.
10.15 Exemplos Práticos com scikit-learn
O scikit-learn (Pedregosa et al. 2011) é a principal biblioteca de aprendizado de máquina clássico em Python. Sua interface é uniforme: todo estimador possui os métodos fit() (ajusta com dados de treino) e predict() (prevê); transformadores possuem fit() e transform(); e classificadores probabilísticos possuem predict_proba().
10.15.1 Divisão, Pipeline, Validação Cruzada e Busca em Grade
O exemplo a seguir usa o conjunto de dados de câncer de mama de Wisconsin (569 tumores, 30 preditores numéricos, resposta maligno/benigno) e uma regressão logística regularizada:
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import (train_test_split, cross_val_score,
                                     StratifiedKFold, GridSearchCV)
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.metrics import (confusion_matrix, classification_report,
                             roc_auc_score, RocCurveDisplay)

X, y = load_breast_cancer(return_X_y=True)
y = 1 - y   # no dataset, 0 = maligno; recodificamos para 1 = maligno (positivo)

# 1. Divisão estratificada: 75% treino, 25% teste
X_treino, X_teste, y_treino, y_teste = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)

# 2. Pipeline: padronização + modelo (evita vazamento)
pipe = Pipeline([
    ("padronizar", StandardScaler()),
    ("modelo", LogisticRegression(max_iter=5000)),
])

# 3. Validação cruzada estratificada com 10 partes (apenas no treino)
cv = StratifiedKFold(n_splits=10, shuffle=True, random_state=42)
auc_cv = cross_val_score(pipe, X_treino, y_treino, cv=cv, scoring="roc_auc")
print(f"AUC (CV 10-fold): {auc_cv.mean():.3f} ± {auc_cv.std():.3f}")

# 4. Busca em grade do hiperparâmetro de regularização C = 1/lambda
grade = {"modelo__C": [0.001, 0.01, 0.1, 1, 10, 100]}
busca = GridSearchCV(pipe, grade, cv=cv, scoring="roc_auc")
busca.fit(X_treino, y_treino)
print("Melhor C:", busca.best_params_, "AUC CV:", round(busca.best_score_, 3))

# 5. Avaliação final, uma única vez, no conjunto de teste
modelo_final = busca.best_estimator_
y_pred = modelo_final.predict(X_teste)
y_prob = modelo_final.predict_proba(X_teste)[:, 1]

print(confusion_matrix(y_teste, y_pred))
print(classification_report(y_teste, y_pred,
                            target_names=["benigno", "maligno"]))
print("AUC teste:", round(roc_auc_score(y_teste, y_prob), 3))

RocCurveDisplay.from_predictions(y_teste, y_prob)
No scikit-learn, a regressão logística usa penalidade ridge por padrão, e o hiperparâmetro C é o inverso da força de regularização: valores pequenos de C significam regularização forte. A sintaxe "modelo__C" (dois sublinhados) indica o parâmetro C da etapa chamada "modelo" no pipeline.
10.15.2 Variáveis Categóricas com ColumnTransformer
Quando há variáveis numéricas e categóricas, cada grupo recebe um pré-processamento diferente. O exemplo prevê o sexo de pinguins a partir de medidas corporais, da espécie e da ilha:
import seaborn as sns
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split, cross_val_score

penguins = sns.load_dataset("penguins").dropna(subset=["sex"])
X = penguins.drop(columns="sex")
y = (penguins["sex"] == "Female").astype(int)

numericas = ["bill_length_mm", "bill_depth_mm", "flipper_length_mm", "body_mass_g"]
categoricas = ["species", "island"]

preprocessamento = ColumnTransformer([
    ("num", Pipeline([("imputar", SimpleImputer(strategy="median")),
                      ("padronizar", StandardScaler())]), numericas),
    ("cat", OneHotEncoder(drop="first", handle_unknown="ignore"), categoricas),
])

pipe = Pipeline([("prep", preprocessamento),
                 ("modelo", LogisticRegression(max_iter=1000))])

X_treino, X_teste, y_treino, y_teste = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=1
)
print(cross_val_score(pipe, X_treino, y_treino, cv=5, scoring="accuracy").mean())

pipe.fit(X_treino, y_treino)
print("Acurácia no teste:", round(pipe.score(X_teste, y_teste), 3))
O argumento drop="first" evita a armadilha das variáveis dummy, e handle_unknown="ignore" impede erros se uma categoria nova aparecer no teste. Como o imputador e o padronizador estão dentro do pipeline, suas estatísticas são calculadas apenas nos dados de treino de cada iteração.
10.16 Exemplos Práticos com tidymodels e caret em R
No R, o ecossistema tidymodels (Kuhn e Silge 2022) organiza a modelagem em pacotes com papéis bem definidos: rsample (divisão e reamostragem), recipes (pré-processamento), parsnip (especificação de modelos), workflows (une receita e modelo), tune (ajuste de hiperparâmetros) e yardstick (métricas).
library(tidymodels)
library(palmerpenguins)

dados <- penguins |>
  filter(!is.na(sex)) |>
  select(-year)

set.seed(42)

# 1. Divisão estratificada
divisao <- initial_split(dados, prop = 0.75, strata = sex)
treino  <- training(divisao)
teste   <- testing(divisao)

# 2. Receita de pré-processamento (estimada apenas no treino)
receita <- recipe(sex ~ ., data = treino) |>
  step_impute_median(all_numeric_predictors()) |>
  step_dummy(all_nominal_predictors()) |>
  step_normalize(all_numeric_predictors())

# 3. Modelo: regressão logística com penalidade lasso a ser ajustada
modelo <- logistic_reg(penalty = tune(), mixture = 1) |>
  set_engine("glmnet")

fluxo <- workflow() |>
  add_recipe(receita) |>
  add_model(modelo)

# 4. Validação cruzada 10-fold estratificada e busca em grade
folds <- vfold_cv(treino, v = 10, strata = sex)
grade <- grid_regular(penalty(range = c(-4, 0)), levels = 20)

ajustes <- tune_grid(
  fluxo,
  resamples = folds,
  grid      = grade,
  metrics   = metric_set(roc_auc, accuracy)
)

show_best(ajustes, metric = "roc_auc", n = 5)
melhor <- select_by_one_std_err(ajustes, desc(penalty), metric = "roc_auc")

# 5. Ajuste final no treino completo e avaliação única no teste
fluxo_final <- finalize_workflow(fluxo, melhor)
resultado   <- last_fit(fluxo_final, divisao,
                        metrics = metric_set(roc_auc, accuracy, sens, spec))
collect_metrics(resultado)

# Matriz de confusão e curva ROC no teste
previsoes <- collect_predictions(resultado)
conf_mat(previsoes, truth = sex, estimate = .pred_class)
roc_curve(previsoes, truth = sex, .pred_female) |> autoplot()
Observe três detalhes: (i) a função penalty() define a grade em escala \(\log_{10}\), de \(10^{-4}\) a \(10^0\); (ii) select_by_one_std_err() implementa a regra de um erro padrão, preferindo o modelo mais regularizado (desc(penalty)) entre os estatisticamente equivalentes ao melhor; (iii) no yardstick, o primeiro nível do fator resposta (female) é tratado como a classe de interesse por padrão, por isso a curva ROC usa a coluna .pred_female.
O pacote caret (Kuhn 2008), predecessor do tidymodels, ainda é muito utilizado e oferece uma interface compacta por meio da função train():
library(caret)
library(palmerpenguins)

dados <- na.omit(penguins)

set.seed(42)
idx    <- createDataPartition(dados$sex, p = 0.75, list = FALSE)
treino <- dados[idx, ]
teste  <- dados[-idx, ]

controle <- trainControl(method = "repeatedcv", number = 10, repeats = 3,
                         classProbs = TRUE, summaryFunction = twoClassSummary)

ajuste_knn <- train(
  sex ~ bill_length_mm + bill_depth_mm + flipper_length_mm + body_mass_g + species,
  data       = treino,
  method     = "knn",
  preProcess = c("center", "scale"),
  tuneGrid   = data.frame(k = seq(1, 31, by = 2)),
  trControl  = controle,
  metric     = "ROC"
)

ajuste_knn            # ROC, sensibilidade e especificidade para cada k
plot(ajuste_knn)      # desempenho de validação cruzada em função de k

pred <- predict(ajuste_knn, newdata = teste)
confusionMatrix(pred, teste$sex)
O gráfico de desempenho em função de \(k\) ilustra concretamente o dilema viés-variância: \(k = 1\) (variância alta) e \(k\) muito grande (viés alto) têm desempenho inferior ao de valores intermediários. O argumento preProcess garante que a padronização seja reestimada em cada partição da validação cruzada.
10.17 Resumo do Capítulo
- Aprendizado de máquina é o estudo de algoritmos que melhoram seu desempenho \(P\) em uma tarefa \(T\) com a experiência \(E\) (Mitchell); divide-se em supervisionado, não supervisionado e por reforço.
- No aprendizado supervisionado, \(Y = f(X) + \varepsilon\); escolhemos uma função de perda e buscamos minimizar o risco esperado. Sob perda quadrática, a função ótima é \(\mathbb{E}[Y \mid X]\); sob perda 0-1, o classificador de Bayes.
- Como a distribuição é desconhecida, minimizamos o risco empírico (ERM), que é uma estimativa otimista do erro de generalização.
- Predição e inferência são objetivos distintos; métodos paramétricos e não paramétricos diferem nas suposições sobre \(f\).
- O erro esperado de previsão se decompõe em variância + viés² + erro irredutível; complexidade crescente reduz o viés e aumenta a variância.
- A divisão treino/validação/teste e a validação cruzada (\(k\)-fold, LOOCV) estimam o erro de generalização e permitem escolher hiperparâmetros (busca em grade ou aleatória).
- Regularização (ridge, lasso) troca um pouco de viés por uma grande redução de variância.
- Todo pré-processamento deve ser ajustado apenas no treino; pipelines evitam o vazamento de dados.
- A avaliação de classificadores exige a matriz de confusão e métricas como precisão, revocação, especificidade, F1, acurácia balanceada, curva ROC e AUC — sobretudo com classes desbalanceadas.
- As perdas quadrática, absoluta e logarítmica correspondem à máxima verossimilhança sob erros normais, de Laplace e respostas de Bernoulli; perdas logarítmica e de Brier são regras de pontuação próprias.
- O erro de Bayes é o limite inferior do erro de classificação; o limiar de decisão ótimo se desloca com as probabilidades a priori das classes e, com custos assimétricos, a regra de Bayes prevê positivo quando \(P(Y = 1 \mid X = x) > t^* = c_{FP}/(c_{FP} + c_{FN})\).
- A desigualdade de Hoeffding e a cota da união dão limites de generalização da forma \(R \le \hat{R}_n + \sqrt{(\ln\lvert\mathcal{H}\rvert + \ln(2/\delta))/(2n)}\); para classes infinitas, a complexidade é medida pela dimensão VC, e uma classe é PAC-aprendível se e somente se sua dimensão VC é finita.
- O excesso de risco divide-se em erro de aproximação e erro de estimação; o teorema “não há almoço grátis” mostra que nenhum algoritmo é universalmente superior: todo aprendizado depende de um viés indutivo.
- O gradiente descendente converge para \(0 < \eta < 2/L\) em problemas quadráticos; o SGD usa gradientes de lotes e taxas decrescentes (condições de Robbins–Monro).
- A maldição da dimensionalidade torna as vizinhanças não locais (\(e_p(r) = r^{1/p}\)) e concentra as distâncias.
- O melhor erro de validação cruzada após uma busca é otimista; a validação cruzada aninhada avalia o procedimento completo. Os estimadores bootstrap .632 e .632+ combinam o erro de treino e o erro fora da amostra.
- A engenharia de atributos (transformações, razões, interações, codificação cíclica) e a codificação pelo alvo suavizada ampliam a classe de funções, mas esta última exige cálculo fora da parte para evitar vazamento.
- A curva precisão-revocação e a precisão média são mais informativas que a ROC com classes raras; calibração, escore de Brier e diagramas de confiabilidade avaliam a qualidade das probabilidades, que podem ser recalibradas por Platt ou regressão isotônica.
- Dois classificadores avaliados no mesmo teste comparam-se pelo teste de McNemar, que usa apenas as observações discordantes; testes \(t\) ingênuos sobre partes da validação cruzada são liberais demais.
10.18 Exercícios Propostos
- (Teórico) Para cada problema, identifique a tarefa \(T\), a experiência \(E\) e a medida de desempenho \(P\) de Mitchell, e classifique-o como regressão, classificação ou não supervisionado: (a) prever o preço de aluguel de apartamentos no Recife; (b) segmentar clientes de um supermercado; (c) identificar transações fraudulentas de cartão de crédito.
- (Teórico) Mostre que, sob perda absoluta \(L(y, \hat{y}) = |y - \hat{y}|\), a previsão ótima em \(X = x\) é a mediana condicional de \(Y\) dado \(X = x\).
- (Teórico) Reproduza a derivação da decomposição viés-variância, justificando cada passo em que um termo cruzado se anula.
- (Cálculo) Considere o estimador \(\hat{\mu}_c = c\bar{X}\) com \(\mu = 1\), \(\sigma^2 = 9\) e \(n = 9\). Calcule o viés, a variância e o EQM em função de \(c\), encontre o \(c\) ótimo e compare o EQM com o da média amostral.
- (Teórico) Explique por que o erro de treino é, em geral, uma estimativa otimista do erro de generalização. Dê um exemplo de modelo com erro de treino zero e péssimo desempenho de teste.
- (Cálculo) Uma validação cruzada 5-fold produziu os RMSE: 3,1; 2,8; 3,4; 3,0; 2,7. Calcule \(\operatorname{CV}_{(5)}\) e o desvio padrão. Discuta as vantagens e desvantagens de usar LOOCV neste problema com \(n = 50.000\).
- (Cálculo) Um detector de fraudes avaliado em 10.000 transações (200 fraudes) obteve VP = 150, FN = 50, FP = 300. Construa a matriz de confusão e calcule acurácia, precisão, revocação, especificidade, F1, \(F_2\) e acurácia balanceada. Compare com o classificador que declara todas as transações legítimas.
- (Cálculo) Para os escores \((0{,}95; 0{,}85; 0{,}80; 0{,}60; 0{,}55; 0{,}40; 0{,}30; 0{,}10)\) com classes reais \((P, N, P, P, N, P, N, N)\), desenhe a curva ROC e calcule a AUC por trapézios e pela contagem de pares.
- (Teórico) Para cada situação, diga se há vazamento de dados e justifique: (a) padronizar todos os dados antes de
train_test_split; (b) incluir a variável “valor do reembolso pago” para prever se um pedido de seguro é fraudulento; (c) ajustar a imputação pela mediana dentro de umPipelineavaliado comcross_val_score; (d) embaralhar aleatoriamente vendas diárias de 2015 a 2024 antes de dividir em treino e teste para prever as vendas de 2025. - (Teórico) Explique a “armadilha das variáveis dummy” usando a matriz de delineamento de uma regressão linear com intercepto e uma variável categórica de três níveis.
- (Prático) Usando o conjunto
load_breast_cancer, compare por validação cruzada 10-fold a AUC da regressão logística, de uma árvore de decisão e do k-NN (com padronização dentro do pipeline). UseGridSearchCVpara escolher a profundidade da árvore e o \(k\) do k-NN. - (Prático) Simule dados com \(y = \sin(2\pi x) + \varepsilon\), \(\varepsilon \sim N(0; 0{,}3^2)\), \(n = 30\). Ajuste polinômios de graus 1 a 15 e faça um gráfico dos erros de treino e de teste (este com um conjunto independente de 1.000 pontos) em função do grau. Identifique as regiões de subajuste e sobreajuste.
- (Prático) Repita o exercício anterior 200 vezes e estime, para os graus 1, 3 e 12, o viés ao quadrado e a variância de \(\hat{f}(0{,}5)\). Verifique numericamente a decomposição viés-variância.
- (Prático) Em R, com tidymodels, ajuste um modelo k-NN (
nearest_neighbor(neighbors = tune())) para prever a espécie dos pinguins, escolhendo \(k\) por validação cruzada. Reporte a matriz de confusão e a acurácia no teste. - (Prático) Crie um conjunto de dados desbalanceado com
sklearn.datasets.make_classification(weights=[0.95, 0.05]). Compare acurácia, F1 e AUC de uma regressão logística com e semclass_weight="balanced"e analise o efeito de variar o limiar de decisão. - (Teórico) Mostre que minimizar a soma dos erros absolutos equivale a maximizar a verossimilhança quando os erros seguem a distribuição de Laplace. Qual modelo probabilístico corresponde à perda quadrática ponderada \(\sum_i w_i (y_i - f(x_i))^2\)?
- (Teórico) Mostre que o escore de Brier é uma regra de pontuação própria, isto é, que \(\mathbb{E}[(p - Y)^2]\), com \(Y \sim \text{Bernoulli}(q)\), é minimizado em \(p = q\). Mostre que a perda absoluta \(\lvert p - Y \rvert\) não é própria (dica: calcule o valor esperado e minimize em \(p\)).
- (Cálculo) Na classe 0, \(X \sim N(0, 1)\); na classe 1, \(X \sim N(3, 1)\). (a) Com \(\pi_0 = \pi_1 = 0{,}5\), encontre o classificador de Bayes e o erro de Bayes. (b) Repita com \(\pi_0 = 0{,}9\). (c) Se o custo de um falso negativo for 5 vezes o de um falso positivo, com \(\pi_0 = 0{,}9\), qual é o novo limiar?
- (Cálculo) Usando a cota para classes finitas, quantas observações são necessárias para garantir, com confiança de 99%, que o erro verdadeiro de todas as \(\lvert\mathcal{H}\rvert = 10^6\) hipóteses esteja a no máximo 0,05 do erro de treino?
- (Teórico) Mostre que a classe dos intervalos fechados \([a, b]\) na reta tem dimensão VC igual a 2. Qual é a dimensão VC da classe das uniões de dois intervalos?
- (Teórico) Explique, com suas palavras, o teorema “não há almoço grátis” e por que ele não contradiz o fato de que alguns algoritmos funcionam melhor que outros em problemas reais.
- (Cálculo) Para os dados \(x = (1, 2, 2, 3)\) e \(y = (1, 3, 2, 5)\), sem intercepto, escreva a iteração do gradiente descendente para \(\hat{R}(\beta) = \frac{1}{2n}\sum_i (y_i - \beta x_i)^2\), determine o intervalo de taxas de aprendizado que garante convergência e faça três iterações à mão com \(\eta = 0{,}1\), partindo de \(\beta = 0\).
- (Cálculo) Calcule a probabilidade de uma observação ficar fora de uma amostra bootstrap para \(n = 5\), \(n = 20\) e \(n = 50\). Para um modelo com erro de treino 0,02 e \(\widehat{\operatorname{Err}}^{(1)} = 0{,}15\), calcule os estimadores .632 e .632+ (com \(\hat{\gamma} = 0{,}5\)).
- (Cálculo) Em um teste com 1.000 observações, os classificadores A e B discordam em 60 casos: A acerta e B erra em 22; A erra e B acerta em 38. Aplique o teste de McNemar (com correção de continuidade) e o teste binomial exato. Há evidência de diferença ao nível de 5%?
- (Cálculo) Para os escores e classes do Exercício 8, construa a curva precisão-revocação e calcule a precisão média. Compare com a linha de base.
- (Cálculo) Para as previsões \(\hat{p} = (0{,}95; 0{,}9; 0{,}9; 0{,}8; 0{,}2; 0{,}1)\) com classes \((1, 0, 1, 0, 0, 0)\), calcule o escore de Brier, o escore de habilidade de Brier e a log-perda média. O modelo parece superconfiante?
- (Prático) Implemente a validação cruzada aninhada para escolher o \(k\) do k-NN no conjunto
load_breast_cancere compare a estimativa aninhada com obest_score_doGridSearchCV. Repita com uma grade de 50 valores de \(k\) e discuta o otimismo. - (Prático) Simule pontos uniformes em \([0,1]^p\) para \(p = 2, 10, 100\) e \(1.000\), com \(n = 500\). Para cada \(p\), calcule a razão entre a maior e a menor distância de um ponto aos demais e faça um gráfico da razão contra \(p\). Relacione com a maldição da dimensionalidade.
- (Prático) Implemente a codificação pelo alvo suavizada, calculada fora da parte (out-of-fold), para uma variável com 200 categorias simuladas sem relação com a resposta. Compare a acurácia de validação cruzada obtida com a codificação ingênua (calculada com todos os dados) e com a versão fora da parte.
- (Prático) Ajuste uma floresta aleatória e uma regressão logística a um conjunto de dados de sua escolha, desenhe os diagramas de confiabilidade e aplique a recalibração de Platt e a isotônica à floresta. Reporte o escore de Brier e a AUC antes e depois.
10.19 Leituras Recomendadas
- James et al. (2013) — An Introduction to Statistical Learning, a principal referência introdutória para os conceitos deste capítulo (capítulos 2, 5 e 6).
- Hastie, Tibshirani, e Friedman (2009) — The Elements of Statistical Learning, tratamento mais aprofundado e matemático; o capítulo 7 é a referência sobre avaliação e seleção de modelos.
- Mitchell (1997) — livro clássico de aprendizado de máquina, de onde vem a definição \(T\), \(E\), \(P\).
- Breiman (2001) — o ensaio sobre as “duas culturas” da modelagem estatística, leitura obrigatória para estatísticos.
- Vapnik (1995) — fundamentos teóricos da minimização do risco empírico e da teoria do aprendizado estatístico.
- Geman, Bienenstock, e Doursat (1992) — artigo clássico que popularizou o dilema viés-variância no aprendizado de máquina.
- Kohavi (1995) — estudo empírico sobre validação cruzada e bootstrap para estimação de desempenho.
- Fawcett (2006) — introdução detalhada e acessível à análise ROC.
- Kaufman et al. (2012) — formalização e exemplos reais de vazamento de dados.
- Kuhn e Silge (2022) — Tidy Modeling with R, guia completo do ecossistema tidymodels.
- Pedregosa et al. (2011) — artigo de apresentação do scikit-learn; a documentação oficial (https://scikit-learn.org/) contém excelentes guias do usuário.
- Shalev-Shwartz e Ben-David (2014) — Understanding Machine Learning: introdução rigorosa e acessível à teoria PAC, à dimensão VC e ao teorema “não há almoço grátis”.
- Valiant (1984) e Vapnik e Chervonenkis (1971) — os artigos fundadores do modelo PAC e da teoria da convergência uniforme.
- Wolpert (1996) — o teorema “não há almoço grátis” para o aprendizado supervisionado.
- Bottou, Curtis, e Nocedal (2018) — revisão abrangente sobre o gradiente descendente estocástico e métodos de otimização em aprendizado de máquina.
- Efron (1983) e Efron e Tibshirani (1997) — os estimadores bootstrap .632 e .632+ do erro de previsão.
- Varma e Simon (2006) e Cawley e Talbot (2010) — o viés de seleção na validação cruzada e a necessidade da validação aninhada.
- Gneiting e Raftery (2007) — teoria das regras de pontuação próprias.
- Niculescu-Mizil e Caruana (2005) — estudo empírico sobre a calibração de diferentes algoritmos e os métodos de Platt e isotônico.
- Davis e Goadrich (2006) — relação entre as curvas ROC e precisão-revocação.
- Dietterich (1998) — testes estatísticos para comparar algoritmos de classificação, incluindo McNemar e 5×2cv.
- Micci-Barreca (2001) — a proposta original da codificação pelo alvo com suavização.