7 Visualização de Dados com ggplot2
O pacote ggplot2 revolucionou a visualização de dados utilizando a Gramática dos Gráficos. Neste capítulo, estudamos como criar visualizações de dados profissionais e customizadas, compreendendo não apenas como escrever o código, mas por que cada componente do gráfico existe e quais decisões estatísticas estão escondidas por trás de cada camada — da escolha do número de classes de um histograma à largura de banda de uma densidade por kernel.
7.1 A Filosofia da Gramática dos Gráficos
O pacote ggplot2 (https://ggplot2.tidyverse.org/), desenvolvido por Hadley Wickham para a linguagem R (Wickham 2016), é um sistema focado na criação declarativa de gráficos baseado em um arcabouço conceitual sólido chamado A Gramática dos Gráficos (proposto originalmente pelo estatístico Leland Wilkinson (Wilkinson 2005)). A ideia central é simples e elegante: você fornece os dados, informa ao pacote como mapear as variáveis para os atributos estéticos, define as primitivas gráficas, e ele cuida de todos os detalhes de renderização subjacentes. Qualquer gráfico complexo pode ser construído a partir de uma combinação sistemática de camadas declarativas independentes.
Em vez de usar comandos monolíticos e rígidos (onde você precisa chamar uma função diferente para cada variação de gráfico, como ocorria nos gráficos base do R), o ggplot2 permite que você “monte” a sua visualização iterativamente, adicionando camadas de dados, representações geométricas, escalas de cores e elementos temáticos utilizando o operador de soma (+).
Nota para usuários de Python: Existe uma versão amplamente utilizada que porta a gramática dos gráficos para o ecossistema Python chamada plotnine (https://plotnine.org/).
7.1.1 Contexto Histórico
A ideia de que gráficos estatísticos possuem uma gramática — isto é, um conjunto de regras formais que combinam elementos básicos para produzir infinitas “frases” visuais — foi sistematizada por Leland Wilkinson no livro The Grammar of Graphics, cuja primeira edição é de 1999 e a segunda, ampliada, de 2005 (Wilkinson 2005). Wilkinson buscava uma especificação abstrata, independente de software, capaz de descrever qualquer gráfico estatístico como a composição de objetos matemáticos (conjuntos de dados, transformações, escalas, sistemas de coordenadas e elementos geométricos).
Hadley Wickham, então doutorando na Iowa State University, implementou e adaptou essas ideias para o R. O ggplot2 foi lançado em 2007 e, em 2010, Wickham publicou o artigo A Layered Grammar of Graphics (Wickham 2010), no qual reformula a proposta de Wilkinson em termos de camadas (layers): cada camada contém dados, mapeamento estético, uma transformação estatística, um objeto geométrico e um ajuste de posição. Essa reformulação é a base conceitual do pacote até hoje e também influenciou outras ferramentas (como o plotnine em Python, o Vega-Lite e o Tableau).
Antes dessa abordagem, a visualização no R era feita principalmente pelo sistema gráfico base (plot(), hist(), boxplot()) e pelo pacote lattice. O sistema base segue a metáfora da “caneta e papel”: cada comando desenha imediatamente sobre o dispositivo gráfico, e não existe um objeto que represente o gráfico como um todo. No ggplot2, ao contrário, um gráfico é um objeto do R que pode ser armazenado em uma variável, modificado, combinado e impresso posteriormente.
7.1.2 O Gráfico como uma Composição de Funções
Uma maneira útil (e rigorosa) de pensar a gramática é enxergar a construção de um gráfico como uma sequência de transformações aplicadas a um conjunto de dados \(\mathcal{D}\):
\[ \text{gráfico} = \underbrace{\text{tema}}_{\text{aparência}} \circ \underbrace{\text{coord}}_{\text{espaço}} \circ \underbrace{\text{faceta}}_{\text{partição}} \circ \underbrace{\text{escala}}_{\text{dado} \to \text{estética}} \circ \underbrace{\text{geom}}_{\text{forma}} \circ \underbrace{\text{stat}}_{\text{resumo}} \,(\mathcal{D}) \]
Em palavras: os dados são (opcionalmente) resumidos por uma transformação estatística; o resultado é representado por objetos geométricos; as escalas traduzem os valores dos dados em valores visuais (posições em pixels, cores, tamanhos); as facetas particionam o conjunto em subconjuntos exibidos em painéis distintos; o sistema de coordenadas define como as posições são projetadas no plano; e, finalmente, o tema controla os elementos que não dependem dos dados. Essa visão explica por que é possível trocar apenas uma das peças (por exemplo, o sistema de coordenadas cartesiano pelo polar) sem reescrever todo o gráfico.
7.2 Os Componentes da Gramática de Gráficos
Um gráfico no ggplot2 é composto por sete componentes ou camadas essenciais:
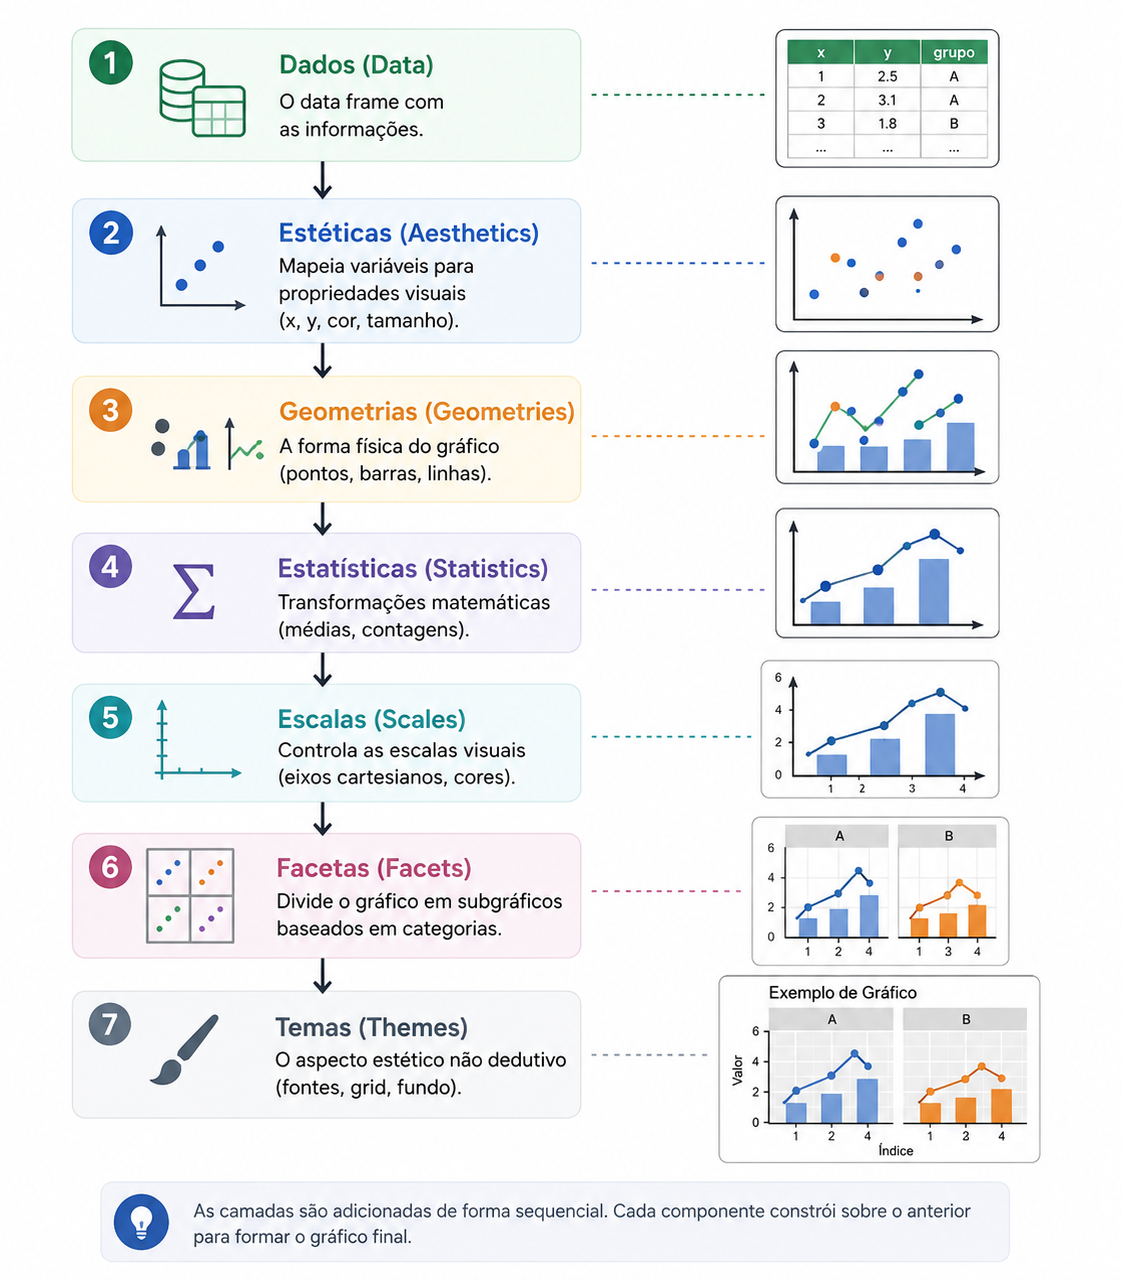
- Dados (Data): O conjunto de dados bruto (preferencialmente estruturado na forma de um data frame limpo ou tidy data).
- Mapeamento Estético (Aesthetics / aes): Define quais variáveis do seu conjunto de dados serão mapeadas para propriedades visuais do gráfico, como a posição no eixo horizontal (
x), no eixo vertical (y), a cor das linhas ou pontos (color), o preenchimento de áreas (fill), o formato dos pontos (shape) ou o tamanho (size). - Geometrias (Geoms): Definem o tipo físico de representação do gráfico. Exemplos comuns:
geom_point(): Gráfico de dispersão (pontos).geom_line(): Gráficos de séries temporais ou conexões (linhas).geom_bar()ougeom_col(): Gráficos de barras.geom_boxplot(): Diagrama de caixa para distribuição e outliers.geom_histogram(): Gráfico de frequência de variáveis contínuas.
- Transformações Estatísticas (Stats): Descrevem como os dados serão resumidos ou transformados matematicamente antes da plotagem (ex: calcular médias ou contar ocorrências em classes no histograma).
- Escalas (Scales): Controlam a correspondência lógica entre o dado e o espaço visual (ex: mapear de forma logarítmica ou usar paletas de cores específicas).
- Facetas (Facets): Permitem dividir um único gráfico em múltiplos subgráficos baseados em colunas categóricas dos dados, facilitando comparações.
- Temas (Themes): Controlam a aparência não relacionada aos dados, como cores de fundo do gráfico, estilos e tamanhos das fontes do título, presença ou ausência de linhas de grade.
Além desses sete, dois outros elementos aparecem em praticamente todo gráfico e merecem destaque: os sistemas de coordenadas (coordinate systems, funções coord_*()) e os ajustes de posição (position adjustments, argumento position). O “molde” geral de qualquer gráfico pode ser escrito como:
ggplot(data = <DADOS>, mapping = aes(<MAPEAMENTOS>)) +
  <GEOM_FUNCAO>(
    mapping  = aes(<MAPEAMENTOS>),
    stat     = <STAT>,
    position = <POSICAO>
  ) +
  <ESCALA_FUNCAO>() +
  <COORD_FUNCAO>() +
  <FACETA_FUNCAO>() +
  <TEMA_FUNCAO>()
Na prática, a maior parte desses argumentos possui valores padrão sensatos, e um gráfico funcional exige apenas três ingredientes: dados, mapeamento e ao menos um geom. Nas subseções a seguir detalhamos cada componente.
7.2.1 Dados no Formato Arrumado (Tidy Data)
O ggplot2 foi projetado para trabalhar com dados no formato arrumado (tidy data), conceito formalizado por Wickham (2014) e discutido em detalhe no Capítulo de Análise Exploratória de Dados com Python: cada variável em uma coluna, cada observação em uma linha e cada valor em uma célula. O motivo é estrutural: um mapeamento estético associa uma coluna a uma propriedade visual. Se a informação que desejamos mapear para a cor está espalhada em várias colunas, não há uma coluna única para mapear.
Considere uma tabela “larga” (wide) com o número de vendas por ano:
library(ggplot2)
library(dplyr)
library(tidyr)

vendas_largo <- tibble(
  loja   = c("Centro", "Boa Viagem", "Casa Forte"),
  `2022` = c(120, 150, 90),
  `2023` = c(135, 160, 110),
  `2024` = c(150, 155, 130)
)

# Convertendo para o formato longo (tidy): uma linha por loja-ano
vendas_longo <- vendas_largo |>
  pivot_longer(cols = c(`2022`, `2023`, `2024`),
               names_to = "ano", values_to = "vendas") |>
  mutate(ano = as.integer(ano))

vendas_longo
#> # A tibble: 9 × 3
#>   loja         ano vendas
#>   <chr>      <int>  <dbl>
#> 1 Centro      2022    120
#> 2 Centro      2023    135
#> ...

ggplot(vendas_longo, aes(x = ano, y = vendas, color = loja)) +
  geom_line(linewidth = 1) +
  geom_point(size = 2)
No formato longo, a coluna loja pode ser mapeada diretamente para a cor, e o ggplot2 cria automaticamente uma linha por loja e a respectiva legenda.
7.2.2 Mapeamentos Estéticos: Variável versus Atributo Fixo
Um mapeamento estético é uma função que associa os valores de uma variável a valores de uma propriedade visual. Formalmente, se \(V\) é o domínio de uma variável (por exemplo, \(V = \{\text{4}, \text{f}, \text{r}\}\) para o tipo de tração) e \(A\) é o conjunto de valores de um atributo visual (por exemplo, um conjunto de cores), o mapeamento é uma função \(m: V \to A\), e é a escala quem escolhe concretamente essa função.
Os atributos estéticos mais comuns são:
| Estética | Significado | Tipo de variável adequada |
|---|---|---|
x, y |
Posição horizontal e vertical | Qualquer |
color / colour |
Cor de contorno de pontos e linhas | Categórica ou contínua |
fill |
Cor de preenchimento de áreas | Categórica ou contínua |
size |
Tamanho de pontos | Contínua (preferencialmente) |
alpha |
Transparência (0 a 1) | Contínua |
shape |
Formato do ponto | Categórica (até cerca de 6 níveis) |
linetype |
Tipo de linha (sólida, tracejada…) | Categórica |
group |
Agrupamento sem efeito visual direto | Categórica |
É fundamental distinguir entre mapear uma estética (o valor visual depende de uma variável, por isso fica dentro de aes()) e fixar um atributo (o valor visual é uma constante, por isso fica fora de aes(), como argumento do geom). Um erro clássico de iniciantes é o seguinte:
# ERRADO (conceitualmente): "blue" é tratado como uma variável constante
# com um único nível chamado "blue"; os pontos ficam vermelho-salmão
# e surge uma legenda sem sentido.
ggplot(mpg, aes(x = displ, y = hwy)) +
  geom_point(aes(color = "blue"))

# CORRETO: atributo fixo, fora de aes()
ggplot(mpg, aes(x = displ, y = hwy)) +
  geom_point(color = "blue")

# MAPEAMENTO: a cor depende da variável 'class'
ggplot(mpg, aes(x = displ, y = hwy)) +
  geom_point(aes(color = class))
Mapeamentos declarados em ggplot() são herdados por todas as camadas; mapeamentos declarados dentro de um geom valem apenas para aquela camada. Isso permite, por exemplo, colorir os pontos por classe e, ao mesmo tempo, ajustar uma única curva de tendência para todos os dados:
ggplot(mpg, aes(x = displ, y = hwy)) +
  geom_point(aes(color = class)) +               # cor apenas nos pontos
  geom_smooth(method = "loess", formula = y ~ x) # uma única curva global
7.2.3 Geometrias (Geoms)
O geom determina como as observações são desenhadas. A tabela a seguir organiza os geoms mais usados de acordo com a natureza dos dados representados:
| Situação | Geoms típicos |
|---|---|
| Uma variável contínua | geom_histogram(), geom_density(), geom_freqpoly(), geom_boxplot(), geom_violin() |
| Uma variável discreta | geom_bar() |
| Duas contínuas | geom_point(), geom_smooth(), geom_bin2d(), geom_hex(), geom_density_2d() |
| Contínua vs. discreta | geom_boxplot(), geom_violin(), geom_jitter(), geom_col() |
| Duas discretas | geom_count(), geom_tile() |
| Série temporal | geom_line(), geom_area(), geom_step() |
| Referências e anotações | geom_hline(), geom_vline(), geom_abline(), geom_text(), geom_label() |
| Incerteza | geom_errorbar(), geom_pointrange(), geom_ribbon() |
Cada geom compreende um subconjunto de estéticas: geom_point() aceita shape, mas não linetype; geom_line() aceita linetype, mas não shape. A documentação de cada função (por exemplo, ?geom_point) lista as estéticas obrigatórias (em negrito) e opcionais.
7.2.4 Transformações Estatísticas (Stats)
Muitos gráficos não exibem os dados brutos, mas sim um resumo deles. Um gráfico de barras exibe contagens; um histograma exibe frequências em intervalos; um boxplot exibe quartis; uma curva suavizada exibe as previsões de um modelo. Esses resumos são calculados pelas funções stat_*().
Todo geom possui um stat padrão e todo stat possui um geom padrão. Por exemplo, geom_bar() usa stat = "count" e geom_histogram() usa stat = "bin". Por isso, os dois comandos abaixo produzem o mesmo gráfico:
ggplot(diamonds, aes(x = cut)) + geom_bar()
ggplot(diamonds, aes(x = cut)) + stat_count()
O stat cria variáveis computadas que podem ser acessadas com after_stat(). O stat_count(), por exemplo, calcula count (contagem) e prop (proporção dentro do grupo). Para exibir proporções em vez de contagens:
ggplot(diamonds, aes(x = cut, y = after_stat(prop), group = 1)) +
  geom_bar() +
  labs(y = "Proporção")
O argumento group = 1 é necessário porque, por padrão, cada nível de cut forma um grupo próprio e a proporção dentro de cada grupo seria sempre 1.
Também podemos resumir uma variável numérica por grupo com stat_summary(). O exemplo abaixo exibe, para cada classe de veículo, a média do consumo na rodovia e o intervalo média \(\pm\) um erro padrão, \(\bar{y} \pm s/\sqrt{n}\):
ggplot(mpg, aes(x = class, y = hwy)) +
  stat_summary(fun.data = mean_se, geom = "pointrange") +
  labs(x = "Classe", y = "Consumo médio na rodovia (mpg)")
7.2.5 Ajustes de Posição (Position Adjustments)
Quando vários elementos ocupariam o mesmo lugar no gráfico, o ajuste de posição decide como resolver a sobreposição. Os principais são:
position = "stack"(padrão degeom_bar()): empilha as barras;position = "dodge": coloca as barras lado a lado;position = "fill": empilha e normaliza a altura total para 1, exibindo proporções condicionais;position = "jitter": adiciona um pequeno ruído aleatório aos pontos, útil quando há muitos valores repetidos (equivalente ageom_jitter());position = "identity": não altera a posição (útil com transparência).
base <- ggplot(diamonds, aes(x = cut, fill = clarity))

base + geom_bar()                     # empilhado: contagens totais
base + geom_bar(position = "dodge")   # lado a lado: compara contagens
base + geom_bar(position = "fill") +  # proporções condicionais P(clarity | cut)
  labs(y = "Proporção")
Note que a escolha do ajuste muda a pergunta respondida pelo gráfico: o empilhado responde “quantos diamantes há em cada corte?”, o lado a lado responde “como as clarezas se comparam em cada corte?” e o preenchido responde “qual a distribuição condicional da clareza dado o corte?”.
7.2.6 Escalas (Scales)
A escala é a função que traduz valores dos dados em valores estéticos, e também é responsável por desenhar a guia correspondente (eixo ou legenda). Toda estética mapeada possui uma escala, mesmo que não a declaremos explicitamente: o ggplot2 adiciona escalas padrão (scale_x_continuous(), scale_color_discrete() etc.). As funções de escala seguem o padrão scale_<estética>_<tipo>():
# Eixos em escala logarítmica (base 10)
ggplot(diamonds, aes(x = carat, y = price)) +
  geom_point(alpha = 0.1) +
  scale_x_log10() +
  scale_y_log10(labels = scales::label_dollar())

# Limites, quebras e rótulos de um eixo contínuo
ggplot(mpg, aes(x = displ, y = hwy)) +
  geom_point() +
  scale_x_continuous(name = "Cilindrada (L)", breaks = seq(1, 7, by = 1)) +
  scale_y_continuous(name = "Rodovia (mpg)", limits = c(10, 45))
A escala logarítmica merece atenção teórica. Se \(y = a x^b\) (relação de potência, comum entre o peso e o preço de diamantes), então \(\log y = \log a + b \log x\): no gráfico log-log a relação torna-se uma reta de inclinação \(b\). Escalas logarítmicas também são adequadas a variáveis estritamente positivas e assimétricas à direita (renda, preços, populações), pois comprimem a cauda longa.
7.2.6.1 Transformações de Escala: Teoria e Prática
Formalmente, uma transformação de escala é uma função contínua e estritamente monótona \(g\) aplicada aos valores antes de serem posicionados no eixo; as quebras e rótulos continuam sendo exibidos na unidade original (o eixo mostra 1, 10, 100, e não 0, 1, 2). No ggplot2 (versão 3.5 ou superior), qualquer escala contínua aceita o argumento transform (antes chamado trans), e há atalhos como scale_x_log10(), scale_x_sqrt() e scale_x_reverse(). As transformações mais úteis são:
| Transformação | \(g(x)\) | Uso típico |
|---|---|---|
| Logarítmica | \(\log_{10} x\) | Variáveis positivas com cauda longa; relações multiplicativas e de potência |
| Raiz quadrada | \(\sqrt{x}\) | Contagens (estabiliza a variância de dados de Poisson); áreas |
| Recíproca | \(1/x\) | Taxas (por exemplo, de “km por litro” para “litros por km”) |
| Box–Cox | \((x^\lambda - 1)/\lambda\) | Família contínua que interpola entre as anteriores |
| Pseudo-log | \(\operatorname{asinh}(x/2\sigma)\) | Dados com zeros ou negativos e cauda longa |
| Logito | \(\log\frac{p}{1 - p}\) | Proporções em \((0, 1)\) |
A escolha não é arbitrária: um princípio orientador é a estabilização da variância. Se \(\mathrm{Var}(X) \approx v(\mu)\) depende da média \(\mu\), uma expansão de Taylor de primeira ordem (o método delta) dá \(\mathrm{Var}[g(X)] \approx g'(\mu)^2\, v(\mu)\). Escolhendo \(g' \propto 1/\sqrt{v}\), a variância transformada fica aproximadamente constante. Para contagens de Poisson, \(v(\mu) = \mu\) e obtemos \(g(x) = \sqrt{x}\); para variáveis com desvio padrão proporcional à média (coeficiente de variação constante, como preços e rendas), \(v(\mu) \propto \mu^2\) e obtemos \(g(x) = \log x\). A transformação de Box–Cox e sua estimação são discutidas no Capítulo de Análise Exploratória de Dados com Python.
Há duas maneiras de “colocar um eixo em escala log”, e elas não são equivalentes:
scale_y_log10()(ouscale_y_continuous(transform = "log10")) transforma os dados antes do stat. Umgeom_smooth(method = "lm")ajusta então uma reta a \(\log y\), e um boxplot calcula quartis de \(\log y\);coord_transform(y = "log10")(chamadacoord_trans()em versões anteriores do pacote) transforma depois do stat, apenas na hora de desenhar. A reta de regressão é ajustada em \(y\) e aparece curva no gráfico.
Para quantis e medianas o resultado é o mesmo (quantis comutam com transformações monótonas), mas para médias, desvios padrão e regressões não: em geral, \(\mathbb{E}[\log Y] \ne \log \mathbb{E}[Y]\) (pela desigualdade de Jensen, \(\mathbb{E}[\log Y] \le \log \mathbb{E}[Y]\)).
Ajustando por mínimos quadrados a reta \(\log_{10}(\text{price}) = a + b\,\log_{10}(\text{carat})\) aos 53.940 diamantes de diamonds, obtemos \(\hat{a} \approx 3{,}669\) e \(\hat{b} \approx 1{,}676\), com \(R^2 \approx 0{,}933\). Voltando à escala original,
\[ \widehat{\text{price}} \approx 10^{3{,}669}\,\text{carat}^{1{,}676} \approx 4\,669 \cdot \text{carat}^{1{,}676}. \]
O expoente \(b > 1\) tem uma interpretação de elasticidade: um aumento de 1% no peso está associado a um aumento de aproximadamente \(1{,}68\%\) no preço; dobrar o peso multiplica o preço por cerca de \(2^{1{,}676} \approx 3{,}2\). Na escala linear, essa relação aparece como uma nuvem curva e heterocedástica; no gráfico log-log, como uma reta com dispersão aproximadamente constante.
Em R: coef(lm(log10(price) ~ log10(carat), data = diamonds)).
# Lei de potência: reta em escala log-log
ggplot(diamonds, aes(x = carat, y = price)) +
  geom_bin2d(bins = 80) +
  geom_smooth(method = "lm", formula = y ~ x, color = "firebrick") +
  scale_x_log10() +
  scale_y_log10(labels = scales::label_dollar()) +
  scale_fill_viridis_c(transform = "log10")

# Box-Cox com lambda = 0,25 aplicada ao eixo x
ggplot(diamonds, aes(x = price)) +
  geom_histogram(bins = 50) +
  scale_x_continuous(transform = scales::transform_boxcox(p = 0.25))
7.2.6.2 Escalas de Cor
A escolha da paleta de cores deve respeitar a natureza da variável:
- Qualitativa (variáveis nominais): cores de matizes distintos e mesma intensidade —
scale_color_brewer(palette = "Set2"),scale_color_viridis_d(),scale_color_manual(values = c(...)); - Sequencial (variáveis contínuas ou ordinais com um sentido único): gradiente do claro ao escuro —
scale_fill_gradient(),scale_fill_viridis_c(),scale_fill_distiller(palette = "Blues"); - Divergente (variáveis com ponto central significativo, como correlações ou variações em torno de zero): duas cores que se afastam de um centro neutro —
scale_fill_gradient2(midpoint = 0).
As paletas viridis foram desenhadas para serem perceptualmente uniformes (passos iguais nos dados correspondem a passos visualmente iguais) e legíveis por pessoas com daltonismo e em impressões em tons de cinza, sendo uma excelente escolha padrão.
ggplot(mpg, aes(x = displ, y = hwy, color = cty)) +
  geom_point(size = 2) +
  scale_color_viridis_c(name = "Consumo\nna cidade") +
  theme_minimal()

ggplot(mpg, aes(x = displ, y = hwy, color = drv)) +
  geom_point(size = 2) +
  scale_color_manual(
    name   = "Tração",
    values = c("4" = "#1b9e77", "f" = "#d95f02", "r" = "#7570b3"),
    labels = c("4" = "4x4", "f" = "Dianteira", "r" = "Traseira")
  )
7.2.6.3 Teoria das Cores: Espaços de Cor e Percepção
A visão humana de cores é tricromática: a retina possui três tipos de cones, sensíveis a comprimentos de onda longos (L, “vermelho”), médios (M, “verde”) e curtos (S, “azul”). Qualquer cor percebida pode, portanto, ser descrita por três números, mas a escolha desses três números — o espaço de cor — faz enorme diferença para a visualização (Ware 2012).
- RGB (vermelho, verde, azul) é o espaço dos dispositivos: descreve quanta luz cada subpixel do monitor emite. Ele não é perceptualmente uniforme: distâncias iguais no cubo RGB não correspondem a diferenças percebidas iguais. Por exemplo, a luminância relativa (o brilho percebido) de uma cor em sRGB linearizado é aproximadamente \[Y = 0{,}2126\,R + 0{,}7152\,G + 0{,}0722\,B,\] de modo que o amarelo puro \((1, 1, 0)\) tem \(Y \approx 0{,}93\) e o azul puro \((0, 0, 1)\) tem \(Y \approx 0{,}07\): são cores de “intensidade máxima” com brilhos completamente diferentes.
- HSV/HSL (matiz, saturação, valor/luminosidade) são apenas reparametrizações do RGB e herdam sua não uniformidade.
- CIELAB e CIELUV (Comissão Internacional de Iluminação, 1976) foram construídos para que a distância euclidiana aproxime a diferença perceptual. O espaço HCL (hue–chroma–luminance) é o CIELUV em coordenadas polares: \(L\) é a luminância, \(C\) (croma) é a “colorfulness” e \(H\) é o ângulo do matiz. Paletas construídas em HCL permitem controlar separadamente o matiz e o brilho.
A paleta discreta padrão do ggplot2 (scales::hue_pal()) escolhe matizes igualmente espaçados no círculo HCL, mantendo croma e luminância fixos (\(C \approx 100\) e \(L \approx 65\)). É uma escolha teoricamente elegante para variáveis nominais — nenhuma categoria “salta aos olhos” mais que as outras —, mas tem duas consequências: impressa em tons de cinza, a paleta se torna uma única tonalidade (todas as cores têm a mesma luminância), e cores de mesma luminância que diferem apenas no eixo vermelho–verde tornam-se indistinguíveis para pessoas com daltonismo.
Deficiências de visão de cores. A forma mais comum é a deficiência vermelho–verde (protanopia/protanomalia, ausência ou alteração dos cones L; deuteranopia/deuteranomalia, dos cones M), que afeta cerca de 8% dos homens e 0,5% das mulheres de ascendência norte-europeia. Em uma turma de 50 estudantes, é provável que ao menos um deles enxergue mal um gráfico que depende apenas da distinção entre vermelho e verde.
Para três categorias, scales::hue_pal()(3) retorna as cores #F8766D (salmão), #00BA38 (verde) e #619CFF (azul). Convertidas para HCL com o pacote colorspace, todas têm \(L \approx 65\) e matizes de aproximadamente \(15^\circ\), \(131^\circ\) e \(254^\circ\) — um terço do círculo entre cada uma. Simulando a deuteranopia com colorspace::deutan(), as cores tornam-se #B6A86A, #AC9C45 e #5A96FD: as duas primeiras viram dois tons de oliva quase idênticos, e o gráfico perde a distinção entre os grupos “4” e “f”. A solução é usar uma paleta que varie também em luminância, como scale_color_viridis_d() ou scale_color_brewer(palette = "Dark2"), ou reforçar a cor com uma segunda codificação redundante (shape ou linetype).
Por que evitar o arco-íris. Paletas do tipo “arco-íris” (rainbow, jet) foram padrão em muitos softwares por décadas, mas são inadequadas para dados contínuos (Crameri, Shephard, e Heron 2020): (i) a luminância não é monótona — o amarelo e o ciano são muito mais claros que o azul e o vermelho —, o que cria fronteiras artificiais onde os dados variam suavemente; (ii) não há uma ordem perceptual natural entre os matizes (o leitor não sabe se o verde é “maior” que o amarelo sem consultar a legenda); e (iii) são ilegíveis para daltônicos e em tons de cinza. A família viridis (viridis, magma, inferno, plasma, cividis) foi desenvolvida em 2015 para o Matplotlib justamente para corrigir esses problemas: a luminância cresce de forma monótona e aproximadamente linear, a uniformidade perceptual foi otimizada em um espaço de cor moderno (CAM02-UCS), e a variante cividis foi ajustada especificamente para deficiências de visão de cores.
library(colorspace)

# Simular como um gráfico é visto com deuteranopia
cores <- scales::hue_pal()(3)
deutan(cores)                          # cores simuladas
swatchplot(Original = cores, Deutan = deutan(cores))

# Paletas HCL sequenciais e divergentes do pacote colorspace
ggplot(faithfuld, aes(waiting, eruptions, fill = density)) +
  geom_raster() +
  scale_fill_continuous_sequential(palette = "Blues 3")

# Paleta segura para daltonismo + codificação redundante
ggplot(mpg, aes(displ, hwy, color = drv, shape = drv)) +
  geom_point(size = 2) +
  scale_color_viridis_d(option = "cividis", end = 0.9)
7.2.6.4 Tamanho, Área e a Lei de Potência de Stevens
A percepção de magnitudes físicas não é linear. A lei de potência de Stevens (Stevens 1957) afirma que a intensidade percebida \(\psi\) de um estímulo de magnitude física \(I\) segue \(\psi \propto I^{\beta}\), com expoente \(\beta\) dependente do tipo de estímulo: para comprimentos, \(\beta \approx 1\) (percepção quase fiel); para áreas, \(\beta \approx 0{,}7\) (subestimamos áreas grandes); para volumes, \(\beta \approx 0{,}6\). Isso ajuda a explicar a hierarquia de Cleveland e McGill e tem uma consequência prática no ggplot2: scale_size() (o padrão) mapeia o valor para a área do ponto, e não para o raio. Se o raio fosse proporcional ao valor, um valor duas vezes maior apareceria com área quatro vezes maior, exagerando muito as diferenças. Use scale_size_area() quando o zero deve corresponder a área zero, e reserve scale_radius() para casos muito específicos.
7.2.7 Sistemas de Coordenadas (Coord)
O sistema de coordenadas determina como as posições \(x\) e \(y\) são projetadas no plano. As funções mais relevantes são:
coord_cartesian(): o padrão; permite dar zoom sem descartar dados (xlim,ylim);coord_flip(): troca os eixos \(x\) e \(y\) (útil para rótulos de categorias longos; nas versões recentes basta trocarxeynoaes());coord_fixed(ratio = 1): impõe uma razão fixa entre as unidades dos eixos (importante quando \(x\) e \(y\) estão na mesma unidade);coord_polar(): coordenadas polares, \((x, y) \mapsto (\theta, r)\);coord_sf(): projeções cartográficas para mapas.
scale_x_continuous(limits = c(a, b)) (ou xlim(a, b)) remove os dados fora do intervalo antes de calcular os stats, enquanto coord_cartesian(xlim = c(a, b)) apenas recorta a visualização depois de tudo calculado. Assim, uma curva geom_smooth() ou um boxplot podem mudar com o primeiro método, mas não com o segundo. Para “dar zoom”, prefira coord_cartesian().
O gráfico de setores (pizza) é, na gramática, simplesmente um gráfico de barras empilhadas em coordenadas polares:
ggplot(mpg, aes(x = "", fill = drv)) +
  geom_bar(width = 1) +
  coord_polar(theta = "y") +
  theme_void()
Esse exemplo é pedagógico: mostra o poder da gramática. Do ponto de vista da percepção visual, porém, comparar ângulos e áreas é menos preciso do que comparar comprimentos sobre uma escala comum, como veremos adiante; em geral, um gráfico de barras comunica melhor a mesma informação.
7.2.8 Facetas (Facets)
As facetas implementam a ideia de pequenos múltiplos (small multiples), popularizada por Edward Tufte (Tufte 1983): uma sequência de gráficos com os mesmos eixos e a mesma escala, cada um exibindo um subconjunto dos dados. Há duas funções:
facet_wrap(~ v): cria um painel por nível dev, “quebrando” a sequência em linhas e colunas;facet_grid(linhas ~ colunas): cria uma grade bidimensional cruzando os níveis de duas variáveis.
# Grade: linhas = tipo de tração, colunas = número de cilindros
ggplot(mpg, aes(x = displ, y = hwy)) +
  geom_point() +
  facet_grid(drv ~ cyl, labeller = label_both)

# Painéis com eixos y livres (cuidado: dificulta comparação entre painéis)
ggplot(economics_long, aes(x = date, y = value)) +
  geom_line() +
  facet_wrap(~ variable, ncol = 1, scales = "free_y")
O argumento scales = "free" (ou "free_x", "free_y") deixa cada painel com sua própria escala. Isso é útil quando as variáveis têm ordens de grandeza diferentes, mas impede comparações diretas de magnitude entre painéis — uma decisão que deve ser consciente.
7.2.9 Temas (Themes) e Rótulos (labs)
O tema controla todos os elementos não relacionados aos dados: fundo, grades, fontes, posição da legenda, margens. O ggplot2 traz temas completos (theme_gray() — o padrão —, theme_bw(), theme_minimal(), theme_classic(), theme_light(), theme_void()), e a função theme() permite ajustes finos por meio de elementos element_text(), element_line(), element_rect() e element_blank() (que remove o elemento).
ggplot(mpg, aes(x = displ, y = hwy, color = drv)) +
  geom_point() +
  labs(
    title    = "Motores maiores consomem mais combustível",
    subtitle = "Consumo na rodovia segundo a cilindrada, por tipo de tração",
    x        = "Cilindrada (litros)",
    y        = "Consumo na rodovia (milhas por galão)",
    color    = "Tração",
    caption  = "Fonte: conjunto de dados mpg (EPA, via ggplot2)"
  ) +
  theme_minimal(base_size = 12) +
  theme(
    plot.title       = element_text(face = "bold"),
    legend.position  = "bottom",
    panel.grid.minor = element_blank()
  )

# Define um tema padrão para todos os gráficos da sessão
theme_set(theme_minimal(base_size = 12))
Bons rótulos são parte da análise, não um detalhe cosmético: os nomes das colunas (hwy, displ) raramente são compreensíveis para o leitor final. O título pode — e, em gráficos explanatórios, deve — enunciar a conclusão principal, conforme discutido no Capítulo de Storytelling com Dados.
7.3 Percepção Visual e a Escolha do Gráfico
7.3.1 A Hierarquia de Cleveland e McGill
Por que preferimos barras a setores, ou posições a cores? Cleveland e McGill (1984) conduziram experimentos sobre a percepção gráfica e ordenaram as tarefas elementares de decodificação visual da mais precisa para a menos precisa:
- Posição ao longo de uma escala comum;
- Posição ao longo de escalas não alinhadas (por exemplo, em painéis distintos);
- Comprimento, direção e ângulo;
- Área;
- Volume e curvatura;
- Sombreamento e saturação de cor.
A consequência prática é direta: a variável mais importante da análise deve ser mapeada para a posição (eixos \(x\) e \(y\)). Cor, tamanho e forma são adequados para variáveis secundárias, e devem ser usados com parcimônia.
7.3.2 Escolhendo o Gráfico Conforme o Tipo de Variável
A escolha da representação depende da natureza das variáveis (os tipos de variáveis são formalizados no Capítulo de Análise Exploratória de Dados com Python) e do número de variáveis envolvidas:
| Análise | Tipos de variáveis | Gráficos recomendados |
|---|---|---|
| Univariada | Quantitativa | Histograma, densidade, boxplot, violino, ECDF |
| Univariada | Qualitativa | Barras (ordenadas por frequência ou pela ordem natural) |
| Bivariada | Quantitativa × quantitativa | Dispersão, dispersão com suavização, hexbin |
| Bivariada | Quantitativa × qualitativa | Boxplots lado a lado, violinos, densidades sobrepostas |
| Bivariada | Qualitativa × qualitativa | Barras agrupadas, barras 100% empilhadas, mapa de calor de contagens |
| Bivariada | Quantitativa × tempo | Linhas |
| Multivariada | Três ou mais | Cor/forma/tamanho adicionais, facetas, matriz de correlação (mapa de calor) |
7.4 Distribuições Univariadas
7.4.1 Histogramas
Seja \(x_1, \dots, x_n\) uma amostra de uma variável contínua. Um histograma particiona o intervalo dos dados em \(k\) classes (bins) \(B_j = [t_{j-1}, t_j)\), de largura \(h = t_j - t_{j-1}\), e desenha sobre cada classe um retângulo cuja altura é proporcional à frequência observada. Na versão normalizada (densidade), a altura sobre a classe \(B_j\) é
\[ \hat{f}(x) = \frac{n_j}{n\,h}, \quad x \in B_j, \qquad n_j = \#\{i : x_i \in B_j\}, \]
de modo que a área total dos retângulos é igual a 1 e \(\hat{f}\) é um estimador (rudimentar) da função densidade de probabilidade \(f\). No ggplot2, a altura padrão é a contagem \(n_j\); para a densidade usa-se aes(y = after_stat(density)).
O ponto crítico é a escolha de \(h\) (ou de \(k\)): classes muito largas escondem a estrutura da distribuição (alto viés); classes muito estreitas produzem um gráfico ruidoso e serrilhado (alta variância). Algumas regras clássicas:
- Regra de Sturges (Sturges 1926): \(k = \lceil \log_2 n \rceil + 1\). Deriva da hipótese de dados aproximadamente normais (aproximando a distribuição binomial) e tende a usar poucas classes para amostras grandes.
- Regra de Scott (Scott 1979): \(h = 3{,}49\, s\, n^{-1/3}\), em que \(s\) é o desvio padrão amostral. Minimiza assintoticamente o erro quadrático médio integrado sob normalidade.
- Regra de Freedman–Diaconis (Freedman e Diaconis 1981): \(h = 2 \cdot \mathrm{IQR} \cdot n^{-1/3}\), em que \(\mathrm{IQR} = Q_3 - Q_1\). Substitui o desvio padrão pelo intervalo interquartil, sendo robusta a outliers.
O fator \(n^{-1/3}\) comum às regras de Scott e Freedman–Diaconis não é acaso: a teoria mostra que a largura que minimiza o erro quadrático médio integrado de um histograma decresce à taxa \(n^{-1/3}\) (Freedman e Diaconis 1981).
7.4.1.1 O histograma como estimador: viés, variância e a regra de Scott
Para entender de onde vêm essas regras, tratamos o histograma como um estimador de \(f\) e medimos sua qualidade global pelo erro quadrático médio integrado (mean integrated squared error, MISE):
\[ \mathrm{MISE}(h) = \mathbb{E}\int \big(\hat{f}(x) - f(x)\big)^2\,dx = \int \mathrm{Viés}^2\big[\hat{f}(x)\big]\,dx + \int \mathrm{Var}\big[\hat{f}(x)\big]\,dx. \]
A segunda igualdade é a decomposição usual do erro quadrático médio, aplicada ponto a ponto e integrada. Analisemos cada parcela para um ponto \(x\) na classe \(B_j = [t_{j-1}, t_j)\).
Variância. O número de observações na classe, \(n_j\), tem distribuição \(\text{Binomial}(n, p_j)\), com \(p_j = \int_{B_j} f(t)\,dt \approx h\,f(x)\). Logo
\[ \mathrm{Var}\big[\hat{f}(x)\big] = \frac{\mathrm{Var}(n_j)}{n^2 h^2} = \frac{p_j(1 - p_j)}{n\,h^2} \approx \frac{f(x)}{n\,h}, \]
e, integrando em \(x\) (lembrando que \(\int f = 1\)), a variância integrada é aproximadamente \(1/(nh)\): classes estreitas têm poucas observações e, portanto, alturas muito instáveis.
Viés. Como \(\mathbb{E}[\hat{f}(x)] = p_j/h\) é a média de \(f\) sobre a classe, o histograma substitui \(f\) por uma função constante por partes. Uma expansão de Taylor de primeira ordem mostra que o viés em \(x\) é aproximadamente \(f'(x)\,\big(h/2 - (x - t_{j-1})\big)\), e integrando o seu quadrado obtemos \(\frac{h^2}{12}R(f')\), em que \(R(g) = \int g(x)^2\,dx\) mede a “rugosidade” de \(g\). Classes largas achatam a estrutura de \(f\).
Juntando as duas parcelas, o MISE assintótico (AMISE) é
\[ \mathrm{AMISE}(h) = \frac{1}{n\,h} + \frac{h^2}{12}\,R(f'). \]
Derivando em \(h\) e igualando a zero, \(-\frac{1}{n h^2} + \frac{h}{6}R(f') = 0\), de onde
\[ h^* = \left(\frac{6}{n\,R(f')}\right)^{1/3} \propto n^{-1/3}, \qquad \mathrm{AMISE}(h^*) \propto n^{-2/3}. \]
A fórmula depende de \(R(f')\), que é desconhecido (é justamente \(f\) que queremos estimar!). A ideia de Scott (1979) é usar uma distribuição de referência: se \(f\) for normal com desvio padrão \(\sigma\), então \(R(f') = 1/(4\sqrt{\pi}\,\sigma^3)\) e
\[ h^* = \left(24\sqrt{\pi}\right)^{1/3}\sigma\, n^{-1/3} \approx 3{,}49\,\sigma\, n^{-1/3}, \]
que é exatamente a regra de Scott, com \(\sigma\) estimado por \(s\). A regra de Freedman–Diaconis troca \(\sigma\) por uma medida robusta: como, sob normalidade, \(\mathrm{IQR} \approx 1{,}349\,\sigma\), a substituição direta daria \(3{,}49/1{,}349 \approx 2{,}59\,\mathrm{IQR}\,n^{-1/3}\); o fator 2 proposto por Freedman e Diaconis (1981) é um pouco mais conservador e produz classes ligeiramente mais estreitas, o que é desejável quando a distribuição tem caudas mais pesadas que a normal (nesse caso, \(R(f')\) é maior e o \(h^*\) verdadeiro é menor).
E a regra de Sturges? Sua justificativa é combinatória, e não de otimização. Sturges imaginou um histograma “ideal” com \(k\) classes cujas frequências são os coeficientes binomiais \(\binom{k-1}{0}, \binom{k-1}{1}, \dots, \binom{k-1}{k-1}\) — uma aproximação discreta da normal. Como \(\sum_{j} \binom{k-1}{j} = 2^{k-1}\), igualando ao tamanho da amostra temos \(n = 2^{k-1}\), isto é, \(k = 1 + \log_2 n\). Note que, por essa regra, \(k\) cresce apenas logaritmicamente com \(n\), enquanto pelas regras ótimas \(k\) cresce como \(n^{1/3}\); por isso Sturges produz histogramas excessivamente suavizados para amostras grandes. Por exemplo, para \(n = 10^6\), Sturges sugere apenas 21 classes.
O erro do histograma ótimo decresce como \(n^{-2/3}\), mais lentamente do que a taxa \(n^{-1}\) típica de estimadores paramétricos (como a média amostral). Esse é o “preço” da estimação não paramétrica: como não supomos uma forma para \(f\), precisamos de mais dados para atingir a mesma precisão. Veremos a seguir que a densidade por kernel atinge a taxa \(n^{-4/5}\), melhor que a do histograma.
mpg$hwy
O conjunto mpg possui \(n = 234\) veículos. Para a variável hwy (consumo na rodovia), temos mínimo 12, \(Q_1 = 18\), mediana 24, \(Q_3 = 27\) e máximo 44.
Sturges: \(\log_2 234 \approx 7{,}87\), logo \(k = \lceil 7{,}87 \rceil + 1 = 8 + 1 = 9\) classes.
Freedman–Diaconis: \(\mathrm{IQR} = 27 - 18 = 9\) e \(234^{1/3} \approx 6{,}16\), logo \(h = 2 \times 9 / 6{,}16 \approx 2{,}92\). Como a amplitude é \(44 - 12 = 32\), o número de classes é \(\lceil 32 / 2{,}92 \rceil = \lceil 10{,}96 \rceil = 11\).
Scott: o desvio padrão amostral é \(s \approx 5{,}95\), logo \(h = 3{,}49 \times 5{,}95 / 6{,}16 \approx 3{,}37\) e o número de classes é \(\lceil 32/3{,}37 \rceil = \lceil 9{,}50 \rceil = 10\).
O R confirma: nclass.Sturges(mpg$hwy) retorna 9, nclass.scott(mpg$hwy) retorna 10 e nclass.FD(mpg$hwy) retorna 11. As três regras concordam razoavelmente porque a amostra é moderada (\(n = 234\)) e a distribuição não é muito distante de uma normal; para amostras grandes e assimétricas, as diferenças tornam-se substanciais.
# Padrão do ggplot2: 30 classes (com uma mensagem sugerindo escolher melhor)
ggplot(mpg, aes(x = hwy)) +
  geom_histogram()

# Largura escolhida pela regra de Freedman–Diaconis
h_fd <- 2 * IQR(mpg$hwy) / length(mpg$hwy)^(1/3)

ggplot(mpg, aes(x = hwy)) +
  geom_histogram(binwidth = h_fd, fill = "steelblue", color = "white") +
  labs(x = "Consumo na rodovia (mpg)", y = "Frequência",
       title = "Histograma com largura de Freedman–Diaconis")

# Número de classes pela regra de Sturges
ggplot(mpg, aes(x = hwy)) +
  geom_histogram(bins = nclass.Sturges(mpg$hwy),
                 fill = "grey60", color = "white")
Uma alternativa visual ao histograma, útil para comparar grupos sobrepostos, é o polígono de frequências (geom_freqpoly()), que liga os pontos médios do topo de cada classe.
7.4.2 Densidade por Kernel
O histograma depende não apenas de \(h\), mas também da origem das classes, e é uma função descontínua. A estimação de densidade por kernel (kernel density estimation, KDE) corrige esses problemas colocando uma pequena “colina” suave sobre cada observação e somando-as:
\[ \hat{f}_h(x) = \frac{1}{n\,h} \sum_{i=1}^{n} K\!\left(\frac{x - x_i}{h}\right), \]
em que \(K\) é o kernel — uma função não negativa, simétrica e que integra 1 (tipicamente uma densidade de probabilidade) — e \(h > 0\) é a largura de banda (bandwidth). O kernel mais usado é o gaussiano, \(K(u) = \frac{1}{\sqrt{2\pi}} e^{-u^2/2}\); outros são o de Epanechnikov, \(K(u) = \frac{3}{4}(1 - u^2)\,\mathbf{1}(|u| \le 1)\), e o retangular.
Assim como no histograma, a escolha de \(h\) governa o compromisso entre viés e variância, enquanto a escolha de \(K\) tem efeito muito menor. Uma regra prática amplamente usada é a regra de Silverman (Silverman 1986):
\[ h = 0{,}9 \cdot \min\!\left(s, \frac{\mathrm{IQR}}{1{,}34}\right) \cdot n^{-1/5}, \]
que é exatamente o padrão bw = "nrd0" do R e, portanto, do geom_density(). O argumento adjust multiplica a largura padrão: adjust = 0.5 produz uma curva mais “nervosa” e adjust = 2, mais suave.
Considere a amostra \(\{1, 2, 4\}\), kernel gaussiano e \(h = 1\). A densidade estimada no ponto \(x = 2\) é
\[ \hat{f}_1(2) = \frac{1}{3 \cdot 1}\left[\phi(2-1) + \phi(2-2) + \phi(2-4)\right] = \frac{1}{3}\left[\phi(1) + \phi(0) + \phi(-2)\right], \]
em que \(\phi\) é a densidade normal padrão. Como \(\phi(0) \approx 0{,}3989\), \(\phi(1) \approx 0{,}2420\) e \(\phi(-2) = \phi(2) \approx 0{,}0540\), obtemos
\[ \hat{f}_1(2) \approx \frac{0{,}2420 + 0{,}3989 + 0{,}0540}{3} = \frac{0{,}6949}{3} \approx 0{,}2316. \]
Em R: mean(dnorm(2, mean = c(1, 2, 4), sd = 1)) retorna 0.2316.
7.4.2.1 Um pouco de história
O estimador por kernel foi proposto de forma independente por Rosenblatt (1956) e Parzen (1962) — por isso também é chamado de estimador de Parzen–Rosenblatt. Epanechnikov (1969) mostrou qual kernel minimiza o erro assintótico, e o livro de Silverman (1986) popularizou a técnica e a regra prática de escolha de \(h\) que leva seu nome. Textos modernos de referência são Wand e Jones (1995) e Scott (2015).
7.4.2.2 Viés, variância e a largura de banda ótima
A análise do KDE é paralela à do histograma, mas o resultado é melhor. Suponha que \(K\) seja uma densidade simétrica com \(\int u^2 K(u)\,du = \mu_2(K) < \infty\) e defina \(R(K) = \int K(u)^2\,du\). Fazendo a mudança de variável \(u = (x - t)/h\):
\[ \mathbb{E}\big[\hat{f}_h(x)\big] = \frac{1}{h}\int K\!\left(\frac{x - t}{h}\right) f(t)\,dt = \int K(u)\, f(x - h u)\,du. \]
Expandindo \(f(x - hu) = f(x) - hu\,f'(x) + \frac{h^2u^2}{2}f''(x) + \dots\) e usando \(\int K = 1\) e \(\int uK(u)\,du = 0\) (simetria), o termo de primeira ordem se anula e
\[ \mathrm{Viés}\big[\hat{f}_h(x)\big] \approx \frac{h^2}{2}\,\mu_2(K)\, f''(x). \]
O viés é proporcional à curvatura \(f''(x)\): o KDE “arredonda” picos (onde \(f'' < 0\), subestima) e “preenche” vales (onde \(f'' > 0\), superestima). De maneira análoga, como \(\hat{f}_h(x)\) é uma média de \(n\) variáveis independentes,
\[ \mathrm{Var}\big[\hat{f}_h(x)\big] \approx \frac{f(x)\,R(K)}{n\,h}. \]
Integrando o quadrado do viés e a variância, obtemos
\[ \mathrm{AMISE}(h) = \frac{R(K)}{n\,h} + \frac{h^4}{4}\,\mu_2(K)^2\, R(f''), \]
minimizado em
\[ h^* = \left[\frac{R(K)}{\mu_2(K)^2\, R(f'')\, n}\right]^{1/5} \propto n^{-1/5}, \qquad \mathrm{AMISE}(h^*) \propto n^{-4/5}. \]
Como \(n^{-4/5}\) decresce mais rápido do que \(n^{-2/3}\), o KDE é assintoticamente mais eficiente que o histograma: o viés de um estimador suave é de ordem \(h^2\), e não \(h\).
Regra de referência normal. Para kernel gaussiano, \(R(K) = 1/(2\sqrt{\pi})\) e \(\mu_2(K) = 1\); se \(f\) é normal com desvio padrão \(\sigma\), então \(R(f'') = 3/(8\sqrt{\pi}\,\sigma^5)\). Substituindo:
\[ h^* = \left[\frac{1/(2\sqrt{\pi})}{3/(8\sqrt{\pi}\,\sigma^5)\; n}\right]^{1/5} = \left(\frac{4}{3}\right)^{1/5}\sigma\, n^{-1/5} \approx 1{,}06\,\sigma\, n^{-1/5}. \]
Esse é o seletor bw = "nrd" do R (com \(\sigma\) estimado por \(\min(s, \mathrm{IQR}/1{,}34)\)). Silverman (1986) observou que, para distribuições bimodais ou assimétricas, a regra de referência normal suaviza demais (pois a curvatura real é maior que a da normal) e propôs reduzir a constante para 0,9, chegando à regra apresentada acima — o padrão bw = "nrd0".
Seletores baseados nos dados. Em vez de supor uma referência normal, podemos estimar \(R(f'')\) a partir dos próprios dados. O método de Sheather–Jones (Sheather e Jones 1991) (bw = "SJ") faz exatamente isso, usando uma estimativa piloto de \(f''\), e costuma ser recomendado quando se suspeita de multimodalidade. A validação cruzada (bw = "ucv") escolhe \(h\) minimizando uma estimativa não viesada do MISE, mas tende a ser muito variável e, com dados discretizados, a produzir larguras pequenas demais.
A escolha do kernel importa pouco. O kernel de Epanechnikov minimiza o AMISE entre todos os kernels não negativos. A eficiência de outro kernel é a razão entre os AMISE ótimos, e os valores são muito próximos de 1:
| Kernel | \(K(u)\) | Eficiência |
|---|---|---|
| Epanechnikov | \(\frac{3}{4}(1 - u^2)\,\mathbf{1}(\lvert u \rvert \le 1)\) | 1,000 |
| Biponderado (biweight) | \(\frac{15}{16}(1 - u^2)^2\,\mathbf{1}(\lvert u \rvert \le 1)\) | 0,994 |
| Triangular | \((1 - \lvert u \rvert)\,\mathbf{1}(\lvert u \rvert \le 1)\) | 0,986 |
| Gaussiano | \(\frac{1}{\sqrt{2\pi}}e^{-u^2/2}\) | 0,951 |
| Retangular | \(\frac{1}{2}\,\mathbf{1}(\lvert u \rvert \le 1)\) | 0,930 |
Em termos práticos, mesmo o kernel retangular precisa de apenas cerca de 7% a mais de observações para igualar o desempenho do ótimo. Por isso a atenção deve recair sobre \(h\), e não sobre \(K\) (Wand e Jones 1995).
mpg$hwy
Com \(n = 234\), \(s \approx 5{,}95\) e \(\mathrm{IQR} = 9\), temos \(\mathrm{IQR}/1{,}34 \approx 6{,}72\), de modo que \(\min(s, \mathrm{IQR}/1{,}34) = 5{,}95\). Além disso, \(234^{-1/5} \approx 0{,}336\).
- Silverman (
nrd0): \(h = 0{,}9 \times 5{,}95 \times 0{,}336 \approx 1{,}80\); - Referência normal (
nrd): \(h = 1{,}06 \times 5{,}95 \times 0{,}336 \approx 2{,}12\); - Sheather–Jones (
SJ): calculado numericamente pelo R, \(h \approx 0{,}93\).
O seletor de Sheather–Jones escolhe uma largura com menos da metade da de Silverman, porque detecta a estrutura bimodal de hwy (carros compactos econômicos versus utilitários e caminhonetes). Em R: bw.nrd0(mpg$hwy), bw.nrd(mpg$hwy) e bw.SJ(mpg$hwy); no ggplot2, geom_density(bw = "SJ").
# Densidades sobrepostas por espécie (dados iris)
ggplot(iris, aes(x = Sepal.Length, fill = Species)) +
  geom_density(alpha = 0.5) +
  labs(x = "Comprimento da sépala (cm)", y = "Densidade estimada")

# Efeito da largura de banda
ggplot(mpg, aes(x = hwy)) +
  geom_density(adjust = 0.3, color = "firebrick") +
  geom_density(adjust = 1,   color = "black") +
  geom_density(adjust = 3,   color = "steelblue")

# Histograma na escala de densidade com a KDE sobreposta
ggplot(mpg, aes(x = hwy)) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 2.9,
                 fill = "grey80", color = "white") +
  geom_density(linewidth = 1, color = "steelblue")
7.4.3 Boxplot (Diagrama de Caixa)
O boxplot, proposto por John Tukey (Tukey 1977), resume uma distribuição em cinco números e sinaliza observações potencialmente discrepantes. No ggplot2, sua construção segue estes passos:
- Calculam-se o primeiro quartil \(Q_1\), a mediana \(Q_2\) e o terceiro quartil \(Q_3\) (pelo método padrão do R,
quantile(type = 7)); - Calcula-se o intervalo interquartil \(\mathrm{IQR} = Q_3 - Q_1\);
- Definem-se as cercas (fences) inferior e superior: \(L_I = Q_1 - 1{,}5\,\mathrm{IQR}\) e \(L_S = Q_3 + 1{,}5\,\mathrm{IQR}\);
- A caixa vai de \(Q_1\) a \(Q_3\), com uma linha na mediana;
- Os bigodes (whiskers) se estendem até a observação mais extrema que ainda está dentro das cercas (e não até a cerca em si);
- As observações fora das cercas são desenhadas individualmente como pontos.
Por que o fator 1,5? Para uma distribuição normal, \(Q_1 \approx \mu - 0{,}674\sigma\) e \(Q_3 \approx \mu + 0{,}674\sigma\); logo \(\mathrm{IQR} \approx 1{,}349\sigma\) e a cerca superior fica em \(\mu + 0{,}674\sigma + 1{,}5 \times 1{,}349\sigma \approx \mu + 2{,}7\sigma\). A probabilidade de uma observação normal cair fora das cercas é de apenas cerca de 0,7%.
Considere os \(n = 10\) valores ordenados \(\{2, 4, 4, 5, 6, 7, 8, 9, 10, 25\}\).
- Mediana: média do 5º e 6º valores, \((6 + 7)/2 = 6{,}5\).
- \(Q_1\) (tipo 7): posição \(1 + 0{,}25(n-1) = 3{,}25\), ou seja, \(x_{(3)} + 0{,}25\,(x_{(4)} - x_{(3)}) = 4 + 0{,}25 \times 1 = 4{,}25\).
- \(Q_3\) (tipo 7): posição \(1 + 0{,}75(n-1) = 7{,}75\), ou seja, \(x_{(7)} + 0{,}75\,(x_{(8)} - x_{(7)}) = 8 + 0{,}75 \times 1 = 8{,}75\).
- IQR: \(8{,}75 - 4{,}25 = 4{,}5\); logo \(1{,}5\,\mathrm{IQR} = 6{,}75\).
- Cercas: \(L_I = 4{,}25 - 6{,}75 = -2{,}5\) e \(L_S = 8{,}75 + 6{,}75 = 15{,}5\).
- Bigodes: o inferior vai até 2 (menor valor \(\ge -2{,}5\)) e o superior até 10 (maior valor \(\le 15{,}5\)).
- Outlier: o valor 25 está acima de 15,5 e é desenhado como ponto.
Em R: ggplot(data.frame(x = c(2, 4, 4, 5, 6, 7, 8, 9, 10, 25)), aes(y = x)) + geom_boxplot().
Boxplots são especialmente úteis para comparar distribuições entre grupos. Ordenar os grupos pela mediana facilita muito a leitura:
ggplot(mpg, aes(x = reorder(class, hwy, FUN = median), y = hwy)) +
  geom_boxplot(fill = "lightblue", outlier.colour = "firebrick") +
  coord_flip() +
  labs(x = "Classe do veículo", y = "Consumo na rodovia (mpg)")
Uma limitação do boxplot é esconder a forma da distribuição (por exemplo, bimodalidade). O gráfico de violino (geom_violin()) desenha uma densidade por kernel espelhada para cada grupo e pode ser combinado com um boxplot estreito:
ggplot(iris, aes(x = Species, y = Petal.Length, fill = Species)) +
  geom_violin(trim = FALSE, alpha = 0.4) +
  geom_boxplot(width = 0.1, outlier.shape = NA) +
  geom_jitter(width = 0.05, alpha = 0.3, size = 1) +
  theme(legend.position = "none")
7.4.4 Gráficos de Barras: geom_bar() versus geom_col()
Há duas funções para barras, e a diferença está no stat:
geom_bar()usastat = "count": recebe dados brutos e conta as ocorrências de cada categoria;geom_col()usastat = "identity": recebe dados já resumidos e usa a colunaycomo altura.
# Dados brutos: o ggplot2 conta
ggplot(mpg, aes(x = class)) +
  geom_bar()

# Dados resumidos: nós contamos (com dplyr) e ordenamos as barras
mpg |>
  count(manufacturer) |>
  ggplot(aes(x = n, y = reorder(manufacturer, n))) +
  geom_col(fill = "steelblue") +
  geom_text(aes(label = n), hjust = -0.2, size = 3) +
  labs(x = "Número de modelos", y = NULL)
Duas regras de boa prática: o eixo de um gráfico de barras deve começar em zero, pois o leitor compara comprimentos (truncar o eixo exagera diferenças); e categorias nominais devem ser ordenadas por frequência, enquanto categorias ordinais (como cut em diamonds) devem manter sua ordem natural.
7.4.5 Função de Distribuição Empírica (ECDF)
Histogramas e densidades exigem a escolha de um parâmetro de suavização. Existe, porém, um resumo gráfico de uma distribuição que não depende de nenhuma escolha: a função de distribuição empírica (empirical cumulative distribution function, ECDF),
\[ F_n(x) = \frac{1}{n}\sum_{i=1}^n \mathbf{1}(x_i \le x) = \frac{\#\{i : x_i \le x\}}{n}, \]
uma função escada que salta \(1/n\) em cada observação (ou \(k/n\) se houver \(k\) empates). Ela é o estimador natural da função de distribuição acumulada \(F(x) = P(X \le x)\) e tem propriedades teóricas notáveis:
- Não viesada e consistente ponto a ponto. Para \(x\) fixo, \(n F_n(x) \sim \text{Binomial}(n, F(x))\); logo \(\mathbb{E}[F_n(x)] = F(x)\) e \(\mathrm{Var}[F_n(x)] = F(x)\,(1 - F(x))/n \to 0\). A variância é máxima na mediana (\(F = 1/2\)) e mínima nas caudas.
- Convergência uniforme (Glivenko–Cantelli). \(\sup_x \lvert F_n(x) - F(x)\rvert \to 0\) quase certamente — resultado às vezes chamado de “teorema fundamental da Estatística”, pois garante que a amostra revela toda a distribuição quando \(n\) cresce.
- Banda de confiança (Dvoretzky–Kiefer–Wolfowitz). Para todo \(\varepsilon > 0\), \(P\big(\sup_x \lvert F_n(x) - F(x)\rvert > \varepsilon\big) \le 2e^{-2n\varepsilon^2}\). Igualando o lado direito a \(\alpha\), obtemos uma banda de confiança \(F_n(x) \pm \varepsilon_n\) válida simultaneamente para todo \(x\), com \(\varepsilon_n = \sqrt{\ln(2/\alpha)/(2n)}\).
Por exemplo, para \(n = 234\) e \(\alpha = 0{,}05\), \(\varepsilon_n = \sqrt{\ln 40 / 468} \approx 0{,}089\): a verdadeira \(F\) está, com 95% de confiança, inteiramente contida na faixa de \(\pm 0{,}089\) em torno da ECDF.
A ECDF permite ler quantis diretamente (a mediana é o \(x\) em que \(F_n\) cruza 0,5) e é excelente para comparar grupos, pois curvas acumuladas não se sobrepõem de forma confusa como histogramas. Se a curva do grupo A está sempre à direita da do grupo B, os valores de A são estocasticamente maiores. A distância vertical máxima entre duas ECDFs é a estatística do teste de Kolmogorov–Smirnov.
ggplot(mpg, aes(x = hwy, color = drv)) +
  stat_ecdf(geom = "step", linewidth = 0.8) +
  geom_hline(yintercept = 0.5, linetype = "dotted") +
  labs(x = "Consumo na rodovia (mpg)", y = expression(F[n](x)),
       color = "Tração")
7.4.6 Gráficos Quantil-Quantil (QQ-plots)
O gráfico quantil-quantil (Wilk e Gnanadesikan 1968) compara os quantis da amostra com os quantis de uma distribuição teórica de referência \(F_0\) (em geral, a normal padrão). Ordenam-se os dados, \(x_{(1)} \le \dots \le x_{(n)}\), e a \(i\)-ésima estatística de ordem é plotada contra o quantil teórico \(F_0^{-1}(p_i)\), em que \(p_i\) é uma posição de plotagem (plotting position). O R (funções qqnorm() e ppoints()) usa
\[ p_i = \frac{i - a}{n + 1 - 2a}, \qquad a = \begin{cases} 3/8, & n \le 10,\\ 1/2, & n > 10. \end{cases} \]
(Usar \(p_i = i/n\) não funcionaria, pois \(F_0^{-1}(1) = +\infty\) para a normal.)
Por que o gráfico deveria ser uma reta? Se \(X\) pertence à família locação-escala de \(F_0\), isto é, \(X = \mu + \sigma Z\) com \(Z \sim F_0\), então o quantil \(p\) de \(X\) é \(\mu + \sigma\,F_0^{-1}(p)\). Como \(x_{(i)}\) estima aproximadamente o quantil \(p_i\), os pontos devem cair perto da reta de intercepto \(\mu\) e inclinação \(\sigma\). Assim, o QQ-plot testa a forma da distribuição sem precisar estimar previamente a média e a variância. A reta de referência desenhada por geom_qq_line() (e por qqline()) passa pelos pontos correspondentes ao primeiro e ao terceiro quartis, uma escolha robusta a outliers.
A leitura de desvios da reta é sistemática:
| Padrão no QQ-plot normal | Interpretação |
|---|---|
| Pontos sobre a reta | Distribuição compatível com a normal |
| Curva convexa (forma de “U”) | Assimetria à direita |
| Curva côncava (forma de “U” invertido) | Assimetria à esquerda |
| Forma de “S” com extremos fora da reta (cauda inferior abaixo, superior acima) | Caudas pesadas (leptocúrtica) |
| Forma de “S” com extremos dentro da reta | Caudas leves (platicúrtica) |
| Degraus horizontais | Dados discretizados ou com muitos empates |
| Poucos pontos isolados nos extremos | Possíveis outliers |
Considere a amostra ordenada \(\{2, 3, 5, 8, 12\}\) (\(n = 5\)). Como \(n \le 10\), usamos \(a = 3/8\) e \(p_i = (i - 0{,}375)/5{,}25\):
| \(i\) | \(x_{(i)}\) | \(p_i\) | \(\Phi^{-1}(p_i)\) |
|---|---|---|---|
| 1 | 2 | 0,119 | \(-1{,}18\) |
| 2 | 3 | 0,310 | \(-0{,}50\) |
| 3 | 5 | 0,500 | \(0{,}00\) |
| 4 | 8 | 0,690 | \(0{,}50\) |
| 5 | 12 | 0,881 | \(1{,}18\) |
A reta de referência passa pelos quartis: os quartis amostrais (tipo 7) são \(Q_1 = 3\) e \(Q_3 = 8\), e os quartis da normal padrão são \(\mp 0{,}674\). A inclinação é \((8 - 3)/(0{,}674 - (-0{,}674)) = 5/1{,}349 \approx 3{,}71\) e o intercepto é \((Q_1 + Q_3)/2 = 5{,}5\). Comparando cada ponto com a reta \(5{,}5 + 3{,}71\,z\): nos extremos, os pontos ficam acima da reta (em \(z = 1{,}18\) a reta vale \(\approx 9{,}9 < 12\); em \(z = -1{,}18\) vale \(\approx 1{,}1 < 2\)), enquanto no centro ficam abaixo (em \(z = 0\) a reta vale \(5{,}5 > 5\)). Esse padrão convexo, mais acentuado à direita, indica assimetria à direita, coerente com a média (\(6\)) maior que a mediana (\(5\)). Em R: qqnorm(c(2, 3, 5, 8, 12))$x reproduz a última coluna.
# QQ-plot normal do consumo na rodovia, por tipo de tração
ggplot(mpg, aes(sample = hwy)) +
  geom_qq(alpha = 0.6) +
  geom_qq_line(color = "firebrick") +
  facet_wrap(~ drv) +
  labs(x = "Quantis teóricos N(0, 1)", y = "Quantis amostrais (mpg)")

# QQ-plot contra outra distribuição de referência (exponencial)
ggplot(data.frame(x = rexp(200)), aes(sample = x)) +
  geom_qq(distribution = qexp) +
geom_qq_line(distribution = qexp)Testes formais (Shapiro–Wilk, Anderson–Darling) respondem a uma pergunta binária e são muito sensíveis ao tamanho da amostra: com \(n\) grande, rejeitam a normalidade por desvios irrelevantes; com \(n\) pequeno, quase nunca rejeitam. O QQ-plot mostra onde e quanto a distribuição se afasta da referência, o que é muito mais informativo para decidir, por exemplo, se uma transformação é necessária.
7.5 Relações Bivariadas e Multivariadas
7.5.1 Dispersão com Suavização
O gráfico de dispersão é a ferramenta básica para duas variáveis quantitativas. A camada geom_smooth() adiciona uma curva que estima a média condicional \(\mathbb{E}[Y \mid X = x]\), acompanhada de uma faixa de confiança:
method = "lm": ajusta uma reta por mínimos quadrados, \(\hat{y} = \hat{\beta}_0 + \hat{\beta}_1 x\);method = "loess"(padrão para menos de 1.000 observações): regressão polinomial localmente ponderada (Cleveland 1979). Para cada ponto \(x_0\), ajusta-se um polinômio de grau baixo por mínimos quadrados ponderados usando apenas uma fraçãospandos dados mais próximos, com pesos dados pela função tricúbica \(w(u) = (1 - |u|^3)^3\) para \(|u| < 1\), em que \(u\) é a distância a \(x_0\) dividida pela distância máxima da vizinhança;method = "gam"(padrão para 1.000 ou mais observações): modelo aditivo generalizado com splines.
ggplot(mpg, aes(x = displ, y = hwy)) +
  geom_point(alpha = 0.6) +
  geom_smooth(method = "loess", formula = y ~ x, span = 0.75,
              color = "firebrick") +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE,
              color = "steelblue", linetype = "dashed") +
  labs(x = "Cilindrada (L)", y = "Rodovia (mpg)",
       title = "Tendência linear (tracejada) vs. suavização LOESS")
O parâmetro span controla, mais uma vez, o compromisso entre viés e variância: valores pequenos seguem o ruído; valores grandes aproximam-se de uma reta.
7.5.1.1 A Teoria por Trás do LOESS
O LOESS (LOcally Estimated Scatterplot Smoothing), proposto por Cleveland (1979) e desenvolvido em Cleveland e Devlin (1988), é um caso particular da regressão polinomial local. Para estimar a média condicional \(m(x_0) = \mathbb{E}[Y \mid X = x_0]\) em um ponto \(x_0\), o procedimento é:
- Seja \(q = \lfloor \alpha n \rfloor\) o número de vizinhos, em que \(\alpha\) é o
span. Calcula-se \(\Delta(x_0)\), a distância de \(x_0\) ao seu \(q\)-ésimo vizinho mais próximo. - Cada observação recebe o peso \(w_i(x_0) = W\big(\lvert x_i - x_0 \rvert / \Delta(x_0)\big)\), em que \(W(u) = (1 - u^3)^3\) para \(0 \le u < 1\) e \(W(u) = 0\) caso contrário (função tricúbica).
- Ajusta-se um polinômio de grau \(d\) (o padrão do
ggplot2/R é \(d = 2\)) por mínimos quadrados ponderados: \[\hat{\boldsymbol{\beta}}(x_0) = \arg\min_{\boldsymbol{\beta}} \sum_{i=1}^n w_i(x_0)\big[y_i - \beta_0 - \beta_1 (x_i - x_0) - \dots - \beta_d (x_i - x_0)^d\big]^2.\] - A estimativa é o intercepto: \(\hat{m}(x_0) = \hat{\beta}_0(x_0)\). Repete-se o processo para uma grade de pontos \(x_0\).
Matricialmente, com \(\mathbf{X}_0\) a matriz de planejamento centrada em \(x_0\) e \(\mathbf{W}_0 = \operatorname{diag}(w_1(x_0), \dots, w_n(x_0))\), temos \(\hat{\boldsymbol{\beta}}(x_0) = (\mathbf{X}_0^\top \mathbf{W}_0 \mathbf{X}_0)^{-1}\mathbf{X}_0^\top \mathbf{W}_0\,\mathbf{y}\). Como cada \(\hat{m}(x_i)\) é uma combinação linear dos \(y\)’s, o vetor de valores ajustados pode ser escrito como \(\hat{\mathbf{y}} = \mathbf{S}\,\mathbf{y}\), em que \(\mathbf{S}\) é a matriz suavizadora (smoother matrix). Por analogia com a regressão linear — em que \(\mathbf{S}\) é a matriz de projeção e \(\operatorname{tr}(\mathbf{S})\) é o número de parâmetros —, define-se o número efetivo de graus de liberdade do suavizador como \(\operatorname{tr}(\mathbf{S})\). Um span pequeno corresponde a muitos graus de liberdade (curva flexível); um span grande, a poucos (curva rígida). A faixa cinza desenhada por geom_smooth() é um intervalo de confiança pontual para \(m(x_0)\), construído a partir da variância \(\hat{\sigma}^2\,\sum_i S_{0i}^2\) da combinação linear.
Por que ajustar polinômios locais em vez de simplesmente tirar médias ponderadas locais (grau \(d = 0\), o estimador de Nadaraya–Watson)? Porque a média local sofre de viés de fronteira: perto dos extremos do eixo \(x\), todos os vizinhos estão de um mesmo lado de \(x_0\), e a média é “puxada” para o interior. O ajuste local linear corrige automaticamente esse viés de primeira ordem.
Considere os pontos \(x = (1, 2, 3, 4, 5)\) e \(y = (2, 4, 3, 6, 5)\), com span = 1 (\(q = 5\)) e grau \(d = 1\). Para estimar \(m(3)\):
- As distâncias a \(x_0 = 3\) são \((2, 1, 0, 1, 2)\) e \(\Delta(3) = 2\), logo \(u = (1;\ 0{,}5;\ 0;\ 0{,}5;\ 1)\).
- Pesos tricúbicos: \(W(1) = 0\), \(W(0{,}5) = (1 - 0{,}125)^3 = 0{,}875^3 \approx 0{,}6699\) e \(W(0) = 1\). Assim, \(w = (0;\ 0{,}6699;\ 1;\ 0{,}6699;\ 0)\).
- Como os pontos com peso positivo são simétricos em torno de \(x_0\) e os pesos também, \(\sum_i w_i (x_i - x_0) = 0\), e o intercepto da reta ponderada coincide com a média ponderada: \[\hat{m}(3) = \frac{0{,}6699 \times 4 + 1 \times 3 + 0{,}6699 \times 6}{0{,}6699 + 1 + 0{,}6699} = \frac{9{,}699}{2{,}340} \approx 4{,}145.\]
Em R: predict(loess(y ~ x, span = 1, degree = 1, control = loess.control(surface = "direct")), data.frame(x = 3)) retorna 4.145. (O argumento surface = "direct" força o cálculo exato em cada ponto, em vez da interpolação usada por padrão para acelerar o ajuste.)
7.5.2 Sobreposição de Pontos (Overplotting)
Com dezenas de milhares de observações (como os 53.940 diamantes de diamonds), os pontos se sobrepõem e o gráfico vira uma mancha. Estratégias:
# 1. Transparência
ggplot(diamonds, aes(carat, price)) +
  geom_point(alpha = 0.05)

# 2. Contagem em células retangulares (histograma bidimensional)
ggplot(diamonds, aes(carat, price)) +
  geom_bin2d(bins = 60) +
  scale_x_log10() + scale_y_log10() +
  scale_fill_viridis_c()

# 3. Células hexagonais (requer o pacote hexbin)
ggplot(diamonds, aes(carat, price)) +
  geom_hex() +
  scale_fill_viridis_c()
Para variáveis discretas com muitos empates (como cty e hwy em mpg, que são inteiras), geom_jitter() ou geom_count() revelam quantas observações estão “escondidas” em cada ponto.
7.5.3 Séries Temporais com Linhas
O conjunto economics contém séries mensais da economia norte-americana. Linhas são a representação natural para dados ordenados no tempo, pois a conexão entre pontos consecutivos tem significado:
ggplot(economics, aes(x = date, y = unemploy / pop)) +
  geom_line(color = "steelblue") +
  scale_y_continuous(labels = scales::label_percent()) +
  labs(x = NULL, y = "Desempregados / população",
       title = "Taxa de desemprego relativa à população (EUA)")

# Várias séries normalizadas para [0, 1] no formato longo
ggplot(economics_long, aes(x = date, y = value01, color = variable)) +
  geom_line() +
  labs(y = "Valor normalizado (0 a 1)", color = "Série")
A coluna value01 de economics_long é a normalização min-max \((v - \min v)/(\max v - \min v)\), que coloca séries de unidades diferentes na mesma escala.
7.5.4 Mais de Duas Variáveis
Variáveis adicionais podem ser codificadas em cor, tamanho e forma, ou em facetas. No mtcars, por exemplo:
ggplot(mtcars, aes(x = wt, y = mpg, color = factor(cyl), size = hp)) +
  geom_point(alpha = 0.7) +
  labs(x = "Peso (1000 lb)", y = "Milhas por galão",
       color = "Cilindros", size = "Potência (hp)")
Um mapa de calor da matriz de correlação resume, de uma só vez, as relações lineares entre todas as variáveis numéricas (o coeficiente de correlação é definido formalmente no Capítulo de Análise Exploratória de Dados com Python):
cor_df <- as.data.frame(as.table(cor(mtcars)))
names(cor_df) <- c("var1", "var2", "r")

ggplot(cor_df, aes(x = var1, y = var2, fill = r)) +
  geom_tile(color = "white") +
  geom_text(aes(label = round(r, 2)), size = 2.5) +
  scale_fill_gradient2(low = "firebrick", mid = "white", high = "steelblue",
                       midpoint = 0, limits = c(-1, 1)) +
  coord_fixed() +
  labs(x = NULL, y = NULL, fill = "r de Pearson") +
  theme(axis.text.x = element_text(angle = 45, hjust = 1))
Note o uso de uma escala divergente centrada em zero, coerente com a natureza da correlação.
7.5.5 Visualizando a Incerteza
Toda estimativa exibida em um gráfico — uma média, uma proporção, uma curva de regressão — é calculada a partir de uma amostra e, portanto, carrega incerteza. Omitir essa incerteza induz o leitor a tratar diferenças pequenas e ruidosas como reais. Por outro lado, barras de erro são frequentemente mal interpretadas, porque o mesmo símbolo gráfico pode representar quantidades muito diferentes (Cumming e Finch 2005):
| Barra de erro | Fórmula (para uma média) | O que descreve |
|---|---|---|
| Desvio padrão (DP) | \(\bar{y} \pm s\) | A variabilidade dos dados individuais; não diminui com \(n\) |
| Erro padrão (EP) | \(\bar{y} \pm s/\sqrt{n}\) | A precisão da média; diminui como \(1/\sqrt{n}\) |
| Intervalo de confiança de 95% | \(\bar{y} \pm t_{n-1;\,0{,}975}\, s/\sqrt{n}\) | Faixa de valores plausíveis para a média populacional \(\mu\) |
Sob normalidade, o intervalo de confiança decorre de \(T = (\bar{Y} - \mu)/(S/\sqrt{n}) \sim t_{n-1}\): com probabilidade \(1 - \alpha\), \(\lvert T \rvert \le t_{n-1;\,1-\alpha/2}\), e isolando \(\mu\) obtemos o intervalo. Uma barra de \(\pm 1\) EP corresponde, para \(n\) grande, a uma confiança de apenas cerca de 68%. Por isso, a legenda do gráfico deve sempre dizer qual barra está sendo exibida.
Considere \(n = 6\) medidas de um grupo: \(\{12, 15, 14, 10, 13, 14\}\). Temos \(\bar{y} = 78/6 = 13\); os desvios ao quadrado são \(1, 4, 1, 9, 0, 1\), com soma \(16\); logo \(s^2 = 16/5 = 3{,}2\) e \(s \approx 1{,}789\). O erro padrão é \(1{,}789/\sqrt{6} \approx 0{,}730\) e o quantil \(t_{5;\,0{,}975} \approx 2{,}571\). Assim:
- DP: \(13 \pm 1{,}79\), isto é, \([11{,}21;\ 14{,}79]\);
- EP: \(13 \pm 0{,}73\), isto é, \([12{,}27;\ 13{,}73]\);
- IC 95%: \(13 \pm 2{,}571 \times 0{,}730 = 13 \pm 1{,}88\), isto é, \([11{,}12;\ 14{,}88]\).
Com \(n = 6\), o IC 95% é cerca de 2,6 vezes mais largo que a barra de EP. Em R: t.test(c(12, 15, 14, 10, 13, 14))$conf.int.
Dois cuidados de interpretação são importantes. Primeiro, a sobreposição de intervalos de confiança não equivale a ausência de diferença significativa: dois ICs de 95% podem se sobrepor moderadamente e, ainda assim, a diferença entre as médias ser significativa ao nível de 5%. Isso ocorre porque o erro padrão da diferença, \(\sqrt{EP_1^2 + EP_2^2}\), é menor que a soma \(EP_1 + EP_2\). Para grupos independentes com erros padrão semelhantes, uma sobreposição de até cerca de metade do braço de um IC ainda corresponde, aproximadamente, a \(p < 0{,}05\) (Cumming e Finch 2005). Segundo, em medidas repetidas (os mesmos indivíduos em várias condições), as barras de erro de cada condição separadamente não informam sobre a precisão das diferenças, que dependem da correlação entre as medidas.
A banda de confiança de uma reta de regressão, desenhada por geom_smooth(method = "lm"), segue a mesma lógica. Para o modelo \(y = \beta_0 + \beta_1 x + \varepsilon\), a variância da média estimada em \(x_0\) é
\[ \mathrm{Var}\big(\hat{y}(x_0)\big) = \sigma^2\left[\frac{1}{n} + \frac{(x_0 - \bar{x})^2}{\sum_i (x_i - \bar{x})^2}\right], \]
e a banda é \(\hat{y}(x_0) \pm t_{n-2;\,0{,}975}\,\hat{\sigma}\sqrt{\cdot}\). O termo \((x_0 - \bar{x})^2\) explica a forma de hipérbole da banda: ela é mais estreita em \(x_0 = \bar{x}\) e se alarga à medida que nos afastamos do centro dos dados. Atenção: essa é uma banda para a média condicional, e não para observações individuais; o intervalo de predição para uma nova observação acrescenta \(1\) dentro dos colchetes e é bem mais largo.
# Média com IC 95% (normal/t) por classe de veículo
ggplot(mpg, aes(x = reorder(class, hwy), y = hwy)) +
  geom_jitter(width = 0.15, alpha = 0.25, color = "grey40") +
  stat_summary(fun.data = mean_cl_normal, geom = "pointrange",
               color = "firebrick") +           # requer o pacote Hmisc
  coord_flip() +
  labs(x = NULL, y = "Rodovia (mpg)",
       caption = "Pontos vermelhos: média e IC 95% baseado na t de Student")

# Calculando os resumos manualmente e usando geom_errorbar()
resumo <- mpg |>
  group_by(drv) |>
  summarise(n = n(), media = mean(hwy), dp = sd(hwy),
            ep = dp / sqrt(n), t = qt(0.975, df = n - 1),
            li = media - t * ep, ls = media + t * ep)

ggplot(resumo, aes(x = drv, y = media)) +
  geom_col(fill = "grey80", width = 0.6) +
  geom_errorbar(aes(ymin = li, ymax = ls), width = 0.2) +
  labs(x = "Tração", y = "Consumo médio (mpg) com IC 95%")

# Banda de confiança da reta de regressão (95% por padrão)
ggplot(cars, aes(speed, dist)) +
  geom_point() +
geom_smooth(method = "lm", formula = y ~ x, level = 0.95)Gráficos de barras com barras de erro (“gráficos de dinamite”) escondem a distribuição: o mesmo par média–IC pode vir de dados simétricos, bimodais ou com um outlier. Sempre que \(n\) não for muito grande, prefira sobrepor os dados individuais (geom_jitter(), geom_point()) ou combinar o resumo com um boxplot ou violino.
7.5.6 Mapas e Projeções Cartográficas
Dados espaciais são um caso especial em que o sistema de coordenadas carrega significado físico. A Terra é (aproximadamente) uma esfera, e representar sua superfície em um plano exige uma projeção cartográfica — uma função \((\lambda, \varphi) \mapsto (x, y)\) da longitude e latitude para o plano. Um resultado clássico de Gauss (o Theorema Egregium) implica que nenhuma projeção preserva simultaneamente distâncias, áreas e ângulos: toda projeção distorce algo, e a escolha depende do propósito.
- Equirretangular (\(x = \lambda\), \(y = \varphi\)): a mais simples (é o que se obtém ao plotar longitude e latitude em
coord_cartesian()); distorce áreas e formas longe do equador. - Mercator: preserva ângulos (é conforme), útil para navegação. Seu fator de escala na latitude \(\varphi\) é \(\sec \varphi\), de modo que áreas são ampliadas por \(\sec^2 \varphi\): a 60° de latitude, as áreas aparecem quatro vezes maiores do que no equador. Por isso a Groenlândia parece tão grande quanto a África, embora seja cerca de 14 vezes menor.
- Projeções de área igual (Albers, Lambert, Mollweide): preservam áreas e são as recomendadas para mapas coropléticos, nos quais o leitor compara regiões coloridas — distorcer áreas seria distorcer o peso visual de cada região.
No ggplot2, dados geográficos vetoriais no padrão simple features (Pebesma 2018) são desenhados com geom_sf(), e a projeção é escolhida por coord_sf(crs = ...), em que crs é um código de sistema de referência de coordenadas. Para o Brasil, o pacote geobr, do IPEA, fornece malhas territoriais oficiais:
library(sf)
library(geobr)    # malhas territoriais oficiais do Brasil (requer internet)

estados <- read_state(year = 2020)

ggplot(estados) +
  geom_sf(aes(fill = abbrev_state == "PE"), color = "white", linewidth = 0.2) +
  scale_fill_manual(values = c("grey80", "firebrick"), guide = "none") +
  coord_sf(crs = "+proj=aea +lat_0=-12 +lat_1=-2 +lat_2=-22 +lon_0=-54") +  # Albers (área igual)
  theme_void()
Um cuidado adicional em mapas coropléticos: colorir regiões por contagens absolutas (número de casos de uma doença, por exemplo) costuma apenas reproduzir o mapa da população. Na maioria das análises, devem-se mapear taxas (casos por 100 mil habitantes), e taxas de regiões pouco populosas são muito instáveis — um problema de variância que remete, novamente, ao compromisso entre viés e variância.
7.6 Exemplos Práticos no R
Vejamos como aplicar a gramática do ggplot2 em códigos práticos utilizando dados reais ou simulados.
7.6.1 1. Gráfico de Dispersão (Scatterplot)
Para analisar a relação entre duas variáveis contínuas:
library(ggplot2)

# Gráfico de dispersão relacionando velocidade e distância de parada de carros (dados nativos 'cars')
ggplot(data = cars, mapping = aes(x = speed, y = dist)) +
  geom_point(color = "steelblue", size = 3) +
  labs(
    title = "Relação entre Velocidade e Distância de Parada",
    x = "Velocidade (mph)",
    y = "Distância de Parada (ft)"
  ) +
  theme_minimal()
7.6.2 2. Dividindo em Subgráficos (Facetas)
Se quisermos comparar grupos categóricos, adicionamos uma camada de facetas:
# Usando o conjunto de dados nativo 'mpg' para comparar milhas por galão
ggplot(data = mpg, aes(x = displ, y = hwy, color = class)) +
  geom_point(alpha = 0.7) +
  facet_wrap(~ drv) +  # Cria subgráficos baseados no tipo de tração (drv)
  labs(
    title = "Consumo na Rodovia por Litragem do Motor",
    subtitle = "Facetado por tipo de tração (drv)",
    x = "Litragem do Motor (L)",
    y = "Milhas por Galão na Rodovia"
  ) +
  theme_light()
7.6.3 3. Construção Incremental de um Gráfico
Como um gráfico é um objeto, podemos construí-lo passo a passo, armazenando etapas intermediárias:
p <- ggplot(diamonds, aes(x = cut, y = price))   # 1. dados + mapeamento
p <- p + geom_boxplot(fill = "grey85")            # 2. geometria
p <- p + scale_y_log10(labels = scales::label_dollar())  # 3. escala
p <- p + labs(x = "Qualidade do corte", y = "Preço (escala log)")  # 4. rótulos
p <- p + theme_bw()                               # 5. tema
p                                                 # imprime o gráfico
Curiosamente, esse gráfico mostra que diamantes com corte Ideal têm mediana de preço menor do que os de corte Fair. A explicação é uma variável de confusão: o peso (carat), fortemente associado ao preço, é em média menor entre os diamantes de corte ideal. Investigar esse tipo de paradoxo aparente é exatamente o papel da análise exploratória (veja a discussão sobre o paradoxo de Simpson no capítulo seguinte).
7.6.4 4. Anotações e Linhas de Referência
media_hwy <- mean(mpg$hwy)

ggplot(mpg, aes(x = displ, y = hwy)) +
  geom_point(color = "grey50") +
  geom_hline(yintercept = media_hwy, linetype = "dashed", color = "firebrick") +
  annotate("text", x = 6.2, y = media_hwy + 1.5,
           label = paste("Média =", round(media_hwy, 1)), color = "firebrick") +
  geom_point(data = subset(mpg, class == "2seater"),
             color = "darkorange", size = 3) +
  annotate("label", x = 5.7, y = 30, label = "Esportivos (2 lugares)",
           color = "darkorange")
O uso de uma segunda camada com outro conjunto de dados (data = subset(...)) para destacar um subgrupo é um padrão muito poderoso — e uma aplicação direta do conceito de camadas independentes.
7.6.5 5. Combinando Gráficos
O pacote patchwork estende o operador + para combinar gráficos completos em um só painel:
library(patchwork)

p1 <- ggplot(mpg, aes(hwy)) + geom_histogram(binwidth = 2.9)
p2 <- ggplot(mpg, aes(drv, hwy)) + geom_boxplot()
p3 <- ggplot(mpg, aes(displ, hwy)) + geom_point()

(p1 | p2) / p3 + plot_annotation(title = "Três visões do consumo na rodovia")
Na sintaxe do patchwork, | coloca gráficos lado a lado, / empilha-os verticalmente e os parênteses agrupam, exatamente como em uma expressão aritmética; plot_layout(guides = "collect") reúne legendas repetidas em uma só.
7.6.6 6. O Ecossistema de Extensões
A gramática em camadas é extensível: novos geoms, stats, escalas e temas podem ser criados por outros pacotes e combinados livremente com os do ggplot2. Algumas extensões consolidadas:
| Pacote | Finalidade | Exemplo de função |
|---|---|---|
patchwork |
Composição de vários gráficos | p1 + p2, p1 / p2 |
plotly |
Gráficos interativos para a web (Sievert 2020) | ggplotly(p) |
ggrepel |
Rótulos de texto que não se sobrepõem | geom_text_repel() |
GGally |
Matrizes de gráficos de pares | ggpairs() |
gganimate |
Animações (por exemplo, ao longo do tempo) | transition_time() |
ggridges |
Densidades empilhadas (ridgeline plots) | geom_density_ridges() |
colorspace |
Paletas HCL e simulação de daltonismo | scale_fill_continuous_sequential() |
sf |
Dados espaciais vetoriais | geom_sf() (no próprio ggplot2) |
library(plotly)
library(ggrepel)
library(GGally)

# Interatividade: passe o mouse sobre os pontos para ver os valores
p <- ggplot(mpg, aes(displ, hwy, color = class, text = model)) +
  geom_point()
ggplotly(p, tooltip = c("text", "x", "y"))

# Rótulos sem sobreposição para os carros mais econômicos
ggplot(mtcars, aes(wt, mpg, label = rownames(mtcars))) +
  geom_point() +
  geom_text_repel(data = subset(mtcars, mpg > 25), size = 3)

# Matriz de gráficos de pares, com correlações no triângulo superior
ggpairs(iris, columns = 1:4, aes(color = Species, alpha = 0.5))
Gráficos interativos são excelentes para exploração (identificar um ponto, dar zoom, filtrar categorias pela legenda) e para painéis na web, mas não substituem um gráfico estático bem desenhado em relatórios e artigos impressos: a mensagem principal não deve depender de o leitor passar o mouse sobre o gráfico.
7.7 Salvando Gráficos com ggsave()
A função ggsave() salva o último gráfico exibido (ou o objeto informado em plot) em arquivo; o formato é deduzido pela extensão:
ggsave("consumo_rodovia.png", plot = p, width = 16, height = 10,
       units = "cm", dpi = 300)

ggsave("consumo_rodovia.pdf", plot = p, width = 16, height = 10, units = "cm")
Dois conceitos importantes:
- Formatos vetoriais (PDF, SVG) descrevem o gráfico por primitivas geométricas e podem ser ampliados sem perda de qualidade — ideais para artigos e documentos LaTeX;
- Formatos matriciais (PNG, JPEG) armazenam pixels; a resolução é controlada por
dpi(pontos por polegada). Para impressão, use ao menos 300 dpi; o tamanho em pixels élargura (pol.) × dpi. Prefira PNG a JPEG em gráficos, pois a compressão do JPEG gera artefatos em linhas e textos.
Fixar width e height no código é uma prática de reprodutibilidade: o gráfico salvo não dependerá do tamanho da janela de visualização do RStudio no momento da execução.
7.8 Erros Comuns e Boas Práticas
+no início da linha: o operador+deve ficar no final da linha anterior; caso contrário, o R entende que o comando terminou.- Confundir
|>(ou%>%) com+: o pipe passa dados entre funções de manipulação; dentro doggplot(), as camadas são somadas com+. - Variáveis numéricas que são categorias: códigos como
cyl(4, 6, 8) são numéricos no data frame; para obter cores discretas, usefactor(cyl). - Excesso de cores e formas: mais de 6 a 8 categorias em cor tornam a legenda ilegível; considere facetas ou agrupar categorias raras.
- Eixos de barras truncados e gráficos 3D decorativos distorcem a percepção e devem ser evitados.
- Paletas arco-íris para dados contínuos e cores que diferem apenas no eixo vermelho–verde prejudicam a leitura e excluem leitores daltônicos; prefira viridis, ColorBrewer ou paletas HCL, e codificações redundantes.
- Barras de erro sem legenda: informe sempre se as barras representam desvio padrão, erro padrão ou intervalo de confiança.
- Aceitar os padrões sem pensar: as 30 classes do
geom_histogram()e a largura de banda de Silverman são pontos de partida, não verdades; experimente diferentes valores e escolha conscientemente. - Confundir
scale_*_log10()comcoord_transform(): o primeiro transforma antes dos stats; o segundo, apenas na hora de desenhar. - Gráficos exploratórios vs. explanatórios: na exploração, priorize velocidade e quantidade; na comunicação, refine rótulos, títulos e destaques (veja o Capítulo de Storytelling com Dados).
7.9 Resumo do Capítulo
- A Gramática dos Gráficos de Wilkinson, reformulada em camadas por Wickham, descreve qualquer gráfico como a composição de dados, mapeamentos estéticos, geoms, stats, ajustes de posição, escalas, sistemas de coordenadas, facetas e temas.
- O
ggplot2exige dados arrumados (tidy);pivot_longer()converte tabelas largas para o formato longo. - Mapear (dentro de
aes()) é diferente de fixar um atributo (fora deaes()). - Stats calculam resumos (contagens, classes, quartis, curvas suavizadas) acessíveis via
after_stat(). - A escolha do gráfico depende do tipo e do número de variáveis; pela hierarquia de Cleveland e McGill, a informação principal deve ser codificada em posição.
- No histograma e na densidade por kernel, a largura de classe/banda controla o compromisso entre viés e variância; as regras de Sturges, Scott, Freedman–Diaconis e Silverman oferecem pontos de partida.
- O boxplot usa quartis e cercas \(Q_1 - 1{,}5\,\mathrm{IQR}\) e \(Q_3 + 1{,}5\,\mathrm{IQR}\) para resumir a distribuição e sinalizar outliers.
- Tratando o histograma como estimador de densidade, o AMISE \(\frac{1}{nh} + \frac{h^2}{12}R(f')\) é minimizado por \(h^* \propto n^{-1/3}\); com referência normal, obtém-se a regra de Scott, \(3{,}49\,\sigma\,n^{-1/3}\). A regra de Sturges tem justificativa binomial e suaviza demais para \(n\) grande.
- No KDE, o viés é de ordem \(h^2 f''(x)\) e a variância de ordem \(1/(nh)\); a largura ótima decresce como \(n^{-1/5}\) e o erro como \(n^{-4/5}\), melhor que o do histograma. A escolha de \(h\) importa muito mais que a do kernel.
- A ECDF é um estimador não viesado de \(F\), sem parâmetros de suavização, que converge uniformemente (Glivenko–Cantelli) e admite bandas de confiança (DKW). O QQ-plot compara a forma da distribuição com uma referência e revela assimetria, caudas pesadas e outliers.
- Transformações de escala (log, raiz, Box–Cox) podem ser justificadas pela estabilização da variância (método delta);
scale_*()transforma antes dos stats ecoord_transform(), depois. - O boxplot usa quartis e cercas \(Q_1 - 1{,}5\,\mathrm{IQR}\) e \(Q_3 + 1{,}5\,\mathrm{IQR}\) para resumir a distribuição e sinalizar outliers.
- O LOESS ajusta polinômios por mínimos quadrados ponderados (pesos tricúbicos) em vizinhanças de tamanho
span; é um suavizador linear \(\hat{\mathbf{y}} = \mathbf{S}\mathbf{y}\) com \(\operatorname{tr}(\mathbf{S})\) graus de liberdade efetivos. - Escalas de cor devem ser qualitativas, sequenciais ou divergentes conforme a natureza da variável, construídas em espaços perceptualmente uniformes (HCL, viridis), com luminância monótona e seguras para daltônicos; paletas arco-íris devem ser evitadas.
- Barras de erro podem representar DP, EP ou IC — quantidades muito diferentes — e devem sempre ser identificadas; a banda de confiança de uma regressão tem forma de hipérbole.
- Mapas exigem projeções cartográficas, que sempre distorcem algo; mapas coropléticos pedem projeções de área igual e taxas, e não contagens.
ggsave()com dimensões fixas garante gráficos reprodutíveis; formatos vetoriais são preferíveis para publicações. Extensões comopatchwork,plotlyeggrepelampliam a gramática.
7.10 Exercícios Propostos
- (Teórico) Explique, com suas palavras, a diferença entre um geom e um stat. Cite dois pares (geom, stat padrão) e descreva quais variáveis cada stat calcula.
- (Teórico) Por que o código
ggplot(mpg, aes(displ, hwy)) + geom_point(aes(color = "blue"))não produz pontos azuis? Reescreva-o corretamente. - (Cálculo) Para uma amostra com \(n = 1000\) observações, \(s = 12\) e \(\mathrm{IQR} = 15\), calcule o número de classes pela regra de Sturges e as larguras de classe pelas regras de Scott e de Freedman–Diaconis. Qual regra produz o histograma mais detalhado?
- (Cálculo) Para a amostra \(\{3, 5, 6, 6, 7, 8, 9, 10, 11, 30\}\), calcule à mão \(Q_1\), \(Q_2\) e \(Q_3\) (método tipo 7), as cercas do boxplot e identifique os outliers. Confira em R com
quantile()egeom_boxplot(). - (Cálculo) Com a amostra \(\{0, 1, 3\}\), kernel gaussiano e \(h = 0{,}5\), calcule \(\hat{f}_h(1)\). Repita para \(h = 2\) e comente o efeito da largura de banda.
- (Teórico) Mostre que, se \(\int K(u)\,du = 1\) e \(K \ge 0\), então a estimativa \(\hat{f}_h\) também é uma densidade (não negativa e integra 1). Dica: use a mudança de variável \(u = (x - x_i)/h\).
- (Prático) Com o conjunto
diamonds, construa histogramas depricecombinwidthigual a 50, 500 e 5000. Descreva o que cada um revela ou esconde. Em seguida, usescale_x_log10()e comente a forma da distribuição. - (Prático) Usando
diamonds, comparegeom_bar(position = "stack"),"dodge"e"fill"para as variáveiscolorecut. Que pergunta cada gráfico responde melhor? - (Prático) Reproduza o mapa de calor da matriz de correlação de
mtcars, ordenando as variáveis pela primeira componente de um agrupamento hierárquico (hclust(as.dist(1 - cor(mtcars)))$order). - (Prático) Usando
economics, crie um gráfico de linha da taxa de poupança pessoal (psavert) ao longo do tempo, adicione uma suavização LOESS comspan = 0.2e destaque comannotate("rect", ...)o período de 2007 a 2009. - (Prático) Investigue o “paradoxo” do preço por corte em
diamonds: refaça o boxplot depriceporcutrestrito a diamantes comcaratentre 0,9 e 1,1. A conclusão muda? Explique. - (Prático) Crie um gráfico de dispersão de
Sepal.Lengthvs.Petal.Lengthnoiris, colorido por espécie, com retas de regressão separadas por espécie e uma reta global (em preto). Salve-o em PDF e em PNG a 300 dpi com 15 × 10 cm. - (Discussão) Com base na hierarquia de Cleveland e McGill, argumente por que um gráfico de barras costuma ser preferível a um gráfico de setores. Em que situação um gráfico de setores ainda pode ser aceitável?
- (Teórico) Mostre que, se \(f\) é a densidade \(N(\mu, \sigma^2)\), então \(R(f') = \int f'(x)^2\,dx = 1/(4\sqrt{\pi}\,\sigma^3)\). Use esse resultado para deduzir a constante \(3{,}49\) da regra de Scott a partir de \(h^* = (6/(n R(f')))^{1/3}\). Dica: \(f'(x) = -\frac{x - \mu}{\sigma^2} f(x)\) e \(f(x)^2\) é proporcional a uma densidade normal com variância \(\sigma^2/2\).
- (Teórico) A partir do AMISE do KDE, \(\frac{R(K)}{nh} + \frac{h^4}{4}\mu_2(K)^2 R(f'')\), derive a largura ótima \(h^*\) e mostre que \(\mathrm{AMISE}(h^*) = \frac{5}{4}\left[\mu_2(K)^2 R(K)^4 R(f'')\right]^{1/5} n^{-4/5}\).
- (Teórico) Mostre que, para \(x\) fixo, \(\mathbb{E}[F_n(x)] = F(x)\) e \(\mathrm{Var}[F_n(x)] = F(x)(1 - F(x))/n\). Usando a desigualdade DKW, determine o tamanho de amostra necessário para que a banda de 95% em torno da ECDF tenha meia-largura de no máximo 0,05.
- (Cálculo) Para a amostra \(\{1{,}2;\ 2{,}5;\ 2{,}9;\ 3{,}4;\ 4{,}1;\ 9{,}8\}\), calcule as posições de plotagem \(p_i\) com \(a = 3/8\), os quantis normais correspondentes e a reta de referência pelos quartis. Esboce o QQ-plot e interprete. Confira com
qqnorm()egeom_qq(). - (Cálculo) Repita o exemplo resolvido do LOESS para estimar \(m(2)\), com os mesmos dados,
span = 1e grau 1. Agora os pesos não são simétricos em torno de \(x_0\): monte e resolva o sistema de mínimos quadrados ponderados (2 × 2) e confira o resultado comloess(). - (Teórico) Use o método delta para mostrar que, se \(X \sim \text{Poisson}(\mu)\), então \(\mathrm{Var}(\sqrt{X}) \approx 1/4\), independentemente de \(\mu\). Que transformação estabiliza a variância de uma proporção \(\hat{p}\) com \(\mathrm{Var}(\hat{p}) = p(1-p)/n\)?
- (Prático) Com
mpg, compare as densidades dehwyobtidas combw = "nrd0","nrd","SJ"e"ucv"em um único gráfico. Qual delas revela a bimodalidade? Qual parece subsuavizar? - (Prático) Para dois grupos com \(n = 10\) cada, simule dados com médias 10 e 11,5 e desvio padrão 1,5. Faça um gráfico com as médias e ICs de 95%, verifique se os intervalos se sobrepõem e compare com o valor-p de
t.test(). Repita o experimento várias vezes e comente. - (Prático) Refaça um gráfico com três grupos coloridos pela paleta padrão do
ggplot2e simule sua aparência para deuteranopia e protanopia comcolorspace::deutan()ecolorspace::protan(). Proponha uma versão acessível. - (Prático) Usando
geobr(ou outra fonte de malhas), construa um mapa coroplético dos estados do Nordeste com uma variável de sua escolha expressa como taxa. Compare o mapa nas projeções equirretangular e de Albers.
7.11 Leituras Recomendadas
- Wickham (2016) — o livro oficial do
ggplot2, com os fundamentos da gramática em camadas; a versão online mais recente está em https://ggplot2-book.org/. - Wickham (2010) — artigo que formaliza a gramática em camadas implementada no
ggplot2. - Wilkinson (2005) — a obra original da Gramática dos Gráficos, de caráter mais abstrato e matemático.
- Wickham e Grolemund (2017) — R for Data Science, capítulos de visualização e análise exploratória.
- Cleveland e McGill (1984) — estudo clássico sobre percepção gráfica que fundamenta muitas boas práticas.
- Tufte (1983) — referência clássica sobre excelência gráfica, densidade de informação e pequenos múltiplos.
- Silverman (1986) — texto de referência sobre estimação de densidade por kernel e escolha da largura de banda.
- Freedman e Diaconis (1981) e Scott (1979) — fundamentos teóricos da escolha da largura de classe em histogramas; Scott (2015) apresenta a teoria completa de histogramas e densidades multivariadas.
- Wand e Jones (1995) — monografia concisa e rigorosa sobre suavização por kernel, com as derivações de viés, variância e AMISE.
- Rosenblatt (1956) e Parzen (1962) — os artigos que introduziram o estimador de densidade por kernel; Sheather e Jones (1991) propõe o seletor de largura de banda de Sheather–Jones.
- Cleveland (1979) e Cleveland e Devlin (1988) — artigos que introduzem e desenvolvem o LOESS.
- Wilk e Gnanadesikan (1968) — artigo clássico sobre gráficos de probabilidade e QQ-plots.
- Ware (2012) — percepção visual aplicada ao design de visualizações, incluindo teoria das cores.
- Crameri, Shephard, e Heron (2020) — por que paletas arco-íris distorcem dados científicos e como escolher paletas perceptualmente uniformes.
- Cumming e Finch (2005) — guia para interpretar corretamente barras de erro e intervalos de confiança em gráficos.
- Sievert (2020) — gráficos interativos com
plotlyeshinya partir do R. - Pebesma (2018) — o padrão simple features para dados espaciais no R, base do
geom_sf().