2 Introdução à Inteligência Artificial
Neste capítulo, abordaremos a história e os conceitos basilares de Inteligência Artificial, Machine Learning e Deep Learning, incluindo marcos como o Teste de Turing. Discutiremos também as diferentes abordagens da área (simbólica, conexionista e estatística), o conceito de agente inteligente, o funcionamento do neurônio artificial e do perceptron, as ideias centrais por trás das redes neurais profundas e dos grandes modelos de linguagem, e, por fim, as questões éticas e regulatórias que acompanham o uso de sistemas de IA.
2.1 O que é Inteligência?
Para definir a Inteligência Artificial, precisamos primeiro refletir sobre o conceito de inteligência humana. Se pensarmos na pessoa mais inteligente que conhecemos, o que nos faz considerá-la inteligente? É o raciocínio lógico rápido? É a capacidade de absorver e aplicar novos conhecimentos? A criatividade contínua? A percepção apurada de detalhes? Ou talvez a empatia profunda para decodificar sentimentos alheios?
De acordo com Sternberg (2000), a inteligência humana é multifacetada e envolve componentes neurológicos e psicológicos:
- O cérebro, que representa o órgão biológico físico de processamento.
- A mente, associada à nossa capacidade abstrata de pensar, lembrar, sentir e raciocinar.
- O pensamento lógico, a habilidade mecânica de solucionar problemas práticos e teóricos.
- A compreensão, a capacidade de absorver e interpretar informações do ambiente.
- A aplicabilidade, que se refere ao uso prático do conhecimento adquirido no cotidiano.
Independentemente de estarmos falando de gênios matemáticos ou vendedores altamente persuasivos, todos nós utilizamos habilidades cognitivas fundamentais no dia a dia. Assim, a inteligência pode ser sintetizada como a capacidade de um indivíduo de realizar tarefas e adaptar-se ao ambiente utilizando seu próprio conhecimento e interpretação.
2.1.1 Quatro maneiras de definir a Inteligência Artificial
Se a própria inteligência humana é difícil de definir, não surpreende que não exista uma definição única de Inteligência Artificial. Russell e Norvig (2021) organizam as definições propostas ao longo da história em duas dimensões: (i) se o objetivo é reproduzir o pensamento ou o comportamento; e (ii) se a referência é o desempenho humano ou um ideal de racionalidade. Disso resultam quatro abordagens:
| Referência: ser humano | Referência: racionalidade | |
|---|---|---|
| Pensamento | Pensar como humanos: modelagem cognitiva, que busca reproduzir os processos mentais humanos (ciência cognitiva). | Pensar racionalmente: as “leis do pensamento”, baseadas na lógica formal e na inferência correta. |
| Comportamento | Agir como humanos: a abordagem do Teste de Turing — o sistema é inteligente se seu comportamento for indistinguível do humano. | Agir racionalmente: a abordagem do agente racional, que age para alcançar o melhor resultado esperado. |
A abordagem do agente racional é a adotada pela maior parte da IA contemporânea, inclusive pelo aprendizado de máquina: em vez de imitar seres humanos (que cometem erros sistemáticos), busca-se construir sistemas que tomem decisões ótimas, ou aproximadamente ótimas, segundo um critério explícito. Essa ideia será formalizada na seção sobre agentes inteligentes.
2.2 Alan Turing e as Origens da Inteligência Artificial
Embora o termo “Inteligência Artificial” tenha sido cunhado formalmente em 1956 na famosa Conferência de Dartmouth, as raízes teóricas do campo remontam aos anos 1940 (Newell 1982). O pioneiro matemático inglês Alan Turing afirmou em 1947 que a inteligência das máquinas poderia ser estudada e simulada através de computadores e programas.
Antes disso, em 1936, Turing já havia proposto um modelo matemático abstrato de computação — a hoje chamada máquina de Turing —, capaz de executar qualquer procedimento descrito por um algoritmo. Essa formalização é a base teórica de todos os computadores modernos e sustenta uma ideia central para a IA: se o raciocínio puder ser descrito como manipulação de símbolos segundo regras, então, em princípio, ele pode ser executado por uma máquina.
Em 1950, em seu célebre artigo “Computing Machinery and Intelligence” (Turing (1950)), Turing propôs uma resposta prática para a pergunta filosófica “As máquinas podem pensar?”. Ele sugeriu substituir essa questão por um teste prático de comportamento chamado Jogo da Imitação ou Teste de Turing.
2.2.1 O Teste de Turing: Como Funciona?
O teste original de Turing consistia em dois cenários:
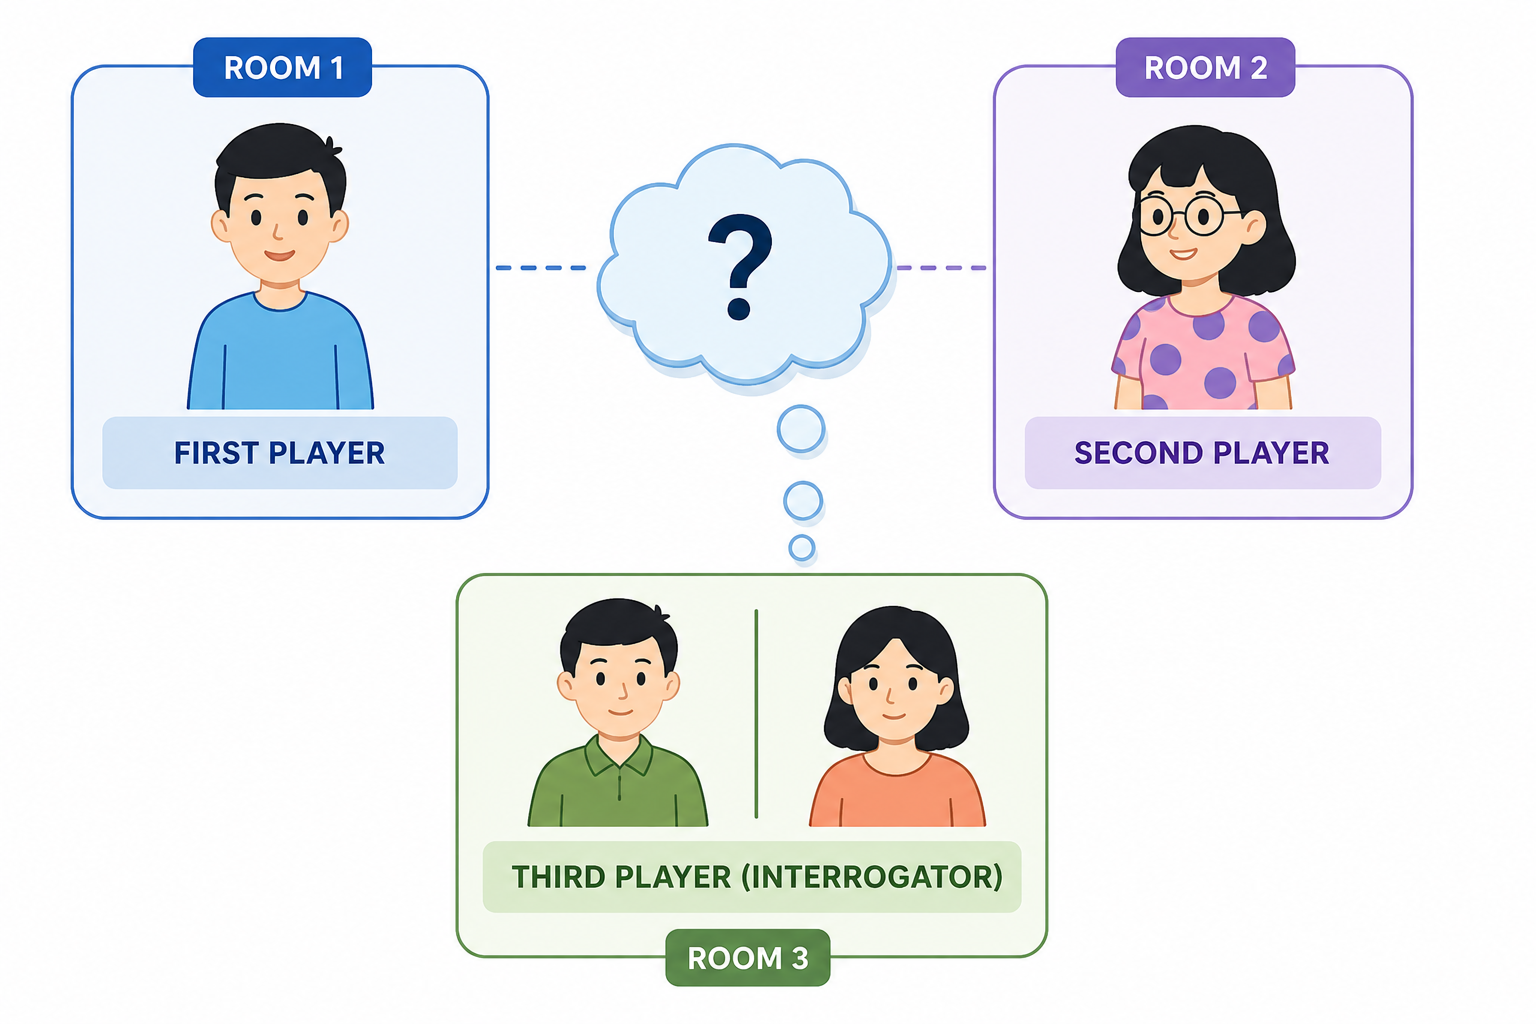
- Cenário 1 (Humano vs. Humano): Um interrogador humano tenta adivinhar, por meio de mensagens escritas (teclado e tela), o gênero de dois participantes em salas fechadas (um homem e uma mulher). O homem tenta ativamente enganar o interrogador fingindo ser mulher, enquanto a mulher tenta ajudar o interrogador a descobrir a verdade.
- Cenário 2 (Máquina vs. Humano): Turing propôs substituir o jogador que tenta enganar o interrogador por um computador. Se o interrogador, após realizar uma série de perguntas e ler as respostas, não conseguir distinguir o computador do participante humano de forma consistente (com uma taxa de erro significativa), a máquina passa no Teste de Turing e pode ser considerada “inteligente”.
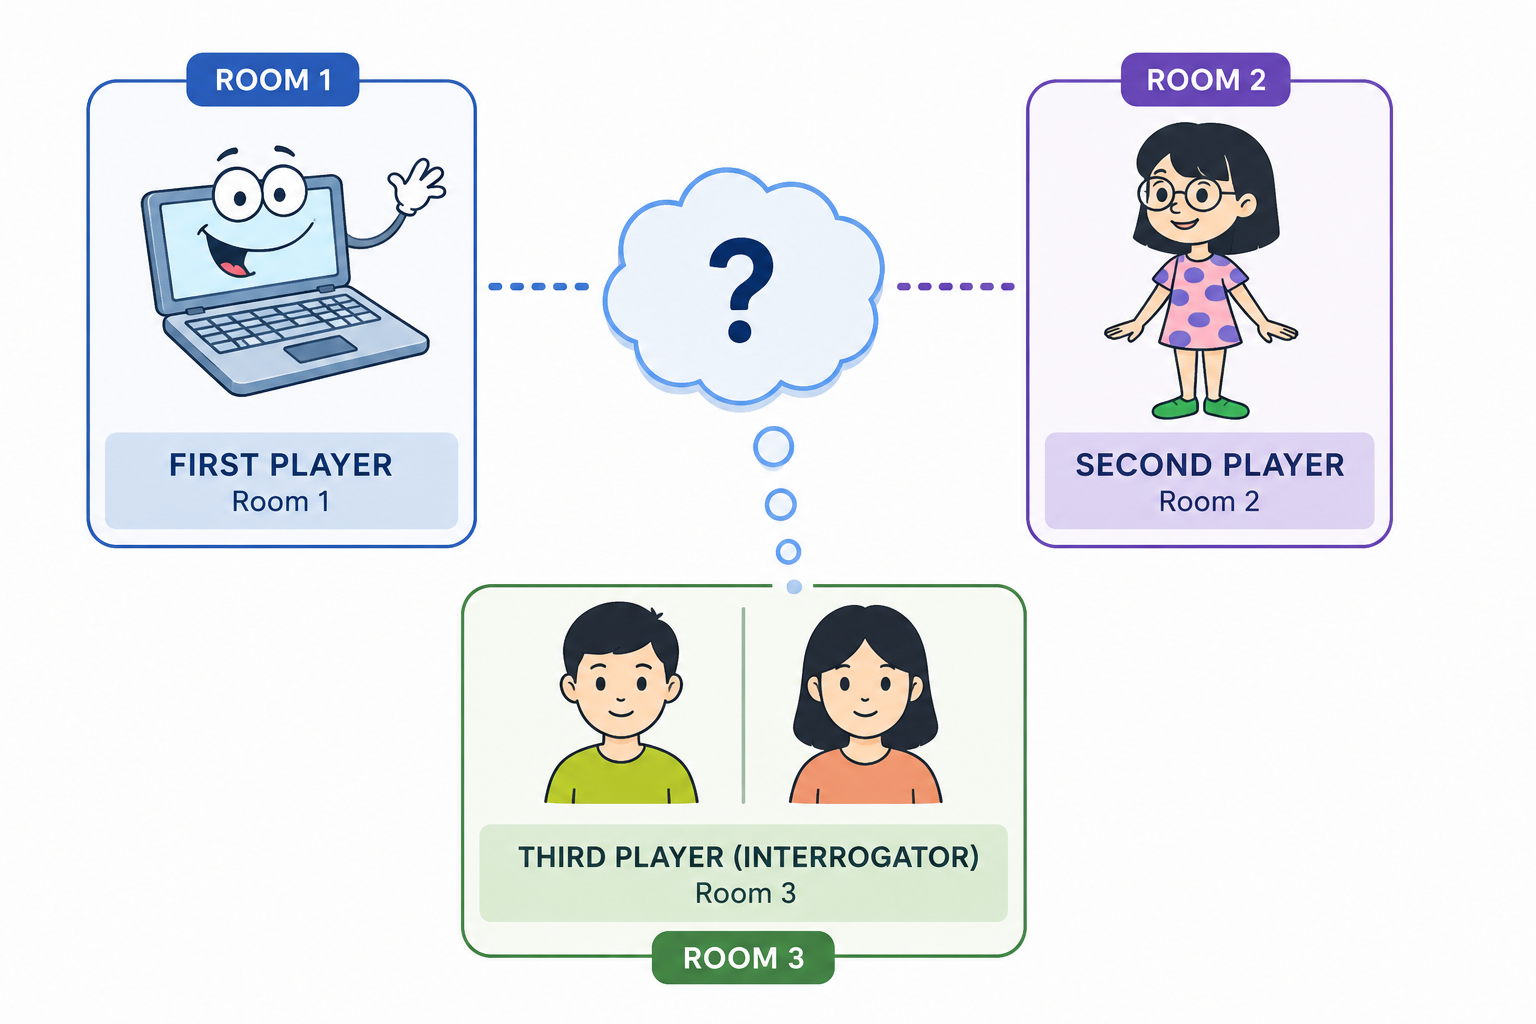
Este teste estabeleceu a visão funcional e empírica da inteligência artificial: se um sistema age de maneira indistinguível de um humano inteligente, ele deve ser classificado como inteligente.
No mesmo artigo, Turing fez uma previsão quantitativa: acreditava que, em cerca de cinquenta anos, seria possível programar computadores com capacidade de armazenamento da ordem de \(10^9\) bits para jogar o jogo da imitação tão bem que um interrogador médio não teria mais de 70% de chance de fazer a identificação correta após cinco minutos de perguntas (Turing 1950). Turing também antecipou e respondeu a diversas objeções à ideia de máquinas pensantes — entre elas a objeção teológica, a objeção matemática (baseada no teorema da incompletude de Gödel), o argumento da consciência e a chamada “objeção de Lady Lovelace”, segundo a qual uma máquina só faz aquilo que mandamos que ela faça. À última, Turing respondeu propondo máquinas que aprendem, programadas como uma “mente infantil” que seria educada — uma antecipação notável do aprendizado de máquina.
O Teste de Turing pode ser visto como um problema de classificação binária realizado por um juiz humano: dada uma conversa, o interrogador deve decidir se o interlocutor é humano ou máquina. Se a máquina for perfeitamente indistinguível, a probabilidade de acerto do juiz é \(1/2\), como num lançamento de moeda. Assim, testar se uma máquina “passa no teste” é, essencialmente, testar a hipótese \(H_0: p = 0{,}5\) contra \(H_1: p > 0{,}5\), em que \(p\) é a probabilidade de o juiz acertar. Com \(n = 100\) conversas e \(x = 58\) acertos, por exemplo, a estatística aproximada é \(z = (0{,}58 - 0{,}5)/\sqrt{0{,}25/100} = 1{,}6\), e o valor-p unilateral é aproximadamente \(0{,}055\): não haveria evidência forte, ao nível de 5%, de que o juiz distingue a máquina do humano.
2.2.2 Críticas ao Teste de Turing
O Teste de Turing é um marco histórico, mas recebeu críticas importantes:
- Comportamento não é compreensão. Em 1966, Joseph Weizenbaum criou o ELIZA, um programa que simulava um psicoterapeuta reformulando as frases do usuário em perguntas a partir de regras simples de casamento de padrões (Weizenbaum 1966). Muitas pessoas atribuíram compreensão e empatia ao programa, embora ele não tivesse nenhum modelo do significado das frases. Isso mostra como é fácil “enganar” interrogadores humanos com truques superficiais.
- O teste é antropocêntrico. Ele mede a capacidade de imitar humanos, inclusive seus erros, e não a inteligência em si. Uma máquina que calculasse instantaneamente produtos de números grandes seria facilmente desmascarada — não por falta de inteligência, mas por excesso de competência.
- O teste é restrito à linguagem. Ele não avalia percepção, ação no mundo físico ou aprendizado de novas habilidades.
- O argumento do Quarto Chinês — a crítica filosófica mais famosa, discutida a seguir.
2.2.3 O Quarto Chinês de Searle
Em 1980, o filósofo John Searle propôs um experimento mental conhecido como Quarto Chinês (Chinese Room) (Searle 1980). Imagine uma pessoa que não sabe nada de chinês, trancada em um quarto com um enorme livro de regras escrito em português. Por uma fenda, ela recebe folhas com símbolos chineses (perguntas). Consultando o livro, que diz apenas coisas como “se receber tal sequência de símbolos, devolva tal outra sequência”, ela produz respostas em chinês e as devolve pela fenda. Para quem está fora do quarto, as respostas são indistinguíveis das de um falante nativo — o quarto “passa no Teste de Turing” em chinês.
E, no entanto, argumenta Searle, a pessoa no quarto não entende uma palavra de chinês: ela apenas manipula símbolos de acordo com sua forma (sintaxe), sem acesso ao seu significado (semântica). Como um computador faz exatamente isso — manipula símbolos segundo regras —, Searle concluiu que a execução de um programa, por si só, não é suficiente para produzir compreensão genuína. Ele distinguiu:
- IA fraca (no sentido de Searle): a tese de que computadores são ferramentas úteis para simular e estudar a mente.
- IA forte (no sentido de Searle): a tese de que um computador adequadamente programado literalmente tem uma mente e estados cognitivos.
Searle aceitava a primeira e rejeitava a segunda. Entre as respostas clássicas ao argumento está a resposta do sistema: embora a pessoa não entenda chinês, o sistema completo (pessoa + livro + papéis) entenderia. Searle replicou que a pessoa poderia memorizar todo o livro e ainda assim não entender chinês. O debate permanece aberto e ganhou nova relevância com os grandes modelos de linguagem atuais.
Note que os termos “IA fraca” e “IA forte” são usados com dois sentidos na literatura: o sentido filosófico de Searle (simular versus ter uma mente) e o sentido de escopo (IA restrita a uma tarefa versus IA geral), apresentado mais adiante neste capítulo. Os dois sentidos são relacionados, mas não idênticos.
2.3 Uma Breve História da Inteligência Artificial
A história da IA é marcada por ciclos de grande otimismo, seguidos de frustração e redução de financiamento — os chamados invernos da IA (AI winters) —, e por renascimentos impulsionados por novas ideias, mais dados e mais capacidade computacional.
2.3.1 Precursores (1943–1955)
- 1943 — O neurônio de McCulloch e Pitts. Warren McCulloch e Walter Pitts propuseram um modelo matemático simplificado do neurônio biológico, mostrando que redes desses neurônios poderiam computar funções lógicas (McCulloch e Pitts 1943). É o ponto de partida da abordagem conexionista.
- 1950 — Turing publica “Computing Machinery and Intelligence” (Turing 1950).
2.3.2 O nascimento: Dartmouth (1956)
Em 1955, John McCarthy, Marvin Minsky, Nathaniel Rochester e Claude Shannon redigiram uma proposta para um projeto de pesquisa de verão no Dartmouth College, realizado em 1956. A proposta, na qual aparece pela primeira vez a expressão artificial intelligence, partia da conjectura de que “todo aspecto do aprendizado ou qualquer outra característica da inteligência pode, em princípio, ser descrito com tanta precisão que uma máquina pode ser construída para simulá-lo” (McCarthy et al. 2006). Entre os temas listados estavam o uso da linguagem por computadores, redes neurais, autoaperfeiçoamento, abstração e criatividade. O encontro de Dartmouth é considerado o marco fundador da IA como campo de pesquisa.
2.3.3 Os anos de entusiasmo (1956–1974)
Seguiram-se anos de resultados impressionantes para a época: o Logic Theorist e o General Problem Solver de Newell e Simon, que provavam teoremas e resolviam quebra-cabeças; o programa de damas de Arthur Samuel, que melhorava jogando contra si mesmo (Samuel 1959) (ver o Capítulo de Introdução ao Aprendizado de Máquina); a linguagem LISP, criada por McCarthy; e o perceptron de Frank Rosenblatt (Rosenblatt 1958), uma máquina capaz de aprender a classificar padrões a partir de exemplos. As previsões eram extremamente otimistas, e muitos pesquisadores acreditavam que máquinas com inteligência humana surgiriam em poucas décadas.
2.3.4 O primeiro inverno (meados dos anos 1970)
Os problemas reais mostraram-se muito mais difíceis que os problemas de brinquedo. Três obstáculos se destacaram: (i) a explosão combinatória — muitos métodos funcionavam por busca exaustiva, cujo custo cresce exponencialmente com o tamanho do problema; (ii) a falta de conhecimento de senso comum; e (iii) as limitações do perceptron, demonstradas formalmente por Minsky e Papert no livro Perceptrons (Minsky e Papert 1969), que mostrou que um perceptron de uma camada não consegue representar funções simples como o OU-exclusivo (XOR). No Reino Unido, o relatório Lighthill (1973) avaliou negativamente o progresso da área, e o financiamento foi drasticamente reduzido em vários países.
2.3.5 Sistemas especialistas (anos 1980)
A IA ressurgiu comercialmente com os sistemas especialistas (expert systems): programas que codificam o conhecimento de especialistas humanos em grandes bases de regras do tipo “SE condição ENTÃO conclusão”, acompanhadas de um motor de inferência. Exemplos célebres são o MYCIN, voltado ao diagnóstico de infecções bacterianas, e o R1/XCON, que configurava computadores da Digital Equipment Corporation. Esses sistemas funcionavam bem em domínios estreitos, mas eram caros de construir e manter (o “gargalo da aquisição de conhecimento”), frágeis diante de situações não previstas e incapazes de aprender.
2.3.6 O segundo inverno e o retorno conexionista (final dos anos 1980)
No fim da década de 1980, o mercado de sistemas especialistas e de máquinas dedicadas à linguagem LISP entrou em colapso, dando início a um segundo inverno. Paralelamente, porém, a abordagem conexionista renascia: a popularização do algoritmo de retropropagação do erro (backpropagation) por Rumelhart, Hinton e Williams (Rumelhart, Hinton, e Williams 1986) permitiu treinar redes neurais de múltiplas camadas, superando a limitação apontada por Minsky e Papert.
2.3.7 A virada estatística (anos 1990 e 2000)
Nos anos 1990, a IA aproximou-se fortemente da Estatística e da teoria das probabilidades. Ganharam destaque as redes bayesianas, os modelos ocultos de Markov (usados em reconhecimento de fala), as máquinas de vetores de suporte (Cortes e Vapnik 1995) e os métodos de conjunto, como as florestas aleatórias (Breiman 2001). Em vez de codificar conhecimento manualmente, passou-se a aprendê-lo dos dados e a tratar a incerteza explicitamente. Em 1997, o computador Deep Blue, da IBM, venceu o campeão mundial de xadrez Garry Kasparov — embora com base principalmente em busca e avaliação de posições, e não em aprendizado.
2.3.8 A era do aprendizado profundo (2006 em diante)
Três fatores convergiram para o renascimento das redes neurais em grande escala: grandes bases de dados rotulados (como a ImageNet), processamento paralelo em GPUs e avanços algorítmicos (novas funções de ativação, inicializações e técnicas de regularização). Em 2012, a rede convolucional conhecida como AlexNet reduziu drasticamente o erro na competição de classificação de imagens ImageNet (Krizhevsky, Sutskever, e Hinton 2012), marcando o início da era do deep learning (LeCun, Bengio, e Hinton 2015). Em 2016, o sistema AlphaGo, da DeepMind, combinando redes neurais profundas, busca em árvore e aprendizado por reforço, venceu o campeão Lee Sedol no jogo Go — considerado muito mais difícil que o xadrez para computadores.
2.3.9 Transformers, grandes modelos de linguagem e IA generativa (2017 em diante)
Em 2017, a arquitetura Transformer, baseada em um mecanismo chamado atenção (attention), foi proposta para tradução automática (Vaswani et al. 2017). Ela se mostrou extremamente escalável e tornou-se a base dos grandes modelos de linguagem (Large Language Models — LLMs), treinados com enormes coleções de textos. Modelos como o GPT-3 mostraram que, em escala suficiente, um único modelo de linguagem consegue realizar muitas tarefas a partir de poucos exemplos fornecidos no próprio texto de entrada (Brown et al. 2020). O lançamento público do ChatGPT, no final de 2022, levou a IA generativa ao cotidiano de centenas de milhões de pessoas.
| Ano | Marco |
|---|---|
| 1943 | Neurônio artificial de McCulloch e Pitts |
| 1950 | Turing propõe o Jogo da Imitação |
| 1956 | Conferência de Dartmouth: nasce o termo “Inteligência Artificial” |
| 1958 | Perceptron de Rosenblatt |
| 1959 | Samuel cunha o termo machine learning com o jogo de damas |
| 1966 | ELIZA, de Weizenbaum |
| 1969 | Perceptrons, de Minsky e Papert |
| 1973–1980 | Primeiro inverno da IA |
| 1980–1987 | Auge dos sistemas especialistas |
| 1986 | Popularização da retropropagação |
| 1987–1993 | Segundo inverno da IA |
| 1995 | Máquinas de vetores de suporte (Cortes e Vapnik) |
| 1997 | Deep Blue vence Kasparov |
| 2012 | AlexNet e o início da era do deep learning |
| 2016 | AlphaGo vence Lee Sedol |
| 2017 | Arquitetura Transformer |
| 2020–2022 | GPT-3 e popularização da IA generativa com o ChatGPT |
2.4 Abordagens da IA: Simbólica, Conexionista e Estatística
Ao longo dessa história, três grandes paradigmas disputaram (e, cada vez mais, combinaram) o protagonismo:
| Aspecto | Simbólica | Conexionista | Estatística/Probabilística |
|---|---|---|---|
| Ideia central | Inteligência como manipulação de símbolos por regras lógicas | Inteligência emerge de redes de unidades simples interconectadas | Inteligência como inferência e decisão sob incerteza |
| Representação do conhecimento | Regras, lógica, ontologias, explícita | Pesos numéricos distribuídos na rede, implícita | Distribuições de probabilidade, modelos paramétricos e não paramétricos |
| Origem do conhecimento | Especialistas humanos | Aprendido dos dados | Aprendido dos dados, com hipóteses de modelagem |
| Pontos fortes | Interpretabilidade, raciocínio exato, uso de conhecimento prévio | Percepção (imagens, som, texto), escalabilidade com dados | Quantificação de incerteza, fundamentação teórica |
| Limitações | Fragilidade, dificuldade de aprender, explosão combinatória | Necessidade de muitos dados, baixa interpretabilidade | Hipóteses de modelagem podem ser irrealistas |
| Exemplos | Sistemas especialistas, provadores de teoremas, planejadores | Perceptron, redes convolucionais, transformers | Classificador Naive Bayes, redes bayesianas, modelos de regressão |
Essas abordagens não são excludentes. As redes neurais modernas são treinadas minimizando funções de perda que, frequentemente, correspondem a verossimilhanças (por exemplo, a entropia cruzada é o negativo da log-verossimilhança de um modelo categórico), o que aproxima conexionismo e estatística. Há também esforços de IA neurossimbólica, que buscam combinar o aprendizado das redes neurais com o raciocínio explícito dos sistemas simbólicos.
2.4.1 Um exemplo simbólico mínimo
Um sistema baseado em regras pode ser escrito em poucas linhas. O exemplo abaixo, em Python, implementa um “sistema especialista” de brinquedo para triagem de crédito. Note que todo o conhecimento foi escrito manualmente pelo programador — nada foi aprendido dos dados.
def triagem_credito(renda, divida, atrasos_12m):
    """Sistema baseado em regras (abordagem simbólica)."""
    comprometimento = divida / renda
    if atrasos_12m >= 3:
        return "negar", "três ou mais atrasos nos últimos 12 meses"
    if comprometimento > 0.4:
        return "negar", "comprometimento de renda acima de 40%"
    if comprometimento > 0.3 or atrasos_12m > 0:
        return "análise manual", "perfil intermediário"
    return "aprovar", "baixo comprometimento e sem atrasos"

for cliente in [(5000, 1000, 0), (3000, 1500, 0), (4000, 1300, 1), (6000, 500, 4)]:
    decisao, motivo = triagem_credito(*cliente)
    print(cliente, "->", decisao, "|", motivo)
#> (5000, 1000, 0) -> aprovar | baixo comprometimento e sem atrasos
#> (3000, 1500, 0) -> negar | comprometimento de renda acima de 40%
#> (4000, 1300, 1) -> análise manual | perfil intermediário
#> (6000, 500, 4) -> negar | três ou mais atrasos nos últimos 12 meses
A grande vantagem é a explicabilidade: cada decisão vem acompanhada de seu motivo. A grande desvantagem é que os limiares (40%, 30%, três atrasos) foram escolhidos arbitrariamente; a abordagem estatística estimaria a relação entre essas variáveis e o risco de inadimplência a partir de dados históricos, por exemplo, com uma regressão logística (Capítulo de Modelos de Regressão).
2.5 Agentes Inteligentes
Um conceito unificador da IA moderna é o de agente (Russell e Norvig 2021). Um agente é qualquer entidade que percebe seu ambiente por meio de sensores e age sobre ele por meio de atuadores. Formalmente, se \(\mathcal{P}\) é o conjunto de percepções possíveis e \(\mathcal{A}\) o conjunto de ações, o comportamento de um agente é descrito por uma função do agente
\[ f: \mathcal{P}^* \longrightarrow \mathcal{A}, \]
que associa a cada sequência de percepções (o histórico completo do que o agente percebeu até o momento, denotado por \(\mathcal{P}^*\)) uma ação. O programa do agente é a implementação concreta dessa função em um sistema físico.
Um agente racional é aquele que, para cada sequência de percepções possível, escolhe a ação que maximiza o valor esperado de sua medida de desempenho, dada a evidência fornecida pelas percepções e o conhecimento prévio do agente. Se \(U(s)\) é a utilidade de um estado \(s\) e \(P(s \mid a, e)\) a probabilidade de alcançar \(s\) ao executar a ação \(a\) dada a evidência \(e\), a escolha racional é
\[ a^* = \arg\max_{a \in \mathcal{A}} \; \mathbb{E}[U \mid a, e] = \arg\max_{a \in \mathcal{A}} \sum_{s} P(s \mid a, e)\, U(s). \]
Esse é exatamente o princípio da maximização da utilidade esperada da teoria da decisão estatística, o que evidencia a forte ligação entre IA e Estatística.
Um agente de manutenção preditiva deve decidir entre parar uma máquina para manutenção ou continuar operando. Com base nos sensores, ele estima que a probabilidade de falha na próxima semana é \(P(\text{falha}) = 0{,}2\). As utilidades (lucros, em milhares de reais) são:
| Ação | Falha ocorre | Falha não ocorre |
|---|---|---|
| Parar | \(-5\) | \(-5\) |
| Continuar | \(-40\) | \(+10\) |
Utilidades esperadas:
- \(\mathbb{E}[U \mid \text{parar}] = 0{,}2 \cdot (-5) + 0{,}8 \cdot (-5) = -5\);
- \(\mathbb{E}[U \mid \text{continuar}] = 0{,}2 \cdot (-40) + 0{,}8 \cdot 10 = -8 + 8 = 0\).
O agente racional continua operando. A decisão se inverte quando \(-40p + 10(1-p) < -5\), isto é, quando \(p > 15/50 = 0{,}3\). A qualidade da decisão depende diretamente da qualidade da estimativa de \(p\) — que é um problema de classificação probabilística, tema central da Parte III deste livro.
2.5.1 Especificando a tarefa: PEAS
Para projetar um agente, especifica-se seu ambiente de tarefa pelo acrônimo PEAS: medida de desempenho (Performance), ambiente (Environment), atuadores (Actuators) e sensores (Sensors).
| Agente | Desempenho | Ambiente | Atuadores | Sensores |
|---|---|---|---|---|
| Carro autônomo | Segurança, tempo de viagem, conforto, respeito às leis | Ruas, tráfego, pedestres, clima | Volante, acelerador, freio, sinalização | Câmeras, radar, lidar, GPS, velocímetro |
| Filtro de spam | Proporção de e-mails corretamente classificados, custo dos falsos positivos | Caixa de entrada, remetentes | Mover para a pasta de spam | Texto e metadados dos e-mails, marcações do usuário |
| Sistema de recomendação | Cliques, compras, satisfação do usuário | Usuários, catálogo de produtos | Lista de itens exibidos | Histórico de navegação e compras |
2.5.2 Propriedades dos ambientes
Os ambientes são classificados segundo algumas dimensões que determinam a dificuldade do problema (Russell e Norvig 2021):
- Completamente observável vs. parcialmente observável: os sensores dão acesso ao estado completo do ambiente? (Xadrez: sim; pôquer: não.)
- Determinístico vs. estocástico: o próximo estado é completamente determinado pelo estado atual e pela ação?
- Episódico vs. sequencial: as decisões são independentes (classificar uma imagem) ou afetam decisões futuras (dirigir um carro)?
- Estático vs. dinâmico: o ambiente muda enquanto o agente delibera?
- Discreto vs. contínuo: número de estados, percepções e ações.
- Agente único vs. multiagente: há outros agentes cooperando ou competindo?
Note que a maior parte dos problemas de aprendizado supervisionado estudados neste livro corresponde a ambientes episódicos: cada observação é classificada independentemente das demais. O aprendizado por reforço, mencionado no Capítulo de Introdução ao Aprendizado de Máquina, lida com ambientes sequenciais.
2.5.3 Tipos de agentes
Em ordem crescente de sofisticação:
- Agente reativo simples: escolhe a ação apenas com base na percepção atual, por meio de regras condição-ação.
- Agente reativo baseado em modelo: mantém um estado interno que resume o histórico, usando um modelo de como o mundo evolui.
- Agente baseado em objetivos: escolhe ações que levem a estados que satisfaçam um objetivo, usando busca e planejamento.
- Agente baseado em utilidade: compara estados por meio de uma função de utilidade, permitindo pesar objetivos conflitantes e incerteza.
- Agente com aprendizado: qualquer dos anteriores acrescido de um componente que melhora seu desempenho a partir da experiência.
O exemplo a seguir implementa, em Python, o clássico “mundo do aspirador de pó” com duas salas (A e B) e um agente reativo simples:
import random

def agente_reativo(percepcao):
    """Percepção = (local, estado). Regras condição-ação."""
    local, estado = percepcao
    if estado == "sujo":
        return "aspirar"
    return "direita" if local == "A" else "esquerda"

def simular(passos=6, semente=42):
    random.seed(semente)
    mundo = {"A": random.choice(["sujo", "limpo"]),
             "B": random.choice(["sujo", "limpo"])}
    local, pontos = "A", 0
    for t in range(passos):
        acao = agente_reativo((local, mundo[local]))
        if acao == "aspirar":
            mundo[local] = "limpo"
        elif acao == "direita":
            local = "B"
        else:
            local = "A"
        # Medida de desempenho: +1 por sala limpa em cada passo
        pontos += sum(v == "limpo" for v in mundo.values())
        print(f"t={t}: ação={acao:8s} local={local} mundo={mundo}")
    print("Desempenho total:", pontos)

simular()
Esse agente é racional para essa medida de desempenho se as salas não voltarem a se sujar, mas desperdiça movimentos indefinidamente quando ambas estão limpas. Um agente baseado em modelo, que se lembrasse de já ter limpado as duas salas, poderia permanecer parado.
2.6 Resolução de Problemas por Busca
Um agente baseado em objetivos precisa encontrar uma sequência de ações que o leve de um estado inicial a um estado desejado: o caminho mais curto entre duas cidades, a sequência de movimentos que resolve um quebra-cabeça, o plano de produção de menor custo. A busca foi a primeira grande técnica da IA simbólica e continua presente em sistemas modernos — o AlphaGo, por exemplo, combina redes neurais com busca em árvore.
2.6.1 Formulação de um problema de busca
Formalmente, um problema de busca é especificado por (Russell e Norvig 2021):
- um conjunto de estados \(\mathcal{S}\) e um estado inicial \(s_0 \in \mathcal{S}\);
- para cada estado \(s\), um conjunto de ações aplicáveis \(\mathcal{A}(s)\);
- um modelo de transição \(\operatorname{Result}(s, a)\), que indica o estado resultante de executar \(a\) em \(s\);
- um teste de objetivo, que verifica se um estado pertence ao conjunto de estados-objetivo \(\mathcal{G} \subseteq \mathcal{S}\);
- uma função de custo \(c(s, a, s') > 0\) para cada passo.
Uma solução é uma sequência de ações que leva de \(s_0\) a um estado de \(\mathcal{G}\); uma solução ótima é a de menor custo total. Os algoritmos de busca constroem uma árvore de busca a partir de \(s_0\): a cada passo, escolhem um nó da fronteira (os nós gerados mas ainda não expandidos), verificam se é objetivo e, se não for, o expandem, gerando seus sucessores. A estratégia de escolha do próximo nó a expandir é o que distingue os algoritmos.
2.6.2 Busca sem informação
Os algoritmos de busca sem informação (ou cega) usam apenas a definição do problema:
- Busca em largura (breadth-first search — BFS): expande primeiro os nós mais rasos, usando uma fila (o primeiro a entrar é o primeiro a sair).
- Busca em profundidade (depth-first search — DFS): expande primeiro o nó mais profundo, usando uma pilha.
- Busca de custo uniforme: expande o nó de menor custo acumulado \(g(n)\) desde a raiz, usando uma fila de prioridade. É essencialmente o algoritmo de Dijkstra (1959).
Seja \(b\) o fator de ramificação (número máximo de sucessores de um nó), \(d\) a profundidade da solução mais rasa e \(m\) a profundidade máxima da árvore. As propriedades clássicas são:
| Algoritmo | Completo? | Ótimo? | Tempo | Memória |
|---|---|---|---|---|
| Largura | Sim (se \(b\) finito) | Sim, se os custos forem iguais | \(O(b^{d})\) | \(O(b^{d})\) |
| Profundidade | Não (pode descer indefinidamente) | Não | \(O(b^{m})\) | \(O(bm)\) |
| Custo uniforme | Sim (custos \(\geq \epsilon > 0\)) | Sim | \(O(b^{1 + \lfloor C^*/\epsilon \rfloor})\) | \(O(b^{1 + \lfloor C^*/\epsilon \rfloor})\) |
em que \(C^*\) é o custo da solução ótima e \(\epsilon\) o menor custo de passo.
Com fator de ramificação \(b = 10\) e solução na profundidade \(d = 6\), a busca em largura pode gerar até \[ 1 + 10 + 10^2 + \cdots + 10^6 = \frac{10^7 - 1}{10 - 1} = 1.111.111 \text{ nós}. \] Se cada nó ocupar 1 KB, são cerca de 1,1 GB de memória — viável. Com \(d = 12\), porém, o número de nós passa de \(10^{12}\), e a memória necessária, de 1 PB. Esse crescimento exponencial é a explosão combinatória que contribuiu para o primeiro inverno da IA, e a principal motivação para a busca informada.
2.6.3 Busca informada e o algoritmo A*
A busca informada usa conhecimento específico do problema na forma de uma função heurística \(h(n)\), que estima o custo do caminho mais barato do nó \(n\) até um objetivo. O algoritmo A* (Hart, Nilsson, e Raphael 1968) expande o nó da fronteira com menor valor de
\[ f(n) = g(n) + h(n), \]
em que \(g(n)\) é o custo já percorrido desde \(s_0\) até \(n\). Assim, \(f(n)\) estima o custo total da melhor solução que passa por \(n\). Duas propriedades da heurística são essenciais. Denotando por \(h^*(n)\) o custo verdadeiro do melhor caminho de \(n\) até um objetivo:
- \(h\) é admissível se nunca superestima esse custo: \(0 \leq h(n) \leq h^*(n)\) para todo \(n\);
- \(h\) é consistente se, para todo nó \(n\) e sucessor \(n'\) gerado pela ação \(a\), vale a desigualdade triangular \(h(n) \leq c(n, a, n') + h(n')\), com \(h = 0\) nos objetivos. Toda heurística consistente é admissível.
Se \(h\) é admissível, a versão de busca em árvore do A* retorna uma solução ótima.
Demonstração (esboço). Seja \(C^*\) o custo ótimo e suponha, por absurdo, que o A* retorne um objetivo \(G_2\) subótimo, com \(g(G_2) > C^*\). Como \(h(G_2) = 0\), temos \(f(G_2) = g(G_2) > C^*\). Imediatamente antes de \(G_2\) ser escolhido, algum nó \(n\) do caminho ótimo ainda está na fronteira (a raiz está no caminho ótimo e, enquanto o objetivo ótimo não for expandido, algum nó desse caminho permanece na fronteira). Para esse nó, \(g(n)\) é o custo ótimo até \(n\) e, por admissibilidade, \[ f(n) = g(n) + h(n) \leq g(n) + h^*(n) = C^* < f(G_2). \] Logo, o A* teria escolhido \(n\) antes de \(G_2\) — contradição. \(\square\)
Com uma heurística consistente, os valores de \(f\) ao longo de qualquer caminho são não decrescentes, e a versão em grafo do algoritmo (que não reexpande estados já visitados) também é ótima. Note que a busca de custo uniforme é o caso particular \(h \equiv 0\), trivialmente admissível. Quanto mais próxima de \(h^*\) for a heurística (sem ultrapassá-la), menos nós o A* expande. Uma forma sistemática de obter heurísticas admissíveis é resolver um problema relaxado: em mapas, a distância em linha reta é admissível porque nenhuma estrada é mais curta que a linha reta.
Considere o grafo abaixo, com distâncias hipotéticas (em dezenas de quilômetros) entre locais \(S\) (partida), \(A\), \(B\), \(C\), \(D\), \(E\) e \(G\) (destino), e uma heurística admissível e consistente \(h\):
| Aresta | \(S\)–\(A\) | \(S\)–\(B\) | \(S\)–\(E\) | \(A\)–\(C\) | \(A\)–\(D\) | \(B\)–\(D\) | \(C\)–\(D\) | \(C\)–\(G\) | \(D\)–\(G\) |
|---|---|---|---|---|---|---|---|---|---|
| Custo | 2 | 7 | 3 | 2 | 6 | 2 | 3 | 7 | 3 |
| Nó | \(S\) | \(A\) | \(B\) | \(C\) | \(D\) | \(E\) | \(G\) |
|---|---|---|---|---|---|---|---|
| \(h(n)\) | 9 | 7 | 4 | 5 | 2 | 8 | 0 |
| \(h^*(n)\) | 10 | 8 | 5 | 6 | 3 | 13 | 0 |
- Expande \(S\) (\(f = 0 + 9 = 9\)). Gera \(A\) (\(f = 2 + 7 = 9\)), \(B\) (\(f = 7 + 4 = 11\)) e \(E\) (\(f = 3 + 8 = 11\)).
- Expande \(A\) (\(f = 9\)). Gera \(C\) (\(f = 4 + 5 = 9\)) e \(D\) (\(f = 8 + 2 = 10\)).
- Expande \(C\) (\(f = 9\)). Gera \(G\) (\(f = 11 + 0 = 11\)) e encontra um caminho melhor para \(D\): \(g = 4 + 3 = 7\), \(f = 9\).
- Expande \(D\) (\(f = 9\)). Encontra um caminho melhor para \(G\): \(g = 7 + 3 = 10\), \(f = 10\).
- Expande \(G\) (\(f = 10\)): objetivo atingido.
A solução é \(S \to A \to C \to D \to G\), com custo 10, obtida expandindo 5 nós. A busca de custo uniforme (\(h \equiv 0\)) encontra a mesma solução, mas expande 7 nós (\(S, A, E, C, B, D, G\)): ela não “sabe” que \(E\) é um beco sem saída nem que \(B\) está longe do destino. Em problemas reais, com milhões de estados, essa diferença é de ordens de grandeza.
Uma implementação compacta do A* em Python, com uma fila de prioridade (heapq):
import heapq

grafo = {
    "S": {"A": 2, "B": 7, "E": 3},
    "A": {"S": 2, "C": 2, "D": 6},
    "B": {"S": 7, "D": 2},
    "E": {"S": 3},
    "C": {"A": 2, "D": 3, "G": 7},
    "D": {"A": 6, "B": 2, "C": 3, "G": 3},
    "G": {"C": 7, "D": 3},
}
h = {"S": 9, "A": 7, "B": 4, "C": 5, "D": 2, "E": 8, "G": 0}

def a_estrela(grafo, h, inicio, objetivo, verbose=True):
    fronteira = [(h[inicio], 0, inicio, [inicio])]   # (f, g, nó, caminho)
    melhor_g = {inicio: 0}
    expandidos = []
    while fronteira:
        f, g, no, caminho = heapq.heappop(fronteira)
        if g > melhor_g.get(no, float("inf")):
            continue                                  # entrada obsoleta
        expandidos.append(no)
        if verbose:
            print(f"expande {no}: g={g}, h={h[no]}, f={f}")
        if no == objetivo:
            return caminho, g, expandidos
        for viz, custo in grafo[no].items():
            g_novo = g + custo
            if g_novo < melhor_g.get(viz, float("inf")):
                melhor_g[viz] = g_novo
                heapq.heappush(fronteira,
                               (g_novo + h[viz], g_novo, viz, caminho + [viz]))
    return None, float("inf"), expandidos

caminho, custo, exp = a_estrela(grafo, h, "S", "G")
print("caminho:", " -> ".join(caminho), "| custo:", custo)
#> expande S: g=0, h=9, f=9
#> expande A: g=2, h=7, f=9
#> expande C: g=4, h=5, f=9
#> expande D: g=7, h=2, f=9
#> expande G: g=10, h=0, f=10
#> caminho: S -> A -> C -> D -> G | custo: 10

# Busca de custo uniforme = A* com heurística nula
zero = {v: 0 for v in grafo}
print(a_estrela(grafo, zero, "S", "G", verbose=False))
#> (['S', 'A', 'C', 'D', 'G'], 10, ['S', 'A', 'E', 'C', 'B', 'D', 'G'])
2.7 Representação do Conhecimento e Raciocínio Lógico
A abordagem simbólica parte da ideia de que um agente pode ter uma base de conhecimento (knowledge base — KB): um conjunto de sentenças, escritas em uma linguagem formal, que representam o que o agente sabe sobre o mundo. Novas sentenças são obtidas por inferência. A linguagem mais simples para isso é a lógica proposicional.
2.7.1 Lógica proposicional: sintaxe e semântica
As sentenças da lógica proposicional são construídas a partir de símbolos proposicionais (\(P\), \(Q\), \(\text{Chuva}, \ldots\)), que podem ser verdadeiros ou falsos, e dos conectivos \(\neg\) (negação), \(\wedge\) (conjunção), \(\vee\) (disjunção), \(\Rightarrow\) (implicação) e \(\Leftrightarrow\) (bicondicional). Um modelo é uma atribuição de valores-verdade a todos os símbolos. A semântica dos conectivos é dada pela tabela-verdade; destaca-se a implicação, que só é falsa quando a premissa é verdadeira e a conclusão é falsa:
| \(P\) | \(Q\) | \(\neg P\) | \(P \wedge Q\) | \(P \vee Q\) | \(P \Rightarrow Q\) | \(P \Leftrightarrow Q\) |
|---|---|---|---|---|---|---|
| V | V | F | V | V | V | V |
| V | F | F | F | V | F | F |
| F | V | V | F | V | V | F |
| F | F | V | F | F | V | V |
O conceito central é o de consequência lógica (entailment): dizemos que \(\text{KB} \models \alpha\) (“a base implica logicamente \(\alpha\)”) se \(\alpha\) é verdadeira em todos os modelos em que a KB é verdadeira. Um procedimento de inferência é correto (sound) se só deriva sentenças que são consequências lógicas, e completo se deriva todas elas.
O procedimento mais direto é a verificação de modelos: enumerar todos os \(2^n\) modelos de \(n\) símbolos e checar a definição. Ele é correto e completo, mas exponencial em \(n\). Na prática, usam-se regras de inferência, como o modus ponens (de \(\alpha \Rightarrow \beta\) e \(\alpha\), conclui-se \(\beta\)) e o modus tollens (de \(\alpha \Rightarrow \beta\) e \(\neg\beta\), conclui-se \(\neg\alpha\)), ou o método da resolução, que é completo para refutação.
Seja \(\text{KB} = \{\text{Chuva} \Rightarrow \text{Molhada},\ \text{Irrigação} \Rightarrow \text{Molhada},\ \neg\text{Molhada}\}\). Queremos saber se \(\text{KB} \models \neg\text{Chuva}\).
Dos \(2^3 = 8\) modelos, a KB exige \(\text{Molhada} = \text{F}\). Com isso, \(\text{Chuva} \Rightarrow \text{Molhada}\) só é verdadeira se \(\text{Chuva} = \text{F}\), e \(\text{Irrigação} \Rightarrow \text{Molhada}\) só se \(\text{Irrigação} = \text{F}\). Há, portanto, um único modelo da KB: (Chuva, Irrigação, Molhada) \(=\) (F, F, F). Nele, \(\neg\text{Chuva}\) é verdadeira, logo \(\text{KB} \models \neg\text{Chuva}\) (e também \(\text{KB} \models \neg\text{Irrigação}\)) — exatamente o modus tollens.
Observe, por outro lado, que da base \(\{\text{Chuva} \Rightarrow \text{Molhada},\ \text{Molhada}\}\) não se conclui Chuva: há um modelo com Molhada verdadeira e Chuva falsa (a rua pode estar molhada pela irrigação). Concluir a causa a partir do efeito é abdução, um raciocínio plausível, mas não dedutivamente válido.
2.7.2 Cláusulas de Horn e encadeamento para a frente
Muitos sistemas especialistas restringem a base a cláusulas de Horn, sentenças da forma \((p_1 \wedge p_2 \wedge \cdots \wedge p_k) \Rightarrow q\) ou fatos atômicos \(q\). Para essas bases, o encadeamento para a frente (forward chaining) é correto, completo e executado em tempo linear no tamanho da base: parte-se dos fatos conhecidos e dispara-se repetidamente toda regra cujas premissas estejam satisfeitas, até que nada de novo seja derivado. O encadeamento para trás (backward chaining) faz o caminho inverso, partindo da pergunta e buscando regras que a concluam; é a estratégia da linguagem Prolog.
# Base de conhecimento com cláusulas de Horn: (premissas, conclusão)
regras = [
    ({"Chuva"}, "RuaMolhada"),
    ({"Irrigacao"}, "RuaMolhada"),
    ({"RuaMolhada"}, "Escorregadio"),
    ({"Escorregadio", "Moto"}, "Risco"),
]
fatos = {"Chuva", "Moto"}

def encadeamento_para_frente(regras, fatos):
    conhecidos = set(fatos)
    mudou = True
    while mudou:
        mudou = False
        for premissas, conclusao in regras:
            if premissas <= conhecidos and conclusao not in conhecidos:
                print(f"{' e '.join(sorted(premissas))} => {conclusao}")
                conhecidos.add(conclusao)
                mudou = True
    return conhecidos

print(sorted(encadeamento_para_frente(regras, fatos)))
#> Chuva => RuaMolhada
#> RuaMolhada => Escorregadio
#> Escorregadio e Moto => Risco
#> ['Chuva', 'Escorregadio', 'Moto', 'Risco', 'RuaMolhada']
2.7.3 Lógica de primeira ordem e os limites da lógica
A lógica proposicional não consegue expressar de forma compacta afirmações gerais como “todo aluno matriculado em Estatística cursa Probabilidade”. A lógica de primeira ordem acrescenta objetos, predicados, funções e os quantificadores universal (\(\forall\)) e existencial (\(\exists\)):
\[ \forall x\ \big(\text{Matriculado}(x, \text{Estatística}) \Rightarrow \text{Cursa}(x, \text{Probabilidade})\big). \]
Ela é muito mais expressiva, mas a consequência lógica em primeira ordem é apenas semidecidível: existe procedimento que confirma toda consequência verdadeira, mas nenhum que sempre termine quando a sentença não é consequência.
Para a Ciência de Dados, a limitação mais importante da lógica clássica é outra: ela é binária e monotônica. Regras como “se tem febre e tosse, então tem gripe” são, na realidade, apenas frequentemente verdadeiras. Tentar listar todas as exceções é inviável (o chamado problema da qualificação). Essa constatação motivou a passagem do raciocínio lógico para o raciocínio probabilístico.
2.8 Raciocínio Probabilístico e Redes Bayesianas
A teoria das probabilidades oferece uma linguagem para representar graus de crença e atualizá-los de forma coerente diante de evidências, por meio do teorema de Bayes. A dificuldade é computacional: a distribuição conjunta de \(n\) variáveis binárias tem \(2^n - 1\) parâmetros livres — com \(n = 30\), mais de um bilhão. A solução é explorar independências condicionais.
2.8.1 Independência condicional e fatoração
Duas variáveis \(X\) e \(Y\) são condicionalmente independentes dado \(Z\), o que se denota \(X \perp\!\!\!\perp Y \mid Z\), se \(P(X, Y \mid Z) = P(X \mid Z)\,P(Y \mid Z)\). Pela regra da cadeia, qualquer distribuição conjunta pode ser escrita como
\[ P(X_1, \ldots, X_n) = \prod_{i=1}^{n} P(X_i \mid X_1, \ldots, X_{i-1}). \]
Uma rede bayesiana (Pearl 1988) é um grafo acíclico dirigido em que cada nó é uma variável aleatória e cada nó \(X_i\) tem uma tabela de probabilidades condicionais dados os seus pais \(\operatorname{Pa}(X_i)\) no grafo. A rede representa a distribuição conjunta
\[ P(X_1, \ldots, X_n) = \prod_{i=1}^{n} P\big(X_i \mid \operatorname{Pa}(X_i)\big), \]
o que equivale a supor que cada variável é condicionalmente independente de seus não descendentes, dados os seus pais. Se cada nó binário tem no máximo \(k\) pais, o número de parâmetros cai de \(2^n - 1\) para no máximo \(n \cdot 2^k\): de exponencial para linear em \(n\).
O classificador Naive Bayes é a rede bayesiana mais simples: a classe \(Y\) é o único pai de todas as variáveis explicativas, de modo que \(P(Y, X_1, \ldots, X_p) = P(Y) \prod_{j} P(X_j \mid Y)\) — uma hipótese “ingênua”, raramente verdadeira, mas que funciona surpreendentemente bem em problemas como a filtragem de spam.
O exemplo clássico de Pearl (1988), popularizado por Russell e Norvig (2021): uma casa tem um alarme (\(A\)) que dispara com roubos (\(B\)) e, às vezes, com pequenos terremotos (\(E\)). Dois vizinhos, João (\(J\)) e Maria (\(M\)), telefonam quando ouvem o alarme, mas nem sempre o ouvem e às vezes confundem outros sons com ele. A rede tem arestas \(B \to A\), \(E \to A\), \(A \to J\) e \(A \to M\), com:
- \(P(B) = 0{,}001\) e \(P(E) = 0{,}002\);
- \(P(A \mid B, E) = 0{,}95\); \(P(A \mid B, \neg E) = 0{,}94\); \(P(A \mid \neg B, E) = 0{,}29\); \(P(A \mid \neg B, \neg E) = 0{,}001\);
- \(P(J \mid A) = 0{,}90\), \(P(J \mid \neg A) = 0{,}05\); \(P(M \mid A) = 0{,}70\), \(P(M \mid \neg A) = 0{,}01\).
A rede usa \(1 + 1 + 4 + 2 + 2 = 10\) parâmetros, contra \(2^5 - 1 = 31\) da conjunta completa. Ambos os vizinhos telefonaram. Qual a probabilidade de roubo? Por enumeração, somando sobre as variáveis não observadas \(E\) e \(A\): \[ P(B \mid j, m) = \frac{\sum_{e, a} P(B)\,P(e)\,P(a \mid B, e)\,P(j \mid a)\,P(m \mid a)}{\sum_{b, e, a} P(b)\,P(e)\,P(a \mid b, e)\,P(j \mid a)\,P(m \mid a)} \approx \frac{0{,}000592}{0{,}002084} \approx 0{,}284. \] Mesmo com dois telefonemas, a probabilidade de roubo é de apenas 28%: roubos são muito raros, e os falsos alarmes, combinados com vizinhos que se enganam, explicam boa parte das ligações. É a mesma lição da taxa-base vista no Capítulo de Conceitos de Ciência de Dados.
from itertools import product

# Tabelas de probabilidade condicional
P_B, P_E = 0.001, 0.002
P_A = {(True, True): 0.95, (True, False): 0.94,
       (False, True): 0.29, (False, False): 0.001}
P_J = {True: 0.90, False: 0.05}     # P(J = verdadeiro | A)
P_M = {True: 0.70, False: 0.01}     # P(M = verdadeiro | A)

def bern(p, x):
    return p if x else 1 - p

def conjunta(b, e, a, j, m):
    """Fatoração da rede: P(b) P(e) P(a | b, e) P(j | a) P(m | a)."""
    return (bern(P_B, b) * bern(P_E, e) * bern(P_A[(b, e)], a)
            * bern(P_J[a], j) * bern(P_M[a], m))

# Inferência por enumeração: P(B | J = verdadeiro, M = verdadeiro)
num = {b: sum(conjunta(b, e, a, True, True)
              for e, a in product([True, False], repeat=2))
       for b in [True, False]}
print(f"P(B | j, m) = {num[True] / (num[True] + num[False]):.3f}")
#> P(B | j, m) = 0.284
A enumeração tem custo exponencial no número de variáveis ocultas. Em redes grandes, usam-se algoritmos exatos mais eficientes (eliminação de variáveis, árvores de junção) ou aproximados (amostragem por Monte Carlo). Os modelos ocultos de Markov, usados por décadas em reconhecimento de fala, e os filtros de Kalman, usados em navegação, são casos particulares de redes bayesianas dinâmicas.
2.9 O Espectro da IA: Inteligência Artificial, Machine Learning e Deep Learning
É muito importante compreender que a inteligência artificial não é um bloco único. Ela é composta de camadas aninhadas que definem o nível de especialização técnica dos métodos:
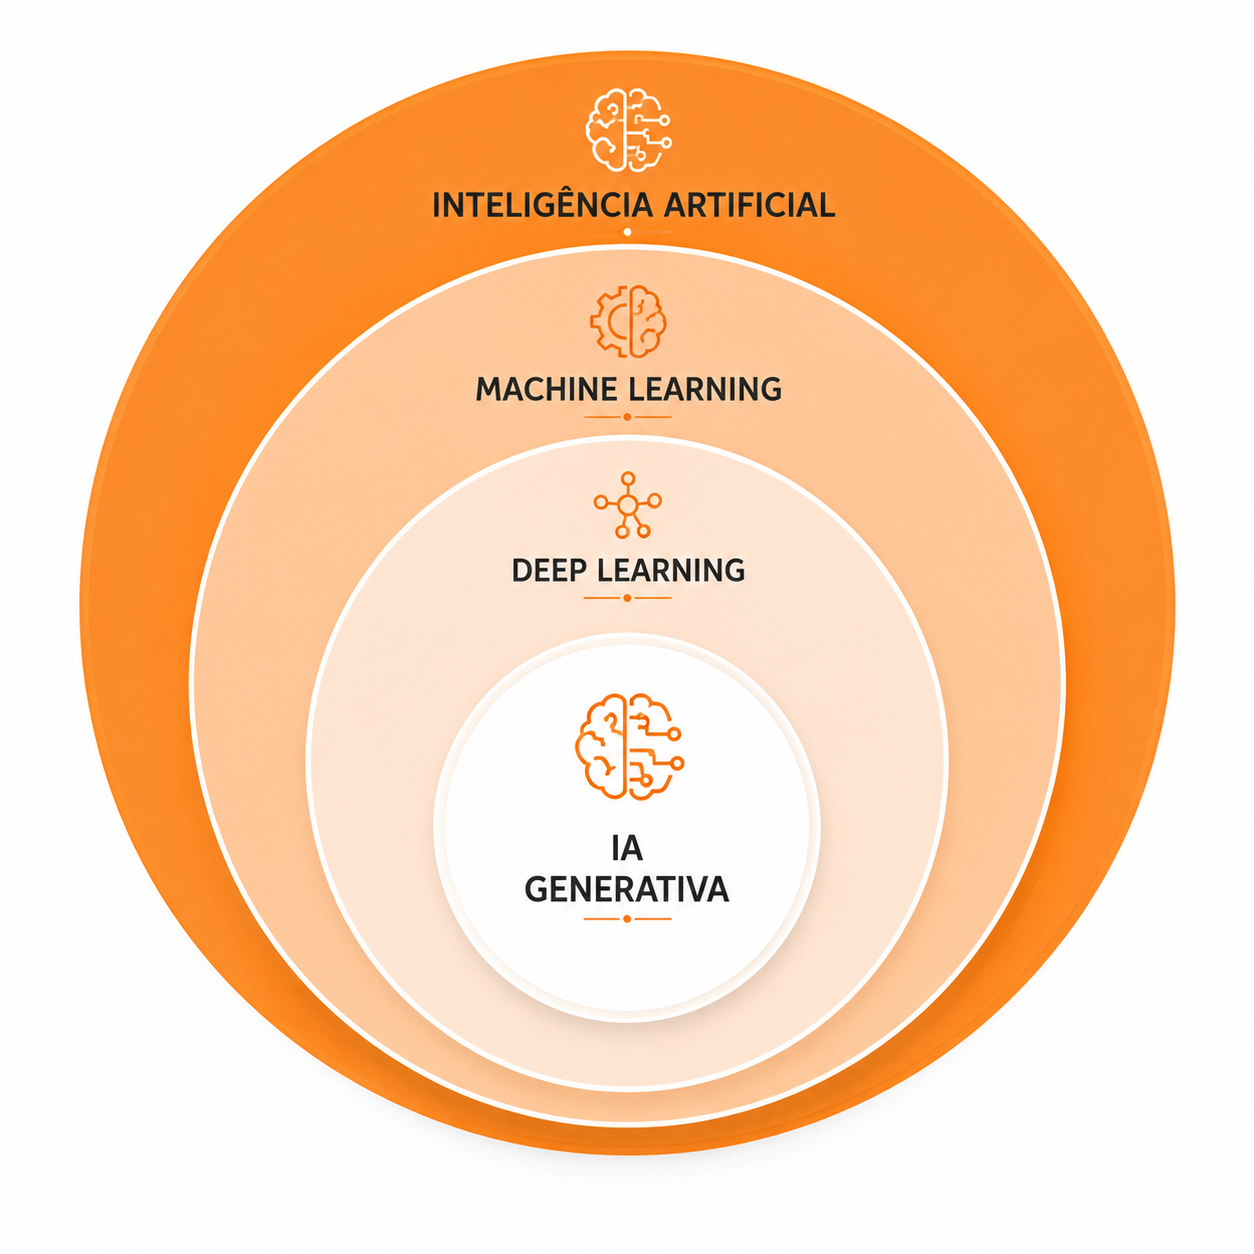
- Inteligência Artificial (IA): O campo amplo que abrange qualquer sistema capaz de simular a inteligência humana, incluindo sistemas baseados em regras rígidas (“se-então”) codificadas manualmente por especialistas. É importante notar que muitos debates contemporâneos apontam que o que frequentemente chamamos de “Inteligência Artificial” na mídia é, na realidade, Aprendizado de Máquina (Jordan 2019; Morettin e Singer 2021).
- Aprendizado de Máquina (Machine Learning - ML): Um subcampo da IA focado no desenvolvimento de algoritmos que aprendem e melhoram seu desempenho de forma automática a partir da exposição a dados históricos, sem que precisem ser explicitamente programados com regras fixas. Classicamente divide-se em métodos de aprendizado supervisionado (focados em previsão e classificação) e não supervisionado (focados em agrupamento e associação) (Morettin e Singer 2021).
- Aprendizado Profundo (Deep Learning - DL): Uma ramificação avançada de Machine Learning baseada em redes neurais artificiais multicamadas (profundas). É a tecnologia por trás dos grandes avanços em visão computacional, processamento de linguagem natural (como os grandes modelos de linguagem - LLMs) e carros autônomos.
- IA Generativa (GenAI): Um subcampo emergente de IA focado em ‘criar conteúdo original’ (texto, imagens, áudio, vídeo) a partir de modelos treinados em grandes volumes de dados. Exemplos incluem o ChatGPT, DALL-E e outros sistemas de geração de conteúdo.
As definições formais de aprendizado de máquina (Samuel e Mitchell) e sua divisão em aprendizado supervisionado, não supervisionado e por reforço são detalhadas no Capítulo de Introdução ao Aprendizado de Máquina. Nas seções a seguir, aprofundamos os dois níveis mais internos do diagrama: as redes neurais (base do deep learning) e os modelos generativos.
2.10 O Neurônio Artificial e o Perceptron
2.10.1 O neurônio de McCulloch–Pitts
Inspirados no neurônio biológico — que recebe sinais elétricos pelos dendritos, integra-os no corpo celular e dispara um impulso pelo axônio se a estimulação ultrapassar um limiar —, McCulloch e Pitts propuseram uma unidade que recebe entradas binárias \(x_1, \ldots, x_p \in \{0, 1\}\) e produz
\[ \hat{y} = \begin{cases} 1, & \text{se } \sum_{j=1}^{p} w_j x_j \geq \theta, \\ 0, & \text{caso contrário,} \end{cases} \]
em que \(w_j\) são pesos fixos e \(\theta\) é um limiar (McCulloch e Pitts 1943). Por exemplo, com \(w_1 = w_2 = 1\) e \(\theta = 2\), a unidade implementa o “E” lógico; com \(\theta = 1\), implementa o “OU”. Os pesos, porém, eram definidos manualmente: o modelo não aprendia.
2.10.2 O perceptron de Rosenblatt
O perceptron (Rosenblatt 1958) acrescenta ao neurônio artificial um mecanismo de aprendizado dos pesos a partir de exemplos rotulados. Dado um vetor de entradas \(\mathbf{x} = (x_1, \ldots, x_p)^\top \in \mathbb{R}^p\), um vetor de pesos \(\mathbf{w} \in \mathbb{R}^p\) e um viés (bias) \(b \in \mathbb{R}\), o perceptron calcula a combinação linear
\[ z = \mathbf{w}^\top \mathbf{x} + b = \sum_{j=1}^{p} w_j x_j + b \]
e aplica a função degrau (step function):
\[ \hat{y} = \phi(z) = \begin{cases} 1, & z > 0, \\ 0, & z \leq 0. \end{cases} \]
Geometricamente, o perceptron divide o espaço \(\mathbb{R}^p\) em duas regiões pelo hiperplano \(\{\mathbf{x} : \mathbf{w}^\top \mathbf{x} + b = 0\}\): o vetor \(\mathbf{w}\) é normal ao hiperplano e \(b\) controla seu deslocamento em relação à origem. Trata-se, portanto, de um classificador linear, parente próximo da regressão logística e das máquinas de vetores de suporte (Capítulo de SVM).
Regra de aprendizado. Para cada exemplo \((\mathbf{x}_i, y_i)\) do conjunto de treinamento, com \(y_i \in \{0, 1\}\), calcula-se a previsão \(\hat{y}_i\) e atualizam-se os parâmetros:
\[ \begin{aligned} \mathbf{w} &\leftarrow \mathbf{w} + \eta\,(y_i - \hat{y}_i)\,\mathbf{x}_i, \\ b &\leftarrow b + \eta\,(y_i - \hat{y}_i), \end{aligned} \]
em que \(\eta > 0\) é a taxa de aprendizado (learning rate). Observe a lógica da regra:
- se a previsão está correta, \(y_i - \hat{y}_i = 0\) e nada muda;
- se o perceptron previu \(0\) quando deveria prever \(1\), então \(y_i - \hat{y}_i = 1\) e os pesos são “empurrados” na direção de \(\mathbf{x}_i\), aumentando \(z\) para esse exemplo;
- se previu \(1\) quando deveria prever \(0\), os pesos se afastam de \(\mathbf{x}_i\), diminuindo \(z\).
O algoritmo percorre os dados repetidas vezes (cada passagem completa é uma época) até que não haja erros ou que um número máximo de épocas seja atingido.
Se os dados de treinamento forem linearmente separáveis — isto é, se existir um hiperplano que separa perfeitamente as duas classes —, o algoritmo do perceptron converge em um número finito de atualizações. Mais precisamente, se \(\|\mathbf{x}_i\| \leq R\) para todo \(i\) e existe um vetor unitário \(\mathbf{u}\) (incorporando o viés) que separa as classes com margem \(\gamma > 0\), o número de erros cometidos é no máximo \((R/\gamma)^2\). Se os dados não forem linearmente separáveis, o algoritmo não converge e os pesos oscilam indefinidamente.
2.10.3 Exemplo resolvido: aprendendo a função “E” lógico
Vamos treinar um perceptron para a função E (AND), com \(\mathbf{w} = (0, 0)\), \(b = 0\) e \(\eta = 1\) iniciais, apresentando os exemplos na ordem da tabela:
| \(x_1\) | \(x_2\) | \(y\) |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 0 |
| 1 | 0 | 0 |
| 1 | 1 | 1 |
Época 1:
| Exemplo | \(z = w_1x_1 + w_2x_2 + b\) | \(\hat{y}\) | \(y - \hat{y}\) | Novo \((w_1, w_2)\) | Novo \(b\) |
|---|---|---|---|---|---|
| \((0,0)\) | \(0\) | 0 | 0 | \((0, 0)\) | \(0\) |
| \((0,1)\) | \(0\) | 0 | 0 | \((0, 0)\) | \(0\) |
| \((1,0)\) | \(0\) | 0 | 0 | \((0, 0)\) | \(0\) |
| \((1,1)\) | \(0\) | 0 | \(+1\) | \((1, 1)\) | \(1\) |
Época 2:
| Exemplo | \(z\) | \(\hat{y}\) | \(y - \hat{y}\) | Novo \((w_1, w_2)\) | Novo \(b\) |
|---|---|---|---|---|---|
| \((0,0)\) | \(0 + 0 + 1 = 1\) | 1 | \(-1\) | \((1, 1)\) | \(0\) |
| \((0,1)\) | \(0 + 1 + 0 = 1\) | 1 | \(-1\) | \((1, 0)\) | \(-1\) |
| \((1,0)\) | \(1 + 0 - 1 = 0\) | 0 | 0 | \((1, 0)\) | \(-1\) |
| \((1,1)\) | \(1 + 0 - 1 = 0\) | 0 | \(+1\) | \((2, 1)\) | \(0\) |
Prosseguindo da mesma forma, o algoritmo comete erros nas épocas 3, 4 e 5 e, ao final da quinta época, chega a \(\mathbf{w} = (2, 1)\) e \(b = -2\). Na sexta época não há mais erros:
- \((0,0)\): \(z = -2 \Rightarrow \hat{y} = 0\);
- \((0,1)\): \(z = 1 - 2 = -1 \Rightarrow \hat{y} = 0\);
- \((1,0)\): \(z = 2 - 2 = 0 \Rightarrow \hat{y} = 0\);
- \((1,1)\): \(z = 2 + 1 - 2 = 1 \Rightarrow \hat{y} = 1\).
A fronteira de decisão aprendida é a reta \(2x_1 + x_2 - 2 = 0\), que separa o ponto \((1,1)\) dos demais. Note que o ponto \((1,0)\) ficou exatamente sobre a fronteira — uma solução válida, porém com margem nula, o que ilustra por que métodos como o SVM, que maximizam a margem, costumam generalizar melhor.
2.10.4 A limitação do XOR
Considere agora a função OU-exclusivo (XOR): \(y = 1\) se exatamente uma das entradas é 1. Suponha que existissem \(w_1, w_2, b\) tais que o perceptron classificasse corretamente os quatro pontos. Então:
\[ \begin{aligned} (0,0) \mapsto 0 &: \quad b \leq 0, \\ (1,1) \mapsto 0 &: \quad w_1 + w_2 + b \leq 0, \\ (1,0) \mapsto 1 &: \quad w_1 + b > 0, \\ (0,1) \mapsto 1 &: \quad w_2 + b > 0. \end{aligned} \]
Somando as duas últimas desigualdades, \(w_1 + w_2 + 2b > 0\), ou seja, \(w_1 + w_2 + b > -b \geq 0\), o que contradiz a segunda desigualdade. Logo, nenhum perceptron de uma camada representa o XOR: os pontos não são linearmente separáveis. Esse é o resultado popularizado por Minsky e Papert (1969). A solução é combinar neurônios em camadas: por exemplo, \(\text{XOR}(x_1, x_2) = \text{E}\big(\text{OU}(x_1, x_2),\ \text{NÃO-E}(x_1, x_2)\big)\), e cada uma dessas três funções é implementável por um perceptron.
2.10.5 Implementação do perceptron
Em Python, usando apenas o numpy:
import numpy as np

class Perceptron:
    def __init__(self, eta=1.0, epocas=20):
        self.eta, self.epocas = eta, epocas

    def fit(self, X, y):
        self.w = np.zeros(X.shape[1])
        self.b = 0.0
        self.erros_ = []
        for _ in range(self.epocas):
            erros = 0
            for xi, yi in zip(X, y):
                delta = yi - self.predict(xi)
                self.w += self.eta * delta * xi
                self.b += self.eta * delta
                erros += int(delta != 0)
            self.erros_.append(erros)
            if erros == 0:          # convergiu
                break
        return self

    def predict(self, X):
        return (np.dot(X, self.w) + self.b > 0).astype(int)

X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
y_and = np.array([0, 0, 0, 1])
y_xor = np.array([0, 1, 1, 0])

p = Perceptron().fit(X, y_and)
print("E lógico  -> w =", p.w, "b =", p.b, "erros por época:", p.erros_)
#> E lógico  -> w = [2. 1.] b = -2.0 erros por época: [1, 3, 3, 2, 1, 0]

p = Perceptron(epocas=20).fit(X, y_xor)
print("XOR       -> previsões:", p.predict(X), "erros na última época:", p.erros_[-1])
# O número de erros nunca chega a zero: o XOR não é linearmente separável
E em R:
perceptron <- function(X, y, eta = 1, epocas = 20) {
  w <- rep(0, ncol(X)); b <- 0; erros <- integer(0)
  for (e in seq_len(epocas)) {
    n_erros <- 0
    for (i in seq_len(nrow(X))) {
      y_hat <- as.integer(sum(w * X[i, ]) + b > 0)
      delta <- y[i] - y_hat
      w <- w + eta * delta * X[i, ]
      b <- b + eta * delta
      n_erros <- n_erros + (delta != 0)
    }
    erros <- c(erros, n_erros)
    if (n_erros == 0) break
  }
  list(w = w, b = b, erros = erros)
}

X <- matrix(c(0, 0,  0, 1,  1, 0,  1, 1), ncol = 2, byrow = TRUE)
modelo <- perceptron(X, y = c(0, 0, 0, 1))
modelo
#> $w
#> [1] 2 1
#> $b
#> [1] -2
#> $erros
#> [1] 1 3 3 2 1 0
2.11 Fundamentos da Teoria do Aprendizado
O teorema de convergência do perceptron garante que o algoritmo encontra um hiperplano que separa os dados de treinamento. Mas a pergunta que realmente interessa é outra: o classificador aprendido acertará em dados novos? A teoria estatística do aprendizado responde a essa pergunta com garantias probabilísticas, e mostra que a resposta depende de dois fatores: o número de exemplos e a “riqueza” da classe de modelos.
2.11.1 O modelo PAC
Considere que os exemplos \((\mathbf{x}, y)\) são gerados de forma i.i.d. por uma distribuição desconhecida \(\mathcal{D}\), e que o algoritmo escolhe uma hipótese \(h\) dentro de uma classe de hipóteses \(\mathcal{H}\) (por exemplo, todos os perceptrons em \(\mathbb{R}^p\)). Definem-se
\[ L_{\mathcal{D}}(h) = P_{(\mathbf{x}, y) \sim \mathcal{D}}\big(h(\mathbf{x}) \neq y\big) \quad \text{(erro verdadeiro)}, \qquad L_S(h) = \frac{1}{m}\sum_{i=1}^{m} \mathbf{1}\{h(\mathbf{x}_i) \neq y_i\} \quad \text{(erro de treinamento)}, \]
em que \(S\) é a amostra de treinamento de tamanho \(m\). Proposto por Valiant (1984), o modelo de aprendizado PAC (Probably Approximately Correct, “provavelmente aproximadamente correto”) exige que, para quaisquer \(\varepsilon, \delta \in (0, 1)\), o algoritmo produza, com probabilidade de pelo menos \(1 - \delta\) sobre o sorteio da amostra (“provavelmente”), uma hipótese com erro verdadeiro de no máximo \(\varepsilon\) (“aproximadamente correta”), desde que o número de exemplos \(m\) seja suficientemente grande. O menor \(m\) que garante isso é a complexidade amostral.
Suponha que \(\mathcal{H}\) é finita e que existe \(h^* \in \mathcal{H}\) com \(L_{\mathcal{D}}(h^*) = 0\) (caso realizável). Se \[ m \geq \frac{1}{\varepsilon}\left( \ln|\mathcal{H}| + \ln\frac{1}{\delta} \right), \] então, com probabilidade de pelo menos \(1 - \delta\), toda hipótese \(h \in \mathcal{H}\) com erro de treinamento nulo tem \(L_{\mathcal{D}}(h) \leq \varepsilon\).
Demonstração. Chame de “ruim” uma hipótese com \(L_{\mathcal{D}}(h) > \varepsilon\). Uma hipótese ruim acerta um exemplo aleatório com probabilidade menor que \(1 - \varepsilon\); pela independência, acerta todos os \(m\) exemplos com probabilidade menor que \((1 - \varepsilon)^m \leq e^{-\varepsilon m}\) (pois \(1 - t \leq e^{-t}\)). Pela desigualdade de Boole (união), a probabilidade de que alguma hipótese ruim tenha erro de treinamento nulo é no máximo \[ |\mathcal{H}|\, e^{-\varepsilon m}. \] Impondo \(|\mathcal{H}| e^{-\varepsilon m} \leq \delta\) e isolando \(m\), obtém-se a condição do enunciado. \(\square\)
Quando nenhuma hipótese é perfeita (caso agnóstico, o mais realista), a desigualdade de Hoeffding (1963) — que afirma que, para cada \(h\) fixa, \(P(|L_S(h) - L_{\mathcal{D}}(h)| > \varepsilon) \leq 2e^{-2m\varepsilon^2}\) — combinada à desigualdade da união fornece a convergência uniforme: se
\[ m \geq \frac{1}{2\varepsilon^2} \ln\frac{2|\mathcal{H}|}{\delta}, \]
então, com probabilidade de pelo menos \(1 - \delta\), \(|L_S(h) - L_{\mathcal{D}}(h)| \leq \varepsilon\) simultaneamente para todas as \(h \in \mathcal{H}\). Em particular, minimizar o erro de treinamento (o princípio da minimização do risco empírico, visto no Capítulo de Introdução ao Aprendizado de Máquina) produz uma hipótese cujo erro verdadeiro está a no máximo \(2\varepsilon\) do melhor erro possível na classe.
Um sistema deve aprender uma regra de triagem que é uma conjunção de condições sobre 10 atributos binários (por exemplo, “renda alta E sem atrasos E NÃO autônomo”). Cada atributo pode aparecer na regra de forma positiva, negada ou não aparecer, logo \(|\mathcal{H}| = 3^{10} = 59.049\). Tome \(\varepsilon = 0{,}05\) e \(\delta = 0{,}01\).
- Caso realizável: \(\ln 59.049 \approx 10{,}986\) e \(\ln 100 \approx 4{,}605\); logo \[ m \geq \frac{1}{0{,}05}(10{,}986 + 4{,}605) = 20 \times 15{,}591 \approx 311{,}8 \;\Rightarrow\; m = 312. \]
- Caso agnóstico: \(\ln(2 \times 59.049 / 0{,}01) = \ln 11.809.800 \approx 16{,}284\); logo \[ m \geq \frac{16{,}284}{2 \times 0{,}05^2} = \frac{16{,}284}{0{,}005} \approx 3256{,}9 \;\Rightarrow\; m = 3.257. \]
Duas lições: a complexidade amostral cresce apenas com o logaritmo do tamanho da classe, mas cresce com \(1/\varepsilon^2\) (em vez de \(1/\varepsilon\)) quando não se supõe que exista uma regra perfeita. Esses limites são conservadores — valem para qualquer distribuição \(\mathcal{D}\) —, e na prática costuma-se precisar de menos exemplos.
2.11.2 Dimensão VC
O teorema anterior não se aplica ao perceptron, cuja classe de hipóteses é infinita (há infinitos hiperplanos). A solução de Vapnik e Chervonenkis (Vapnik 1995) foi medir a riqueza de uma classe não por seu tamanho, mas por sua capacidade de fragmentar (shatter) conjuntos de pontos.
Definição. Uma classe \(\mathcal{H}\) fragmenta um conjunto \(C = \{\mathbf{x}_1, \ldots, \mathbf{x}_k\}\) se, para cada uma das \(2^k\) rotulações possíveis de \(C\), existe \(h \in \mathcal{H}\) que a realiza. A dimensão VC de \(\mathcal{H}\), \(d_{\text{VC}}(\mathcal{H})\), é o tamanho do maior conjunto fragmentado por \(\mathcal{H}\).
Para classificadores lineares no plano (os perceptrons com \(p = 2\)):
- Três pontos não colineares são fragmentados. Para qualquer das \(2^3 = 8\) rotulações, basta uma reta que separe o ponto de rótulo minoritário (ou nenhum) dos demais.
- Nenhum conjunto de quatro pontos é fragmentado. Se os quatro pontos formam um quadrilátero convexo, a rotulação “diagonais com rótulos iguais” é exatamente o XOR, que já demonstramos não ser linearmente separável. Se um dos pontos está dentro do triângulo formado pelos outros três, rotular o ponto interno diferentemente dos demais é impossível, pois um semiplano que contém três pontos contém todo o triângulo (o semiplano é convexo). Se três dos pontos são colineares, rotular o do meio diferentemente dos extremos também é impossível.
Logo, \(d_{\text{VC}} = 3\) para retas no plano; em geral, para hiperplanos em \(\mathbb{R}^p\), \(d_{\text{VC}} = p + 1\) — o número de parâmetros \((\mathbf{w}, b)\). O resultado fundamental da teoria é que uma classe é PAC-aprendível se, e somente se, sua dimensão VC é finita, e a complexidade amostral no caso agnóstico é da ordem de
\[ m = O\!\left( \frac{d_{\text{VC}} + \ln(1/\delta)}{\varepsilon^2} \right), \]
em que \(\ln|\mathcal{H}|\) foi substituído por \(d_{\text{VC}}\) (Shalev-Shwartz e Ben-David 2014). Esse é o fundamento teórico do dilema viés-variância estudado no Capítulo de Introdução ao Aprendizado de Máquina: classes muito ricas (dimensão VC alta) podem ajustar quase qualquer coisa nos dados de treinamento, mas exigem muitos exemplos para generalizar.
A fragmentação pode ser verificada empiricamente com o perceptron implementado anteriormente (a classe Perceptron definida acima): como o algoritmo converge sempre que os dados são separáveis, se ele zera os erros, a rotulação é realizável.
from itertools import product
import numpy as np

def fragmenta(X, epocas=1000):
    """Lista as rotulações de X que o perceptron não conseguiu realizar."""
    falhas = []
    for rotulos in product([0, 1], repeat=len(X)):
        p = Perceptron(epocas=epocas).fit(X, np.array(rotulos))
        if p.erros_[-1] != 0:
            falhas.append(rotulos)
    return falhas

tres = np.array([[0, 0], [1, 0], [0, 1]])
quatro = np.array([[0, 0], [0, 1], [1, 0], [1, 1]])
print("3 pontos:", fragmenta(tres))
#> 3 pontos: []
print("4 pontos:", fragmenta(quatro))
#> 4 pontos: [(0, 1, 1, 0), (1, 0, 0, 1)]
As duas rotulações não realizadas para os quatro vértices do quadrado são o XOR e sua negação. (A falha do algoritmo em um número finito de épocas, isoladamente, não prova a não separabilidade; aqui, ela é confirmada pela demonstração da seção anterior.)
O teorema “não existe almoço grátis” (no free lunch) (Wolpert 1996) afirma, informalmente, que, quando se considera a média sobre todos os problemas possíveis, nenhum algoritmo de aprendizado é melhor que outro — nem mesmo melhor que um palpite aleatório fora da amostra de treinamento. A consequência prática é que todo aprendizado bem-sucedido depende de viés indutivo: hipóteses prévias (linearidade, suavidade, localidade) que restringem \(\mathcal{H}\) e que são adequadas ao problema em questão. Escolher o modelo é, portanto, escolher quais hipóteses fazer sobre o mundo.
2.12 Redes Neurais Multicamadas e Aprendizado Profundo
2.12.1 Arquitetura
Uma rede neural de múltiplas camadas (multilayer perceptron — MLP) organiza neurônios em camadas: uma camada de entrada, uma ou mais camadas ocultas e uma camada de saída. Com uma camada oculta de \(m\) neurônios e uma saída, a rede calcula
\[ \begin{aligned} \mathbf{h} &= g\big(\mathbf{W}^{(1)} \mathbf{x} + \mathbf{b}^{(1)}\big), \qquad \mathbf{W}^{(1)} \in \mathbb{R}^{m \times p},\ \mathbf{b}^{(1)} \in \mathbb{R}^m, \\ \hat{y} &= \sigma\big(\mathbf{w}^{(2)\top} \mathbf{h} + b^{(2)}\big), \end{aligned} \]
em que \(g\) é uma função de ativação não linear aplicada elemento a elemento e \(\sigma\) é uma função de saída adequada ao problema. As funções de ativação mais comuns são:
| Função | Expressão | Imagem |
|---|---|---|
| Sigmoide (logística) | \(\sigma(z) = \dfrac{1}{1 + e^{-z}}\) | \((0, 1)\) |
| Tangente hiperbólica | \(\tanh(z) = \dfrac{e^{z} - e^{-z}}{e^{z} + e^{-z}}\) | \((-1, 1)\) |
| ReLU | \(\operatorname{ReLU}(z) = \max(0, z)\) | \([0, \infty)\) |
A não linearidade é essencial: se \(g\) fosse a identidade, a composição de camadas lineares seria ainda uma função linear, e a rede não teria mais poder de representação que um único neurônio. Note também que, com saída sigmoide e nenhuma camada oculta, o modelo \(\hat{y} = \sigma(\mathbf{w}^\top \mathbf{x} + b)\) é exatamente a regressão logística.
O teorema da aproximação universal (Cybenko 1989) garante que uma rede com uma única camada oculta e ativação sigmoide pode aproximar, com precisão arbitrária, qualquer função contínua definida em um subconjunto compacto de \(\mathbb{R}^p\), desde que tenha neurônios suficientes. O teorema é um resultado de existência: ele não diz quantos neurônios são necessários, nem como encontrar os pesos, nem se a rede generalizará bem para dados novos.
2.12.2 Derivadas das ativações e o desaparecimento do gradiente
O treinamento por gradiente, descrito a seguir, depende das derivadas das funções de ativação:
| Função | Derivada | Valor máximo da derivada |
|---|---|---|
| Sigmoide | \(\sigma'(z) = \sigma(z)\,[1 - \sigma(z)]\) | \(1/4\) (em \(z = 0\)) |
| Tangente hiperbólica | \(\tanh'(z) = 1 - \tanh^2(z)\) | \(1\) (em \(z = 0\)) |
| ReLU | \(\operatorname{ReLU}'(z) = \mathbf{1}\{z > 0\}\) | \(1\) |
Para verificar a primeira, escreva \(\sigma(z) = (1 + e^{-z})^{-1}\); então \(\sigma'(z) = e^{-z}(1 + e^{-z})^{-2} = \sigma(z) \cdot \frac{e^{-z}}{1 + e^{-z}} = \sigma(z)[1 - \sigma(z)]\), cujo máximo, atingido quando \(\sigma(z) = 1/2\), é \(1/4\).
Como veremos, o gradiente em relação aos pesos de uma camada inicial é um produto de termos, um por camada, que incluem essas derivadas. Numa rede com \(L\) camadas sigmoides, esse produto contém \(L\) fatores menores ou iguais a \(1/4\), e pode ser tão pequeno quanto \((1/4)^L\): com \(L = 10\), \((1/4)^{10} \approx 9{,}5 \times 10^{-7}\). As primeiras camadas praticamente deixam de aprender — é o problema do desaparecimento do gradiente (vanishing gradient), um dos motivos pelos quais redes profundas eram tão difíceis de treinar antes de 2006. A ReLU, cuja derivada é exatamente 1 na região ativa, foi uma das soluções; outra foram as conexões residuais, que somam a entrada de um bloco à sua saída e criam “atalhos” para o gradiente. Em contrapartida, um neurônio ReLU cuja entrada fica negativa para todos os exemplos tem derivada nula e para de aprender (o problema da “ReLU morta”), como ilustra o exemplo resolvido de retropropagação mais adiante.
Para problemas com \(K > 2\) classes, a camada de saída usa a função softmax, \(\hat{y}_k = e^{z_k}/\sum_{j=1}^{K} e^{z_j}\), que transforma \(K\) escores reais em uma distribuição de probabilidade — a mesma função que reaparecerá nos modelos de linguagem.
2.12.3 Exemplo resolvido: propagação para a frente
Considere uma rede com \(p = 2\) entradas, \(m = 2\) neurônios ocultos com ativação ReLU e uma saída sigmoide, com
\[ \mathbf{W}^{(1)} = \begin{pmatrix} 0{,}5 & -0{,}5 \\ 1{,}0 & 0{,}5 \end{pmatrix}, \quad \mathbf{b}^{(1)} = \begin{pmatrix} 0 \\ -1 \end{pmatrix}, \quad \mathbf{w}^{(2)} = \begin{pmatrix} 1 \\ -1 \end{pmatrix}, \quad b^{(2)} = 0{,}5, \]
e a entrada \(\mathbf{x} = (1, 2)^\top\).
- Camada oculta, antes da ativação: \(\mathbf{W}^{(1)}\mathbf{x} + \mathbf{b}^{(1)} = \begin{pmatrix} 0{,}5 - 1{,}0 + 0 \\ 1{,}0 + 1{,}0 - 1 \end{pmatrix} = \begin{pmatrix} -0{,}5 \\ 1{,}0 \end{pmatrix}\).
- Após a ReLU: \(\mathbf{h} = (\max(0, -0{,}5),\ \max(0, 1)) = (0,\ 1)\).
- Saída, antes da ativação: \(z = 1 \cdot 0 + (-1) \cdot 1 + 0{,}5 = -0{,}5\).
- Saída: \(\hat{y} = \sigma(-0{,}5) = 1/(1 + e^{0{,}5}) \approx 1/2{,}6487 \approx 0{,}378\).
A rede atribui probabilidade de aproximadamente \(37{,}8\%\) à classe positiva para essa entrada.
2.12.4 Treinamento: gradiente descendente e retropropagação
Os parâmetros \(\boldsymbol{\theta}\) (todos os pesos e vieses) são escolhidos minimizando uma função de perda média sobre os \(n\) exemplos de treinamento. Em classificação binária, usa-se a entropia cruzada binária
\[ L(\boldsymbol{\theta}) = -\frac{1}{n} \sum_{i=1}^{n} \Big[ y_i \log \hat{y}_i + (1 - y_i) \log(1 - \hat{y}_i) \Big], \]
que é o negativo da log-verossimilhança média de um modelo de Bernoulli — o mesmo critério da regressão logística. A minimização é feita pelo gradiente descendente:
\[ \boldsymbol{\theta} \leftarrow \boldsymbol{\theta} - \eta\, \nabla_{\boldsymbol{\theta}} L(\boldsymbol{\theta}). \]
O algoritmo de retropropagação (Rumelhart, Hinton, e Williams 1986) é simplesmente uma forma eficiente de calcular \(\nabla_{\boldsymbol{\theta}} L\) aplicando a regra da cadeia do cálculo, camada por camada, da saída para a entrada. Na prática, o gradiente é estimado em pequenos subconjuntos aleatórios dos dados (mini-batches), o que caracteriza o gradiente descendente estocástico.
Para ilustrar a regra da cadeia, considere um único neurônio sigmoide \(\hat{y} = \sigma(z)\), \(z = wx + b\), e a perda de um exemplo \(\ell = -[y \log \hat{y} + (1-y)\log(1-\hat{y})]\). Usando \(\sigma'(z) = \sigma(z)(1 - \sigma(z))\):
\[ \frac{\partial \ell}{\partial w} = \frac{\partial \ell}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial z} \cdot \frac{\partial z}{\partial w} = \left( -\frac{y}{\hat{y}} + \frac{1-y}{1-\hat{y}} \right) \hat{y}(1-\hat{y})\, x = (\hat{y} - y)\, x. \]
Esse resultado elegante — o gradiente é o erro de previsão multiplicado pela entrada — tem a mesma forma da regra do perceptron, com a diferença de que \(\hat{y}\) agora é uma probabilidade contínua.
2.12.5 Por que o gradiente descendente funciona?
O gradiente \(\nabla L(\boldsymbol{\theta})\) aponta na direção de maior crescimento local da perda; andar no sentido oposto deveria, portanto, reduzi-la. Para tornar esse argumento preciso, suponha que \(L\) seja \(\beta\)-suave, isto é, que seu gradiente seja Lipschitz com constante \(\beta\): \(\|\nabla L(\boldsymbol{\theta}) - \nabla L(\boldsymbol{\theta}')\| \leq \beta\|\boldsymbol{\theta} - \boldsymbol{\theta}'\|\). Um resultado padrão de análise garante, então, a cota quadrática
\[ L(\boldsymbol{\theta}') \leq L(\boldsymbol{\theta}) + \nabla L(\boldsymbol{\theta})^\top (\boldsymbol{\theta}' - \boldsymbol{\theta}) + \frac{\beta}{2}\|\boldsymbol{\theta}' - \boldsymbol{\theta}\|^2. \]
Substituindo o passo do gradiente \(\boldsymbol{\theta}' = \boldsymbol{\theta} - \eta\nabla L(\boldsymbol{\theta})\):
\[ L(\boldsymbol{\theta}') \leq L(\boldsymbol{\theta}) - \eta\|\nabla L(\boldsymbol{\theta})\|^2 + \frac{\beta\eta^2}{2}\|\nabla L(\boldsymbol{\theta})\|^2 = L(\boldsymbol{\theta}) - \eta\left(1 - \frac{\beta\eta}{2}\right)\|\nabla L(\boldsymbol{\theta})\|^2. \]
Logo, se \(0 < \eta < 2/\beta\), cada passo diminui a perda enquanto o gradiente não for nulo. Se, além disso, \(L\) for convexa (como na regressão logística), o método converge para um mínimo global; em redes neurais, \(L\) não é convexa, e o gradiente descendente converge, em geral, apenas para pontos estacionários — que, na prática, costumam ser soluções de boa qualidade.
Minimize \(L(w) = (w - 3)^2\), a partir de \(w_0 = 0\). Como \(L'(w) = 2(w - 3)\) e \(L''(w) = 2\), a função é \(\beta\)-suave com \(\beta = 2\), e a condição é \(\eta < 1\). O passo é \[ w_{t+1} = w_t - 2\eta(w_t - 3) \quad\Longrightarrow\quad w_{t+1} - 3 = (1 - 2\eta)(w_t - 3) \quad\Longrightarrow\quad w_t = 3 - 3(1 - 2\eta)^t. \]
- Com \(\eta = 0{,}1\): o fator é \(0{,}8\), e \(w_1 = 0{,}6\), \(w_2 = 1{,}08\), \(w_3 = 1{,}464\), …, \(w_{10} = 3(1 - 0{,}8^{10}) \approx 2{,}678\). Converge, lentamente, para 3.
- Com \(\eta = 0{,}5\): o fator é \(0\) e \(w_1 = 3\) — convergência em um passo (para uma quadrática, \(\eta = 1/\beta\) é ótimo).
- Com \(\eta = 1{,}1\): o fator é \(-1{,}2\), e \(w_1 = 6{,}6\), \(w_2 = -1{,}32\), \(w_3 = 8{,}184\), …: o algoritmo oscila com amplitude crescente e diverge.
Na prática, utilizam-se variantes do gradiente descendente estocástico: o momento (momentum), que acumula uma média móvel dos gradientes para atravessar regiões planas e amortecer oscilações, e métodos adaptativos como o Adam (Kingma e Ba 2015), que ajustam uma taxa de aprendizado separada para cada parâmetro.
2.12.6 Retropropagação em notação matricial
Considere uma rede com camadas \(l = 1, \ldots, L\), em que \(\mathbf{h}^{(0)} = \mathbf{x}\) e
\[ \mathbf{a}^{(l)} = \mathbf{W}^{(l)}\mathbf{h}^{(l-1)} + \mathbf{b}^{(l)}, \qquad \mathbf{h}^{(l)} = g\big(\mathbf{a}^{(l)}\big), \]
com saída sigmoide \(\hat{y} = \sigma(a^{(L)})\) e perda de entropia cruzada \(\ell\). Defina o erro da camada \(l\) como \(\boldsymbol{\delta}^{(l)} = \partial \ell / \partial \mathbf{a}^{(l)}\). A regra da cadeia fornece as quatro equações da retropropagação:
\[ \begin{aligned} \delta^{(L)} &= \hat{y} - y, \\ \boldsymbol{\delta}^{(l)} &= \big(\mathbf{W}^{(l+1)\top}\boldsymbol{\delta}^{(l+1)}\big) \odot g'\big(\mathbf{a}^{(l)}\big), \qquad l = L-1, \ldots, 1, \\ \frac{\partial \ell}{\partial \mathbf{W}^{(l)}} &= \boldsymbol{\delta}^{(l)}\,\mathbf{h}^{(l-1)\top}, \qquad \frac{\partial \ell}{\partial \mathbf{b}^{(l)}} = \boldsymbol{\delta}^{(l)}, \end{aligned} \]
em que \(\odot\) denota o produto elemento a elemento. A primeira equação é a generalização do resultado \((\hat{y} - y)x\) obtido acima; a segunda “propaga o erro para trás”, multiplicando pela transposta da matriz de pesos e pela derivada da ativação — e é nela que surgem os produtos responsáveis pelo desaparecimento do gradiente. O custo de calcular todo o gradiente é da mesma ordem que o de uma única propagação para a frente, o que torna viável treinar redes com bilhões de parâmetros.
Retome a rede do exemplo de propagação para a frente, com \(\mathbf{x} = (1, 2)^\top\), e suponha que o rótulo verdadeiro seja \(y = 1\). Da propagação para a frente, temos \(\mathbf{a}^{(1)} = (-0{,}5;\ 1)^\top\), \(\mathbf{h} = (0;\ 1)^\top\) e \(\hat{y} \approx 0{,}3775\); a perda é \(\ell = -\ln 0{,}3775 \approx 0{,}974\).
- Erro da saída: \(\delta^{(2)} = \hat{y} - y \approx 0{,}3775 - 1 = -0{,}6225\).
- Gradientes da camada de saída: \(\partial \ell / \partial \mathbf{w}^{(2)} = \delta^{(2)}\mathbf{h} = (0;\ -0{,}6225)^\top\) e \(\partial \ell / \partial b^{(2)} = -0{,}6225\).
- Erro da camada oculta: \(\boldsymbol{\delta}^{(1)} = \delta^{(2)}\,\mathbf{w}^{(2)} \odot \operatorname{ReLU}'(\mathbf{a}^{(1)}) = -0{,}6225 \cdot (1;\ -1)^\top \odot (0;\ 1)^\top = (0;\ 0{,}6225)^\top\). O primeiro neurônio, inativo (\(a_1 = -0{,}5 < 0\)), não recebe gradiente.
- Gradientes da camada oculta: \[ \frac{\partial \ell}{\partial \mathbf{W}^{(1)}} = \boldsymbol{\delta}^{(1)}\mathbf{x}^\top = \begin{pmatrix} 0 & 0 \\ 0{,}6225 & 1{,}2449 \end{pmatrix}, \qquad \frac{\partial \ell}{\partial \mathbf{b}^{(1)}} = \begin{pmatrix} 0 \\ 0{,}6225 \end{pmatrix}. \]
- Atualização com \(\eta = 0{,}5\): \(b^{(2)}\) passa de \(0{,}5\) para \(0{,}5 + 0{,}5 \times 0{,}6225 \approx 0{,}811\); \(w^{(2)}_2\) passa de \(-1\) para \(\approx -0{,}689\); a segunda linha de \(\mathbf{W}^{(1)}\) passa de \((1;\ 0{,}5)\) para \(\approx (0{,}689;\ -0{,}122)\) e \(b^{(1)}_2\), de \(-1\) para \(\approx -1{,}311\).
- Nova propagação: \(a^{(1)}_2 \approx 0{,}689 - 0{,}245 - 1{,}311 \approx -0{,}867 < 0\), de modo que os dois neurônios ocultos ficam inativos, \(\mathbf{h} = (0;\ 0)\) e \(\hat{y} = \sigma(0{,}811) \approx 0{,}692\). A perda caiu de \(0{,}974\) para \(-\ln 0{,}692 \approx 0{,}368\).
O passo cumpriu seu papel — a probabilidade da classe correta subiu de 38% para 69% —, mas com uma taxa de aprendizado grande ele “desligou” o segundo neurônio para essa entrada: um exemplo concreto do problema da ReLU morta. Uma verificação útil em implementações é comparar o gradiente analítico com a diferença finita \([\ell(\theta + \epsilon) - \ell(\theta)]/\epsilon\); para \(W^{(1)}_{22}\), com \(\epsilon = 10^{-6}\), obtém-se \(1{,}2449\), como no item 4.
O código a seguir implementa, apenas com numpy, uma rede com uma camada oculta de quatro neurônios (ativação \(\tanh\)) treinada por gradiente descendente para resolver o XOR — o problema que o perceptron de uma camada não consegue resolver:
import numpy as np

def sigmoide(z):
    return 1.0 / (1.0 + np.exp(-z))

X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
y = np.array([0, 1, 1, 0], dtype=float)

rng = np.random.default_rng(42)
m = 4                                   # neurônios ocultos
W1 = rng.normal(0, 1, size=(2, m)); b1 = np.zeros(m)
w2 = rng.normal(0, 1, size=m);      b2 = 0.0
eta, n = 0.5, len(y)

for epoca in range(5001):
    # Propagação para a frente (todas as observações de uma vez)
    H = np.tanh(X @ W1 + b1)            # n x m
    y_hat = sigmoide(H @ w2 + b2)       # n
    perda = -np.mean(y * np.log(y_hat) + (1 - y) * np.log(1 - y_hat))

    # Retropropagação
    d2 = (y_hat - y) / n                # dL/da da saída
    g_w2 = H.T @ d2
    g_b2 = d2.sum()
    d1 = np.outer(d2, w2) * (1 - H**2)  # tanh'(a) = 1 - tanh(a)^2
    g_W1 = X.T @ d1
    g_b1 = d1.sum(axis=0)

    # Passo do gradiente descendente
    W1 -= eta * g_W1; b1 -= eta * g_b1
    w2 -= eta * g_w2; b2 -= eta * g_b2
    if epoca % 1000 == 0:
        print(f"época {epoca:4d}: perda = {perda:.4f}")

print("probabilidades:", y_hat.round(3))
print("classes previstas:", (y_hat > 0.5).astype(int))
#> época    0: perda = 0.8299
#> época 1000: perda = 0.0055
#> época 2000: perda = 0.0024
#> época 3000: perda = 0.0015
#> época 4000: perda = 0.0011
#> época 5000: perda = 0.0009
#> probabilidades: [0.    0.999 0.999 0.001]
#> classes previstas: [0 1 1 0]Como a perda de uma rede neural não é convexa, o resultado depende da inicialização. Executando o mesmo código com a semente default_rng(0), a perda estaciona em torno de \(0{,}347\) e a rede classifica corretamente apenas dois dos quatro pontos: o algoritmo ficou preso em uma região ruim da superfície de perda. Na prática, usam-se inicializações cuidadosas, várias reinicializações e redes mais largas, que tornam esse problema muito menos frequente.
2.12.7 Aprendizado profundo
Redes com muitas camadas ocultas são chamadas profundas. A principal vantagem da profundidade é o aprendizado de representações: as primeiras camadas aprendem características simples (em imagens, bordas e texturas), e as camadas seguintes as combinam em características progressivamente mais abstratas (partes de objetos, objetos inteiros) (LeCun, Bengio, e Hinton 2015; Goodfellow, Bengio, e Courville 2016). Isso elimina boa parte da engenharia manual de atributos, mas exige muitos dados e grande capacidade computacional. Algumas arquiteturas importantes:
- Redes convolucionais (Convolutional Neural Networks — CNNs): compartilham pesos por meio de filtros aplicados em diferentes posições da entrada, explorando a estrutura espacial de imagens.
- Redes recorrentes (Recurrent Neural Networks — RNNs): processam sequências mantendo um estado oculto que é atualizado a cada elemento; foram dominantes em texto e fala antes dos transformers.
- Transformers: processam sequências inteiras em paralelo por meio do mecanismo de atenção, descrito a seguir.
O estudo detalhado de redes neurais profundas está além do escopo deste livro introdutório. Os métodos das Partes III e IV — árvores, florestas, k-NN, SVM, regressão e k-médias — continuam sendo, em dados tabulares de tamanho moderado, frequentemente tão bons ou melhores que redes neurais, além de mais simples de treinar e interpretar.
2.13 IA Generativa e Grandes Modelos de Linguagem
2.13.1 Modelos discriminativos e generativos
Do ponto de vista estatístico, a distinção entre modelos discriminativos e generativos é clara:
- Um modelo discriminativo estima diretamente a distribuição condicional \(P(Y \mid X)\), isto é, a probabilidade da resposta dadas as variáveis explicativas. A regressão logística e a maioria dos classificadores da Parte III deste livro são discriminativos.
- Um modelo generativo estima a distribuição dos próprios dados, \(P(X)\) ou \(P(X, Y)\). Uma vez estimada essa distribuição, é possível amostrar dela, gerando novos exemplos semelhantes aos de treinamento: novos textos, imagens, sons.
A IA generativa é, portanto, a aplicação em larga escala de modelos generativos a dados de altíssima dimensão. Entre as famílias de modelos usadas estão os modelos autorregressivos (base dos LLMs), as redes adversariais generativas (Generative Adversarial Networks — GANs) (Goodfellow et al. 2014) e os modelos de difusão (muito usados para geração de imagens).
2.13.2 Modelos de linguagem
Um modelo de linguagem atribui probabilidades a sequências de unidades de texto, chamadas tokens (palavras, partes de palavras ou caracteres). Pela regra do produto da probabilidade, qualquer distribuição sobre uma sequência \(w_1, w_2, \ldots, w_T\) pode ser fatorada como
\[ P(w_1, w_2, \ldots, w_T) = \prod_{t=1}^{T} P(w_t \mid w_1, \ldots, w_{t-1}). \]
Um modelo autorregressivo aprende cada fator \(P(w_t \mid w_{<t})\), isto é, a distribuição do próximo token dado o contexto anterior. Para gerar texto, o modelo sorteia um token dessa distribuição, acrescenta-o ao contexto e repete o processo. Os LLMs são modelos autorregressivos baseados em transformers com bilhões de parâmetros, treinados para minimizar a entropia cruzada da previsão do próximo token em enormes coleções de texto.
Os modelos de linguagem estatísticos não são novidade: os modelos de \(n\)-gramas, que aproximam \(P(w_t \mid w_{<t}) \approx P(w_t \mid w_{t-n+1}, \ldots, w_{t-1})\) e estimam essas probabilidades por frequências relativas, foram usados por décadas em reconhecimento de fala e tradução. A novidade dos LLMs está na capacidade de usar contextos muito longos e de generalizar para combinações nunca vistas.
Considere o “corpus” formado pelas três frases: “o gato dorme”, “o gato come”, “o cão dorme”. Num modelo de bigramas (\(n = 2\)), estimamos \(P(w_t \mid w_{t-1})\) por frequências relativas:
- \(\hat{P}(\text{gato} \mid \text{o}) = 2/3\), \(\hat{P}(\text{cão} \mid \text{o}) = 1/3\);
- \(\hat{P}(\text{dorme} \mid \text{gato}) = 1/2\), \(\hat{P}(\text{come} \mid \text{gato}) = 1/2\);
- \(\hat{P}(\text{dorme} \mid \text{cão}) = 1\).
Assim, \(\hat{P}(\text{"o cão dorme"} \mid \text{começa com "o"}) = 1/3 \times 1 = 1/3\), enquanto \(\hat{P}(\text{"o cão come"}) = 1/3 \times 0 = 0\): o modelo atribui probabilidade zero a uma frase perfeitamente plausível apenas porque ela não apareceu no corpus. Esse problema de esparsidade motivou técnicas de suavização e, mais tarde, as representações vetoriais contínuas usadas nas redes neurais, que permitem generalizar de “gato” para “cão”.
2.13.3 Avaliando modelos de linguagem: entropia cruzada e perplexidade
Como avaliar um modelo de linguagem? Dado um texto de teste \(w_1, \ldots, w_N\), a medida natural é a entropia cruzada média por token,
\[ H = -\frac{1}{N}\sum_{t=1}^{N} \ln \hat{P}(w_t \mid w_{<t}), \]
que é exatamente a perda minimizada no treinamento (o negativo da log-verossimilhança média). Na literatura de processamento de linguagem natural, é comum reportar sua exponencial, a perplexidade:
\[ \text{PP} = e^{H} = \left( \prod_{t=1}^{N} \hat{P}(w_t \mid w_{<t}) \right)^{-1/N}. \]
A perplexidade tem uma interpretação intuitiva: se o modelo distribuísse sua probabilidade uniformemente entre \(k\) tokens a cada passo, teríamos \(\text{PP} = k\). Assim, ela mede o “número efetivo de escolhas” entre as quais o modelo hesita; quanto menor, melhor.
No modelo de bigramas do exemplo anterior, a frase “o gato dorme” (dado que começa com “o”) envolve duas previsões, com probabilidades \(2/3\) e \(1/2\). Logo, \[ \text{PP} = \left( \tfrac{2}{3} \times \tfrac{1}{2} \right)^{-1/2} = \sqrt{3} \approx 1{,}73. \] Já para “o cão come” a probabilidade é zero e a perplexidade é infinita: um único bigrama não visto torna o modelo inutilizável. A suavização de Laplace soma 1 a todas as contagens: com vocabulário \(V = \{\text{o, gato, cão, dorme, come}\}\) de tamanho 5, \[ \hat{P}_{\text{L}}(w_t \mid w_{t-1}) = \frac{c(w_{t-1}, w_t) + 1}{c(w_{t-1}) + |V|}, \] de modo que \(\hat{P}_{\text{L}}(\text{cão} \mid \text{o}) = (1 + 1)/(3 + 5) = 0{,}25\) e \(\hat{P}_{\text{L}}(\text{come} \mid \text{cão}) = (0 + 1)/(1 + 5) = 1/6\). A frase passa a ter probabilidade \(0{,}25 \times 1/6 \approx 0{,}042\) e perplexidade \((0{,}042)^{-1/2} \approx 4{,}9\): finita, embora alta.
2.13.4 Tokenização
Antes de qualquer modelagem, o texto precisa ser dividido em tokens. Usar palavras inteiras gera vocabulários enormes e não resolve o problema de palavras novas (nomes próprios, erros de digitação, termos técnicos); usar caracteres gera sequências muito longas. Os LLMs atuais adotam um meio-termo: subpalavras, obtidas, por exemplo, pelo algoritmo Byte Pair Encoding (BPE), adaptado para tradução automática por Sennrich, Haddow, e Birch (2016). O BPE começa com um vocabulário de caracteres e repete o seguinte passo um número predeterminado de vezes: encontrar o par de símbolos adjacentes mais frequente no corpus e fundi-lo em um novo símbolo.
Considere um corpus com as palavras casa (5 ocorrências), casas (3), caso (2) e asa (4), separadas em caracteres e com o marcador de fim de palavra “_”.
- O par mais frequente é (a, s): \(5 + 2 \times 3 + 2 + 4 = 17\) ocorrências (note que casas contém o par duas vezes). Funde-se em as:
c as a _,c as as _,c as o _,as a _. - Agora o par mais frequente é (c, as), com \(5 + 3 + 2 = 10\) ocorrências, formando cas.
- Em seguida, (a, _), com \(5 + 4 = 9\), formando a_ (um “a” em final de palavra).
- Por fim, (cas, a_), com 5, formando casa_.
Após quatro fusões, casa é um único token, enquanto casas é representada como cas + as + _. Uma palavra nunca vista, como casarão, ainda pode ser representada por pedaços conhecidos (cas, a, r, …). Os modelos atuais aplicam esse procedimento a corpora gigantescos, até obter vocabulários de dezenas ou centenas de milhares de subpalavras.
from collections import Counter

def pares(vocab):
    contagem = Counter()
    for palavra, freq in vocab.items():
        simbolos = palavra.split()
        for a, b in zip(simbolos, simbolos[1:]):
            contagem[(a, b)] += freq
    return contagem

def fundir(par, vocab):
    a, b = par
    novo = {}
    for palavra, freq in vocab.items():
        s, i, saida = palavra.split(), 0, []
        while i < len(s):
            if i < len(s) - 1 and s[i] == a and s[i + 1] == b:
                saida.append(a + b); i += 2
            else:
                saida.append(s[i]); i += 1
        novo[" ".join(saida)] = freq
    return novo

vocab = {"c a s a _": 5, "c a s a s _": 3, "c a s o _": 2, "a s a _": 4}
for passo in range(1, 5):
    contagem = pares(vocab)
    melhor = max(contagem, key=contagem.get)
    vocab = fundir(melhor, vocab)
    print(passo, melhor, contagem[melhor])
#> 1 ('a', 's') 17
#> 2 ('c', 'as') 10
#> 3 ('a', '_') 9
#> 4 ('cas', 'a_') 5
print(vocab)
#> {'casa_': 5, 'cas as _': 3, 'cas o _': 2, 'as a_': 4}
2.13.5 Representações vetoriais (embeddings)
Um modelo de \(n\)-gramas trata “gato” e “cão” como símbolos sem relação alguma. As redes neurais, ao contrário, associam a cada token um vetor \(\mathbf{e} \in \mathbb{R}^d\), chamado embedding, aprendido durante o treinamento. A ideia remonta à hipótese distribucional da linguística — palavras que ocorrem em contextos semelhantes têm significados semelhantes — e foi popularizada pelo word2vec (Mikolov et al. 2013), que aprende os vetores prevendo palavras a partir de seus vizinhos. A semelhança entre dois tokens é medida pela similaridade do cosseno:
\[ \cos(\mathbf{u}, \mathbf{v}) = \frac{\mathbf{u}^\top \mathbf{v}}{\|\mathbf{u}\|\,\|\mathbf{v}\|} \in [-1, 1]. \]
Suponha os embeddings (fictícios, em \(d = 3\) dimensões) \(\mathbf{e}_{\text{gato}} = (0{,}9;\ 0{,}8;\ 0{,}1)\), \(\mathbf{e}_{\text{cão}} = (0{,}8;\ 0{,}9;\ 0{,}2)\) e \(\mathbf{e}_{\text{carro}} = (0{,}1;\ 0{,}2;\ 0{,}9)\).
- \(\mathbf{e}_{\text{gato}}^\top \mathbf{e}_{\text{cão}} = 0{,}72 + 0{,}72 + 0{,}02 = 1{,}46\); \(\|\mathbf{e}_{\text{gato}}\| = \sqrt{1{,}46} \approx 1{,}208\); \(\|\mathbf{e}_{\text{cão}}\| = \sqrt{1{,}49} \approx 1{,}221\). Logo, \(\cos \approx 1{,}46/(1{,}208 \times 1{,}221) \approx 0{,}990\).
- \(\mathbf{e}_{\text{gato}}^\top \mathbf{e}_{\text{carro}} = 0{,}09 + 0{,}16 + 0{,}09 = 0{,}34\); \(\|\mathbf{e}_{\text{carro}}\| = \sqrt{0{,}86} \approx 0{,}927\). Logo, \(\cos \approx 0{,}34/(1{,}208 \times 0{,}927) \approx 0{,}303\).
No espaço vetorial, “gato” está muito mais próximo de “cão” do que de “carro”. É isso que permite a um modelo neural generalizar: o que aprendeu sobre “o gato dorme” transfere-se, em parte, para “o cão dorme” — exatamente o que faltava ao modelo de bigramas.
Os embeddings aprendidos exibem regularidades surpreendentes, como a célebre analogia \(\mathbf{e}_{\text{rei}} - \mathbf{e}_{\text{homem}} + \mathbf{e}_{\text{mulher}} \approx \mathbf{e}_{\text{rainha}}\) (Mikolov et al. 2013). Eles também são uma forma de aprendizado de representações: transformam dados não estruturados (texto) em vetores numéricos que podem alimentar qualquer método das Partes III e IV deste livro, como k-NN ou k-médias.
2.13.6 Softmax e temperatura
Na última camada, o modelo produz um vetor de escores reais \(\mathbf{z} = (z_1, \ldots, z_V)\) (os logits), um para cada token do vocabulário de tamanho \(V\). Esses escores são convertidos em probabilidades pela função softmax com temperatura \(\tau > 0\):
\[ P(w = k \mid \text{contexto}) = \frac{\exp(z_k / \tau)}{\sum_{j=1}^{V} \exp(z_j / \tau)}. \]
Com \(\tau = 1\), temos a softmax usual. Valores \(\tau < 1\) concentram a probabilidade nos tokens mais prováveis (texto mais previsível); valores \(\tau > 1\) espalham a probabilidade (texto mais diverso, porém mais propenso a erros). No limite \(\tau \to 0\), a escolha torna-se determinística (sempre o token de maior escore).
Após o contexto “A capital de Pernambuco é”, suponha que o modelo produza os logits \(z = (2{,}0;\ 1{,}0;\ 0{,}0)\) para os tokens “Recife”, “Olinda” e “Paris”.
Com \(\tau = 1\): \(e^{2} \approx 7{,}389\), \(e^{1} \approx 2{,}718\), \(e^{0} = 1\); soma \(\approx 11{,}107\). Logo,
\[ P = (7{,}389;\ 2{,}718;\ 1)/11{,}107 \approx (0{,}665;\ 0{,}245;\ 0{,}090). \]
Com \(\tau = 0{,}5\): os expoentes dobram, \(e^{4} \approx 54{,}598\), \(e^{2} \approx 7{,}389\), \(e^{0} = 1\); soma \(\approx 62{,}987\), e \(P \approx (0{,}867;\ 0{,}117;\ 0{,}016)\).
Com \(\tau = 2\): \(e^{1} \approx 2{,}718\), \(e^{0{,}5} \approx 1{,}649\), \(e^{0} = 1\); soma \(\approx 5{,}367\), e \(P \approx (0{,}506;\ 0{,}307;\ 0{,}186)\).
Com temperatura alta, a resposta errada “Paris” passa a ter quase 19% de probabilidade de ser sorteada.
import numpy as np

def softmax(z, tau=1.0):
    z = np.asarray(z, dtype=float) / tau
    z = z - z.max()                 # estabilidade numérica
    e = np.exp(z)
    return e / e.sum()

logits = [2.0, 1.0, 0.0]
tokens = ["Recife", "Olinda", "Paris"]
for tau in [0.5, 1.0, 2.0]:
    probs = softmax(logits, tau).round(3)
    print(tau, {t: float(pr) for t, pr in zip(tokens, probs)})
#> 0.5 {'Recife': 0.867, 'Olinda': 0.117, 'Paris': 0.016}
#> 1.0 {'Recife': 0.665, 'Olinda': 0.245, 'Paris': 0.09}
#> 2.0 {'Recife': 0.506, 'Olinda': 0.307, 'Paris': 0.186}

# Geração por amostragem: 1000 sorteios com tau = 2
rng = np.random.default_rng(123)
amostra = rng.choice(tokens, size=1000, p=softmax(logits, 2.0))
print({t: int((amostra == t).sum()) for t in tokens})
Subtrair o máximo dos logits antes de exponenciar não altera o resultado (o fator \(e^{-\max z}\) se cancela no numerador e no denominador), mas evita estouro numérico.
2.13.7 O mecanismo de atenção
A peça central do transformer é a atenção (attention) (Vaswani et al. 2017). Cada token da sequência é representado por um vetor, a partir do qual se calculam três vetores: uma consulta (query), uma chave (key) e um valor (value). Empilhando-os nas matrizes \(\mathbf{Q}\), \(\mathbf{K}\) e \(\mathbf{V}\), a atenção é
\[ \operatorname{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \operatorname{softmax}\!\left( \frac{\mathbf{Q}\mathbf{K}^\top}{\sqrt{d_k}} \right) \mathbf{V}, \]
em que \(d_k\) é a dimensão das chaves e a softmax é aplicada a cada linha. Intuitivamente, o produto interno entre a consulta de um token e a chave de outro mede o quanto o primeiro deve “prestar atenção” ao segundo; a nova representação de cada token é uma média ponderada dos valores de todos os tokens, com pesos dados por essas afinidades. Isso permite que, na frase “O banco recusou o empréstimo porque ele estava com pouco caixa”, a representação de “ele” incorpore informação de “banco”. A divisão por \(\sqrt{d_k}\) evita que os produtos internos fiquem muito grandes, o que saturaria a softmax.
Considere dois tokens com \(d_k = 2\) e \[ \mathbf{Q} = \begin{pmatrix} 1 & 0 \\ 0 & 1 \end{pmatrix}, \qquad \mathbf{K} = \begin{pmatrix} 1 & 0 \\ 1 & 1 \end{pmatrix}, \qquad \mathbf{V} = \begin{pmatrix} 1 & 2 \\ 3 & 4 \end{pmatrix}. \]
- Escores: \(\mathbf{Q}\mathbf{K}^\top/\sqrt{2} = \begin{pmatrix} 1 & 1 \\ 0 & 1 \end{pmatrix} / \sqrt{2} \approx \begin{pmatrix} 0{,}707 & 0{,}707 \\ 0 & 0{,}707 \end{pmatrix}\).
- Pesos (softmax por linha): a primeira linha tem escores iguais, logo pesos \((0{,}5;\ 0{,}5)\). Na segunda, \(e^{0} = 1\) e \(e^{0{,}707} \approx 2{,}028\), logo pesos \(\approx (1/3{,}028;\ 2{,}028/3{,}028) \approx (0{,}330;\ 0{,}670)\).
- Saídas (médias ponderadas das linhas de \(\mathbf{V}\)):
- token 1: \(0{,}5\,(1, 2) + 0{,}5\,(3, 4) = (2;\ 3)\);
- token 2: \(0{,}330\,(1, 2) + 0{,}670\,(3, 4) \approx (2{,}34;\ 3{,}34)\).
O segundo token “presta mais atenção” ao segundo valor porque sua consulta \((0, 1)\) tem produto interno maior com a segunda chave \((1, 1)\) do que com a primeira \((1, 0)\). Num transformer real, \(\mathbf{Q}\), \(\mathbf{K}\) e \(\mathbf{V}\) são obtidas multiplicando os embeddings por matrizes de parâmetros aprendidas, e várias “cabeças” de atenção operam em paralelo.
2.13.8 Do modelo pré-treinado ao assistente
Os assistentes conversacionais atuais costumam ser construídos em etapas:
- Pré-treinamento: o modelo aprende a prever o próximo token em um corpus muito grande e diverso, adquirindo conhecimento linguístico e factual de forma implícita.
- Ajuste fino supervisionado (supervised fine-tuning): o modelo é ajustado com exemplos de instruções e respostas desejadas.
- Alinhamento com preferências humanas: avaliadores comparam respostas alternativas, e o modelo é ajustado para produzir respostas preferidas — por exemplo, por aprendizado por reforço a partir de feedback humano (Reinforcement Learning from Human Feedback — RLHF) (Ouyang et al. 2022).
2.13.9 Limitações dos LLMs
- Alucinações: como o modelo gera texto plausível segundo a distribuição aprendida, e não consulta uma base de fatos verificada, ele pode produzir afirmações falsas com aparência convincente — inclusive referências bibliográficas inexistentes. Toda saída deve ser verificada.
- Conhecimento datado: o conhecimento do modelo limita-se, em princípio, aos dados de treinamento.
- Vieses: os modelos reproduzem vieses presentes nos textos de treinamento.
- Custo e opacidade: treinar e executar grandes modelos exige enorme capacidade computacional e energia, e seu funcionamento interno é difícil de interpretar.
- Compreensão: se os LLMs “entendem” o que dizem é uma questão aberta, que remete diretamente ao argumento do Quarto Chinês de Searle.
2.14 Aprendizado por Reforço
Nos ambientes sequenciais, as ações de um agente afetam não só a recompensa imediata, mas também os estados futuros. O aprendizado por reforço (reinforcement learning) estuda como um agente pode aprender, por tentativa e erro, a agir bem nesses ambientes, recebendo apenas um sinal numérico de recompensa (Sutton e Barto 2018). Foi a combinação de aprendizado por reforço com redes profundas e busca que permitiu ao AlphaGo vencer Lee Sedol, e é uma variante dele (o RLHF) que ajusta os grandes modelos de linguagem às preferências humanas.
2.14.1 Processos de decisão de Markov
O modelo matemático básico é o processo de decisão de Markov (MDP), definido por uma quíntupla \((\mathcal{S}, \mathcal{A}, P, R, \gamma)\):
- \(\mathcal{S}\) é o conjunto de estados e \(\mathcal{A}\) o conjunto de ações;
- \(P(s' \mid s, a)\) é a probabilidade de transição para \(s'\) ao executar \(a\) em \(s\);
- \(R(s, a, s')\) é a recompensa recebida nessa transição;
- \(\gamma \in [0, 1)\) é o fator de desconto, que pondera recompensas futuras.
A propriedade de Markov afirma que o próximo estado depende apenas do estado e da ação atuais, e não do histórico anterior. O comportamento do agente é uma política \(\pi(a \mid s)\), e seu objetivo é maximizar o retorno esperado
\[ G_t = R_{t+1} + \gamma R_{t+2} + \gamma^2 R_{t+3} + \cdots = \sum_{k=0}^{\infty} \gamma^k R_{t+k+1}. \]
Se as recompensas são limitadas por \(R_{\max}\), então \(|G_t| \leq R_{\max}/(1 - \gamma)\): o desconto garante que o retorno seja finito. A função valor de uma política, \(V^\pi(s) = \mathbb{E}_\pi[G_t \mid S_t = s]\), e a função valor-ação, \(Q^\pi(s, a) = \mathbb{E}_\pi[G_t \mid S_t = s, A_t = a]\), medem o quão bom é estar em um estado (ou executar uma ação nele) e seguir \(\pi\) dali em diante.
2.14.2 As equações de Bellman
Separando a primeira recompensa das demais, \(G_t = R_{t+1} + \gamma G_{t+1}\), obtém-se uma relação recursiva. A função valor ótima \(V^*(s) = \max_\pi V^\pi(s)\) satisfaz a equação de otimalidade de Bellman:
\[ V^*(s) = \max_{a \in \mathcal{A}} \sum_{s'} P(s' \mid s, a)\big[ R(s, a, s') + \gamma V^*(s') \big]. \]
Uma vez conhecida \(V^*\), a política ótima é gulosa em relação a ela: em cada estado, escolhe-se a ação que atinge o máximo. A equação sugere o algoritmo de iteração de valor: partir de \(V_0 = 0\) e aplicar repetidamente o lado direito como regra de atualização, \(V_{k+1} = \mathcal{T}V_k\).
O operador de Bellman \(\mathcal{T}\) é uma contração na norma do máximo: \(\|\mathcal{T}U - \mathcal{T}V\|_\infty \leq \gamma\|U - V\|_\infty\). Consequentemente, pelo teorema do ponto fixo de Banach, \(V^*\) é o único ponto fixo de \(\mathcal{T}\) e \(\|V_k - V^*\|_\infty \leq \gamma^k \|V_0 - V^*\|_\infty \to 0\).
Esboço da demonstração. Para cada \(s\), use \(|\max_a f(a) - \max_a g(a)| \leq \max_a |f(a) - g(a)|\): \[ |\mathcal{T}U(s) - \mathcal{T}V(s)| \leq \max_a \gamma \sum_{s'} P(s' \mid s, a)\,|U(s') - V(s')| \leq \gamma \|U - V\|_\infty, \] pois as probabilidades \(P(\cdot \mid s, a)\) somam 1. \(\square\)
Um robô de coleta de recicláveis tem dois estados: bateria alta (\(s_A\)) e bateria baixa (\(s_B\)). Com bateria alta, pode buscar (recompensa 2; continua com bateria alta com probabilidade 0,7 e fica com bateria baixa com probabilidade 0,3) ou esperar (recompensa 1; continua com bateria alta). Com bateria baixa, pode buscar (com probabilidade 0,6 coleta, recebe 2 e continua com bateria baixa; com probabilidade 0,4 a bateria acaba, ele precisa ser resgatado, recebe \(-10\) e volta com bateria alta) ou recarregar (recompensa 0; volta à bateria alta). Use \(\gamma = 0{,}9\).
- Iteração 1 (\(V_0 = 0\)): em \(s_A\), buscar vale 2 e esperar vale 1, logo \(V_1(s_A) = 2\); em \(s_B\), buscar vale \(0{,}6 \times 2 + 0{,}4 \times (-10) = -2{,}8\) e recarregar vale 0, logo \(V_1(s_B) = 0\).
- Iteração 2: em \(s_A\), buscar vale \(2 + 0{,}9(0{,}7 \times 2 + 0{,}3 \times 0) = 3{,}26\) e esperar, \(1 + 0{,}9 \times 2 = 2{,}8\); logo \(V_2(s_A) = 3{,}26\). Em \(s_B\), buscar vale \(-2{,}8 + 0{,}9(0{,}6 \times 0 + 0{,}4 \times 2) = -2{,}08\) e recarregar, \(0{,}9 \times 2 = 1{,}8\); logo \(V_2(s_B) = 1{,}8\).
- Convergência: prosseguindo, a política estabiliza em “buscar com bateria alta, recarregar com bateria baixa”. Para essa política, as equações de Bellman são lineares: \(V(s_B) = 0{,}9\,V(s_A)\) e \(V(s_A) = 2 + 0{,}9[0{,}7\,V(s_A) + 0{,}3\,V(s_B)] = 2 + 0{,}873\,V(s_A)\). Logo, \[ V^*(s_A) = \frac{2}{0{,}127} \approx 15{,}748, \qquad V^*(s_B) = 0{,}9 \times 15{,}748 \approx 14{,}173. \]
- Verificação: esperar em \(s_A\) valeria \(1 + 0{,}9 \times 15{,}748 \approx 15{,}17 < 15{,}748\), e buscar em \(s_B\) valeria \(-2{,}8 + 0{,}9(0{,}6 \times 14{,}173 + 0{,}4 \times 15{,}748) \approx 10{,}52 < 14{,}173\). A política é, de fato, ótima.
import numpy as np

# Estados: 0 = bateria alta, 1 = bateria baixa
# P[s][a] = lista de (probabilidade, próximo estado, recompensa)
P = {
    0: {"buscar":     [(0.7, 0, 2.0), (0.3, 1, 2.0)],
        "esperar":    [(1.0, 0, 1.0)]},
    1: {"buscar":     [(0.6, 1, 2.0), (0.4, 0, -10.0)],
        "recarregar": [(1.0, 0, 0.0)]},
}
gama = 0.9

def q_valor(s, a, V):
    return sum(p * (r + gama * V[s2]) for p, s2, r in P[s][a])

V = np.zeros(2)
for k in range(1, 1001):
    V_novo = np.array([max(q_valor(s, a, V) for a in P[s]) for s in P])
    if k <= 3:
        print(f"iteração {k}: V = {V_novo.round(4)}")
    if np.max(np.abs(V_novo - V)) < 1e-10:
        break
    V = V_novo

politica = {s: max(P[s], key=lambda a: q_valor(s, a, V)) for s in P}
print("V* =", V.round(3), "| política ótima:", politica)
#> iteração 1: V = [2. 0.]
#> iteração 2: V = [3.26 1.8 ]
#> iteração 3: V = [4.5398 2.934 ]
#> V* = [15.748 14.173] | política ótima: {0: 'buscar', 1: 'recarregar'}
2.14.3 Aprendendo sem conhecer o modelo: Q-learning
A iteração de valor exige conhecer \(P\) e \(R\). No aprendizado por reforço propriamente dito, o agente não conhece o modelo e precisa aprender interagindo com o ambiente. O algoritmo Q-learning (Watkins e Dayan 1992) mantém uma estimativa \(Q(s, a)\) e, após cada transição observada \((s, a, r, s')\), faz a atualização
\[ Q(s, a) \leftarrow Q(s, a) + \alpha\Big[ \underbrace{r + \gamma \max_{a'} Q(s', a')}_{\text{alvo}} - Q(s, a) \Big], \]
em que \(\alpha \in (0, 1]\) é a taxa de aprendizado. O termo entre colchetes é o erro de diferença temporal: a diferença entre uma estimativa melhorada (a recompensa observada mais o valor estimado do próximo estado) e a estimativa atual. Sob condições adequadas — todos os pares \((s, a)\) visitados infinitas vezes e taxas \(\alpha\) decrescentes —, \(Q\) converge para a função valor-ação ótima \(Q^*\).
No problema do robô, suponha \(Q(s_B, \text{buscar}) = 1{,}0\) e \(\max_{a'} Q(s_A, a') = 5{,}0\). O robô busca com bateria baixa, a bateria acaba (\(r = -10\)) e ele volta a \(s_A\). Com \(\alpha = 0{,}1\) e \(\gamma = 0{,}9\): \[ \text{alvo} = -10 + 0{,}9 \times 5 = -5{,}5, \qquad Q(s_B, \text{buscar}) \leftarrow 1{,}0 + 0{,}1(-5{,}5 - 1{,}0) = 0{,}35. \] A experiência ruim reduziu o valor estimado de buscar com bateria baixa, tornando essa ação menos atraente no futuro.
Um dilema central do aprendizado por reforço é o equilíbrio entre exploração (testar ações pouco conhecidas, que podem ser melhores) e aproveitamento (exploitation: escolher a ação que parece melhor até agora). A estratégia mais simples é a \(\varepsilon\)-gulosa: com probabilidade \(\varepsilon\), escolhe-se uma ação ao acaso; caso contrário, a de maior \(Q(s, a)\). Quando o número de estados é muito grande (como em jogos ou em robótica), a tabela \(Q\) é substituída por uma rede neural — é o aprendizado por reforço profundo.
2.15 IA Fraca (Estreita) vs. IA Forte (Geral)
De acordo com o escopo de atuação e habilidades, os sistemas de IA são comumente divididos em duas categorias conceituais:
- IA Fraca (Narrow/Weak AI): Sistemas projetados e treinados para realizar uma única tarefa específica (ou um conjunto limitado de tarefas) com extrema eficiência. Exemplos incluem filtros de spam de e-mail, assistentes de voz (Siri, Alexa), recomendadores de filmes da Netflix, ou sistemas de diagnóstico por imagem. Todos os sistemas de IA existentes hoje no mundo são classificados como IA Fraca.
- IA Forte (General/Strong AI - AGI): Refere-se a um sistema de inteligência artificial geral que possui todas as capacidades cognitivas de um ser humano, incluindo autoconsciência, capacidade de planejar, adaptar-se a novos contextos complexos de forma autônoma e aprender qualquer tarefa intelectual que um humano pode realizar. A AGI ainda é um conceito teórico e um dos grandes temas de debate científico no mundo.
Os grandes modelos de linguagem tornaram essa fronteira menos nítida: um mesmo modelo consegue redigir textos, traduzir, resumir, escrever código e resolver exercícios, o que é muito mais amplo do que uma tarefa única. Ainda assim, não há consenso científico de que esses sistemas possuam as capacidades associadas à IA geral — como compreensão robusta do mundo físico, aprendizado contínuo a partir de poucas experiências e planejamento confiável de longo prazo —, e a própria definição de AGI permanece em debate.
2.16 Ética, Viés e Explicabilidade em IA
À medida que sistemas de IA passam a apoiar ou tomar decisões sobre pessoas — concessão de crédito, triagem de currículos, diagnósticos médicos, policiamento —, três preocupações tornam-se centrais.
2.16.1 Viés e justiça algorítmica
Um modelo aprendido a partir de dados históricos reproduz, e pode amplificar, as desigualdades presentes nesses dados (ver a seção sobre viés no Capítulo de Conceitos de Ciência de Dados). Um caso amplamente discutido foi a reportagem da organização ProPublica, em 2016, sobre o COMPAS, um sistema usado em tribunais dos Estados Unidos para estimar o risco de reincidência criminal, que apontou taxas de falsos positivos diferentes entre réus negros e brancos. O debate que se seguiu mostrou que existem diferentes definições matemáticas de justiça (fairness), e que, em geral, elas não podem ser satisfeitas simultaneamente.
Seja \(A\) um atributo protegido (por exemplo, o grupo), \(Y\) a classe verdadeira e \(\hat{Y}\) a decisão do modelo. Duas definições comuns são:
- Paridade demográfica: \(P(\hat{Y} = 1 \mid A = a) = P(\hat{Y} = 1 \mid A = b)\) — a taxa de decisões positivas é igual entre os grupos.
- Igualdade de oportunidades: \(P(\hat{Y} = 1 \mid Y = 1, A = a) = P(\hat{Y} = 1 \mid Y = 1, A = b)\) — a taxa de verdadeiros positivos (sensibilidade) é igual entre os grupos.
Um modelo aprovou crédito para dois grupos de 100 clientes cada. “Bom pagador” indica \(Y = 1\).
| Grupo | Bons pagadores | Bons aprovados | Maus pagadores | Maus aprovados |
|---|---|---|---|---|
| A | 50 | 40 | 50 | 10 |
| B | 20 | 10 | 80 | 5 |
- Taxa de aprovação: grupo A: \((40 + 10)/100 = 0{,}50\); grupo B: \((10 + 5)/100 = 0{,}15\). Diferença de paridade demográfica: \(0{,}35\).
- Taxa de verdadeiros positivos: grupo A: \(40/50 = 0{,}80\); grupo B: \(10/20 = 0{,}50\).
- Taxa de falsos positivos: grupo A: \(10/50 = 0{,}20\); grupo B: \(5/80 = 0{,}0625\).
Parte da diferença nas aprovações decorre da diferença nas proporções de bons pagadores (50% vs. 20%), mas a diferença de sensibilidade mostra que, entre os bons pagadores, os do grupo B têm chance muito menor de aprovação: o modelo viola a igualdade de oportunidades. Note que exigir paridade demográfica aqui obrigaria o modelo a aprovar mais maus pagadores do grupo B ou menos bons pagadores do grupo A, ilustrando o conflito entre critérios.
2.16.2 Explicabilidade
Muitos modelos de alto desempenho (florestas aleatórias, boosting, redes profundas) são “caixas-pretas”: é difícil explicar por que produziram uma determinada previsão. A explicabilidade (explainability) é importante para detectar erros e vieses, para gerar confiança e, em muitos contextos, por exigência legal. Distinguem-se duas estratégias:
- Modelos interpretáveis por construção: regressão linear e logística, árvores de decisão rasas, sistemas de regras. Seus parâmetros têm leitura direta (por exemplo, a razão de chances \(e^{\beta_j}\) na regressão logística).
- Explicações post hoc: técnicas aplicadas a um modelo já treinado, como a importância de variáveis por permutação (vista no Capítulo de Florestas Aleatórias), o LIME, que aproxima o modelo localmente por um modelo linear simples (Ribeiro, Singh, e Guestrin 2016), e os valores SHAP, baseados no valor de Shapley da teoria dos jogos cooperativos (Lundberg e Lee 2017).
2.16.3 Regulação
A preocupação com os impactos da IA levou a iniciativas regulatórias em vários países:
- LGPD (Brasil): a Lei n.º 13.709/2018, discutida no Capítulo de Conceitos de Ciência de Dados, assegura ao titular o direito de solicitar a revisão de decisões tomadas unicamente com base em tratamento automatizado de dados pessoais que afetem seus interesses (art. 20), bem como de obter informações sobre os critérios e procedimentos utilizados, observados os segredos comercial e industrial.
- União Europeia: o Regulamento (UE) 2024/1689, conhecido como AI Act, adota uma abordagem baseada em risco: práticas consideradas de risco inaceitável (como certos sistemas de pontuação social) são proibidas; sistemas de alto risco (por exemplo, em educação, emprego, crédito e serviços públicos essenciais) devem cumprir requisitos de gestão de riscos, qualidade de dados, documentação, transparência e supervisão humana; e sistemas de risco limitado têm obrigações de transparência, como informar ao usuário que ele está interagindo com uma IA. Suas obrigações entram em vigor de forma escalonada ao longo de vários anos.
- Brasil — marco legal da IA: tramita no Congresso Nacional o Projeto de Lei n.º 2.338/2023, aprovado pelo Senado Federal em dezembro de 2024, que também propõe uma abordagem baseada em riscos. Como o texto pode ser alterado durante a tramitação, recomenda-se ao leitor consultar sua situação atualizada.
Regulação é um tema em rápida evolução. Para decisões práticas, consulte sempre o texto legal vigente e fontes oficiais, e não resumos (inclusive este).
2.17 Desafios na Implementação de IA
Embora o avanço tecnológico seja inegável, a implantação de soluções reais de Inteligência Artificial no mundo corporativo e industrial enfrenta grandes desafios práticos:
- Escassez de Talentos: Profissionais qualificados que entendam profundamente a matemática, estatística e engenharia de software necessárias para IA são raros e disputados globalmente.
- Dados de Qualidade: Os algoritmos de aprendizado de máquina exigem volumes massivos de dados limpos, rotulados e representativos para serem treinados. Dados com ruídos ou enviesados levam a previsões incorretas.
- Resistência Cultural: O medo da substituição de postos de trabalho e a desconfiança em relação às decisões tomadas por modelos automatizados geram barreiras à adoção dentro das empresas.
- Infraestrutura Computacional: O treinamento de redes neurais modernas exige recursos computacionais avançados de alto custo (GPUs, TPUs).
- Integração com Sistemas Legados: Conectar modelos preditivos modernos a sistemas antigos e defasados das corporações exige esforço significativo de engenharia de software.
- Conformidade, Ética e Confiança: É preciso garantir que os sistemas cumpram a legislação de proteção de dados e de IA, que sejam auditáveis quanto a vieses e que suas decisões possam ser explicadas a usuários e reguladores.
- Manutenção em Produção: Modelos degradam quando a distribuição dos dados muda ao longo do tempo (data drift), exigindo monitoramento contínuo e retreinamento.
2.18 Resumo do Capítulo
- A inteligência é um conceito multifacetado; as definições de IA podem ser organizadas em quatro abordagens (pensar/agir, como humanos/racionalmente), sendo a do agente racional a predominante hoje.
- Turing propôs, em 1950, o Jogo da Imitação como critério comportamental de inteligência. O teste foi criticado por confundir comportamento com compreensão (ELIZA) e, filosoficamente, pelo argumento do Quarto Chinês de Searle.
- A IA nasceu oficialmente em Dartmouth (1956) e atravessou ciclos de otimismo e invernos, passando pelos sistemas especialistas, pelo retorno conexionista com a retropropagação, pela virada estatística, pelo deep learning e pelos transformers e LLMs.
- As abordagens simbólica, conexionista e estatística têm forças e limitações complementares.
- Um agente percebe e age no ambiente; um agente racional maximiza a utilidade esperada. Tarefas são especificadas por PEAS, e ambientes se classificam por observabilidade, determinismo, episodicidade etc.
- Problemas de busca são definidos por estados, ações, modelo de transição, teste de objetivo e custos. A busca em largura e a de custo uniforme são completas, mas sofrem com a explosão combinatória; o A* com heurística admissível é ótimo e expande menos nós quanto mais informativa for a heurística.
- Na lógica proposicional, \(\text{KB} \models \alpha\) se \(\alpha\) é verdadeira em todos os modelos da base; o encadeamento para a frente é correto, completo e eficiente para cláusulas de Horn. A lógica clássica, porém, não lida bem com incerteza e exceções.
- Redes bayesianas representam distribuições conjuntas de forma compacta pela fatoração \(\prod_i P(X_i \mid \operatorname{Pa}(X_i))\), explorando independências condicionais; a inferência atualiza crenças pelo teorema de Bayes.
- O perceptron é um classificador linear \(\hat{y} = \mathbf{1}(\mathbf{w}^\top \mathbf{x} + b > 0)\) treinado pela regra \(\mathbf{w} \leftarrow \mathbf{w} + \eta(y - \hat{y})\mathbf{x}\); converge se os dados forem linearmente separáveis, mas não representa o XOR.
- A teoria PAC fornece garantias de generalização: para classes finitas, \(m \geq \varepsilon^{-1}(\ln|\mathcal{H}| + \ln \delta^{-1})\) exemplos bastam no caso realizável. Para classes infinitas, o papel de \(\ln|\mathcal{H}|\) é desempenhado pela dimensão VC, que vale \(p + 1\) para hiperplanos em \(\mathbb{R}^p\). Pelo teorema no free lunch, todo aprendizado depende de viés indutivo.
- Redes multicamadas com ativações não lineares são aproximadores universais, treinadas por gradiente descendente com retropropagação; redes profundas aprendem representações hierárquicas. O gradiente descendente reduz a perda se \(\eta < 2/\beta\); derivadas pequenas das ativações causam o desaparecimento do gradiente, e a não convexidade pode levar a mínimos locais.
- Modelos generativos estimam a distribuição dos dados; LLMs são modelos autorregressivos de próximo token baseados em transformers e atenção, cuja diversidade de geração é controlada pela temperatura da softmax. Eles podem alucinar e reproduzir vieses.
- Modelos de linguagem são avaliados pela entropia cruzada e pela perplexidade; o texto é dividido em subpalavras por algoritmos como o BPE, e os tokens são representados por embeddings, comparados pela similaridade do cosseno.
- O aprendizado por reforço modela problemas sequenciais como processos de decisão de Markov; a função valor ótima satisfaz a equação de Bellman, resolvida pela iteração de valor (uma contração), e o Q-learning aprende sem conhecer o modelo do ambiente.
- Sistemas de IA exigem atenção a viés e justiça (com definições formais conflitantes), explicabilidade e regulação (LGPD, AI Act europeu, PL 2.338/2023).
2.19 Exercícios Propostos
- Classifique cada um dos sistemas a seguir em uma das quatro abordagens de Russell e Norvig (2021) e justifique: (a) um provador automático de teoremas; (b) um chatbot projetado para passar no Teste de Turing; (c) um carro autônomo; (d) um modelo computacional da memória humana usado em psicologia.
- Explique o argumento do Quarto Chinês e a “resposta do sistema”. Em sua opinião, o argumento se aplica aos grandes modelos de linguagem atuais? Argumente.
- Em um experimento, juízes acertaram a identidade (humano ou máquina) em 230 de 400 conversas. Teste, ao nível de 5%, a hipótese de que os juízes não conseguem distinguir a máquina do humano (\(H_0: p = 0{,}5\)).
- Descreva os principais fatores que levaram aos dois “invernos da IA” e os fatores que explicam o sucesso do deep learning após 2012.
- Especifique o ambiente de tarefa (PEAS) e classifique o ambiente segundo as seis propriedades estudadas para: (a) um sistema de detecção de fraudes em cartões de crédito; (b) um agente que joga pôquer.
- No exemplo da manutenção preditiva, refaça a análise supondo que a falha custe 100 mil reais (utilidade \(-100\)). A partir de qual probabilidade de falha a máquina deve ser parada?
- Treine à mão um perceptron para a função OU lógico, com \(\mathbf{w} = (0,0)\), \(b = 0\), \(\eta = 1\), apresentando os exemplos na ordem \((0,0), (0,1), (1,0), (1,1)\). Mostre todas as atualizações até a convergência e desenhe a fronteira de decisão.
- Mostre que o XOR pode ser representado por uma rede com uma camada oculta de dois neurônios com função degrau. Especifique explicitamente os pesos e vieses.
- Usando o código Python ou R do capítulo, treine o perceptron para a função XOR e registre o número de erros em cada uma de 20 épocas. Explique o comportamento observado à luz do teorema de convergência.
- Para a rede do exemplo de propagação para a frente, calcule a saída para \(\mathbf{x} = (2, 0)^\top\) e para \(\mathbf{x} = (0, 0)^\top\).
- Mostre que \(\sigma'(z) = \sigma(z)(1 - \sigma(z))\) e, a partir disso, derive que \(\partial \ell / \partial b = \hat{y} - y\) para um neurônio sigmoide com perda de entropia cruzada.
- Com os logits \(z = (3, 1, 0, -1)\), calcule as probabilidades da softmax para \(\tau = 1\) e \(\tau = 0{,}5\). Mostre algebricamente que somar uma constante \(c\) a todos os logits não altera as probabilidades.
- Construa um modelo de bigramas a partir de um pequeno corpus de cinco frases de sua escolha (pode ser em Python ou R) e use-o para gerar três frases novas por amostragem. Discuta o problema das probabilidades nulas.
- Na auditoria do modelo de crédito, calcule a taxa de falsos negativos de cada grupo. Proponha uma alteração nos números de aprovados do grupo B que satisfaça a igualdade de oportunidades, e verifique se a paridade demográfica passa a ser satisfeita.
- Pesquise e resuma, em uma página, as categorias de risco do AI Act europeu e o direito de revisão de decisões automatizadas da LGPD, citando os textos legais consultados.
- Formule como problema de busca (estados, estado inicial, ações, modelo de transição, teste de objetivo e custo) o quebra-cabeça de 8 peças (tabuleiro \(3 \times 3\) com uma posição vazia). Mostre que o número de peças fora do lugar é uma heurística admissível.
- No grafo do exemplo do A*, execute à mão a busca em largura e a busca em profundidade (expandindo os vizinhos em ordem alfabética) de \(S\) até \(G\). Os caminhos encontrados são ótimos? Quantos nós cada uma expande?
- Mostre que toda heurística consistente é admissível. (Sugestão: use indução sobre o número de passos do caminho ótimo de \(n\) até o objetivo.) Dê um exemplo de heurística admissível, mas não consistente, para o grafo do exemplo.
- Altere a heurística do exemplo para \(h(E) = 14\), mantendo os demais valores. A heurística continua admissível? O que pode acontecer com a solução do A*? Verifique com o código do capítulo.
- Construa a tabela-verdade e verifique se \(\{P \Rightarrow Q,\ Q \Rightarrow R\} \models P \Rightarrow R\). Em seguida, verifique se \(\{P \Rightarrow Q,\ Q\} \models P\) e explique a diferença entre dedução e abdução.
- Acrescente à base de conhecimento do código de encadeamento para a frente as regras “Irrigacao e Verao => ContaAlta” e o fato “Verao”. Quais novos fatos são derivados se o fato “Chuva” for substituído por “Irrigacao”?
- Na rede do alarme, calcule por enumeração \(P(B \mid j, \neg m)\) (João telefona e Maria não). Compare com \(P(B \mid j, m) \approx 0{,}284\) e interprete. Quantos parâmetros teria a distribuição conjunta de 10 variáveis binárias? E uma rede bayesiana em que cada uma tem no máximo 2 pais?
- Escreva a fatoração de uma rede bayesiana Naive Bayes com classe \(Y\) e três atributos binários, e conte seus parâmetros. Mostre que \(P(Y \mid x_1, x_2, x_3) \propto P(Y)\prod_j P(x_j \mid Y)\).
- Usando o teorema PAC para classes finitas, calcule a complexidade amostral, nos casos realizável e agnóstico, para \(|\mathcal{H}| = 2^{20}\), \(\varepsilon = 0{,}1\) e \(\delta = 0{,}05\). Como o resultado muda se \(\varepsilon\) for reduzido à metade?
- Mostre que a classe dos intervalos \(h_{a,b}(x) = \mathbf{1}\{a \leq x \leq b\}\) na reta tem dimensão VC igual a 2. E a classe dos limiares \(h_c(x) = \mathbf{1}\{x \geq c\}\)?
- Para \(L(w) = 2(w + 1)^2\), determine a constante de suavidade \(\beta\), o intervalo de taxas de aprendizado que garante a diminuição da perda e a taxa que leva ao mínimo em um passo. Simule 10 passos com \(w_0 = 2\) para \(\eta = 0{,}1\), \(0{,}25\) e \(0{,}6\).
- Refaça o exemplo resolvido de retropropagação supondo \(y = 0\). Calcule todos os gradientes e a nova saída após um passo com \(\eta = 0{,}5\). Confira com diferenças finitas em Python.
- Altere o código da rede para o XOR, trocando \(\tanh\) por ReLU na camada oculta (lembre-se de trocar também a derivada). Teste cinco sementes diferentes e relate em quantas a rede resolve o problema.
- Aplique mais três fusões do BPE ao vocabulário final do exemplo resolvido. Em seguida, construa um pequeno corpus em português com 20 palavras e aplique 10 fusões com o código do capítulo.
- No problema do robô de coleta, refaça a iteração de valor com \(\gamma = 0{,}5\). A política ótima muda? Explique o papel do fator de desconto. Em seguida, implemente o Q-learning com política \(\varepsilon\)-gulosa (\(\varepsilon = 0{,}1\), \(\alpha = 0{,}1\)), simulando o ambiente a partir das probabilidades dadas, e compare a tabela \(Q\) obtida após 50.000 passos com os valores exatos.
2.20 Leituras Recomendadas
- Russell e Norvig (2021) — o livro-texto de referência em Inteligência Artificial, com tratamento abrangente de agentes, busca, raciocínio, incerteza e aprendizado.
- Turing (1950) — o artigo fundador do Teste de Turing, ainda muito legível e atual.
- Searle (1980) — o argumento do Quarto Chinês, acompanhado no original de comentários de diversos pesquisadores.
- McCarthy et al. (2006) — a proposta original do projeto de Dartmouth.
- Rosenblatt (1958) e Minsky e Papert (1969) — o perceptron e sua crítica.
- Goodfellow, Bengio, e Courville (2016) — livro-texto de referência em aprendizado profundo; LeCun, Bengio, e Hinton (2015) oferece uma visão geral concisa.
- Vaswani et al. (2017) — o artigo que introduziu a arquitetura Transformer.
- Jordan (2019) — reflexão crítica sobre o uso do termo “Inteligência Artificial” e a necessidade de uma engenharia de sistemas baseados em dados.
- Morettin e Singer (2021) — introdução em português ao aprendizado estatístico, com discussão sobre a relação entre IA, aprendizado de máquina e Estatística.
- Hart, Nilsson, e Raphael (1968) — o artigo original do algoritmo A*, com a demonstração de sua otimalidade.
- Pearl (1988) — obra fundadora das redes bayesianas e do raciocínio probabilístico em IA.
- Valiant (1984) e Shalev-Shwartz e Ben-David (2014) — o modelo PAC e um livro-texto moderno e rigoroso sobre teoria do aprendizado, incluindo a dimensão VC.
- Vapnik (1995) — a teoria estatística do aprendizado na visão de um de seus criadores.
- Mikolov et al. (2013) e Sennrich, Haddow, e Birch (2016) — os embeddings do word2vec e a tokenização por subpalavras com BPE.
- Sutton e Barto (2018) — o livro-texto de referência em aprendizado por reforço, disponível gratuitamente pelos autores.