11 Classificação com Árvores de Decisão
Antes de abordarmos algoritmos específicos, é importante definirmos formalmente o problema de Classificação no aprendizado de máquina.
Seja \(\mathbf{X}\) uma matriz de dados de treinamento com \(n\) observações (linhas) e \(p\) variáveis ou features (colunas), e \(\mathbf{y}\) um vetor de \(n\) observações do tipo qualitativas (as classes ou labels): \[ \mathbf{X} = \begin{bmatrix} x_{11} & \cdots & x_{1p} \\ \vdots & \ddots & \vdots \\ x_{n1} & \cdots & x_{np} \end{bmatrix} \quad \text{e} \quad \mathbf{y} = \begin{bmatrix} y_1 \\ \vdots \\ y_n \end{bmatrix} \]
Considerando um problema com \(c\) classes, temos o par \((\mathbf{x}, y)\) em que \(\mathbf{x} \in \mathbb{R}^p\) e \(y \in \{1, \ldots, c\}\). O objetivo de um classificador é encontrar uma função matemática \(f : \mathbb{R}^p \rightarrow \{1, \ldots, c\}\) que minimize a função de risco ou erro geral, dada pela probabilidade de predições incorretas: \(L(f) = P \{Y \neq f(\mathbf{X})\}\).
Como a distribuição conjunta de \((\mathbf{X}, Y)\) é desconhecida, na prática trabalhamos com o risco empírico (empirical risk), isto é, a proporção de erros na amostra de treinamento, \[ \widehat{L}(f) = \frac{1}{n} \sum_{i=1}^{n} \mathbb{I}\{y_i \neq f(\mathbf{x}_i)\}, \] em que \(\mathbb{I}\{\cdot\}\) é a função indicadora. Conforme discutido no Capítulo de Introdução ao Aprendizado de Máquina, minimizar apenas o risco empírico conduz ao sobreajuste; por isso, todo método de classificação combina um critério de ajuste aos dados com algum mecanismo de controle da complexidade.
As Árvores de Decisão são uma das formas mais intuitivas e interpretáveis de construir essa função \(f\) para tarefas de classificação. Neste capítulo estudaremos sua formalização como partição recursiva do espaço de atributos, os algoritmos históricos (ID3, C4.5 e CART), os critérios de divisão (entropia, ganho de informação, razão de ganho, índice de Gini e erro de classificação) e seus fundamentos em teoria da informação, as propriedades teóricas das medidas de impureza, um exemplo numérico completo resolvido à mão, o tratamento de variáveis contínuas, categóricas e ausentes, o custo computacional do algoritmo, critérios de parada, a poda por custo-complexidade (com um exemplo completo da sequência de podas), custos de classificação desiguais, a importância de variáveis, extensões como as árvores de inferência condicional e as árvores oblíquas e, por fim, implementações em R e Python. As árvores de regressão, em que a resposta é quantitativa, serão tratadas no Capítulo de Modelos de Regressão com Árvores e Florestas.
11.1 Intuição e Estrutura das Árvores de Decisão
As Árvores de Decisão são modelos de aprendizado supervisionado extremamente populares pela sua simplicidade e forte interpretabilidade. A estrutura lógica assemelha-se a um fluxograma de tomadas de decisões sequenciais, onde o algoritmo divide recursivamente os dados em subconjuntos com base nas perguntas feitas aos atributos.
Uma árvore é composta por três tipos básicos de nós:
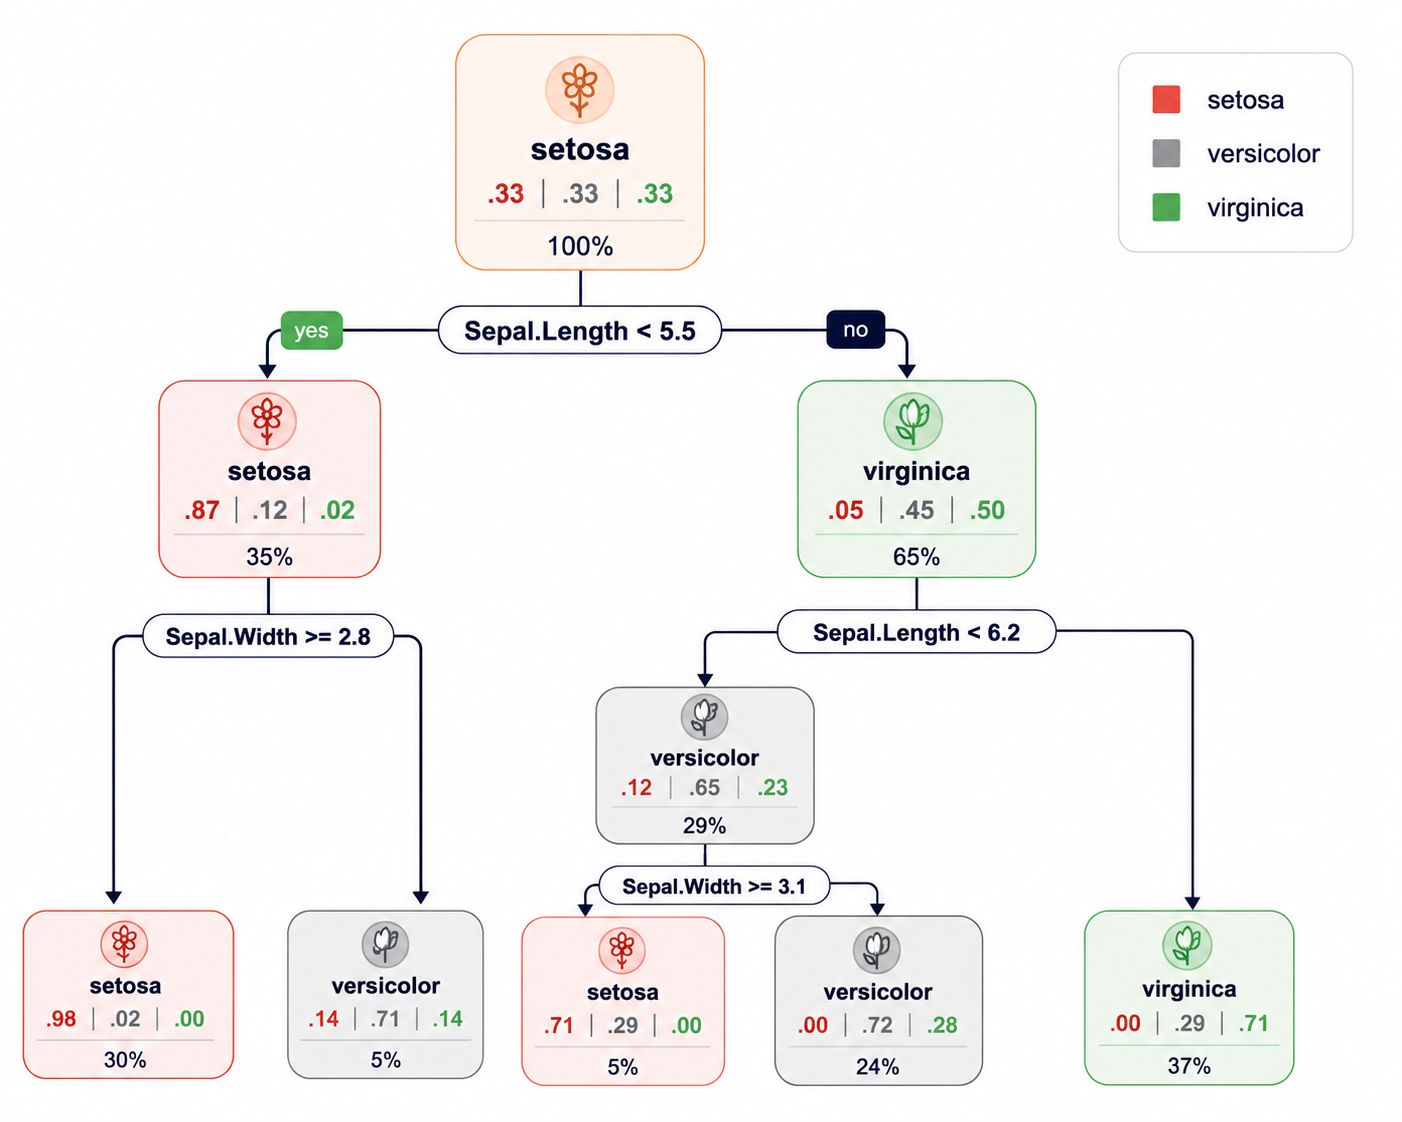
- Nó Raiz: Fica no topo da árvore e inicia a divisão dos dados com base no atributo mais discriminativo do projeto.
- Nós Internos: Representam nós intermediários de tomada de decisão baseada em atributos específicos.
- Nós Folhas: Nós terminais que não sofrem mais divisões. Eles carregam a resposta ou a classe final predita pelo modelo.
Os nós são ligados por ramos (branches), que correspondem às respostas possíveis de cada pergunta. A profundidade (depth) de um nó é o número de ramos entre ele e a raiz; a profundidade da árvore é a maior profundidade entre suas folhas. Cada caminho da raiz até uma folha pode ser lido como uma regra lógica do tipo “SE \(x_3 \leq 2{,}45\) E \(x_4 > 1{,}75\) ENTÃO classe = virginica”. Essa equivalência entre árvores e conjuntos de regras é a principal fonte de sua interpretabilidade.
Uma das grandes vantagens da Árvore de Decisão é a sua capacidade de lidar nativamente tanto com variáveis categóricas quanto numéricas sem exigir grandes transformações. Além disso, por usarem apenas comparações do tipo “menor ou igual a um limiar”, as árvores são invariantes a transformações monótonas das variáveis preditoras: aplicar logaritmo, padronizar ou elevar ao quadrado uma variável positiva não altera a ordem das observações e, portanto, não altera a árvore obtida. Por isso, ao contrário do k-NN (Capítulo de k-Vizinhos Mais Próximos) e do SVM, as árvores dispensam normalização.
11.2 Formalização: Partição Recursiva do Espaço de Atributos
Do ponto de vista matemático, uma árvore de decisão com \(M\) folhas particiona o espaço de atributos \(\mathcal{X} \subseteq \mathbb{R}^p\) em \(M\) regiões disjuntas \(R_1, R_2, \ldots, R_M\), com \(\bigcup_{m=1}^{M} R_m = \mathcal{X}\) e \(R_m \cap R_{m'} = \emptyset\) para \(m \neq m'\). Nas árvores binárias com divisões univariadas (o caso mais comum), cada região é um hiper-retângulo com faces paralelas aos eixos, pois resulta da interseção de condições do tipo \(x_j \leq s\) ou \(x_j > s\).
Para uma observação na região \(R_m\), que contém \(n_m\) observações de treinamento, definimos a proporção de observações da classe \(k\) no nó \(m\) como \[ \hat{p}_{mk} = \frac{1}{n_m} \sum_{\mathbf{x}_i \in R_m} \mathbb{I}\{y_i = k\}, \qquad k = 1, \ldots, c. \]
O classificador associado à árvore atribui a cada região a classe majoritária: \[ f(\mathbf{x}) = \sum_{m=1}^{M} k(m) \, \mathbb{I}\{\mathbf{x} \in R_m\}, \qquad k(m) = \arg\max_{k} \hat{p}_{mk}. \]
As proporções \(\hat{p}_{mk}\) também fornecem uma estimativa da probabilidade condicional \(P(Y = k \mid \mathbf{X} = \mathbf{x})\) para \(\mathbf{x} \in R_m\), o que permite usar árvores para gerar escores e curvas ROC.
Idealmente, buscaríamos a partição \(R_1, \ldots, R_M\) que minimiza o erro de classificação entre todas as árvores possíveis. Contudo, Hyafil e Rivest (1976) mostraram que construir a árvore binária ótima é um problema NP-completo. Por isso, todos os algoritmos práticos adotam uma estratégia gulosa (greedy) e de cima para baixo (top-down), conhecida como partição recursiva binária (recursive binary splitting): a cada passo escolhe-se a melhor divisão local do nó corrente, sem olhar para as divisões futuras.
Formalmente, considere um nó \(t\) com conjunto de dados \(S_t\). Para uma variável \(j\) e um ponto de corte \(s\), definimos os dois nós filhos \[ S_{L}(j, s) = \{(\mathbf{x}_i, y_i) \in S_t : x_{ij} \leq s\}, \qquad S_{R}(j, s) = \{(\mathbf{x}_i, y_i) \in S_t : x_{ij} > s\}. \] Dada uma medida de impureza \(Q(\cdot)\) (definida na próxima seção), a melhor divisão é aquela que maximiza o decréscimo de impureza \[ \Delta Q(j, s) = Q(S_t) - \left[ \frac{|S_L|}{|S_t|} Q(S_L) + \frac{|S_R|}{|S_t|} Q(S_R) \right], \] ou seja, \((j^*, s^*) = \arg\max_{j, s} \Delta Q(j, s)\). O procedimento é então aplicado recursivamente a \(S_L\) e \(S_R\) até que um critério de parada seja satisfeito. Note que, como \(Q(S_t)\) é constante para o nó, maximizar \(\Delta Q\) equivale a minimizar a impureza média ponderada dos filhos.
O algoritmo geral pode ser descrito como:
- Comece com todas as observações de treinamento no nó raiz.
- Se o nó satisfaz algum critério de parada (é puro, tem poucas observações, atingiu a profundidade máxima etc.), declare-o folha e atribua a classe majoritária.
- Caso contrário, para cada variável \(j = 1, \ldots, p\) e cada ponto de corte candidato \(s\), calcule \(\Delta Q(j, s)\).
- Escolha \((j^*, s^*)\) com maior decréscimo de impureza e divida o nó em dois filhos.
- Repita os passos 2–4 para cada filho.
11.3 Algoritmos Históricos: ID3, C4.5 e CART
A ideia de dividir recursivamente os dados remonta aos trabalhos de Automatic Interaction Detection (AID) nos anos 1960, mas três algoritmos consolidaram as árvores de decisão como ferramenta central do aprendizado de máquina:
| Algoritmo | Autor(es) | Critério de divisão | Tipo de divisão | Variáveis contínuas | Poda |
|---|---|---|---|---|---|
| ID3 | Quinlan (1986) | Ganho de informação (entropia) | Multivias (um ramo por categoria) | Não (apenas categóricas) | Não |
| C4.5 | Quinlan (1993) | Razão de ganho | Multivias para categóricas, binária para contínuas | Sim | Pós-poda baseada em erro pessimista |
| CART | Breiman, Friedman, Olshen e Stone (1984) | Índice de Gini (classificação) / soma de quadrados (regressão) | Sempre binária | Sim | Poda por custo-complexidade com validação cruzada |
- ID3 (Iterative Dichotomiser 3), proposto por Quinlan (1986), introduziu o uso da entropia de Shannon e do ganho de informação para escolher atributos. Trabalha apenas com atributos categóricos e cria um ramo para cada categoria.
- C4.5 (Quinlan 1993) é o sucessor do ID3: corrige o viés do ganho de informação a favor de atributos com muitos valores usando a razão de ganho, trata variáveis contínuas e valores ausentes, e inclui um procedimento de pós-poda. Seu sucessor comercial é o C5.0.
- CART (Classification and Regression Trees), sistematizado por Breiman et al. (1984), produz sempre árvores binárias, usa o índice de Gini para classificação e introduziu a poda por custo-complexidade, além das divisões substitutas (surrogate splits) para lidar com valores ausentes. É o algoritmo implementado no pacote
rpartdo R e, essencialmente, noscikit-learndo Python.
Existem outras variantes importantes, como o CHAID (Kass 1980), que utiliza testes qui-quadrado para escolher as divisões, e as árvores de inferência condicional (Hothorn, Hornik, e Zeileis 2006), que discutiremos na seção de extensões ao final do capítulo.
11.3.1 Uma breve linha do tempo
A história das árvores de decisão é curiosa porque se desenvolveu em paralelo em duas comunidades — a Estatística e a Inteligência Artificial — que só mais tarde perceberam que trabalhavam no mesmo problema:
- 1963 — AID. Morgan e Sonquist (1963), no Instituto de Pesquisas Sociais da Universidade de Michigan, propuseram o Automatic Interaction Detection para analisar dados de surveys: o programa dividia a amostra sucessivamente em dois grupos de modo a maximizar a soma de quadrados entre grupos de uma resposta quantitativa. É, essencialmente, uma árvore de regressão sem poda.
- 1966 — CLS. Na psicologia cognitiva, Hunt, Marin e Stone descreveram o Concept Learning System, um procedimento de “dividir para conquistar” para aprender conceitos lógicos, que inspiraria diretamente o ID3.
- 1972–1980 — THAID e CHAID. Versões do AID para respostas categóricas; o CHAID (Kass 1980) introduziu testes de significância (qui-quadrado com correção de Bonferroni) como critério de divisão e de parada.
- 1984 — CART. Breiman et al. (1984) deram ao tema um tratamento estatístico rigoroso: divisões binárias, poda por custo-complexidade, validação cruzada, divisões substitutas e resultados de consistência.
- 1986–1993 — ID3 e C4.5. Na comunidade de aprendizado de máquina, Quinlan desenvolveu o ID3 e o C4.5, que se tornaram o algoritmo de referência da área ao longo dos anos 1990.
- 2001 em diante. As árvores tornam-se principalmente blocos de construção de métodos de conjunto — bagging, Floresta Aleatória e boosting — tema do próximo capítulo.
Uma crítica importante aos primeiros métodos (AID em particular) foi a de que eles “encontravam estrutura” mesmo em dados puramente aleatórios, pois a busca exaustiva por cortes produz decréscimos de impureza positivos por puro acaso. Essa observação motivou tanto a poda com validação cruzada do CART quanto as abordagens baseadas em testes de hipóteses, como o CHAID e as árvores de inferência condicional.
11.4 Como a Árvore Decide Onde Dividir? Medidas de Impureza
Durante o treinamento, a árvore precisa decidir de forma inteligente qual atributo e qual valor de corte usar para realizar a divisão mais limpa dos dados. O objetivo é que os nós gerados após a divisão sejam o mais puros (homogêneos) possíveis. Para quantificar a pureza dos nós, utilizamos medidas de impureza (impurity). Os dois critérios matemáticos principais são a Entropia e o Índice de Gini; um terceiro, o erro de classificação, é usado sobretudo na poda.
Uma função de impureza \(Q(\hat{p}_1, \ldots, \hat{p}_c)\) deve satisfazer, idealmente, as seguintes propriedades (Breiman et al. 1984):
- Atinge seu máximo quando todas as classes são igualmente prováveis, \(\hat{p}_k = 1/c\).
- Atinge seu mínimo (zero) quando o nó é puro, isto é, \(\hat{p}_k = 1\) para alguma classe \(k\).
- É simétrica em relação às proporções (não depende da ordem das classes).
- É estritamente côncava, o que garante que qualquer divisão não trivial produza decréscimo de impureza \(\Delta Q \geq 0\).
11.4.1 Entropia (Ganho de Informação)
A Entropia é uma medida física e matemática de desordem ou incerteza contida em um conjunto de dados, introduzida na teoria da informação por Shannon (1948). Para um problema de classificação binária (classes + e -), a entropia de um nó \(S\) é dada pela fórmula: \[H(S) = -p_{+} \log_2(p_{+}) - p_{-} \log_2(p_{-})\] Onde \(p_{+}\) é a proporção de amostras positivas no nó e \(p_{-}\) é a proporção de negativas.
- Se o nó for perfeitamente homogêneo (todas as amostras pertencem a uma mesma classe), a entropia é 0 (incerteza nula).
- Se o nó estiver perfeitamente equilibrado (50% de cada classe), a entropia atinge o seu valor máximo de 1.
Para \(c\) classes, a definição geral é \[ H(S) = -\sum_{k=1}^{c} p_k \log_2 p_k, \] com a convenção \(0 \log_2 0 = 0\) (justificada por \(\lim_{p \to 0^+} p \log_2 p = 0\)). O valor máximo, atingido quando \(p_k = 1/c\) para todo \(k\), é \(\log_2 c\). A entropia mede, em bits, a quantidade média de informação necessária para identificar a classe de uma observação sorteada ao acaso do nó.
Seja \(h(p) = -p \log_2 p - (1-p) \log_2 (1-p)\). Derivando, \[ h'(p) = -\log_2 p + \log_2 (1-p) = \log_2\left(\frac{1-p}{p}\right), \] que se anula em \(p = 1/2\). Como \(h''(p) = -\frac{1}{\ln 2}\left(\frac{1}{p} + \frac{1}{1-p}\right) < 0\), a função é estritamente côncava e \(p = 1/2\) é o ponto de máximo, com \(h(1/2) = 1\) bit.
A árvore calcula o Ganho de Informação (\(GI\)) de cada atributo, que mede a redução da entropia geral após a divisão. O atributo com maior Ganho de Informação é selecionado para o nó: \[GI(S, A) = H(S) - \sum_{v \in Val(A)} \frac{|S_v|}{|S|} H(S_v)\] em que \(Val(A)\) é o conjunto de valores possíveis do atributo \(A\) e \(S_v\) é o subconjunto de \(S\) em que \(A = v\). O segundo termo é a entropia condicional \(H(S \mid A)\); logo, o ganho de informação coincide com a informação mútua entre o atributo e a classe, \(GI(S, A) = H(Y) - H(Y \mid A)\), que é sempre não negativa.
11.4.2 Razão de Ganho
O ganho de informação tem um viés conhecido: ele favorece atributos com muitos valores distintos. No caso extremo de um identificador único (por exemplo, o CPF de um cliente), cada subconjunto \(S_v\) teria uma única observação, com entropia zero, e o ganho seria máximo, \(GI = H(S)\), embora o atributo seja inútil para generalizar. Para corrigir isso, Quinlan (1993) propôs normalizar o ganho pela informação da divisão (split information), que é a entropia da própria partição induzida pelo atributo: \[ SI(S, A) = -\sum_{v \in Val(A)} \frac{|S_v|}{|S|} \log_2 \frac{|S_v|}{|S|}, \qquad RG(S, A) = \frac{GI(S, A)}{SI(S, A)}. \] Atributos que fragmentam os dados em muitos subconjuntos pequenos têm \(SI\) grande e, portanto, razão de ganho penalizada.
11.4.3 Índice de Gini
O Índice de Gini mede a probabilidade de um elemento selecionado aleatoriamente do nó ser rotulado de forma incorreta se fosse classificado de acordo com a distribuição das classes no nó. É a métrica padrão do algoritmo CART: \[Gini(S) = 1 - \sum_{i=1}^{c} p_i^2\] Onde \(p_i\) é a proporção de elementos pertencentes à classe \(i\) no nó.
- Um nó perfeitamente homogêneo tem Gini igual a 0.
- O valor cresce até o máximo de \(0{,}5\) para divisões binárias equilibradas e, no caso geral de \(c\) classes, até \(1 - 1/c\).
A interpretação probabilística decorre da identidade \[ \sum_{k=1}^{c} p_k (1 - p_k) = \sum_{k} p_k - \sum_k p_k^2 = 1 - \sum_k p_k^2: \] se sortearmos uma observação do nó (classe \(k\) com probabilidade \(p_k\)) e lhe atribuirmos um rótulo também sorteado segundo as proporções do nó, a probabilidade de erro é \(\sum_k p_k (1-p_k)\). Alternativamente, \(p_k(1-p_k)\) é a variância de uma variável Bernoulli que indica pertencer à classe \(k\); assim, o Gini é a soma das variâncias dessas indicadoras, o que conecta o critério de classificação ao critério de soma de quadrados usado nas árvores de regressão. No caso binário, \(Gini = 2p(1-p)\).
11.4.4 Erro de Classificação
A terceira medida é a taxa de erro de classificação (misclassification error) do nó: \[ E(S) = 1 - \max_{k} p_k, \] que é exatamente a fração de observações do nó que seriam classificadas incorretamente se o nó fosse uma folha. Apesar de ser a medida mais diretamente ligada ao objetivo final, ela não é estritamente côncava (é linear por partes) e, por isso, é pouco sensível a mudanças nas proporções das classes, sendo inadequada para o crescimento da árvore. É, porém, frequentemente usada na etapa de poda.
11.4.5 Comparação das Impurezas
Para o caso binário, com \(p\) denotando a proporção da classe positiva, as três medidas são \[ H(p) = -p\log_2 p - (1-p)\log_2(1-p), \qquad G(p) = 2p(1-p), \qquad E(p) = 1 - \max(p, 1-p). \] Todas são simétricas em torno de \(p = 1/2\), valem zero em \(p \in \{0, 1\}\) e atingem o máximo em \(p = 1/2\). A tabela a seguir mostra seus valores para \(p \in [0; 0{,}5]\) (os valores para \(p > 0{,}5\) são obtidos por simetria, \(Q(p) = Q(1-p)\)):
| \(p\) | Entropia \(H(p)\) | Gini \(G(p)\) | Erro \(E(p)\) |
|---|---|---|---|
| 0,0 | 0,000 | 0,000 | 0,000 |
| 0,1 | 0,469 | 0,180 | 0,100 |
| 0,2 | 0,722 | 0,320 | 0,200 |
| 0,3 | 0,881 | 0,420 | 0,300 |
| 0,4 | 0,971 | 0,480 | 0,400 |
| 0,5 | 1,000 | 0,500 | 0,500 |
Observe que a entropia, quando dividida por 2, fica muito próxima do Gini; na prática, os dois critérios produzem árvores muito semelhantes. O Gini tem a vantagem computacional de não exigir logaritmos.
Considere um nó com 400 observações de cada classe, \((400, 400)\), e duas divisões candidatas (Hastie, Tibshirani, e Friedman 2009):
- Divisão A: filhos \((300, 100)\) e \((100, 300)\).
- Divisão B: filhos \((200, 400)\) e \((200, 0)\).
Pelo erro de classificação, ambas têm erro ponderado \(\frac{400}{800}\cdot 0{,}25 + \frac{400}{800}\cdot 0{,}25 = 0{,}25\) (A) e \(\frac{600}{800}\cdot\frac{1}{3} + \frac{200}{800}\cdot 0 = 0{,}25\) (B): empate.
Pelo Gini: na divisão A, cada filho tem \(G = 2(0{,}75)(0{,}25) = 0{,}375\), com média ponderada \(0{,}375\); na divisão B, o primeiro filho tem \(G = 2\cdot\frac{1}{3}\cdot\frac{2}{3} \approx 0{,}444\) e o segundo é puro, com média ponderada \(\frac{600}{800}(0{,}444) + 0 \approx 0{,}333\). O Gini prefere a divisão B, que cria um nó puro, o que costuma ser vantajoso para as divisões seguintes. A concavidade estrita do Gini e da entropia é o que permite essa distinção.
11.5 Fundamentos de Teoria da Informação
A entropia não foi escolhida ao acaso como medida de impureza. Nesta seção apresentamos os resultados de teoria da informação que justificam seu uso e que explicam, de forma precisa, o que o ganho de informação mede. Uma referência completa para o tema é Cover e Thomas (2006).
11.5.1 Os axiomas de Shannon
Shannon (1948) procurou uma medida \(H(p_1, \ldots, p_c)\) da “quantidade de incerteza” de uma distribuição discreta que satisfizesse três requisitos naturais:
- Continuidade: \(H\) é contínua nas probabilidades \(p_k\).
- Monotonicidade: para distribuições uniformes, \(H(1/c, \ldots, 1/c)\) é crescente em \(c\) — há mais incerteza ao escolher entre mais alternativas igualmente prováveis.
- Agrupamento (composição): se uma escolha for decomposta em duas escolhas sucessivas, a incerteza total é a incerteza da primeira escolha mais a incerteza média da segunda. Formalmente, \[ H(p_1, p_2, p_3, \ldots, p_c) = H(p_1 + p_2, p_3, \ldots, p_c) + (p_1 + p_2)\, H\!\left(\frac{p_1}{p_1+p_2}, \frac{p_2}{p_1+p_2}\right). \]
A única função que satisfaz os três requisitos acima é, a menos de uma constante positiva \(K\), \[ H(p_1, \ldots, p_c) = -K \sum_{k=1}^{c} p_k \log p_k. \] A escolha da base do logaritmo (equivalentemente, de \(K\)) define a unidade: base 2 fornece bits; o logaritmo natural fornece nats. Como \(\log_2 x = \ln x / \ln 2\), as duas versões diferem por um fator constante e levam exatamente às mesmas divisões.
Exemplo resolvido (agrupamento). Considere a distribuição \((1/2, 1/3, 1/6)\). Diretamente, \[ H\left(\tfrac{1}{2}, \tfrac{1}{3}, \tfrac{1}{6}\right) = \tfrac{1}{2}\log_2 2 + \tfrac{1}{3}\log_2 3 + \tfrac{1}{6}\log_2 6 = 0{,}5 + 0{,}5283 + 0{,}4308 = 1{,}4591 \text{ bits}. \] Pelo axioma de agrupamento, podemos primeiro decidir entre “a primeira categoria” e “uma das outras duas” (probabilidades \(1/2\) e \(1/2\)) e, no segundo caso, escolher entre as duas restantes (probabilidades condicionais \(2/3\) e \(1/3\)): \[ H\left(\tfrac{1}{2}, \tfrac{1}{2}\right) + \tfrac{1}{2}\, H\left(\tfrac{2}{3}, \tfrac{1}{3}\right) = 1 + \tfrac{1}{2}(0{,}9183) = 1{,}4591 \text{ bits}, \] exatamente o mesmo valor. O axioma de agrupamento é precisamente o que torna natural medir a qualidade de uma divisão pela entropia média dos filhos: a árvore é uma sequência de perguntas, e a incerteza se decompõe ao longo dela.
11.5.2 Divergência de Kullback–Leibler e desigualdade de Gibbs
Dadas duas distribuições \(P = (p_1, \ldots, p_c)\) e \(Q = (q_1, \ldots, q_c)\) sobre as mesmas categorias, a divergência de Kullback–Leibler (Kullback e Leibler 1951) de \(P\) para \(Q\) é \[ D_{KL}(P \,\|\, Q) = \sum_{k=1}^{c} p_k \log_2 \frac{p_k}{q_k}, \] com as convenções \(0 \log (0/q) = 0\) e \(p \log(p/0) = +\infty\) para \(p > 0\). Ela mede o “custo”, em bits, de codificar dados gerados por \(P\) usando um código otimizado para \(Q\). Não é uma distância no sentido métrico (não é simétrica nem satisfaz a desigualdade triangular), mas tem a propriedade fundamental a seguir.
\(D_{KL}(P \,\|\, Q) \geq 0\), com igualdade se, e somente se, \(P = Q\).
Demonstração. A função \(\log_2\) é estritamente côncava. Pela desigualdade de Jensen, para a variável aleatória \(Z = q_K / p_K\) com \(K \sim P\) (restrita a \(p_k > 0\)), \[ -D_{KL}(P \,\|\, Q) = \sum_{k : p_k > 0} p_k \log_2 \frac{q_k}{p_k} \leq \log_2 \left( \sum_{k : p_k > 0} p_k \frac{q_k}{p_k} \right) = \log_2 \sum_{k : p_k > 0} q_k \leq \log_2 1 = 0. \] A igualdade em Jensen exige que \(q_k/p_k\) seja constante, e a segunda desigualdade exige que essa constante seja 1; logo \(P = Q\). \(\blacksquare\)
Uma consequência imediata é o máximo da entropia: tomando \(Q\) uniforme, \(q_k = 1/c\), \[ 0 \leq D_{KL}(P \,\|\, Q) = \sum_k p_k \log_2 p_k + \log_2 c = \log_2 c - H(P), \] isto é, \(H(P) \leq \log_2 c\), com igualdade apenas para a distribuição uniforme — o resultado que o Exercício 1 pede para obter por multiplicadores de Lagrange.
11.5.3 Ganho de informação é informação mútua
Sejam \(Y\) a classe e \(A\) um atributo categórico, com distribuição conjunta \(P(A = v, Y = k)\) (no nó, as frequências relativas empíricas). A entropia condicional e a informação mútua são \[ H(Y \mid A) = \sum_{v} P(A = v)\, H(Y \mid A = v), \qquad I(Y; A) = \sum_{v}\sum_{k} P(v, k) \log_2 \frac{P(v, k)}{P(v)\,P(k)}. \]
\(I(Y; A) = H(Y) - H(Y \mid A) = D_{KL}\big(P_{AY} \,\|\, P_A \otimes P_Y\big) \geq 0\). Consequentemente, o ganho de informação \(GI(S, A) = H(Y) - H(Y \mid A)\) é sempre não negativo e vale zero se, e somente se, \(A\) e \(Y\) são (empiricamente) independentes no nó.
Demonstração. Escrevendo \(P(v, k) = P(v)\,P(k \mid v)\), \[ \begin{aligned} I(Y; A) &= \sum_{v,k} P(v,k) \log_2 \frac{P(k \mid v)}{P(k)} = \sum_{v,k} P(v,k)\log_2 P(k \mid v) - \sum_{k} \Big(\sum_v P(v,k)\Big) \log_2 P(k) \\ &= -H(Y \mid A) + H(Y). \end{aligned} \] A igualdade com a divergência KL é a própria definição, tomando \(P = P_{AY}\) e \(Q = P_A \otimes P_Y\) (o produto das marginais, que é a distribuição conjunta sob independência). A não negatividade segue da desigualdade de Gibbs. \(\blacksquare\)
Essa leitura é esclarecedora: o ganho de informação mede quão longe a distribuição conjunta de (atributo, classe) está da independência. Um atributo independente da classe tem ganho populacional nulo; o ganho amostral, porém, raramente é exatamente zero, como veremos a seguir.
11.5.4 Entropia, verossimilhança e o teste \(G\)
Considere um nó com \(n_t\) observações e contagens \(n_{tk}\) por classe. Sob um modelo multinomial com probabilidades estimadas por \(\hat{p}_{tk} = n_{tk}/n_t\), o logaritmo natural da verossimilhança maximizada é \[
\ell_t = \sum_{k} n_{tk} \ln \hat{p}_{tk} = -\,n_t\, H_{\text{nats}}(t),
\] em que \(H_{\text{nats}}\) é a entropia em nats. Assim, minimizar a entropia média ponderada dos filhos equivale a maximizar a verossimilhança do modelo que usa uma distribuição de classes por folha; por isso a entropia também é chamada de desvio (deviance) nas implementações (por exemplo, split = "information" no rpart e criterion = "log_loss" no scikit-learn).
Mais ainda, a estatística da razão de verossimilhanças para testar independência entre \(A\) e \(Y\) na tabela de contingência do nó é \[ G = 2 \sum_{v,k} n_{vk} \ln \frac{n_{vk}\, n_t}{n_{v\cdot}\, n_{\cdot k}} = 2\, n_t \ln 2 \cdot GI(S, A). \] Sob independência, \(G\) tem distribuição aproximadamente \(\chi^2\) com \((q - 1)(c - 1)\) graus de liberdade, em que \(q\) é o número de valores do atributo. Como \(E[\chi^2_\nu] = \nu\), obtemos uma aproximação para o ganho de informação esperado de um atributo inútil: \[ E[GI] \approx \frac{(q - 1)(c - 1)}{2\, n_t \ln 2}. \]
A expressão acima mostra que o ganho de informação de um atributo completamente irrelevante cresce linearmente com o número de níveis \(q\). Simulamos 20 mil nós com \(n_t = 100\) observações, classe binária equiprovável e um atributo aleatório independente da classe:
| Níveis \(q\) | \(E[GI]\) simulado | Aproximação \(\frac{q-1}{2 n_t \ln 2}\) |
|---|---|---|
| 2 | 0,0074 | 0,0072 |
| 5 | 0,0298 | 0,0289 |
| 10 | 0,0702 | 0,0649 |
| 20 | 0,1634 | 0,1371 |
Um atributo de ruído com 20 níveis tem, em média, ganho mais de 20 vezes maior que um de ruído binário. (A aproximação qui-quadrado piora quando há muitas caselas com poucas observações, como no caso \(q = 20\).) Esse é o fundamento quantitativo da razão de ganho do C4.5 e dos métodos baseados em testes, como o CHAID e as árvores de inferência condicional, que comparam atributos pelo valor-p do teste, e não pelo ganho bruto.
11.6 Propriedades Teóricas das Medidas de Impureza
11.6.1 Concavidade e a não negatividade do decréscimo de impureza
Seja \(\mathbf{p} = (p_1, \ldots, p_c)\) o vetor de proporções de classes no nó pai e \(\mathbf{p}_L\), \(\mathbf{p}_R\) os vetores dos filhos, com pesos \(w_L = n_L/n_t\) e \(w_R = n_R / n_t\). Como cada observação do pai vai para exatamente um filho, \[ \mathbf{p} = w_L\, \mathbf{p}_L + w_R\, \mathbf{p}_R, \] isto é, a distribuição do pai é uma combinação convexa das distribuições dos filhos.
Se \(Q\) é côncava, então para qualquer divisão \[ \Delta Q = Q(\mathbf{p}) - \left[w_L\, Q(\mathbf{p}_L) + w_R\, Q(\mathbf{p}_R)\right] \geq 0. \] Se \(Q\) é estritamente côncava, a igualdade ocorre se, e somente se, \(\mathbf{p}_L = \mathbf{p}_R\) (os filhos têm exatamente a mesma composição de classes).
Demonstração. É a definição de concavidade (ou a desigualdade de Jensen com dois pontos): \(Q(w_L \mathbf{p}_L + w_R \mathbf{p}_R) \geq w_L Q(\mathbf{p}_L) + w_R Q(\mathbf{p}_R)\), com desigualdade estrita para \(\mathbf{p}_L \neq \mathbf{p}_R\) quando \(Q\) é estritamente côncava. O argumento se estende a divisões multivias por indução. \(\blacksquare\)
A entropia e o Gini são estritamente côncavas (o Gini é uma forma quadrática com Hessiana \(-2\mathbf{I}\) restrita ao simplex). Já o erro de classificação \(E(\mathbf{p}) = 1 - \max_k p_k\) é côncavo, mas não estritamente: é linear em cada região onde a classe majoritária não muda. Daí decorre um fato importante: se os dois filhos têm a mesma classe majoritária que o pai, o decréscimo do erro de classificação é exatamente zero, por mais informativa que seja a divisão.
Exemplo resolvido. Um nó tem 70 observações da classe A e 30 da B. A divisão candidata gera os filhos \((40, 20)\) e \((30, 10)\). Ambos os filhos têm A como classe majoritária:
- Erro: pai \(0{,}30\); filhos \(\frac{60}{100}\cdot\frac{20}{60} + \frac{40}{100}\cdot\frac{10}{40} = 0{,}30\). Decréscimo: \(0\).
- Gini: pai \(2(0{,}7)(0{,}3) = 0{,}42\); filhos \(0{,}6 \cdot 2\cdot\frac{2}{3}\cdot\frac{1}{3} + 0{,}4 \cdot 2(0{,}75)(0{,}25) = 0{,}2667 + 0{,}15 = 0{,}4167\). Decréscimo: \(0{,}0033\).
- Entropia: pai \(0{,}8813\); filhos \(0{,}6(0{,}9183) + 0{,}4(0{,}8113) = 0{,}8755\). Decréscimo: \(0{,}0058\).
O erro de classificação é “cego” para essa divisão, enquanto Gini e entropia detectam que o segundo filho ficou ligeiramente mais puro. Em nós com uma classe muito majoritária, quase toda divisão útil tem essa característica, e o critério de erro faria o crescimento parar prematuramente.
11.6.2 O Gini como soma de quadrados
Codifique a classe por indicadoras \(z_{ik} = \mathbb{I}\{y_i = k\}\). No nó \(t\), a média de \(z_{ik}\) é \(\hat{p}_{tk}\), e a soma de quadrados dos resíduos em torno da média é \[ \sum_{i \in t} (z_{ik} - \hat{p}_{tk})^2 = n_t\, \hat{p}_{tk}(1 - \hat{p}_{tk}). \] Somando sobre as classes, \(\sum_k \sum_{i \in t}(z_{ik} - \hat{p}_{tk})^2 = n_t\, Gini(t)\).
Para qualquer divisão, o decréscimo de Gini ponderado pelo tamanho do nó é igual ao decréscimo da soma de quadrados dos resíduos das indicadoras de classe: \[ n_t\, \Delta Gini = \mathrm{SQR}(t) - \left[\mathrm{SQR}(t_L) + \mathrm{SQR}(t_R)\right], \qquad \mathrm{SQR}(t) = \sum_{k}\sum_{i \in t}(z_{ik} - \hat{p}_{tk})^2. \] Em particular, no caso binário com \(y \in \{0, 1\}\), \(\mathrm{SQR}\) é a soma de quadrados usual e \(Gini = 2\,\mathrm{SQR}/n_t\): a árvore de classificação com Gini escolhe exatamente as mesmas divisões que uma árvore de regressão por mínimos quadrados ajustada à resposta 0/1.
Por exemplo, no nó com 70 A e 30 B, codificando B como 1, a soma de quadrados é \(100 \times 0{,}3 \times 0{,}7 = 21\) e \(2 \times 21 / 100 = 0{,}42\), o Gini do nó. Essa equivalência explica por que o mesmo código (CART) serve para classificação e regressão.
11.6.3 Entropia e Gini como membros de uma mesma família
Expandindo \(-\ln p\) em torno de \(p = 1\), temos \(-\ln p = (1 - p) + \frac{(1-p)^2}{2} + \cdots\). Mantendo só o primeiro termo, \[ H_{\text{nats}}(\mathbf{p}) = -\sum_k p_k \ln p_k \approx \sum_k p_k (1 - p_k) = Gini(\mathbf{p}), \] o que explica a semelhança numérica observada na tabela comparativa. De fato, ambas pertencem à família de entropias de Tsallis, \(S_q(\mathbf{p}) = \frac{1}{q-1}\left(1 - \sum_k p_k^q\right)\): o Gini corresponde a \(q = 2\) e a entropia de Shannon (em nats) ao limite \(q \to 1\). Valores maiores de \(q\) dão menos peso às classes raras.
11.6.4 Árvores de regressão em poucas palavras
Quando a resposta é quantitativa, o CART usa como impureza a variância (soma de quadrados) do nó e prediz a média das respostas da folha: \[ Q(t) = \frac{1}{n_t}\sum_{i \in t}(y_i - \bar{y}_t)^2, \qquad \hat{f}(\mathbf{x}) = \bar{y}_{t(\mathbf{x})}. \] Toda a maquinaria deste capítulo — partição recursiva gulosa, poda por custo-complexidade (com \(R(T)\) = soma de quadrados dos resíduos), divisões substitutas e importância de variáveis — aplica-se sem alterações. O tratamento detalhado está no Capítulo de Modelos de Regressão com Árvores e Florestas.
11.7 Exemplo Numérico Completo: Jogar Tênis
Vamos aplicar o ID3 à mão ao clássico conjunto de dados “jogar tênis”, popularizado por Quinlan (1986) e Mitchell (1997). Cada linha corresponde a um dia, e queremos prever se haverá partida (Jogar) a partir das condições meteorológicas.
| Dia | Tempo | Temperatura | Umidade | Vento | Jogar |
|---|---|---|---|---|---|
| D1 | Ensolarado | Quente | Alta | Fraco | Não |
| D2 | Ensolarado | Quente | Alta | Forte | Não |
| D3 | Nublado | Quente | Alta | Fraco | Sim |
| D4 | Chuvoso | Amena | Alta | Fraco | Sim |
| D5 | Chuvoso | Fria | Normal | Fraco | Sim |
| D6 | Chuvoso | Fria | Normal | Forte | Não |
| D7 | Nublado | Fria | Normal | Forte | Sim |
| D8 | Ensolarado | Amena | Alta | Fraco | Não |
| D9 | Ensolarado | Fria | Normal | Fraco | Sim |
| D10 | Chuvoso | Amena | Normal | Fraco | Sim |
| D11 | Ensolarado | Amena | Normal | Forte | Sim |
| D12 | Nublado | Amena | Alta | Forte | Sim |
| D13 | Nublado | Quente | Normal | Fraco | Sim |
| D14 | Chuvoso | Amena | Alta | Forte | Não |
11.7.1 Passo 1: Entropia do nó raiz
Há \(n = 14\) dias, sendo 9 “Sim” e 5 “Não”. Logo, \[ H(S) = -\frac{9}{14}\log_2\frac{9}{14} - \frac{5}{14}\log_2\frac{5}{14} = 0{,}4098 + 0{,}5305 \approx 0{,}940 \text{ bits}. \]
11.7.2 Passo 2: Entropia condicional de cada atributo
Atributo Tempo. Os subconjuntos são: Ensolarado (5 dias: 2 Sim, 3 Não), Nublado (4 dias: 4 Sim, 0 Não) e Chuvoso (5 dias: 3 Sim, 2 Não). \[ \begin{aligned} H(S_{\text{Ens}}) &= -\tfrac{2}{5}\log_2\tfrac{2}{5} - \tfrac{3}{5}\log_2\tfrac{3}{5} \approx 0{,}971,\\ H(S_{\text{Nub}}) &= 0 \quad (\text{nó puro}),\\ H(S_{\text{Chu}}) &= -\tfrac{3}{5}\log_2\tfrac{3}{5} - \tfrac{2}{5}\log_2\tfrac{2}{5} \approx 0{,}971,\\ H(S \mid \text{Tempo}) &= \tfrac{5}{14}(0{,}971) + \tfrac{4}{14}(0) + \tfrac{5}{14}(0{,}971) \approx 0{,}694. \end{aligned} \] Portanto, \(GI(S, \text{Tempo}) = 0{,}940 - 0{,}694 = 0{,}247\).
Atributo Temperatura. Quente (4: 2 Sim, 2 Não), Amena (6: 4 Sim, 2 Não), Fria (4: 3 Sim, 1 Não): \[ H(S \mid \text{Temperatura}) = \tfrac{4}{14}(1{,}000) + \tfrac{6}{14}(0{,}918) + \tfrac{4}{14}(0{,}811) \approx 0{,}911, \] e \(GI(S, \text{Temperatura}) = 0{,}940 - 0{,}911 = 0{,}029\).
Atributo Umidade. Alta (7: 3 Sim, 4 Não), Normal (7: 6 Sim, 1 Não): \[ H(S \mid \text{Umidade}) = \tfrac{7}{14}(0{,}985) + \tfrac{7}{14}(0{,}592) \approx 0{,}789, \] e \(GI(S, \text{Umidade}) = 0{,}940 - 0{,}789 = 0{,}152\).
Atributo Vento. Fraco (8: 6 Sim, 2 Não), Forte (6: 3 Sim, 3 Não): \[ H(S \mid \text{Vento}) = \tfrac{8}{14}(0{,}811) + \tfrac{6}{14}(1{,}000) \approx 0{,}892, \] e \(GI(S, \text{Vento}) = 0{,}940 - 0{,}892 = 0{,}048\).
11.7.3 Passo 3: Comparação e escolha da raiz
Calculando também a informação da divisão, a razão de ganho e o decréscimo de Gini (o Gini da raiz é \(1 - (9/14)^2 - (5/14)^2 \approx 0{,}459\)), obtemos:
| Atributo | \(GI\) | \(SI\) | Razão de ganho | Gini ponderado dos filhos | Decréscimo de Gini |
|---|---|---|---|---|---|
| Tempo | 0,247 | 1,577 | 0,156 | 0,343 | 0,116 |
| Umidade | 0,152 | 1,000 | 0,152 | 0,367 | 0,092 |
| Vento | 0,048 | 0,985 | 0,049 | 0,429 | 0,031 |
| Temperatura | 0,029 | 1,557 | 0,019 | 0,441 | 0,019 |
Os três critérios concordam: Tempo é o atributo escolhido para a raiz. Repare que a razão de ganho de Tempo (0,156) fica bem mais próxima da de Umidade (0,152) do que o ganho de informação, pois Tempo tem três valores e é penalizado pela informação da divisão.
Pelo teorema da seção de teoria da informação, \(GI(S, \text{Tempo}) = D_{KL}(P_{AY} \,\|\, P_A \otimes P_Y)\). A tabela conjunta (frequências relativas), com as marginais, é:
| Tempo | Sim | Não | \(P(A = v)\) |
|---|---|---|---|
| Ensolarado | 2/14 | 3/14 | 5/14 |
| Nublado | 4/14 | 0 | 4/14 |
| Chuvoso | 3/14 | 2/14 | 5/14 |
| \(P(Y = k)\) | 9/14 | 5/14 | 1 |
Cada casela contribui com \(P(v,k)\log_2\frac{P(v,k)}{P(v)P(k)}\). Por exemplo, para (Nublado, Sim): \(\frac{4}{14}\log_2 \frac{4/14}{(4/14)(9/14)} = \frac{4}{14}\log_2\frac{14}{9} \approx 0{,}1821\). As cinco contribuições não nulas são \[ -0{,}0978 \;(\text{Ens, Sim}) + 0{,}1604 \;(\text{Ens, Não}) + 0{,}1821 \;(\text{Nub, Sim}) - 0{,}0213 \;(\text{Chu, Sim}) + 0{,}0234 \;(\text{Chu, Não}) = 0{,}2467, \] exatamente o ganho de informação obtido no Passo 2. Note que algumas parcelas são negativas (a casela é menos frequente do que sob independência), mas a soma é necessariamente não negativa. Além disso, a estatística \(G = 2 \cdot 14 \cdot \ln 2 \cdot 0{,}2467 \approx 4{,}79\), com \((3-1)(2-1) = 2\) graus de liberdade, corresponde a um valor-p aproximado de \(0{,}09\): com apenas 14 dias, nem o melhor atributo é “significativo” ao nível de 5%, um lembrete de que esse exemplo é puramente ilustrativo.
11.7.4 Passo 4: Recursão nos nós filhos
- O ramo Nublado é puro (4 Sim) e vira uma folha com rótulo “Sim”.
- No ramo Ensolarado (D1, D2, D8, D9, D11; 2 Sim e 3 Não, \(H = 0{,}971\)), o atributo Umidade separa perfeitamente os dados: Alta \(\rightarrow\) {D1, D2, D8} todos “Não”; Normal \(\rightarrow\) {D9, D11} todos “Sim”. O ganho é \(0{,}971 - 0 = 0{,}971\), o máximo possível.
- No ramo Chuvoso (D4, D5, D6, D10, D14; 3 Sim e 2 Não), o atributo Vento separa perfeitamente: Fraco \(\rightarrow\) {D4, D5, D10} “Sim”; Forte \(\rightarrow\) {D6, D14} “Não”.
A árvore final é:
Tempo?
├── Ensolarado → Umidade?
│       ├── Alta   → Não
│       └── Normal → Sim
├── Nublado    → Sim
└── Chuvoso    → Vento?
        ├── Fraco  → Sim
        └── Forte  → Não
Note que o atributo Temperatura nunca é usado: a árvore realiza, implicitamente, uma seleção de variáveis. Em linguagem de regras: “SE Tempo = Ensolarado E Umidade = Normal ENTÃO Jogar = Sim”, e assim por diante.
11.8 Divisões em Variáveis Contínuas e Categóricas
11.8.1 Variáveis contínuas
Para uma variável contínua \(x_j\) com valores distintos ordenados \(v_{(1)} < v_{(2)} < \cdots < v_{(r)}\) no nó, só existem \(r - 1\) partições distintas do tipo \(x_j \leq s\), e os pontos de corte candidatos usualmente são os pontos médios \(s = (v_{(i)} + v_{(i+1)})/2\). Ordenando os dados uma vez (\(O(n \log n)\)), é possível atualizar as contagens das classes incrementalmente e avaliar todos os cortes em tempo linear. Além disso, para a entropia demonstra-se que o corte ótimo sempre ocorre num ponto de fronteira, isto é, entre dois valores consecutivos com classes diferentes, o que reduz ainda mais o número de candidatos.
Exemplo. Considere 8 observações de uma variável \(x\) com classes S/N:
| \(x\) | 2 | 3 | 5 | 7 | 8 | 10 | 12 | 15 |
|---|---|---|---|---|---|---|---|---|
| \(y\) | N | N | N | N | S | N | S | S |
O nó tem 5 N e 3 S, com \(Gini = 1 - (5/8)^2 - (3/8)^2 = 30/64 \approx 0{,}469\). Os pontos de fronteira são \(s = 7{,}5\), \(s = 9\) e \(s = 11\):
- \(s = 7{,}5\): esquerda {N,N,N,N} com \(G = 0\); direita {S,N,S,S} com \(G = 1 - (3/4)^2 - (1/4)^2 = 0{,}375\). Gini ponderado: \(\frac{4}{8}(0) + \frac{4}{8}(0{,}375) = 0{,}1875\).
- \(s = 9\): esquerda {N,N,N,N,S} com \(G = 0{,}32\); direita {N,S,S} com \(G \approx 0{,}444\). Ponderado: \(\frac{5}{8}(0{,}32) + \frac{3}{8}(0{,}444) \approx 0{,}367\).
- \(s = 11\): esquerda {N,N,N,N,S,N} com \(G = 10/36 \approx 0{,}278\); direita {S,S} com \(G = 0\). Ponderado: \(\frac{6}{8}(0{,}278) \approx 0{,}208\).
O melhor corte é \(x \leq 7{,}5\), com decréscimo de Gini \(0{,}469 - 0{,}1875 \approx 0{,}281\).
11.8.2 Custo computacional da busca pela melhor divisão
Vale a pena quantificar o custo do algoritmo guloso, pois ele explica por que as árvores escalam bem para grandes bases de dados.
- Em um nó com \(n_t\) observações e uma variável contínua: ordenar os valores custa \(O(n_t \log n_t)\). Em seguida, percorremos os cortes candidatos da esquerda para a direita; ao mover uma observação da direita para a esquerda, as contagens \(n_{Lk}\) e \(n_{Rk}\) mudam em uma unidade, e a impureza dos filhos é atualizada em tempo \(O(c)\). A varredura completa custa \(O(c\, n_t)\).
- Em um nó, considerando as \(p\) variáveis: \(O(p\, n_t \log n_t)\) (ou \(O(p\, n_t)\) se os dados forem pré-ordenados uma única vez na raiz e a ordem for herdada pelos filhos, como faz o CART original).
- Na árvore inteira: em cada nível de profundidade, os nós particionam as \(n\) observações, de modo que o custo por nível é \(O(p\, n \log n)\). Para uma árvore razoavelmente balanceada, com profundidade \(O(\log n)\), o custo total é \(O(p\, n \log^2 n)\). No pior caso (árvore degenerada, que separa uma observação por vez), a profundidade é \(O(n)\) e o custo sobe para \(O(p\, n^2 \log n)\).
- Predição: percorrer a árvore da raiz até uma folha custa \(O(\text{profundidade})\), tipicamente \(O(\log n)\).
Implementações modernas, como as árvores baseadas em histogramas (usadas no HistGradientBoostingClassifier do scikit-learn e no LightGBM, que veremos no próximo capítulo), discretizam cada variável em no máximo 256 faixas antes do treinamento; a busca por cortes passa a custar \(O(n_t)\) para montar o histograma e \(O(256)\) para varrê-lo, o que é muito mais rápido em bases grandes.
O resultado de Hyafil e Rivest (1976) diz que, mesmo para atributos binários, decidir se existe uma árvore de decisão consistente com os dados e com custo esperado (número médio de perguntas) menor ou igual a um valor \(k\) é NP-completo. Na prática, isso significa que não se conhece algoritmo de tempo polinomial que encontre a árvore ótima, e o número de árvores possíveis cresce de forma super-exponencial com o número de nós. Abordagens recentes usam programação inteira mista ou programação dinâmica para obter árvores ótimas de profundidade pequena (por exemplo, até 3 ou 4 níveis) em bases moderadas, mas o algoritmo guloso continua sendo o padrão: é rápido, e a perda em relação ao ótimo costuma ser pequena quando comparada à variância de estimação.
11.8.3 Variáveis categóricas
Para uma variável categórica com \(q\) níveis não ordenados, uma divisão binária corresponde a escolher um subconjunto de níveis que vai para a esquerda. Há \(2^{q-1} - 1\) partições binárias distintas, número que cresce exponencialmente (para \(q = 10\) são 511; para \(q = 30\), mais de 500 milhões). Felizmente, no caso de resposta binária, Breiman et al. (1984) mostraram que basta ordenar os níveis pela proporção da classe positiva em cada nível e tratar a variável como ordinal: a divisão ótima está entre as \(q - 1\) divisões dessa ordenação. Para mais de duas classes não existe simplificação exata, e é comum usar heurísticas ou codificação one-hot.
Exemplo resolvido. Uma variável com níveis \(a, b, c, d\), cada um com 10 observações, tem as seguintes contagens da classe positiva: \(a\): 2, \(b\): 8, \(c\): 5, \(d\): 1. O nó tem 16 positivos em 40 (\(Gini = 2 \cdot 0{,}4 \cdot 0{,}6 = 0{,}48\)). Há \(2^{3} - 1 = 7\) partições binárias; calculando o Gini ponderado de todas:
| Partição | Gini ponderado |
|---|---|
| \(\{a, d\}\) vs. \(\{b, c\}\) | 0,355 |
| \(\{a, c, d\}\) vs. \(\{b\}\) | 0,373 |
| \(\{d\}\) vs. \(\{a, b, c\}\) | 0,420 |
| \(\{a\}\) vs. \(\{b, c, d\}\) | 0,453 |
| \(\{a, b\}\) vs. \(\{c, d\}\) | 0,460 |
| \(\{c\}\) vs. \(\{a, b, d\}\) | 0,473 |
| \(\{a, c\}\) vs. \(\{b, d\}\) | 0,475 |
Ordenando os níveis pela proporção de positivos, \(d\,(0{,}1) < a\,(0{,}2) < c\,(0{,}5) < b\,(0{,}8)\), os únicos candidatos a examinar são \(\{d\}|\{a,c,b\}\), \(\{d,a\}|\{c,b\}\) e \(\{d,a,c\}|\{b\}\) — e, de fato, a melhor partição entre as sete, \(\{a, d\}\) vs. \(\{b, c\}\), é uma delas. A ideia da demonstração é que, com resposta binária, o Gini ponderado dos filhos depende da partição apenas através das proporções de positivos de cada lado, e a concavidade da impureza faz com que a partição ótima nunca “intercale” níveis na ordenação.
Algoritmos como ID3 e C4.5 usam, em vez disso, divisões multivias (um ramo por nível). Isso produz árvores mais rasas, mas fragmenta rapidamente os dados e, como vimos, exige a razão de ganho para não favorecer variáveis de alta cardinalidade.
Binária ou multivias? Toda divisão multivias pode ser representada por uma sequência de divisões binárias (por exemplo, \(\{a\}\) vs. \(\{b, c\}\) seguida de \(\{b\}\) vs. \(\{c\}\)), de modo que as árvores binárias não perdem expressividade. As vantagens das divisões binárias são: (i) a fragmentação é mais lenta, pois cada divisão consome dados de forma mais gradual; (ii) níveis com comportamento semelhante podem ser agrupados, em vez de receberem ramos separados com poucas observações; e (iii) a comparação entre variáveis com números diferentes de níveis é menos desequilibrada. Ainda assim, mesmo no CART, uma variável categórica com \(q\) níveis oferece \(2^{q-1} - 1\) partições, contra \(r - 1\) cortes de uma variável contínua com \(r\) valores distintos, e o viés de seleção a favor de variáveis com mais possibilidades de corte persiste — tema que retomaremos ao discutir as árvores de inferência condicional.
No scikit-learn, as árvores tradicionalmente exigem variáveis numéricas, de modo que variáveis categóricas costumam ser codificadas (por exemplo, com OneHotEncoder). Já o rpart do R trata fatores nativamente, usando a ordenação descrita acima.
11.8.4 Valores ausentes
O CART lida com valores ausentes por meio de divisões substitutas (surrogate splits): para cada divisão principal, armazenam-se outras divisões, em outras variáveis, que melhor imitam a partição original. Quando a variável principal está ausente para uma observação, usa-se a melhor substituta disponível. O C4.5, por sua vez, distribui a observação fracionariamente entre os ramos, com pesos proporcionais ao tamanho de cada ramo.
Formalmente, seja \(s^*\) a divisão principal do nó \(t\), que envia cada observação para a esquerda ou para a direita. Para uma outra variável \(x_{j'}\) e um corte \(s'\), a concordância (agreement) é a fração das observações do nó (com ambas as variáveis observadas) que \(s'\) envia para o mesmo lado que \(s^*\): \[
\operatorname{agree}(s') = \frac{1}{n_t}\sum_{i \in t} \mathbb{I}\{\text{$s'$ e $s^*$ enviam $i$ para o mesmo lado}\}.
\] Uma substituta só é útil se for melhor que a regra trivial “envie tudo para o lado majoritário”, cuja concordância é \(\max(n_L, n_R)/n_t\). Por isso o rpart reporta também a concordância ajustada \[
\operatorname{adj}(s') = \frac{n_t \cdot \operatorname{agree}(s') - \max(n_L, n_R)}{n_t - \max(n_L, n_R)},
\] que mede a fração do “erro da regra majoritária” que a substituta corrige; substitutas com \(\operatorname{adj} \leq 0\) são descartadas.
Exemplo resolvido (dados kyphosis). No conjunto kyphosis do pacote rpart (81 crianças submetidas a cirurgia de coluna), a divisão principal da raiz é \(\texttt{Start} \geq 8{,}5\), que envia 62 crianças para a esquerda e 19 para a direita. A melhor substituta encontrada é \(\texttt{Number} < 6{,}5\), que concorda com a divisão principal em 65 das 81 crianças, ou seja, \(\operatorname{agree} = 65/81 \approx 0{,}802\). Como a regra majoritária já acerta \(62/81 \approx 0{,}765\), a concordância ajustada é \[
\operatorname{adj} = \frac{65 - 62}{81 - 62} = \frac{3}{19} \approx 0{,}158.
\] Embora a concordância bruta pareça alta, a substituta corrige apenas 15,8% dos “erros” da regra trivial — o que ilustra por que o ajuste é necessário. Esses números aparecem na saída de summary():
library(rpart)
arv <- rpart(Kyphosis ~ Age + Number + Start, data = kyphosis, method = "class")
summary(arv, cp = 0.1)
#> Node number 1: 81 observations,    complexity param=0.1764706
#>   ...
#>   Primary splits:
#>       Start  < 8.5  to the right, improve=6.762330, (0 missing)
#>       Number < 5.5  to the left,  improve=2.866795, (0 missing)
#>       Age    < 39.5 to the left,  improve=2.250212, (0 missing)
#>   Surrogate splits:
#>       Number < 6.5  to the left,  agree=0.802, adj=0.158, (0 split)

# Controle do uso de substitutas na predição com dados faltantes
kyph_na <- kyphosis
kyph_na$Start[1:5] <- NA
arv_na <- rpart(Kyphosis ~ ., data = kyph_na, method = "class",
                control = rpart.control(maxsurrogate = 5, usesurrogate = 2))
predict(arv_na, newdata = kyph_na[1:5, ], type = "prob")
No rpart, usesurrogate = 2 (padrão) significa: se nenhuma substituta estiver disponível, a observação segue a direção majoritária. Diferentemente da imputação, que preenche os valores faltantes antes do ajuste (ver Capítulo de Análise Exploratória de Dados com Python), as divisões substitutas exploram a correlação local entre variáveis dentro de cada nó. Elas pressupõem, entretanto, que a ausência ocorre ao acaso; se o próprio fato de faltar for informativo, é preferível criar uma indicadora de ausência ou tratar “ausente” como categoria (como fazem o HistGradientBoostingClassifier e as versões recentes do DecisionTreeClassifier do scikit-learn, que aprendem para qual lado enviar os ausentes).
11.9 O Problema do Overfitting e a Poda (Pruning)
As Árvores de Decisão são altamente suscetíveis ao sobreajuste (overfitting). Se permitirmos que o algoritmo cresça livremente sem restrições, a árvore continuará gerando perguntas até criar nós folhas contendo um único dado de treino. Isso resulta em uma acurácia de 100% no treino, mas que falhará drasticamente nos dados de teste. Em termos do dilema viés-variância visto no Capítulo de Introdução ao Aprendizado de Máquina, uma árvore profunda tem viés baixo e variância alta, enquanto uma árvore muito rasa tem o comportamento oposto.
Para combater o overfitting, aplicamos técnicas de Poda (Pruning):
- Pré-poda (Early Stopping): Interrompe o crescimento da árvore durante o treinamento se determinados limites forem atingidos. Exemplos comuns:
- Limitar a profundidade máxima da árvore (
max_depth). - Definir o número mínimo de amostras necessárias em um nó antes de permitir que ele sofra uma nova divisão.
- Definir o número mínimo de amostras permitidas em um nó folha.
- Limitar a profundidade máxima da árvore (
- Pós-poda (Post-pruning): Permite que a árvore cresça completamente e, em seguida, avalia o impacto de colapsar subárvores inteiras de volta a nós folhas a partir de um conjunto de validação, removendo ramos que não acrescentem ganhos reais à capacidade de generalização.
11.9.1 Critérios de parada (pré-poda) em detalhe
Os critérios de parada mais usados e seus nomes nas principais implementações são:
| Critério | rpart (R) |
scikit-learn (Python) |
|---|---|---|
| Profundidade máxima | maxdepth (padrão 30) |
max_depth (padrão None) |
| Mínimo de observações para dividir um nó | minsplit (padrão 20) |
min_samples_split (padrão 2) |
| Mínimo de observações em cada folha | minbucket (padrão minsplit/3) |
min_samples_leaf (padrão 1) |
| Decréscimo mínimo de impureza / ajuste | cp (padrão 0,01) |
min_impurity_decrease (padrão 0) |
| Número máximo de folhas | — | max_leaf_nodes |
A pré-poda é computacionalmente barata, mas sofre do chamado efeito horizonte: uma divisão que, isoladamente, produz pouco ganho pode viabilizar divisões muito boas logo abaixo. O exemplo clássico é o problema do “ou exclusivo” (XOR), em que nenhuma divisão isolada em \(x_1\) ou \(x_2\) reduz a impureza, mas a combinação das duas separa perfeitamente as classes. Por isso, a recomendação de Breiman et al. (1984) é crescer uma árvore grande e depois podá-la.
11.9.2 Poda por custo-complexidade
A poda por custo-complexidade (cost-complexity pruning), também chamada de weakest link pruning, é o método de pós-poda do CART. Seja \(T_0\) a árvore grande obtida sem restrições, e seja \(T \preceq T_0\) uma subárvore obtida colapsando nós internos de \(T_0\). Denotemos por \(|T|\) o número de folhas de \(T\) e por \(R(T)\) uma medida de erro da árvore no treinamento (por exemplo, a taxa de erro de classificação ponderada pelas folhas). Para um parâmetro de complexidade \(\alpha \geq 0\), definimos o critério de custo-complexidade \[ R_\alpha(T) = R(T) + \alpha |T|. \]
O termo \(\alpha|T|\) funciona como uma penalidade pelo tamanho da árvore, de forma análoga às penalizações de modelos de regressão regularizados. Quando \(\alpha = 0\), a melhor subárvore é a própria \(T_0\); à medida que \(\alpha\) cresce, subárvores menores são favorecidas; para \(\alpha\) suficientemente grande, resta apenas a raiz. Breiman et al. (1984) demonstraram que, para cada \(\alpha\), existe uma única menor subárvore \(T_\alpha\) que minimiza \(R_\alpha(T)\), e que as soluções são encaixadas: se \(\alpha_1 < \alpha_2\), então \(T_{\alpha_2} \preceq T_{\alpha_1}\).
O cálculo da sequência é feito pelo princípio do elo mais fraco. Para cada nó interno \(t\), seja \(T_t\) a subárvore com raiz em \(t\). Colapsar \(T_t\) em uma folha altera o erro de \(R(T_t)\) para \(R(t)\) e reduz o número de folhas em \(|T_t| - 1\). Os dois são indiferentes sob \(R_\alpha\) quando \(R(t) + \alpha = R(T_t) + \alpha|T_t|\), isto é, quando \[ \alpha = g(t) = \frac{R(t) - R(T_t)}{|T_t| - 1}. \] O nó com menor \(g(t)\) é o elo mais fraco e é podado primeiro. Repetindo o processo obtemos uma sequência de árvores \(T_0 \succ T_1 \succ \cdots \succ \{\text{raiz}\}\) associada a valores crescentes \(0 = \alpha_0 < \alpha_1 < \alpha_2 < \cdots\).
Exemplo. Suponha dois nós internos numa árvore:
- Nó \(t_1\): se colapsado, teria erro \(R(t_1) = 0{,}20\); sua subárvore tem 3 folhas com erro \(R(T_{t_1}) = 0{,}12\). Então \(g(t_1) = (0{,}20 - 0{,}12)/(3 - 1) = 0{,}04\).
- Nó \(t_2\): \(R(t_2) = 0{,}10\); sua subárvore tem 2 folhas com erro \(0{,}08\). Então \(g(t_2) = (0{,}10 - 0{,}08)/(2 - 1) = 0{,}02\).
O nó \(t_2\) é o elo mais fraco: ele é podado quando \(\alpha\) atinge \(0{,}02\), pois o ramo extra reduz o erro em apenas \(0{,}02\) ao custo de uma folha adicional. O nó \(t_1\) só será podado quando \(\alpha \geq 0{,}04\) (considerando que nada mais mudou na árvore).
11.9.3 Exemplo resolvido: a sequência completa de podas
Vamos executar o algoritmo do elo mais fraco do início ao fim. Considere uma árvore \(T_0\) ajustada a \(N = 200\) observações de duas classes (A e B), com 6 folhas. Entre parênteses, as contagens (A, B) de cada nó; \(R(t)\) é o número de erros do nó, caso ele fosse uma folha, dividido por \(N\):
t1 (110, 90)                       R(t1)  = 90/200 = 0,450
├── t2 (70, 30)                    R(t2)  = 30/200 = 0,150
│   ├── t4 (58, 2)   [folha]       R(t4)  =  2/200 = 0,010
│   └── t5 (12, 28)                R(t5)  = 12/200 = 0,060
│       ├── t8 (4, 21)  [folha]    R(t8)  =  4/200 = 0,020
│       └── t9 (8, 7)   [folha]    R(t9)  =  7/200 = 0,035
└── t3 (40, 60)                    R(t3)  = 40/200 = 0,200
    ├── t6 (35, 5)                 R(t6)  =  5/200 = 0,025
    │   ├── t10 (32, 0) [folha]    R(t10) =  0
    │   └── t11 (3, 5)  [folha]    R(t11) =  3/200 = 0,015
    └── t7 (5, 55)   [folha]       R(t7)  =  5/200 = 0,025
O erro de treinamento da árvore completa é \(R(T_0) = (2 + 4 + 7 + 0 + 3 + 5)/200 = 0{,}105\).
Iteração 1. Calculamos \(g(t) = \frac{R(t) - R(T_t)}{|T_t| - 1}\) para todos os nós internos:
- \(g(t_5) = \frac{0{,}060 - (0{,}020 + 0{,}035)}{2 - 1} = 0{,}005\);
- \(g(t_6) = \frac{0{,}025 - (0 + 0{,}015)}{2 - 1} = 0{,}010\);
- \(g(t_2) = \frac{0{,}150 - (0{,}010 + 0{,}020 + 0{,}035)}{3 - 1} = 0{,}0425\);
- \(g(t_3) = \frac{0{,}200 - (0 + 0{,}015 + 0{,}025)}{3 - 1} = 0{,}080\);
- \(g(t_1) = \frac{0{,}450 - 0{,}105}{6 - 1} = 0{,}069\).
O elo mais fraco é \(t_5\), com \(\alpha_1 = 0{,}005\): o ramo de \(t_5\) reduz o erro em apenas uma observação. Colapsando-o, obtemos \(T_1\) com 5 folhas e \(R(T_1) = 0{,}110\).
Iteração 2. Recalculamos os valores que mudaram: agora \(T_{t_2}\) tem folhas \(t_4, t_5\), com erro \(0{,}070\), e \(g(t_2) = (0{,}150 - 0{,}070)/1 = 0{,}080\); para a raiz, \(g(t_1) = (0{,}450 - 0{,}110)/4 = 0{,}085\); \(g(t_6) = 0{,}010\) e \(g(t_3) = 0{,}080\) não mudam. O mínimo é \(g(t_6) = 0{,}010 = \alpha_2\), e obtemos \(T_2\) com 4 folhas e \(R(T_2) = 0{,}120\).
Iteração 3. Agora \(g(t_3) = (0{,}200 - 0{,}050)/1 = 0{,}150\), \(g(t_2) = 0{,}080\) e \(g(t_1) = (0{,}450 - 0{,}120)/3 = 0{,}110\). O elo mais fraco é \(t_2\), com \(\alpha_3 = 0{,}080\), gerando \(T_3\) com 3 folhas (\(t_2\), \(t_6\), \(t_7\)) e \(R(T_3) = 0{,}200\).
Iteração 4. Restam \(g(t_3) = 0{,}150\) e \(g(t_1) = (0{,}450 - 0{,}200)/2 = 0{,}125\). Poda-se a raiz com \(\alpha_4 = 0{,}125\), restando apenas o nó raiz \(T_4\).
Resumindo a sequência encaixada:
| Subárvore | Folhas \(\lvert T \rvert\) | \(R(T)\) | Ótima para \(\alpha \in\) |
|---|---|---|---|
| \(T_0\) | 6 | 0,105 | \([0;\ 0{,}005)\) |
| \(T_1\) | 5 | 0,110 | \([0{,}005;\ 0{,}010)\) |
| \(T_2\) | 4 | 0,120 | \([0{,}010;\ 0{,}080)\) |
| \(T_3\) | 3 | 0,200 | \([0{,}080;\ 0{,}125)\) |
| \(T_4\) (raiz) | 1 | 0,450 | \([0{,}125;\ \infty)\) |
Dois fatos merecem destaque. Primeiro, os valores \(\alpha_k\) são crescentes, como garante a teoria. Segundo, na iteração 4 a raiz foi podada antes de \(t_3\), embora \(t_3\) seja um nó mais profundo: o algoritmo não poda necessariamente “de baixo para cima”, mas sempre o ramo com menor redução de erro por folha. Podemos conferir, por exemplo, que para \(\alpha = 0{,}05\) a subárvore \(T_2\) é de fato a melhor: \(R_{0{,}05}(T_2) = 0{,}120 + 0{,}05 \times 4 = 0{,}320\), contra \(0{,}105 + 0{,}30 = 0{,}405\) para \(T_0\), \(0{,}110 + 0{,}25 = 0{,}360\) para \(T_1\), \(0{,}200 + 0{,}15 = 0{,}350\) para \(T_3\) e \(0{,}450 + 0{,}05 = 0{,}500\) para a raiz.
Uma árvore com \(M\) folhas pode ter um número exponencial de subárvores podadas. O teorema de Breiman et al. (1984) garante que basta considerar as \(K + 1\) árvores da sequência \(T_0 \succ T_1 \succ \cdots \succ T_K\), com \(K\) no máximo igual ao número de nós internos: para qualquer \(\alpha\), a subárvore ótima \(T_\alpha\) é um elemento dessa sequência. O custo de calcular a sequência é apenas polinomial no tamanho da árvore. É isso que torna viável a escolha de \(\alpha\) por validação cruzada.
11.9.4 Outras estratégias de pós-poda
- Poda por erro reduzido (reduced error pruning): separa-se um conjunto de validação; percorrendo os nós de baixo para cima, colapsa-se cada subárvore sempre que isso não aumentar o erro de validação. É simples, mas desperdiça dados quando \(n\) é pequeno.
- Poda pessimista do C4.5: não usa dados de validação. Em cada folha com \(n_t\) observações e \(e_t\) erros, substitui-se a taxa de erro observada pelo limite superior de um intervalo de confiança binomial (controlado pelo fator de confiança \(CF\), cujo padrão é 25%), que é tanto mais “pessimista” quanto menor \(n_t\). Uma subárvore é substituída por uma folha se o erro pessimista da folha não for maior que a soma dos erros pessimistas da subárvore. É uma heurística sem justificativa estatística rigorosa, mas funciona bem na prática.
- Critérios de penalização do tipo \(R(T) + \alpha|T|\) podem ser vistos como análogos do AIC e do BIC: o termo \(\alpha|T|\) é uma penalidade pelo número de parâmetros (folhas).
11.9.5 Escolha de \(\alpha\) por validação cruzada
O valor de \(\alpha\) é um hiperparâmetro e deve ser escolhido por validação cruzada com \(K\) partes (K-fold cross-validation): os dados de treinamento são divididos em \(K\) partes; para cada \(k\), cresce-se uma árvore com as outras \(K-1\) partes, calcula-se a sequência de subárvores podadas e mede-se o erro na parte \(k\) para cada \(\alpha\). O erro de validação cruzada é a média sobre as \(K\) partes, e escolhe-se o \(\hat{\alpha}\) que o minimiza. Por fim, a árvore é crescida com todos os dados de treinamento e podada em \(\hat{\alpha}\).
Uma variação muito usada é a regra de um erro padrão (1-SE rule) (Breiman et al. 1984): escolhe-se a menor árvore cujo erro de validação cruzada não exceda o erro mínimo mais um erro padrão. A justificativa é que, dentro da incerteza da estimativa, devemos preferir o modelo mais simples (princípio da parcimônia).
No rpart, o parâmetro cp é uma versão reescalonada de \(\alpha\): \(cp = \alpha / R(T_{\text{raiz}})\), em que \(R(T_{\text{raiz}})\) é o erro da árvore com apenas a raiz. A tabela cptable traz, para cada valor de cp, o número de divisões, o erro relativo de treinamento (rel error), o erro de validação cruzada (xerror) e seu desvio padrão (xstd). No scikit-learn, o parâmetro equivalente é ccp_alpha.
11.10 Custos de Classificação, Pesos e Probabilidades nas Folhas
Até aqui supusemos, implicitamente, que todos os erros têm o mesmo custo. Em muitas aplicações isso é falso: deixar de diagnosticar uma doença (falso negativo) costuma ser muito mais grave que solicitar um exame desnecessário (falso positivo). As árvores incorporam custos de três formas complementares.
11.10.1 Regra de decisão com custos
Seja \(C(j \mid k) \geq 0\) o custo de predizer a classe \(j\) quando a verdadeira é \(k\), com \(C(k \mid k) = 0\). Em uma folha com proporções \(\hat{p}_{t1}, \ldots, \hat{p}_{tc}\), o custo esperado de rotular a folha como \(j\) é \(\sum_k \hat{p}_{tk}\, C(j \mid k)\), e a regra de Bayes escolhe \[ k^*(t) = \arg\min_{j} \sum_{k=1}^{c} \hat{p}_{tk}\, C(j \mid k). \] Com custos iguais, isso se reduz à classe majoritária. No caso binário, com \(C_{FN} = C(\text{neg} \mid \text{pos})\) e \(C_{FP} = C(\text{pos} \mid \text{neg})\), prediz-se positivo se \(\hat{p}\, C_{FN} > (1 - \hat{p})\, C_{FP}\), isto é, se \[ \hat{p} > \frac{C_{FP}}{C_{FP} + C_{FN}}. \]
Exemplo resolvido. Uma folha contém 30 pacientes doentes e 70 saudáveis (\(\hat{p} = 0{,}3\)). Com custos iguais, a folha seria rotulada “saudável”. Suponha agora \(C_{FN} = 5\) e \(C_{FP} = 1\). O custo esperado de rotular “saudável” é \(0{,}3 \times 5 = 1{,}5\); o de rotular “doente” é \(0{,}7 \times 1 = 0{,}7\). A folha passa a ser rotulada “doente”, o que é coerente com o limiar \(\frac{1}{1 + 5} = 1/6 \approx 0{,}167 < 0{,}3\).
11.10.2 Custos e pesos durante o crescimento
Mudar apenas o rótulo das folhas não altera a estrutura da árvore. Para que os custos influenciem também a escolha das divisões, o CART altera as probabilidades a priori das classes. No caso binário, usar custos \(C_{FN}\) e \(C_{FP}\) equivale a multiplicar o peso de cada observação positiva por \(C_{FN}\) e o de cada negativa por \(C_{FP}\), e então crescer a árvore normalmente com as proporções ponderadas (Breiman et al. 1984; Elkan 2001). Na prática:
- no
rpart, usa-separms = list(loss = L), em queLé a matriz de perdas (linhas = classe verdadeira, colunas = classe predita), ouparms = list(prior = c(...)), ou ainda pesos por observação com o argumentoweights; - no
scikit-learn, usa-seclass_weight(por exemplo,{0: 1, 1: 5}ou"balanced", que define pesos inversamente proporcionais às frequências das classes) ousample_weightno métodofit.
library(rpart)
# Classes de Kyphosis: absent (ausente) e present (presente).
# Errar um caso "present" (falso negativo) custa 5; um falso positivo custa 1.
perda <- matrix(c(0, 1,
                  5, 0), nrow = 2, byrow = TRUE)
arv_custo <- rpart(Kyphosis ~ Age + Number + Start, data = kyphosis,
                   method = "class", parms = list(loss = perda))

# Alternativa: pesos por observação
w <- ifelse(kyphosis$Kyphosis == "present", 4, 1)
arv_peso <- rpart(Kyphosis ~ ., data = kyphosis, weights = w, method = "class")
from sklearn.tree import DecisionTreeClassifier
# Erros na classe 1 pesam 5 vezes mais durante o crescimento e na rotulação
arv = DecisionTreeClassifier(class_weight={0: 1, 1: 5}, min_samples_leaf=5)11.10.3 Probabilidades nas folhas e correção de Laplace
As proporções \(\hat{p}_{tk}\) são estimativas de máxima verossimilhança, mas em folhas pequenas são muito ruidosas e tendem a ser extremas: uma folha com 3 observações, todas positivas, estima \(\hat{p} = 1\), o que é exagerado. Uma correção simples é a estimativa de Laplace (ou, mais geralmente, um estimador bayesiano com priori de Dirichlet): \[ \tilde{p}_{tk} = \frac{n_{tk} + 1}{n_t + c}. \] No exemplo, \(\tilde{p} = (3 + 1)/(3 + 2) = 0{,}8\). Essa correção não altera a classe predita (para custos iguais), mas melhora a calibração das probabilidades e, frequentemente, a área sob a curva ROC. Árvores muito profundas, com folhas quase puras, produzem probabilidades mal calibradas; por isso, quando probabilidades confiáveis são necessárias, convém usar folhas maiores, aplicar a correção acima, calibrar as probabilidades a posteriori ou recorrer aos métodos de conjunto do próximo capítulo.
11.11 Importância de Variáveis
Uma árvore permite medir quanto cada variável contribuiu para o modelo. A medida mais comum é a diminuição total da impureza: para cada variável \(j\), somamos os decréscimos de impureza ponderados pelo número de observações de todos os nós \(t\) em que \(j\) foi usada para dividir, \[
\operatorname{Imp}(j) = \sum_{t \,:\, v(t) = j} \frac{n_t}{n} \, \Delta Q(t),
\] em que \(v(t)\) é a variável usada no nó \(t\) e \(n_t\) é o número de observações no nó. Frequentemente normaliza-se \(\operatorname{Imp}(j)\) para que as importâncias somem 1 (como no atributo feature_importances_ do scikit-learn). O rpart também contabiliza a contribuição das divisões substitutas, de modo que uma variável pode ter importância positiva mesmo sem aparecer na árvore final, refletindo o fenômeno de mascaramento entre variáveis correlacionadas.
Essa medida deve ser interpretada com cautela: ela é calculada nos dados de treinamento e tende a favorecer variáveis contínuas ou com muitos níveis, que oferecem mais pontos de corte candidatos (Strobl et al. 2007). No próximo capítulo veremos a importância por permutação, mais robusta.
11.12 Extensões: Inferência Condicional, Árvores Oblíquas e Regras
11.12.1 Árvores de inferência condicional
Vimos que a busca exaustiva por cortes produz um viés de seleção de variáveis: variáveis com mais pontos de corte candidatos (contínuas, ou categóricas com muitos níveis) têm mais chances de produzir, por acaso, um grande decréscimo de impureza, e são escolhidas com frequência excessiva mesmo quando não são informativas. Além disso, o critério de parada do CART não tem interpretação estatística: uma divisão é aceita se reduz a impureza, por menor e mais casual que seja essa redução.
As árvores de inferência condicional (conditional inference trees, ctree) de Hothorn, Hornik, e Zeileis (2006) resolvem os dois problemas separando a escolha da variável da escolha do ponto de corte, e usando testes de hipóteses na primeira etapa. Em cada nó:
- Teste global de independência. Para cada variável \(X_j\), testa-se \(H_0^{(j)}: Y \perp X_j\) por meio de uma estatística linear do tipo \(\mathbf{T}_j = \sum_{i \in t} g_j(x_{ij})\, h(y_i)^\top\), cuja distribuição sob \(H_0\) é obtida condicionalmente aos dados, por permutação (ou por sua aproximação assintótica). Isso fornece um valor-p \(P_j\) para cada variável, que já leva em conta o número de níveis ou de valores distintos.
- Seleção da variável e regra de parada. Corrige-se a multiplicidade (por exemplo, por Bonferroni, \(P_j^{\text{adj}} = \min(1, p\, P_j)\)). Se \(\min_j P_j^{\text{adj}} > \alpha\) (tipicamente \(\alpha = 0{,}05\)), não há evidência de associação entre \(Y\) e qualquer preditor, e o nó vira folha. Caso contrário, escolhe-se a variável de menor valor-p.
- Escolha do corte. Apenas na variável escolhida, busca-se o melhor ponto de corte (também via uma estatística de teste de duas amostras).
Como os valores-p estão em uma escala comum, a seleção de variáveis é aproximadamente não viesada: sob a hipótese nula global, cada variável tem a mesma probabilidade de ser escolhida, independentemente de sua escala ou do número de níveis. E, como o crescimento para quando não há associação significativa, a árvore não precisa de poda. O nível \(\alpha\) passa a funcionar como hiperparâmetro de complexidade, com interpretação estatística clara.
# install.packages("partykit")
library(partykit)
arv_ci <- ctree(Kyphosis ~ Age + Number + Start, data = rpart::kyphosis,
                control = ctree_control(alpha = 0.05, testtype = "Bonferroni"))
print(arv_ci)   # mostra as estatísticas e os valores-p de cada nó
plot(arv_ci)
O preço dessa abordagem é que o critério de parada pode ser conservador em amostras pequenas (gerando árvores rasas) e que a correção de Bonferroni perde poder quando há muitas variáveis. As florestas construídas a partir dessas árvores (cforest) estão na base da importância condicional por permutação, discutida no próximo capítulo.
11.12.2 Árvores oblíquas
Uma divisão univariada \(x_j \leq s\) produz uma fronteira paralela a um dos eixos. Se a fronteira verdadeira for diagonal, a árvore precisa aproximá-la por uma “escada” de muitas divisões. As árvores oblíquas (Murthy, Kasif, e Salzberg 1994) permitem divisões da forma \[ \mathbf{a}^\top \mathbf{x} = a_1 x_1 + \cdots + a_p x_p \leq s, \] de modo que cada nó corresponde a um hiperplano em posição arbitrária e as regiões passam a ser poliedros convexos. O CART original já previa divisões por combinações lineares, e há variantes que usam a direção discriminante de Fisher, a regressão logística ou projeções aleatórias em cada nó.
Exemplo numérico. Seja \(\mathbf{x}\) uniforme em \([0, 1]^2\) e \(y = \mathbb{I}\{x_1 > x_2\}\). Uma única divisão oblíqua, \(x_1 - x_2 \leq 0\), classifica perfeitamente todos os pontos. Já uma árvore univariada crescida até a pureza precisou, em nossa simulação com o scikit-learn, de 10 folhas com \(n = 100\) pontos de treino (acurácia de 91,9% em pontos novos), 38 folhas com \(n = 1\,000\) (98,1%) e 107 folhas com \(n = 10\,000\) (99,1%). O número de folhas cresce com \(n\) porque a escada precisa ficar cada vez mais fina para acompanhar a diagonal.
A busca pelo melhor hiperplano é muito mais custosa (o problema de encontrar o hiperplano ótimo em um nó é, ele próprio, NP-difícil em geral), e as divisões oblíquas são menos interpretáveis, já que envolvem várias variáveis simultaneamente. Uma alternativa prática, quando se suspeita de uma relação linear, é criar manualmente variáveis derivadas (como \(x_1 - x_2\) ou razões entre variáveis) antes de ajustar uma árvore comum.
11.12.3 Extração e simplificação de regras
Cada caminho da raiz até uma folha define uma regra conjuntiva. Para a árvore do exemplo “jogar tênis”, obtemos cinco regras:
| Regra | Antecedente | Consequente | Cobertura | Confiança |
|---|---|---|---|---|
| R1 | Tempo = Ensolarado E Umidade = Alta | Não | 3/14 | 3/3 |
| R2 | Tempo = Ensolarado E Umidade = Normal | Sim | 2/14 | 2/2 |
| R3 | Tempo = Nublado | Sim | 4/14 | 4/4 |
| R4 | Tempo = Chuvoso E Vento = Fraco | Sim | 3/14 | 3/3 |
| R5 | Tempo = Chuvoso E Vento = Forte | Não | 2/14 | 2/2 |
A cobertura é a fração de observações que satisfazem o antecedente e a confiança é a fração dessas que pertencem à classe do consequente. As regras extraídas de uma árvore são mutuamente exclusivas e exaustivas: cada observação satisfaz exatamente uma delas.
O C4.5 vai além com o procedimento conhecido como C4.5rules (Quinlan 1993): (i) para cada regra, remove condições do antecedente sempre que isso não piorar uma estimativa pessimista de seu erro; (ii) descarta regras redundantes; e (iii) ordena as regras resultantes por classe, com uma classe padrão para os casos não cobertos. Após a simplificação, as regras deixam de ser mutuamente exclusivas, mas tornam-se mais curtas e, muitas vezes, mais precisas que a árvore original. No rpart, rpart.plot::rpart.rules() lista as regras de uma árvore ajustada; no scikit-learn, export_text() produz uma representação textual equivalente.
11.13 Vantagens e Desvantagens
Vantagens:
- Interpretabilidade: árvores pequenas são facilmente visualizadas e explicadas para pessoas sem formação técnica; podem ser convertidas em regras.
- Pouco pré-processamento: dispensam normalização, são invariantes a transformações monótonas e lidam com variáveis numéricas e categóricas.
- Robustez a outliers nos preditores: como só a ordem dos valores importa, valores extremos de \(x_j\) têm pouco efeito.
- Captura de interações e não linearidades: a estrutura hierárquica modela naturalmente interações entre variáveis.
- Seleção automática de variáveis e tratamento de valores ausentes (divisões substitutas).
- Rapidez de treinamento e predição: a predição custa \(O(\text{profundidade})\).
Desvantagens:
- Instabilidade / alta variância: pequenas perturbações nos dados de treinamento podem mudar a primeira divisão e, com ela, toda a árvore. Como a estrutura é hierárquica, um erro no topo se propaga para todos os nós abaixo.
- Fronteiras em degraus: como as regiões são retângulos alinhados aos eixos, uma fronteira de decisão diagonal simples (por exemplo, \(x_1 > x_2\)) exige muitas divisões para ser aproximada.
- Desempenho preditivo modesto: uma árvore isolada costuma ser superada por outros métodos.
- Otimização gulosa: não há garantia de encontrar a melhor árvore global.
- Viés em importâncias e divisões a favor de variáveis com muitos valores possíveis.
A instabilidade é justamente o ponto de partida dos métodos de conjunto: ao combinar muitas árvores treinadas em versões perturbadas dos dados, reduz-se drasticamente a variância. Esse é o tema do próximo capítulo, sobre Floresta Aleatória.
11.14 Implementação em R com rpart e rpart.plot
11.14.1 Reproduzindo o exemplo “jogar tênis”
library(rpart)
library(rpart.plot)

tenis <- data.frame(
  Tempo = c("Ensolarado","Ensolarado","Nublado","Chuvoso","Chuvoso","Chuvoso","Nublado",
            "Ensolarado","Ensolarado","Chuvoso","Ensolarado","Nublado","Nublado","Chuvoso"),
  Temperatura = c("Quente","Quente","Quente","Amena","Fria","Fria","Fria",
                  "Amena","Fria","Amena","Amena","Amena","Quente","Amena"),
  Umidade = c("Alta","Alta","Alta","Alta","Normal","Normal","Normal",
              "Alta","Normal","Normal","Normal","Alta","Normal","Alta"),
  Vento = c("Fraco","Forte","Fraco","Fraco","Fraco","Forte","Forte",
            "Fraco","Fraco","Fraco","Forte","Forte","Fraco","Forte"),
  Jogar = c("Não","Não","Sim","Sim","Sim","Não","Sim","Não","Sim","Sim","Sim","Sim","Sim","Não"),
  stringsAsFactors = TRUE
)

# Funções auxiliares para conferir os cálculos à mão
entropia <- function(y) {
  p <- prop.table(table(y))
  p <- p[p > 0]
  -sum(p * log2(p))
}

ganho_info <- function(dados, atributo, alvo = "Jogar") {
  h_pai <- entropia(dados[[alvo]])
  grupos <- split(dados[[alvo]], dados[[atributo]])
  h_cond <- sum(sapply(grupos, function(g) length(g) / nrow(dados) * entropia(g)))
  h_pai - h_cond
}

entropia(tenis$Jogar)
#> [1] 0.940286
sapply(c("Tempo", "Temperatura", "Umidade", "Vento"), ganho_info, dados = tenis)
#>      Tempo Temperatura    Umidade      Vento
#> 0.24674982  0.02922257 0.15183550 0.04812703

# Árvore com critério de entropia; minsplit e cp baixos para permitir
# crescer a árvore completa em um conjunto tão pequeno
arv_tenis <- rpart(Jogar ~ ., data = tenis, method = "class",
                   parms = list(split = "information"),
                   control = rpart.control(minsplit = 2, minbucket = 1, cp = 0))
rpart.plot(arv_tenis, extra = 104)
Note que o rpart gera divisões binárias; assim, em vez de três ramos para Tempo, ele pode agrupar níveis (por exemplo, “Nublado” contra “Ensolarado ou Chuvoso”). A árvore resultante é logicamente equivalente, mas com outra forma.
11.14.2 Árvore completa, poda e avaliação no conjunto Iris
library(rpart)
library(rpart.plot)

set.seed(123)
idx    <- sample(seq_len(nrow(iris)), size = 0.7 * nrow(iris))
treino <- iris[idx, ]
teste  <- iris[-idx, ]

# 1) Cresce uma árvore grande (cp = 0) com validação cruzada de 10 partes
arv_grande <- rpart(Species ~ ., data = treino, method = "class",
                    parms = list(split = "gini"),
                    control = rpart.control(cp = 0, minsplit = 5, xval = 10))

printcp(arv_grande)   # tabela de custo-complexidade
plotcp(arv_grande)    # erro de validação cruzada versus cp

# 2) Escolha de cp: mínimo do xerror e regra de 1 erro padrão
tab      <- arv_grande$cptable
i_min    <- which.min(tab[, "xerror"])
cp_min   <- tab[i_min, "CP"]
limite   <- tab[i_min, "xerror"] + tab[i_min, "xstd"]
cp_1se   <- tab[which(tab[, "xerror"] <= limite)[1], "CP"]

arv_podada <- prune(arv_grande, cp = cp_1se)

# 3) Visualização
rpart.plot(arv_podada, type = 2, extra = 104, under = TRUE,
           main = "Árvore podada (regra 1-SE)")

# 4) Avaliação no teste
pred <- predict(arv_podada, newdata = teste, type = "class")
table(Predito = pred, Real = teste$Species)
mean(pred == teste$Species)   # acurácia

# Probabilidades estimadas (proporções nas folhas)
head(predict(arv_podada, newdata = teste, type = "prob"))

# 5) Importância das variáveis e regras
arv_podada$variable.importance
rpart.rules(arv_podada)
11.15 Implementação em Python com DecisionTreeClassifier
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, GridSearchCV, StratifiedKFold
from sklearn.tree import DecisionTreeClassifier, plot_tree, export_text
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix

# Dados: diagnóstico de câncer de mama (maligno x benigno), 30 variáveis
dados = load_breast_cancer()
X, y = dados.data, dados.target
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42)

# 1) Árvore sem restrições: tende a sobreajustar
arv_cheia = DecisionTreeClassifier(criterion="gini", random_state=42)
arv_cheia.fit(X_tr, y_tr)
print("Folhas:", arv_cheia.get_n_leaves(), "| Profundidade:", arv_cheia.get_depth())
print("Acurácia treino:", accuracy_score(y_tr, arv_cheia.predict(X_tr)))
print("Acurácia teste :", accuracy_score(y_te, arv_cheia.predict(X_te)))

# 2) Caminho de poda por custo-complexidade: valores críticos de alpha
caminho = arv_cheia.cost_complexity_pruning_path(X_tr, y_tr)
alphas = caminho.ccp_alphas[:-1]          # o último alpha corresponde só à raiz

# 3) Escolha de alpha por validação cruzada estratificada de 5 partes
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
busca = GridSearchCV(
    DecisionTreeClassifier(random_state=42),
    param_grid={"ccp_alpha": alphas, "criterion": ["gini", "entropy"]},
    cv=cv, scoring="accuracy")
busca.fit(X_tr, y_tr)
print("Melhores parâmetros:", busca.best_params_)

arv_podada = busca.best_estimator_
y_pred = arv_podada.predict(X_te)
print("Folhas após poda:", arv_podada.get_n_leaves())
print("Acurácia teste (podada):", accuracy_score(y_te, y_pred))
print(confusion_matrix(y_te, y_pred))
print(classification_report(y_te, y_pred, target_names=dados.target_names))

# 4) Visualização e regras em texto
plt.figure(figsize=(14, 7))
plot_tree(arv_podada, feature_names=dados.feature_names,
          class_names=dados.target_names, filled=True, rounded=True)
plt.show()
print(export_text(arv_podada, feature_names=list(dados.feature_names)))

# 5) Importância das variáveis (diminuição média da impureza)
imp = pd.Series(arv_podada.feature_importances_, index=dados.feature_names)
print(imp[imp > 0].sort_values(ascending=False))
O trecho a seguir ilustra a instabilidade das árvores: ajustamos árvores em diferentes amostras bootstrap do mesmo conjunto e verificamos qual variável é escolhida para a raiz.
from collections import Counter

rng = np.random.default_rng(0)
raizes, acuracias, predicoes = [], [], []
for b in range(200):
    i = rng.integers(0, len(y_tr), size=len(y_tr))   # amostra com reposição
    arv = DecisionTreeClassifier(random_state=0).fit(X_tr[i], y_tr[i])
    raizes.append(dados.feature_names[arv.tree_.feature[0]])
    acuracias.append(arv.score(X_te, y_te))
    predicoes.append(arv.predict(X_te))

print(Counter(raizes).most_common())
print("Acurácia: média = %.3f, desvio = %.3f, mín = %.3f, máx = %.3f"
      % (np.mean(acuracias), np.std(acuracias), np.min(acuracias), np.max(acuracias)))

P = np.array(predicoes)                            # 200 x n_teste
discordancia = (P.min(axis=0) != P.max(axis=0)).mean()
voto = (P.mean(axis=0) > 0.5).astype(int)          # voto majoritário das 200 árvores
print("Fração de pontos de teste com alguma discordância:", discordancia)
print("Acurácia do voto majoritário:", (voto == y_te).mean())
Em geral, mais de uma variável aparece como raiz entre as 200 árvores, e a estrutura abaixo da raiz varia ainda mais, evidenciando a alta variância do método.
Em nossa execução do código acima (com scikit-learn 1.4), cinco variáveis diferentes ocuparam a raiz: worst concave points (64 vezes), worst perimeter (61), worst radius (38), worst area (22) e mean concave points (15). A acurácia das 200 árvores no mesmo conjunto de teste teve média 0,918 e desvio padrão 0,019, variando de 0,871 a 0,965 — uma amplitude de quase 10 pontos percentuais causada apenas por reamostrar os dados de treino. Em 45,6% dos pontos de teste, ao menos duas árvores discordaram da classe predita. Por fim, o voto majoritário das 200 árvores atingiu acurácia de 0,936, superior à média das árvores individuais: é exatamente a ideia do bagging, que formalizaremos no próximo capítulo. (Os valores exatos podem mudar ligeiramente com a versão da biblioteca.)
A razão teórica da instabilidade é a natureza descontínua do procedimento guloso: quando duas divisões candidatas têm decréscimos de impureza próximos, uma pequena perturbação nos dados troca a vencedora; como todas as divisões seguintes são condicionais à primeira, a troca altera a árvore inteira. Em termos da decomposição viés-variância, a variância de \(\hat{f}(\mathbf{x})\) é alta exatamente nas regiões próximas às fronteiras de decisão.
11.16 Resumo do Capítulo
- Uma árvore de decisão particiona o espaço de atributos em regiões retangulares \(R_1, \ldots, R_M\) e atribui a cada região a classe majoritária; as proporções nas folhas estimam \(P(Y = k \mid \mathbf{X} = \mathbf{x})\).
- Como encontrar a árvore ótima é NP-completo, os algoritmos usam partição recursiva binária gulosa, escolhendo a divisão que maximiza o decréscimo de impureza.
- ID3 usa ganho de informação e divisões multivias; C4.5 usa razão de ganho e trata variáveis contínuas; CART usa Gini, divisões binárias e poda por custo-complexidade.
- Entropia, Gini e erro de classificação são medidas de impureza; as duas primeiras são estritamente côncavas e preferíveis para o crescimento da árvore.
- Variáveis contínuas geram no máximo \(r-1\) cortes candidatos; categóricas com \(q\) níveis geram \(2^{q-1}-1\) partições binárias, que se reduzem a \(q-1\) no caso de resposta binária.
- A pós-poda por custo-complexidade, \(R_\alpha(T) = R(T) + \alpha|T|\), gera uma sequência encaixada de subárvores; \(\alpha\) é escolhido por validação cruzada, frequentemente com a regra de 1 erro padrão.
- A entropia é a única medida de incerteza que satisfaz os axiomas de Shannon; o ganho de informação é a informação mútua \(I(Y; A) = D_{KL}(P_{AY} \,\|\, P_A \otimes P_Y) \geq 0\), e \(2 n_t \ln 2 \cdot GI\) é a estatística \(G\) do teste de independência, o que quantifica o viés a favor de atributos com muitos níveis.
- Pela concavidade (desigualdade de Jensen), nenhuma divisão aumenta a entropia ou o Gini ponderados; o erro de classificação, por não ser estritamente côncavo, pode não detectar divisões úteis. O decréscimo de Gini equivale ao decréscimo da soma de quadrados das indicadoras de classe.
- Encontrar a melhor divisão custa \(O(p\, n_t \log n_t)\) por nó; a árvore ótima global é um problema NP-completo.
- Divisões substitutas tratam valores ausentes e são avaliadas pela concordância ajustada; custos de erro desiguais entram pela regra de Bayes nas folhas e por pesos/prioris no crescimento.
- O algoritmo do elo mais fraco gera uma sequência finita de subárvores que contém a subárvore ótima para todo \(\alpha\).
- Árvores de inferência condicional usam testes de permutação para escolher variáveis sem viés e para decidir quando parar; árvores oblíquas usam hiperplanos arbitrários; caminhos da raiz às folhas podem ser convertidos em regras.
- Árvores são interpretáveis e exigem pouco pré-processamento, mas são instáveis e têm alta variância — limitação que motiva os métodos de conjunto.
11.17 Exercícios Propostos
- Mostre que, para \(c\) classes, a entropia é máxima quando \(p_k = 1/c\) para todo \(k\) e que seu valor máximo é \(\log_2 c\). (Dica: use multiplicadores de Lagrange com a restrição \(\sum_k p_k = 1\).)
- Mostre que o índice de Gini para \(c\) classes tem valor máximo \(1 - 1/c\). Qual é esse valor para \(c = 3\)?
- Um nó contém 60 observações da classe A e 40 da classe B. Calcule a entropia, o índice de Gini e o erro de classificação do nó.
- Para o nó do exercício anterior, considere a divisão em dois filhos: (A = 50, B = 10) e (A = 10, B = 30). Calcule o ganho de informação e o decréscimo de Gini dessa divisão.
- No exemplo “jogar tênis”, suponha que adicionamos uma coluna
Diacom os identificadores D1, …, D14. Calcule o ganho de informação e a razão de ganho desse atributo e compare com os de Tempo. O que esse exercício ilustra? - Refaça o Passo 4 do exemplo “jogar tênis” para o ramo Ensolarado, calculando o ganho de informação de Temperatura, Umidade e Vento e confirmando que Umidade é a melhor escolha.
- Explique por que uma árvore de decisão é invariante a transformações monótonas crescentes das variáveis preditoras. Essa propriedade vale também para transformações não monótonas, como \(x \mapsto x^2\) quando \(x\) assume valores negativos e positivos?
- Quantas partições binárias distintas existem para uma variável categórica com 6 níveis? Explique como esse número é reduzido no caso de resposta binária.
- Considere uma árvore com um nó interno \(t\) tal que \(R(t) = 0{,}15\), cuja subárvore \(T_t\) tem 4 folhas e \(R(T_t) = 0{,}06\). Para quais valores de \(\alpha\) é preferível manter a subárvore? E colapsá-la?
- Construa um conjunto de dados bidimensional do tipo “ou exclusivo” (XOR) e mostre que nenhuma divisão isolada na raiz reduz o índice de Gini. Discuta as consequências para a pré-poda.
- (Prático, R) Ajuste uma árvore com
rpartao conjuntokyphosis(pacoterpart) e compare a árvore escolhida pelo mínimo dexerrorcom a escolhida pela regra 1-SE em termos de número de folhas e acurácia por validação cruzada. - (Prático, Python) Usando
load_wine()doscikit-learn, trace um gráfico da acurácia de treino e de teste em função deccp_alpha. Identifique as regiões de sobreajuste e de subajuste. - (Prático) Repita o experimento de instabilidade apresentado no capítulo, registrando também a acurácia no teste de cada árvore. Calcule a média e o desvio padrão das acurácias e discuta o resultado.
- Discuta por que a importância de variáveis baseada na diminuição de impureza pode ser enviesada a favor de variáveis com muitos valores distintos. Proponha um experimento simulado para evidenciar o fenômeno.
- Verifique o axioma de agrupamento para a distribuição \((0{,}5;\ 0{,}25;\ 0{,}25)\), calculando a entropia diretamente e pela decomposição em duas escolhas sucessivas.
- Mostre que \(D_{KL}(P \,\|\, Q) \neq D_{KL}(Q \,\|\, P)\) em geral, usando \(P = (0{,}9;\ 0{,}1)\) e \(Q = (0{,}5;\ 0{,}5)\).
- Demonstre que \(I(Y; A) \leq \min\{H(Y), H(A)\}\) e conclua que \(GI(S, A) \leq H(S)\). Quando vale a igualdade \(GI(S, A) = H(S)\)?
- Um nó tem 80 observações da classe A e 20 da B. Encontre uma divisão em dois filhos de 50 observações cada para a qual o decréscimo do erro de classificação seja zero, mas o decréscimo do Gini seja positivo. Calcule ambos.
- Mostre, para o caso binário com \(y \in \{0, 1\}\), que o Gini ponderado dos filhos é igual a \(2/n_t\) vezes a soma de quadrados dos resíduos de uma árvore de regressão com as mesmas folhas. Verifique numericamente com o exemplo de 8 observações da seção de variáveis contínuas.
- Usando a aproximação \(E[GI] \approx (q-1)(c-1)/(2 n_t \ln 2)\), calcule o ganho de informação esperado de um atributo irrelevante com 8 níveis em um nó com 200 observações e 3 classes. Compare com o ganho de um atributo binário verdadeiramente informativo cujo ganho populacional seja 0,02.
- No exemplo resolvido da sequência de podas, refaça os cálculos supondo que a folha \(t_9\) tivesse contagens \((10, 5)\) em vez de \((8, 7)\), ajustando \(t_8\) para \((2, 23)\). A ordem das podas muda?
- Uma folha tem 12 observações da classe positiva e 28 da negativa. Para quais razões \(C_{FN}/C_{FP}\) a folha deve ser rotulada como positiva?
- Na saída do
rpartpara os dadoskyphosis, uma substituta temagree = 0.79. Calcule sua concordância ajustada e interprete o resultado. - (Prático, R) Instale o pacote
partykite compare as árvores obtidas porrpartectreeem um conjunto de dados ao qual você adicionou uma variável de ruído categórica com 30 níveis. Qual dos métodos usa a variável de ruído com mais frequência? Repita a simulação 100 vezes. - (Prático, Python) Gere dados com \(y = \mathbb{I}\{x_1 + x_2 > 1\}\) e compare o número de folhas e a acurácia de uma árvore ajustada às variáveis originais com os de uma árvore que recebe também a variável derivada \(x_1 + x_2\).
11.18 Leituras Recomendadas
- Breiman et al. (1984) — a obra fundadora do CART, com a teoria da poda por custo-complexidade, divisões substitutas e importância de variáveis.
- Quinlan (1986) e Quinlan (1993) — os trabalhos originais do ID3 e do C4.5.
- James et al. (2013), Capítulo 8 — introdução acessível a árvores, com laboratórios em R.
- Hastie, Tibshirani, e Friedman (2009), Seção 9.2 — tratamento mais aprofundado de árvores, medidas de impureza e poda.
- Mitchell (1997), Capítulo 3 — apresentação clássica do ID3, com o exemplo “jogar tênis”.
- Shannon (1948) — artigo que introduziu a entropia na teoria da informação.
- Cover e Thomas (2006) — o texto de referência em teoria da informação, com entropia, divergência de Kullback–Leibler e informação mútua.
- Hothorn, Hornik, e Zeileis (2006) — artigo que propõe as árvores de inferência condicional e discute o viés de seleção de variáveis.
- Morgan e Sonquist (1963) — o trabalho pioneiro sobre o AID, ancestral das árvores de regressão.
- Murthy, Kasif, e Salzberg (1994) — sistema OC1 para indução de árvores oblíquas.
- Elkan (2001) — fundamentos da aprendizagem sensível a custos, incluindo a relação entre custos e pesos de classe.
- Hyafil e Rivest (1976) — demonstração de que a construção da árvore binária ótima é NP-completa.