8 Análise Exploratória de Dados com Python
A Análise Exploratória de Dados (AED) é essencial para compreender nossos dados antes de aplicar modelagem. Este capítulo apresenta as bibliotecas Pandas, Matplotlib e Seaborn aplicadas à AED e, sobretudo, a teoria estatística por trás de cada resumo que calculamos: medidas de posição, dispersão e forma, medidas de associação, tabelas de contingência, mecanismos de dados faltantes, detecção de outliers e transformações de variáveis. Ao final, percorremos um fluxo completo de AED sobre um conjunto de dados público.
8.1 O Papel da Análise Exploratória de Dados (AED)
A Análise Exploratória de Dados (AED) não é um processo com um conjunto de regras rígidas; mais do que qualquer coisa, é um “estado de espírito” investigativo proposto por John Tukey — que já defendia, em The Future of Data Analysis (Tukey 1962), uma análise de dados mais empírica e menos presa à matemática formal — e consolidado em seu livro Exploratory Data Analysis (Tukey 1977), sendo posteriormente incorporado aos processos de mineração de dados. Como ressaltam Schutt & O’Neil (Schutt e O’Neil 2013), antes de implementarmos algoritmos complexos de Machine Learning, é fundamental conhecer profundamente a base de dados.
Tukey contrapunha a análise exploratória à análise confirmatória. Na confirmatória (testes de hipóteses, intervalos de confiança), partimos de uma hipótese definida a priori e quantificamos a evidência dos dados contra ela. Na exploratória, deixamos os dados “falarem”: procuramos padrões, anomalias e estruturas que sugiram hipóteses e modelos. Em suas palavras, a análise exploratória é um “trabalho de detetive”, e a confirmatória, um “trabalho de juiz”. As duas são complementares — mas é preciso cautela: uma hipótese sugerida pelos dados não pode ser “confirmada” com os mesmos dados que a sugeriram.
Uma boa AED exige dois entendimentos essenciais: a Compreensão da Problemática (o problema de negócio a ser resolvido) e a Compreensão do Contexto (quem é o público e o que deve ser destacado). Em termos quantitativos, costumamos iniciar a AED por dois caminhos:
- Que tipo de variação ocorre dentro das minhas variáveis?
- Que tipo de covariação ocorre entre as minhas variáveis?
A AED nos permite, na prática:
- Identificar valores nulos ou faltantes (missing values) que podem quebrar os modelos.
- Compreender as distribuições de probabilidade de cada variável.
- Detectar a presença de anomalias ou dados discrepantes (outliers).
- Avaliar a correlação linear entre as variáveis de interesse.
- Validar hipóteses iniciais de negócio.
A esses objetivos podemos acrescentar: verificar a qualidade e a coerência dos dados (valores impossíveis, unidades trocadas, duplicatas, categorias grafadas de formas diferentes); avaliar as suposições de modelos posteriores (simetria, homogeneidade de variâncias, linearidade); e orientar decisões de pré-processamento (transformações, codificação de categorias, imputação), que serão retomadas no Capítulo de Aprendizado de Máquina e o Processo de Modelagem.
Em Python, a biblioteca padrão absoluta para manipulação estruturada de dados é o Pandas (McKinney 2022), construída sobre a base eficiente do NumPy. Para visualizações e plotagens, as ferramentas mais utilizadas são o Matplotlib (Hunter 2007) e seu wrapper de alto nível estatístico, o Seaborn (Waskom 2021). As visualizações em R com ggplot2, e a teoria por trás de histogramas, densidades e boxplots, foram estudadas no Capítulo de Visualização de Dados com ggplot2; aqui nos concentramos nos resumos numéricos e no fluxo de trabalho em Python.
8.2 O Conceito de Tidy Data (Dados Arrumados)
Antes de explorar, precisamos garantir que nossos dados estão em um formato tratável. Parafraseando Liev Tolstói, o estatístico Hadley Wickham afirma que “Conjuntos de dados arrumados são todos iguais, mas cada conjunto de dados bagunçado, é bagunçado de sua própria maneira” (Wickham 2014).
Para que um conjunto de dados seja considerado Tidy Data (Dados Tabulados Arrumados), ele deve seguir três regras inter-relacionadas:
- Cada variável deve ter sua própria coluna.
- Cada observação deve ter sua própria linha.
- Cada valor deve ter sua própria célula.
Uma vez que os dados estão estruturados dessa forma, o Pandas consegue explorá-los com extrema eficiência.
Os problemas mais comuns de dados “bagunçados”, segundo Wickham (2014), são: (i) cabeçalhos de colunas que são valores, e não nomes de variáveis (por exemplo, uma coluna por ano); (ii) várias variáveis armazenadas em uma única coluna (por exemplo, "M_25-34" codificando sexo e faixa etária); (iii) variáveis armazenadas tanto em linhas quanto em colunas; (iv) vários tipos de unidade observacional na mesma tabela; e (v) uma mesma unidade observacional espalhada por várias tabelas. Em Pandas, as operações melt() (largo → longo) e pivot()/pivot_table() (longo → largo) resolvem os casos mais frequentes:
import pandas as pd

largo = pd.DataFrame({
    "loja": ["Centro", "Boa Viagem"],
    "2023": [135, 160],
    "2024": [150, 155],
})

# Largo -> longo (tidy): uma linha por loja-ano
longo = largo.melt(id_vars="loja", var_name="ano", value_name="vendas")
print(longo)
#>          loja   ano  vendas
#> 0      Centro  2023     135
#> 1  Boa Viagem  2023     160
#> 2      Centro  2024     150
#> 3  Boa Viagem  2024     155

# Longo -> largo
print(longo.pivot(index="loja", columns="ano", values="vendas"))

# Separando uma coluna que codifica duas variáveis
d = pd.DataFrame({"grupo": ["M_25-34", "F_35-44"], "n": [10, 12]})
d[["sexo", "faixa"]] = d["grupo"].str.split("_", expand=True)
8.3 Tipos de Variáveis
A escolha de resumos numéricos e gráficos depende do tipo da variável. A classificação usual em Estatística distingue:
- Qualitativas (categóricas):
- Nominais: categorias sem ordem (espécie, ilha, sexo, cor);
- Ordinais: categorias com ordem natural, mas sem distância numérica definida (escolaridade, faixa de renda, qualidade do corte: Fair < Good < … < Ideal).
- Quantitativas (numéricas):
- Discretas: assumem valores em um conjunto enumerável, geralmente contagens (número de filhos, número de compras);
- Contínuas: assumem valores em um intervalo dos reais (peso, comprimento, tempo).
Uma classificação complementar, devida a Stevens (1946), organiza as escalas de mensuração em nominal, ordinal, intervalar e razão. Na escala intervalar (temperatura em graus Celsius), diferenças têm significado, mas o zero é arbitrário — não faz sentido dizer que 20 °C é “o dobro” de 10 °C. Na escala de razão (massa, renda), o zero é absoluto e razões têm significado. A escala determina quais operações são legítimas: a moda vale para todas; a mediana e os quantis exigem ao menos ordem; a média exige escala intervalar; o coeficiente de variação exige escala de razão.
No Pandas, os tipos (dtypes) não coincidem necessariamente com os tipos estatísticos: um código postal armazenado como inteiro é, estatisticamente, nominal. Convém declarar explicitamente as variáveis categóricas — inclusive a ordem das ordinais:
df = pd.DataFrame({
    "escolaridade": ["Médio", "Superior", "Fundamental", "Médio"],
    "cep": [50740, 50670, 50740, 52011],
})

df["cep"] = df["cep"].astype("category")   # nominal, apesar de numérico
df["escolaridade"] = pd.Categorical(
    df["escolaridade"],
    categories=["Fundamental", "Médio", "Superior"],
    ordered=True,
)
print(df["escolaridade"].min())   #> Fundamental  (a ordem é respeitada)
print(df.dtypes)
8.4 Fundamentos do Pandas: Series e DataFrames
O Pandas trabalha essencialmente com duas estruturas de dados primárias:
- Series: É uma estrutura de dados homogênea unidimensional (semelhante a um vetor de R) que pode ter um índice associado a cada elemento.
- DataFrame: É uma estrutura bidimensional heterogênea ordenada (semelhante a uma tabela SQL ou ao data frame do R) com linhas rotuladas e colunas indexadas.
Cada coluna de um DataFrame é uma Series, e todas compartilham o mesmo índice de linhas. O índice é o que permite ao Pandas alinhar dados automaticamente em operações entre Series. A seleção de dados é feita principalmente por:
df["col"]oudf[["col1", "col2"]]: seleção de colunas;df.loc[linhas, colunas]: seleção por rótulos (inclui o limite final em fatias);df.iloc[linhas, colunas]: seleção por posições inteiras (exclui o limite final, como em Python);df[condicao]: filtragem booleana (as condições são combinadas com&,|e~, sempre entre parênteses).
8.4.1 Operações Básicas de Exploração de Dados
Ao carregar um conjunto de dados, os primeiros passos padrão de AED incluem o uso de métodos estatísticos integrados do Pandas:
import pandas as pd

# Carregando dados a partir de um arquivo CSV
df = pd.read_csv("vendas.csv")

# Exibe as primeiras 5 linhas do DataFrame para inspeção visual rápida
print(df.head())

# Exibe informações estruturais: número de linhas, colunas, tipos de dados e memória usada
print(df.info())

# Exibe estatísticas descritivas rápidas (média, desvio padrão, mínimo, quartis e máximo)
print(df.describe())
Outros métodos indispensáveis no início de qualquer AED:
df.shape                          # (número de linhas, número de colunas)
df.dtypes                         # tipo de cada coluna
df.isna().sum()                   # número de faltantes por coluna
df.duplicated().sum()             # número de linhas duplicadas
df.nunique()                      # número de valores distintos por coluna
df["Regiao"].value_counts(normalize=True)   # frequências relativas de uma categórica
df.describe(include="object")     # resumo das colunas de texto (contagem, únicos, moda)
8.5 Medidas de Posição (Tendência Central)
Seja \(x_1, x_2, \dots, x_n\) uma amostra de uma variável quantitativa e \(x_{(1)} \le x_{(2)} \le \dots \le x_{(n)}\) a amostra ordenada (as estatísticas de ordem).
8.5.1 Média, Mediana e Moda
Média aritmética: \[\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i.\] É o ponto de equilíbrio dos dados: \(\sum_{i=1}^n (x_i - \bar{x}) = 0\). Além disso, \(\bar{x}\) é o valor \(c\) que minimiza a soma dos quadrados dos desvios \(\sum_i (x_i - c)^2\) (basta derivar em \(c\) e igualar a zero: \(-2\sum_i(x_i - c) = 0 \Rightarrow c = \bar{x}\)). Sua grande limitação é a sensibilidade a valores extremos: um único valor arbitrariamente grande pode levar a média a qualquer valor — dizemos que seu ponto de ruptura (breakdown point) é \(0\%\).
Mediana: \[\operatorname{Md} = \begin{cases} x_{((n+1)/2)}, & n \text{ ímpar},\\[4pt] \dfrac{x_{(n/2)} + x_{(n/2+1)}}{2}, & n \text{ par}. \end{cases}\] A mediana minimiza a soma dos desvios absolutos \(\sum_i |x_i - c|\) e é robusta: seu ponto de ruptura é \(50\%\), ou seja, é preciso contaminar metade da amostra para levá-la a valores arbitrários.
Moda: o valor (ou categoria) mais frequente. É a única medida de posição aplicável a variáveis nominais. Uma distribuição pode ser bimodal ou multimodal, o que frequentemente indica a mistura de subpopulações (por exemplo, espécies diferentes).
Média aparada (trimmed mean) a \(\alpha\%\): descarta os \(\alpha\%\) menores e os \(\alpha\%\) maiores valores e calcula a média dos restantes — um meio-termo entre a eficiência da média e a robustez da mediana (
scipy.stats.trim_mean(x, 0.1)).
Em distribuições simétricas, média e mediana coincidem (aproximadamente). Em distribuições assimétricas à direita (renda, preços, tempos de espera), geralmente média > mediana, pois a cauda longa “puxa” a média.
8.5.2 Quantis
O quantil de ordem \(p\) (\(0 < p < 1\)), \(Q(p)\), é um valor que deixa aproximadamente uma proporção \(p\) dos dados abaixo dele. Os quartis são \(Q_1 = Q(0{,}25)\), \(Q_2 = Q(0{,}5) = \operatorname{Md}\) e \(Q_3 = Q(0{,}75)\); os percentis correspondem a \(p = 0{,}01, 0{,}02, \dots\); os decis, a \(p = 0{,}1, 0{,}2, \dots\)
Para amostras finitas, há várias definições de quantil amostral — Hyndman e Fan (1996) catalogam nove! A mais comum (padrão do R, tipo 7, e do NumPy/Pandas, method="linear") usa interpolação linear entre estatísticas de ordem:
\[ h = (n-1)\,p + 1, \qquad Q(p) = x_{(\lfloor h \rfloor)} + (h - \lfloor h \rfloor)\left(x_{(\lfloor h \rfloor + 1)} - x_{(\lfloor h \rfloor)}\right). \]
Diferentes softwares (ou calculadoras) podem, portanto, fornecer quartis ligeiramente diferentes para os mesmos dados — sem que nenhum esteja “errado”.
8.6 Medidas de Dispersão
Duas amostras podem ter a mesma média e distribuições completamente diferentes. As medidas de dispersão quantificam a variabilidade dos dados.
- Amplitude: \(A = x_{(n)} - x_{(1)}\). Simples, mas depende apenas dos dois valores extremos.
- Variância amostral: \[s^2 = \frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{x})^2.\]
- Desvio padrão amostral: \(s = \sqrt{s^2}\), na mesma unidade dos dados.
- Coeficiente de variação: \(\mathrm{CV} = s / \bar{x}\) (geralmente em %), adimensional; permite comparar a variabilidade de variáveis em unidades ou escalas diferentes. Só faz sentido para variáveis em escala de razão com média positiva.
- Intervalo interquartil: \(\mathrm{IQR} = Q_3 - Q_1\), a amplitude dos 50% centrais dos dados; robusto.
- Desvio absoluto mediano (median absolute deviation, MAD): \[\mathrm{MAD} = \operatorname{Md}\big(|x_i - \operatorname{Md}(x)|\big).\] É a medida de dispersão mais robusta (ponto de ruptura de 50%). Para dados normais, \(\mathrm{MAD} \approx 0{,}6745\,\sigma\); por isso usa-se a versão escalada \(1{,}4826 \cdot \mathrm{MAD}\) como estimador robusto de \(\sigma\).
8.6.1 Por que dividir por \(n-1\)?
Sejam \(X_1, \dots, X_n\) variáveis aleatórias independentes com média \(\mu\) e variância \(\sigma^2\). Usando a identidade \(\sum_i (X_i - \bar{X})^2 = \sum_i (X_i - \mu)^2 - n(\bar{X} - \mu)^2\) e o fato de que \(\operatorname{Var}(\bar{X}) = \sigma^2/n\):
\[ \mathbb{E}\left[\sum_{i=1}^{n}(X_i - \bar{X})^2\right] = n\sigma^2 - n\cdot\frac{\sigma^2}{n} = (n-1)\,\sigma^2. \]
Logo, \(\mathbb{E}[s^2] = \sigma^2\): dividir por \(n-1\) torna \(s^2\) um estimador não viesado de \(\sigma^2\). Intuitivamente, os desvios são medidos em relação a \(\bar{X}\), que é calculado com os próprios dados e fica “mais perto” deles do que \(\mu\); perdemos um grau de liberdade, pois os desvios estão sujeitos à restrição \(\sum_i (X_i - \bar{X}) = 0\).
No Pandas, Series.var() e Series.std() usam \(n-1\) por padrão (ddof=1). No NumPy, np.var() e np.std() usam \(n\) por padrão (ddof=0). Para obter a versão amostral no NumPy, use np.std(x, ddof=1). No R, var() e sd() usam \(n-1\).
Considere as gorjetas (em reais) de \(n = 10\) mesas, já ordenadas: \(\{1, 2, 2, 3, 3, 3, 4, 5, 6, 11\}\).
- Média: \(\bar{x} = 40/10 = 4\). Mediana: \((3 + 3)/2 = 3\). Moda: \(3\). Como \(\bar{x} > \operatorname{Md}\), há indício de assimetria à direita (causada pelo 11).
- Desvios \(x_i - \bar{x}\): \(-3, -2, -2, -1, -1, -1, 0, 1, 2, 7\) (soma zero, como esperado). Quadrados: \(9, 4, 4, 1, 1, 1, 0, 1, 4, 49\), cuja soma é \(74\).
- Variância: \(s^2 = 74/9 \approx 8{,}22\); desvio padrão: \(s \approx 2{,}87\); CV \(\approx 2{,}87/4 \approx 71{,}7\%\).
- Quartis (tipo 7): \(Q_1\): \(h = 9 \times 0{,}25 + 1 = 3{,}25 \Rightarrow 2 + 0{,}25(3-2) = 2{,}25\); \(Q_3\): \(h = 7{,}75 \Rightarrow 4 + 0{,}75(5-4) = 4{,}75\). Assim, \(\mathrm{IQR} = 2{,}5\).
- MAD: desvios absolutos em relação à mediana 3, ordenados: \(0, 0, 0, 1, 1, 1, 2, 2, 3, 8\); a mediana deles é \((1+1)/2 = 1\). Logo \(\mathrm{MAD} = 1\) e \(1{,}4826\cdot\mathrm{MAD} \approx 1{,}48\).
Note como o valor 11 infla o desvio padrão (2,87) em relação às medidas robustas (IQR/1,349 \(\approx\) 1,85 e MAD escalado \(\approx\) 1,48).
import numpy as np
import pandas as pd
from scipy import stats

x = pd.Series([1, 2, 2, 3, 3, 3, 4, 5, 6, 11])

print(x.mean(), x.median(), x.mode().tolist())   #> 4.0 3.0 [3]
print(x.var(), x.std())                          #> 8.222... 2.867...
print(x.std() / x.mean())                        #> 0.7168... (CV)
print(x.quantile([0.25, 0.5, 0.75]).tolist())    #> [2.25, 3.0, 4.75]
print(stats.iqr(x))                              #> 2.5
print(stats.median_abs_deviation(x))             #> 1.0
print(stats.median_abs_deviation(x, scale="normal"))  #> 1.4826
print(stats.trim_mean(x, 0.1))                   #> 3.5 (média aparada a 10%)
8.6.2 Padronização e a Desigualdade de Chebyshev
O desvio padrão é a “régua natural” de uma distribuição. A padronização expressa cada valor em unidades de desvio padrão em relação à média,
\[ z_i = \frac{x_i - \bar{x}}{s}, \]
e os escores resultantes têm média 0 e desvio padrão 1. A demonstração é imediata: \(\bar{z} = \frac{1}{s}\cdot\frac{1}{n}\sum_i (x_i - \bar{x}) = 0\) e \(s_z^2 = \frac{1}{s^2}\cdot\frac{1}{n-1}\sum_i (x_i - \bar{x})^2 = s^2/s^2 = 1\). A padronização é uma transformação afim crescente; portanto, não altera a forma da distribuição (assimetria, curtose e correlações permanecem iguais), apenas sua localização e escala.
Mas quanto da distribuição está a até \(k\) desvios padrão da média? Sem nenhuma suposição sobre a forma da distribuição, a resposta é dada pela desigualdade de Chebyshev: se \(X\) tem média \(\mu\) e variância \(\sigma^2\) finitas, então, para todo \(k > 0\),
\[ P\big(\lvert X - \mu \rvert \ge k\sigma\big) \le \frac{1}{k^2}. \]
Demonstração. A desigualdade de Markov afirma que, para \(Y \ge 0\) e \(a > 0\), \(P(Y \ge a) \le \mathbb{E}[Y]/a\) (pois \(a\,\mathbf{1}(Y \ge a) \le Y\); tome a esperança dos dois lados). Aplicando-a a \(Y = (X - \mu)^2\) e \(a = k^2\sigma^2\):
\[ P\big(\lvert X - \mu\rvert \ge k\sigma\big) = P\big((X - \mu)^2 \ge k^2\sigma^2\big) \le \frac{\mathbb{E}[(X - \mu)^2]}{k^2\sigma^2} = \frac{1}{k^2}. \qquad \blacksquare \]
Assim, pelo menos 75% dos valores de qualquer distribuição estão a até 2 desvios padrão da média, e pelo menos 88,9% a até 3. A mesma desigualdade vale para a distribuição empírica de qualquer amostra (com \(\bar{x}\) e o desvio padrão calculado com denominador \(n\); como o desvio padrão com \(n - 1\) é maior, a afirmação continua válida para \(s\)). Para a normal, as proporções reais são muito maiores — a conhecida regra empírica 68–95–99,7:
| \(k\) | Chebyshev (qualquer distribuição) | Normal |
|---|---|---|
| 1 | \(\ge 0\%\) | 68,3% |
| 2 | \(\ge 75{,}0\%\) | 95,4% |
| 3 | \(\ge 88{,}9\%\) | 99,7% |
| 4 | \(\ge 93{,}8\%\) | 99,994% |
A desigualdade de Chebyshev é “pessimista” porque precisa valer para todas as distribuições, inclusive as mais patológicas; seu valor está justamente em não depender de suposições. Ela também explica por que o escore-z, sozinho, é um critério frágil para outliers em distribuições de cauda pesada: sem normalidade, \(\lvert z \rvert > 3\) pode ocorrer em até 11% dos dados.
Para as gorjetas, \(\bar{x} = 4\) e \(s \approx 2{,}87\). O intervalo \(\bar{x} \pm 2s\) é \([-1{,}73;\ 9{,}73]\), e contém 9 dos 10 valores (todos, exceto o 11), ou seja, 90% \(\ge 75\%\), como garante a desigualdade. Os escores padronizados vão de \(z = (1 - 4)/2{,}87 \approx -1{,}05\) a \(z = (11 - 4)/2{,}87 \approx 2{,}44\).
8.7 Estatística Robusta
Vimos que a média e o desvio padrão são sensíveis a valores extremos, enquanto a mediana, o IQR e o MAD não são. A estatística robusta formaliza essa noção e estuda estimadores que se comportam bem mesmo quando uma pequena parte dos dados está contaminada ou quando a distribuição se afasta do modelo suposto (Huber e Ronchetti 2009; Hampel 1974).
8.7.1 Ponto de Ruptura
O ponto de ruptura amostral (finite-sample breakdown point) de um estimador \(T\) na amostra \(\mathbf{x} = (x_1, \dots, x_n)\) é a menor fração de observações que, substituídas por valores arbitrários, conseguem levar o estimador a valores arbitrariamente grandes (em módulo):
\[ \varepsilon_n^*(T; \mathbf{x}) = \min\left\{\frac{m}{n} : \sup_{\tilde{\mathbf{x}}_m} \lvert T(\tilde{\mathbf{x}}_m)\rvert = \infty\right\}, \]
em que \(\tilde{\mathbf{x}}_m\) percorre todas as amostras obtidas substituindo \(m\) observações de \(\mathbf{x}\). O ponto de ruptura assintótico é o limite de \(\varepsilon_n^*\) quando \(n \to \infty\).
- Média: basta alterar uma observação, \(x_1 \to \infty\), para que \(\bar{x} \to \infty\). Logo \(\varepsilon_n^* = 1/n \to 0\).
- Mediana: é preciso deslocar mais da metade das observações para arrastá-la; \(\varepsilon_n^* = \lfloor (n+1)/2 \rfloor / n \to 1/2\), o máximo possível para um estimador de locação equivariante.
- Média aparada a \(\alpha\): como descarta a fração \(\alpha\) de cada cauda, só “rompe” quando mais de \(\alpha n\) valores são contaminados; seu ponto de ruptura é \(\alpha\). A média (\(\alpha = 0\)) e a mediana (\(\alpha \to 1/2\)) são os dois extremos dessa família.
- Desvio padrão: \(0\); IQR: \(25\%\); MAD: \(50\%\).
8.7.2 Função de Influência e Curva de Sensibilidade
O ponto de ruptura mede a robustez “global”. A função de influência de Hampel (1974) mede o efeito “local” de uma contaminação infinitesimal em um ponto \(x\). Sua versão empírica, a curva de sensibilidade, é fácil de calcular: fixamos uma amostra de \(n - 1\) valores, acrescentamos um valor \(x\) e observamos como o estimador varia com \(x\):
\[ SC_n(x) = n\,\big[T(x_1, \dots, x_{n-1}, x) - T(x_1, \dots, x_{n-1})\big]. \]
Para a média, \(SC_n(x) = x - \bar{x}_{n-1}\), uma reta ilimitada: uma única observação pode ter influência arbitrariamente grande. Para a mediana, a curva é limitada — a partir de certo ponto, aumentar \(x\) não muda mais nada. Estimadores com função de influência limitada são chamados de B-robustos.
Fixemos as nove gorjetas \(\{1, 2, 2, 3, 3, 3, 4, 5, 6\}\) (soma 29) e acrescentemos um décimo valor \(x\):
| \(x\) | Média | Mediana | Média aparada a 10% |
|---|---|---|---|
| 0 | 2,9 | 3,0 | 2,875 |
| 3 | 3,2 | 3,0 | 3,125 |
| 11 | 4,0 | 3,0 | 3,5 |
| 100 | 12,9 | 3,0 | 3,5 |
| 1000 | 102,9 | 3,0 | 3,5 |
A média cresce linearmente com \(x\): \((29 + x)/10\). A mediana não se altera, e a média aparada (que descarta o menor e o maior valor) estabiliza em \(28/8 = 3{,}5\) assim que \(x\) passa a ser o máximo. Com \(x = 1000\), o desvio padrão salta de 2,87 para cerca de 315, enquanto o MAD continua igual a 1 e o IQR, igual a 2,5.
A média winsorizada é uma alternativa à aparada: em vez de descartar os extremos, substitui-os pelos valores mais próximos que permanecem. Com 10% de winsorização, a amostra original vira \(\{2, 2, 2, 3, 3, 3, 4, 5, 6, 6\}\) e a média, \(36/10 = 3{,}6\) (scipy.stats.mstats.winsorize).
8.7.3 O Preço da Robustez: Eficiência
Se a mediana é tão robusta, por que não usá-la sempre? Porque, quando os dados são de fato normais, ela é menos eficiente que a média: sua variância assintótica é \(\frac{\pi}{2}\cdot\frac{\sigma^2}{n} \approx 1{,}571\,\frac{\sigma^2}{n}\), contra \(\frac{\sigma^2}{n}\) da média. A eficiência relativa assintótica da mediana em relação à média, sob normalidade, é \(2/\pi \approx 0{,}637\): a mediana precisa de cerca de 57% mais observações para atingir a mesma precisão. Em distribuições de caudas pesadas, porém, a situação se inverte (na distribuição de Laplace, a mediana é duas vezes mais eficiente que a média, e na de Cauchy a média nem sequer converge). Estimadores como a média aparada a 10%–20% e os M-estimadores de Huber (Huber e Ronchetti 2009) oferecem um bom compromisso: perdem pouca eficiência sob normalidade e ganham muita robustez sob contaminação.
Por que o fator 1,4826? Se \(X \sim N(\mu, \sigma^2)\), a mediana de \(\lvert X - \mu\rvert\) é o valor \(c\) tal que \(P(\lvert X - \mu\rvert \le c) = 1/2\), isto é, \(P(\lvert Z \rvert \le c/\sigma) = 1/2\), ou \(\Phi(c/\sigma) = 3/4\). Logo \(c = \Phi^{-1}(0{,}75)\,\sigma \approx 0{,}6745\,\sigma\), e \(\mathrm{MAD}/0{,}6745 \approx 1{,}4826\,\mathrm{MAD}\) é um estimador consistente de \(\sigma\) sob normalidade. Do mesmo modo, \(\mathrm{IQR}/1{,}349\) é consistente para \(\sigma\), pois \(\mathrm{IQR} = 2 \times 0{,}6745\,\sigma\) na normal.
8.8 Medidas de Forma: Assimetria e Curtose
Definindo os momentos centrais amostrais \(m_k = \frac{1}{n}\sum_{i=1}^n (x_i - \bar{x})^k\), temos:
Coeficiente de assimetria (skewness): \[g_1 = \frac{m_3}{m_2^{3/2}}.\] \(g_1 \approx 0\) indica simetria; \(g_1 > 0\), assimetria à direita (cauda longa para valores altos); \(g_1 < 0\), assimetria à esquerda. O cubo preserva o sinal dos desvios, de modo que desvios grandes positivos dominam a soma quando a cauda direita é longa.
Coeficiente de curtose (kurtosis): \[b_2 = \frac{m_4}{m_2^{2}}, \qquad \text{curtose em excesso: } g_2 = b_2 - 3.\] Para a distribuição normal, \(b_2 = 3\) (excesso zero). Distribuições com \(g_2 > 0\) (leptocúrticas, como a \(t\) de Student) têm caudas mais pesadas, isto é, maior propensão a valores extremos; com \(g_2 < 0\) (platicúrticas, como a uniforme), caudas mais leves. Ao contrário da crença popular, a curtose mede essencialmente o peso das caudas, e não o “achatamento do pico”.
Os softwares costumam aplicar correções de viés. O Pandas (.skew(), .kurt()) usa as versões ajustadas
\[ G_1 = \frac{\sqrt{n(n-1)}}{n-2}\,g_1, \qquad G_2 = \frac{n-1}{(n-2)(n-3)}\left[(n+1)\,g_2 + 6\right], \]
enquanto scipy.stats.skew() e scipy.stats.kurtosis() retornam \(g_1\) e \(g_2\) por padrão (bias=True).
Para as gorjetas \(\{1, 2, 2, 3, 3, 3, 4, 5, 6, 11\}\): \(m_2 = 74/10 = 7{,}4\). Os cubos dos desvios são \(-27, -8, -8, -1, -1, -1, 0, 1, 8, 343\), com soma \(306\), logo \(m_3 = 30{,}6\) e
\[g_1 = \frac{30{,}6}{7{,}4^{3/2}} = \frac{30{,}6}{20{,}13} \approx 1{,}52.\]
As quartas potências somam \(81 + 16 + 16 + 1 + 1 + 1 + 0 + 1 + 16 + 2401 = 2534\), logo \(m_4 = 253{,}4\), \(b_2 = 253{,}4 / 7{,}4^2 \approx 4{,}63\) e \(g_2 \approx 1{,}63\). A amostra é assimétrica à direita e tem cauda mais pesada que a normal — ambos efeitos do valor 11. As versões ajustadas do Pandas são \(G_1 \approx 1{,}80\) e \(G_2 \approx 3{,}84\).
8.8.1 Momentos Populacionais e Amostrais
Os coeficientes acima são versões amostrais de quantidades populacionais. Para uma variável aleatória \(X\) com média \(\mu\), o \(k\)-ésimo momento central é \(\mu_k = \mathbb{E}[(X - \mu)^k]\), e definem-se a assimetria e a curtose em excesso populacionais
\[ \gamma_1 = \frac{\mu_3}{\sigma^3}, \qquad \gamma_2 = \frac{\mu_4}{\sigma^4} - 3. \]
Alguns valores de referência ajudam a calibrar a intuição:
| Distribuição | \(\gamma_1\) | \(\gamma_2\) |
|---|---|---|
| Normal | 0 | 0 |
| Uniforme | 0 | \(-1{,}2\) |
| Exponencial | 2 | 6 |
| \(t\) de Student com \(\nu > 4\) graus de liberdade | 0 | \(6/(\nu - 4)\) |
| Laplace (dupla exponencial) | 0 | 3 |
Os momentos centrais amostrais podem ser calculados a partir dos momentos brutos \(m'_k = \frac{1}{n}\sum_i x_i^k\) expandindo o binômio. Por exemplo,
\[ m_2 = m'_2 - (m'_1)^2, \qquad m_3 = m'_3 - 3\,m'_1 m'_2 + 2\,(m'_1)^3. \]
Nas gorjetas, \(\sum x_i^2 = 234\) e \(\sum x_i^3 = 1834\), logo \(m'_2 = 23{,}4\), \(m'_3 = 183{,}4\), e \(m_2 = 23{,}4 - 4^2 = 7{,}4\) e \(m_3 = 183{,}4 - 3 \times 4 \times 23{,}4 + 2 \times 4^3 = 30{,}6\), como antes. (Numericamente, porém, essas fórmulas “de uma passada” sofrem de cancelamento catastrófico quando a média é grande em relação ao desvio padrão; bibliotecas como o NumPy calculam os desvios em relação à média primeiro.)
Viés dos estimadores de forma. Assim como \(m_2\) é viesado para \(\sigma^2\) (\(\mathbb{E}[m_2] = \frac{n-1}{n}\sigma^2\)), os coeficientes \(g_1\) e \(g_2\) são viesados para \(\gamma_1\) e \(\gamma_2\), especialmente em amostras pequenas. As versões \(G_1\) e \(G_2\) do Pandas são construídas a partir de razões de estimadores não viesados dos cumulantes (\(k\)-estatísticas) e reduzem o viés em amostras pequenas (embora uma razão de estimadores não viesados não seja, em geral, não viesada); Joanes e Gill (1998) comparam as diversas versões e mostram que nenhuma domina as demais para todas as distribuições. Além disso, mesmo sem viés, esses coeficientes são muito variáveis: sob normalidade, seus erros padrão são aproximadamente
\[ \mathrm{EP}(g_1) \approx \sqrt{6/n}, \qquad \mathrm{EP}(g_2) \approx \sqrt{24/n}. \]
Com \(n = 30\), por exemplo, \(\mathrm{EP}(g_1) \approx 0{,}45\): um coeficiente de assimetria de 0,5 calculado em 30 observações é perfeitamente compatível com uma distribuição simétrica. Combinando as duas estatísticas, o teste de Jarque–Bera usa
\[ JB = \frac{n}{6}\left(g_1^2 + \frac{g_2^2}{4}\right) \;\approx\; \chi^2_2 \text{ sob normalidade (para } n \text{ grande).} \]
Uma medida robusta de assimetria. Como \(g_1\) depende do cubo dos desvios, ele é extremamente sensível a outliers (seu ponto de ruptura é zero). O coeficiente de assimetria de Bowley (ou dos quartis) usa apenas quartis:
\[ \mathrm{AQ} = \frac{(Q_3 - \operatorname{Md}) - (\operatorname{Md} - Q_1)}{Q_3 - Q_1} = \frac{Q_3 + Q_1 - 2\operatorname{Md}}{Q_3 - Q_1} \in [-1, 1]. \]
Ele vale zero quando a mediana está no centro da caixa do boxplot e é positivo quando a “metade de cima” da caixa é mais longa.
Com \(n = 10\), \(g_1 \approx 1{,}520\) e \(g_2 \approx 1{,}627\):
\[ JB = \frac{10}{6}\left(1{,}520^2 + \frac{1{,}627^2}{4}\right) = \frac{10}{6}\,(2{,}311 + 0{,}662) \approx 4{,}95, \]
com valor-p \(P(\chi^2_2 > 4{,}95) = e^{-4{,}95/2} \approx 0{,}084\). A aproximação qui-quadrado é ruim para \(n = 10\), mas o resultado ilustra a baixa potência dos testes de forma em amostras pequenas: mesmo com o valor 11 claramente destacado, não rejeitamos a normalidade ao nível de 5%. O erro padrão aproximado de \(g_1\) é \(\sqrt{6/10} \approx 0{,}77\).
A assimetria de Bowley é \(\mathrm{AQ} = (4{,}75 + 2{,}25 - 2 \times 3)/2{,}5 = 1/2{,}5 = 0{,}4\): positiva, mas bem mais moderada que \(g_1\), pois não é afetada pela magnitude do valor 11.
Em Python: stats.jarque_bera(x) retorna a estatística 4,955 e o valor-p 0,084.
8.9 Medidas de Associação entre Variáveis Quantitativas
8.9.1 Covariância e Correlação de Pearson
Para pares \((x_i, y_i)\), \(i = 1, \dots, n\), a covariância amostral é
\[ s_{xy} = \frac{1}{n-1}\sum_{i=1}^n (x_i - \bar{x})(y_i - \bar{y}). \]
O sinal indica a direção da associação linear (pontos nos quadrantes “alto-alto” e “baixo-baixo” em relação às médias contribuem positivamente), mas sua magnitude depende das unidades. Normalizando, obtemos o coeficiente de correlação de Pearson (Karl Pearson, 1895):
\[ r = \frac{s_{xy}}{s_x\, s_y} = \frac{\sum_{i}(x_i - \bar{x})(y_i - \bar{y})}{\sqrt{\sum_{i}(x_i - \bar{x})^2}\,\sqrt{\sum_{i}(y_i - \bar{y})^2}}. \]
Propriedades importantes:
- \(-1 \le r \le 1\), consequência da desigualdade de Cauchy–Schwarz aplicada aos vetores de desvios \(\mathbf{u} = (x_i - \bar{x})_i\) e \(\mathbf{v} = (y_i - \bar{y})_i\): \(r = \frac{\langle \mathbf{u}, \mathbf{v}\rangle}{\|\mathbf{u}\|\,\|\mathbf{v}\|} = \cos\theta\), o cosseno do ângulo entre os vetores de desvios;
- \(|r| = 1\) se, e somente se, os pontos estão exatamente sobre uma reta;
- \(r\) é invariante a transformações afins crescentes (\(x \mapsto a + bx\), \(b > 0\)) — não depende das unidades;
- \(r\) mede apenas associação linear: \(r = 0\) não implica independência (por exemplo, \(y = x^2\) com \(x\) simétrico em torno de zero dá \(r = 0\));
- \(r\) é sensível a outliers.
Uma interpretação útil: na regressão linear simples, \(r^2\) é a proporção da variância de \(y\) explicada pela reta ajustada (veja o coeficiente de determinação no Capítulo de Modelos de Regressão). Classificações verbais como “fraca” (\(|r| < 0{,}3\)), “moderada” (\(0{,}3 \le |r| < 0{,}7\)) e “forte” (\(|r| \ge 0{,}7\)) são convenções rudimentares e dependentes da área.
8.9.2 Correlação de Spearman
O coeficiente de Spearman (Spearman 1904), \(\rho_s\), é simplesmente a correlação de Pearson calculada sobre os postos (ranks) das observações. Ele mede associação monotônica (não necessariamente linear) e é robusto a outliers. Sem empates, vale a fórmula
\[ \rho_s = 1 - \frac{6\sum_{i=1}^n d_i^2}{n(n^2 - 1)}, \]
em que \(d_i\) é a diferença entre os postos de \(x_i\) e \(y_i\). Uma terceira medida baseada em postos é o \(\tau\) de Kendall, que compara pares concordantes e discordantes.
Sejam \(x = (1, 2, 3, 4, 5)\) e \(y = (1, 3, 2, 4, 20)\) — o último valor de \(y\) é um outlier.
Pearson. \(\bar{x} = 3\) e \(\bar{y} = 6\). Desvios: \(x - \bar{x} = (-2, -1, 0, 1, 2)\) e \(y - \bar{y} = (-5, -3, -4, -2, 14)\).
- \(\sum (x_i - \bar{x})(y_i - \bar{y}) = 10 + 3 + 0 - 2 + 28 = 39\);
- \(\sum (x_i - \bar{x})^2 = 10\) e \(\sum (y_i - \bar{y})^2 = 25 + 9 + 16 + 4 + 196 = 250\);
- \(r = 39 / \sqrt{10 \times 250} = 39/50 = 0{,}78\).
Spearman. Postos de \(x\): \((1, 2, 3, 4, 5)\); postos de \(y\): \((1, 3, 2, 4, 5)\). Diferenças: \(d = (0, -1, 1, 0, 0)\), logo \(\sum d_i^2 = 2\) e
\[\rho_s = 1 - \frac{6 \times 2}{5 \times 24} = 1 - 0{,}1 = 0{,}90.\]
O Spearman “enxerga” uma relação quase perfeitamente monotônica, enquanto o Pearson é distorcido pelo valor 20. Em Python: stats.pearsonr(x, y) e stats.spearmanr(x, y).
8.9.3 O \(\tau\) de Kendall
O coeficiente proposto por Kendall (1938) baseia-se na comparação de pares de observações. Dois pares \((x_i, y_i)\) e \((x_j, y_j)\) são concordantes se \((x_i - x_j)(y_i - y_j) > 0\) (as duas variáveis “andam juntas”) e discordantes se \((x_i - x_j)(y_i - y_j) < 0\). Sendo \(C\) e \(D\) os números de pares concordantes e discordantes entre os \(\binom{n}{2}\) pares possíveis, sem empates,
\[ \tau = \frac{C - D}{\binom{n}{2}} = \frac{2\,(C - D)}{n(n-1)} \in [-1, 1]. \]
O \(\tau\) tem uma interpretação probabilística direta: na população, \(\tau = P(\text{concordância}) - P(\text{discordância})\) para dois indivíduos sorteados ao acaso. Na presença de empates, usa-se a versão \(\tau_b\) (padrão em scipy.stats.kendalltau), que corrige o denominador. Sob independência, \(\mathbb{E}[\tau] = 0\) e \(\mathrm{Var}(\tau) = \frac{2(2n + 5)}{9n(n - 1)}\), e a distribuição de \(\tau\) aproxima-se rapidamente da normal, o que torna o teste baseado em \(\tau\) mais confiável que o de Spearman em amostras pequenas.
Para a distribuição normal bivariada com correlação \(\rho\), valem as relações \(\tau = \frac{2}{\pi}\arcsin\rho\) e \(\rho_s = \frac{6}{\pi}\arcsin\frac{\rho}{2}\). Assim, em geral \(\lvert\tau\rvert < \lvert\rho_s\rvert\) — os três coeficientes estão em escalas diferentes e não devem ser comparados diretamente. Por exemplo, \(\rho = 0{,}5\) corresponde a \(\tau \approx 0{,}33\) e \(\rho_s \approx 0{,}48\).
Retomando \(x = (1, 2, 3, 4, 5)\) e \(y = (1, 3, 2, 4, 20)\), há \(\binom{5}{2} = 10\) pares. Como \(x\) já está ordenado, um par \((i, j)\) com \(i < j\) é concordante se \(y_i < y_j\). O único par discordante é o das observações 2 e 3 (\(y_2 = 3 > y_3 = 2\)); os outros nove são concordantes. Logo
\[ \tau = \frac{9 - 1}{10} = 0{,}80. \]
Note que o valor 20 é tratado apenas como “maior que os demais”: o \(\tau\), como o Spearman, depende só da ordem. Sob independência, \(\mathrm{Var}(\tau) = 2 \times 15/(9 \times 5 \times 4) = 1/6\), logo o erro padrão é \(\approx 0{,}41\) — com \(n = 5\), nem uma concordância de 90% dos pares é conclusiva. O valor-p exato de stats.kendalltau(x, y) é 0,083.
8.9.4 Inferência para o Coeficiente de Correlação
Em uma AED, um \(r\) amostral é uma estimativa do coeficiente populacional \(\rho\), sujeita a erro amostral — e, para \(n\) pequeno, o erro é enorme. Suponha que os pares \((X_i, Y_i)\) sejam independentes e tenham distribuição normal bivariada.
Teste de \(H_0: \rho = 0\). Sob \(H_0\),
\[ T = \frac{r\sqrt{n - 2}}{\sqrt{1 - r^2}} \sim t_{n-2}. \]
Essa estatística é exatamente a estatística \(t\) do teste da inclinação na regressão linear simples, o que não é coincidência: \(\beta_1 = 0\) se, e somente se, \(\rho = 0\).
Intervalo de confiança: a transformação \(z\) de Fisher. A distribuição de \(r\) é assimétrica quando \(\rho \ne 0\) (está “presa” ao intervalo \([-1, 1]\)), e sua variância depende do próprio \(\rho\): aproximadamente \((1 - \rho^2)^2/n\). Fisher (1921) mostrou que a transformação
\[ z = \operatorname{artanh}(r) = \frac{1}{2}\ln\frac{1 + r}{1 - r} \]
é aproximadamente normal com média \(\operatorname{artanh}(\rho)\) e variância \(1/(n - 3)\), que não depende de \(\rho\) — trata-se de uma transformação estabilizadora da variância (pelo método delta, \(g'(\rho) = 1/(1 - \rho^2)\) cancela exatamente o fator \((1 - \rho^2)^2\)). Um intervalo de 95% para \(\rho\) é obtido calculando \(z \pm 1{,}96/\sqrt{n - 3}\) e aplicando \(\tanh\) aos extremos.
Amostra pequena. No exemplo anterior, \(r = 0{,}78\) com \(n = 5\). Então \(T = 0{,}78\sqrt{3}/\sqrt{1 - 0{,}6084} \approx 1{,}351/0{,}626 \approx 2{,}16\), com \(t_3\) e valor-p bilateral \(\approx 0{,}12\). Para o intervalo, \(z = \operatorname{artanh}(0{,}78) \approx 1{,}045\) e \(1{,}96/\sqrt{2} \approx 1{,}386\), logo \(z \in [-0{,}341;\ 2{,}431]\) e, aplicando \(\tanh\), \(\rho \in [-0{,}33;\ 0{,}98]\). Um intervalo tão largo diz que os dados são compatíveis com quase qualquer associação.
Amostra grande. Para os 342 pinguins com medidas, a correlação entre comprimento da nadadeira e massa corporal é \(r \approx 0{,}871\). Então \(z = \operatorname{artanh}(0{,}871) \approx 1{,}338\), o erro padrão é \(1/\sqrt{339} \approx 0{,}0543\) e \(z \pm 1{,}96 \times 0{,}0543 = [1{,}232;\ 1{,}445]\), de onde \(\rho \in [0{,}843;\ 0{,}895]\). A estatística \(T \approx 32{,}7\) torna o valor-p praticamente nulo.
import numpy as np
from scipy import stats

def ic_correlacao(r, n, conf=0.95):
    """IC para rho pela transformação z de Fisher."""
    z = np.arctanh(r)
    ep = 1 / np.sqrt(n - 3)
    q = stats.norm.ppf(1 - (1 - conf) / 2)
    return np.tanh(z - q * ep), np.tanh(z + q * ep)

print(ic_correlacao(0.78, 5))        #> (-0.328, 0.985)
print(ic_correlacao(0.8712, 342))    #> (0.843, 0.895)

# Nas versões recentes do SciPy, o resultado de pearsonr fornece o IC diretamente
res = stats.pearsonr([1, 2, 3, 4, 5], [1, 3, 2, 4, 20])
print(res.statistic, res.pvalue)               #> 0.78 0.1197
print(res.confidence_interval(confidence_level=0.95))Uma matriz de correlação com \(p\) variáveis contém \(p(p-1)/2\) coeficientes. Com \(p = 20\), são 190 pares; mesmo que todas as variáveis sejam independentes, esperamos cerca de \(0{,}05 \times 190 \approx 9{,}5\) correlações “significativas” ao nível de 5% apenas por acaso. Correlações descobertas varrendo uma matriz grande devem ser tratadas como hipóteses a confirmar em dados novos, e não como achados.
8.9.5 Correlação Não É Causalidade
Uma correlação forte entre \(X\) e \(Y\) pode surgir porque \(X\) causa \(Y\), porque \(Y\) causa \(X\), porque uma terceira variável \(Z\) (uma variável de confusão, ou confounder) influencia ambas, por seleção da amostra, ou simplesmente por acaso (especialmente quando muitas variáveis são comparadas). O número de afogamentos e as vendas de sorvete são correlacionados — ambos aumentam no verão —, mas proibir sorvetes não reduziria os afogamentos. Estabelecer causalidade exige experimentos aleatorizados ou métodos específicos de inferência causal; a AED apenas sugere hipóteses.
8.9.6 O Paradoxo de Simpson
O paradoxo de Simpson (Simpson 1951) ocorre quando uma associação observada em todos os subgrupos se inverte (ou desaparece) quando os subgrupos são agregados. Um exemplo clássico vem de um estudo sobre tratamentos de cálculos renais (Charig et al. 1986):
| Tamanho do cálculo | Tratamento A | Tratamento B |
|---|---|---|
| Pequeno | 81/87 (93%) | 234/270 (87%) |
| Grande | 192/263 (73%) | 55/80 (69%) |
| Total | 273/350 (78%) | 289/350 (83%) |
O tratamento A tem maior taxa de sucesso em ambos os grupos, mas o B parece melhor no agregado. A explicação: o tratamento A foi aplicado majoritariamente a casos graves (cálculos grandes), que têm menor taxa de sucesso independentemente do tratamento. O tamanho do cálculo é uma variável de confusão.
O mesmo fenômeno ocorre com correlações. No conjunto de dados dos pinguins de Palmer (Gorman, Williams, e Fraser 2014; Horst, Hill, e Gorman 2020), a correlação entre comprimento e profundidade do bico é negativa quando todas as espécies são consideradas juntas (\(r \approx -0{,}24\)), mas positiva dentro de cada espécie (\(r \approx 0{,}39\) para Adelie, \(0{,}65\) para Chinstrap e \(0{,}64\) para Gentoo). A espécie, ignorada na análise agregada, inverte a conclusão. Moral: sempre explore as relações também condicionalmente aos grupos relevantes.
8.9.7 O Quarteto de Anscombe
Anscombe (1973) construiu quatro conjuntos de dados com 11 pontos cada que possuem estatísticas resumo praticamente idênticas: \(\bar{x} = 9\), \(s_x^2 = 11\), \(\bar{y} \approx 7{,}50\), \(s_y^2 \approx 4{,}12\), \(r \approx 0{,}816\) e reta de regressão \(\hat{y} \approx 3{,}00 + 0{,}500\,x\). Contudo, seus gráficos de dispersão são radicalmente diferentes: uma relação linear com ruído; uma relação curvilínea perfeita; uma relação linear perfeita com um único outlier; e uma variável \(x\) constante exceto por um ponto influente. A lição — talvez a mais importante da AED — é que resumos numéricos nunca substituem a visualização dos dados.
import seaborn as sns

anscombe = sns.load_dataset("anscombe")

# Estatísticas praticamente idênticas...
print(anscombe.groupby("dataset").agg(
    media_x=("x", "mean"), var_x=("x", "var"),
    media_y=("y", "mean"), var_y=("y", "var"),
).round(2))
print(anscombe.groupby("dataset")[["x", "y"]].corr().round(3))

# ...mas gráficos completamente distintos
sns.lmplot(data=anscombe, x="x", y="y", col="dataset", col_wrap=2,
           ci=None, height=3)
8.10 Associação entre Variáveis Qualitativas: Tabelas de Contingência
Para duas variáveis categóricas \(A\) (com \(r\) níveis) e \(B\) (com \(c\) níveis), a tabela de contingência registra as frequências conjuntas \(n_{ij}\), com totais marginais \(n_{i\cdot} = \sum_j n_{ij}\) e \(n_{\cdot j} = \sum_i n_{ij}\). As proporções condicionais por linha, \(n_{ij}/n_{i\cdot}\), estimam \(P(B = j \mid A = i)\) e são o ponto de partida para avaliar associação: se \(A\) e \(B\) forem independentes, as distribuições condicionais de todas as linhas deveriam ser parecidas.
Sob independência, a frequência esperada da casela \((i, j)\) é \(E_{ij} = n_{i\cdot}\, n_{\cdot j}/n\), e a estatística qui-quadrado de Pearson compara observados e esperados:
\[ \chi^2 = \sum_{i=1}^{r}\sum_{j=1}^{c}\frac{(n_{ij} - E_{ij})^2}{E_{ij}}, \]
com distribuição aproximada \(\chi^2_{(r-1)(c-1)}\) sob a hipótese de independência (quando as frequências esperadas não são muito pequenas). Como \(\chi^2\) cresce com \(n\), uma medida de intensidade da associação é o V de Cramér:
\[ V = \sqrt{\frac{\chi^2}{n\,(\min(r, c) - 1)}} \in [0, 1]. \]
import seaborn as sns
from scipy import stats

penguins = sns.load_dataset("penguins")

tab = pd.crosstab(penguins["species"], penguins["island"], margins=True)
print(tab)
#> island     Biscoe  Dream  Torgersen  All
#> species
#> Adelie         44     56         52  152
#> Chinstrap       0     68          0   68
#> Gentoo        124      0          0  124
#> All           168    124         52  344

# Proporções condicionais por linha: P(ilha | espécie)
print(pd.crosstab(penguins["species"], penguins["island"], normalize="index").round(2))

obs = pd.crosstab(penguins["species"], penguins["island"])
chi2, p_valor, gl, esperados = stats.chi2_contingency(obs)
n = obs.to_numpy().sum()
v_cramer = np.sqrt(chi2 / (n * (min(obs.shape) - 1)))
print(f"chi2 = {chi2:.1f}, gl = {gl}, V de Cramér = {v_cramer:.2f}")
#> chi2 = 299.6, gl = 4, V de Cramér = 0.66
A associação é forte: os pinguins Gentoo só aparecem em Biscoe e os Chinstrap só em Dream. Todas as frequências esperadas são maiores que 10 (a menor é \(68 \times 52/344 \approx 10{,}3\)), de modo que a aproximação qui-quadrado é adequada; o valor-p, da ordem de \(10^{-63}\), é irrelevante diante de uma associação tão evidente na própria tabela.
8.10.1 Por que a Estatística Qui-Quadrado Funciona?
A estatística de Pearson (1900) pode ser motivada da seguinte forma. Sob independência, cada contagem \(n_{ij}\) é aproximadamente de Poisson com média \(E_{ij}\), e portanto com variância também \(E_{ij}\). O termo \((n_{ij} - E_{ij})/\sqrt{E_{ij}}\) é, então, um resíduo padronizado aproximadamente \(N(0, 1)\) para frequências grandes, e \(\chi^2\) é a soma dos quadrados desses resíduos. Os graus de liberdade não são \(rc\), mas \((r-1)(c-1)\): estimamos \(r - 1\) proporções marginais de linha e \(c - 1\) de coluna (as últimas são determinadas pelas demais), e \(rc - 1 - (r - 1) - (c - 1) = (r - 1)(c - 1)\).
Os próprios resíduos são valiosos na AED: os resíduos de Pearson \(e_{ij} = (n_{ij} - E_{ij})/\sqrt{E_{ij}}\) indicam quais caselas são responsáveis pela associação (valores com \(\lvert e_{ij}\rvert > 2\) merecem atenção) e podem ser exibidos em um mapa de calor com escala divergente.
A aproximação qui-quadrado exige frequências esperadas não muito pequenas; uma regra prática usual pede \(E_{ij} \ge 5\) em pelo menos 80% das caselas e nenhuma \(E_{ij} < 1\). Para tabelas \(2 \times 2\) pequenas, usa-se o teste exato de Fisher (stats.fisher_exact). Também no caso \(2 \times 2\), com caselas \(\begin{pmatrix} a & b\\ c & d\end{pmatrix}\), o V de Cramér coincide com o valor absoluto do coeficiente \(\phi\),
\[ \phi = \frac{ad - bc}{\sqrt{(a + b)(c + d)(a + c)(b + d)}}, \qquad \chi^2 = n\,\phi^2, \]
que é simplesmente a correlação de Pearson entre duas variáveis indicadoras 0/1. O V de Cramér generaliza essa ideia: como o valor máximo de \(\chi^2\) em uma tabela \(r \times c\) é \(n(\min(r, c) - 1)\), a divisão garante \(V \in [0, 1]\) (Cramér 1946).
Em uma turma de 100 estudantes, registrou-se o curso e a linguagem de programação preferida:
| Curso | R | Python | Outra | Total |
|---|---|---|---|---|
| Estatística | 30 | 15 | 5 | 50 |
| Computação | 10 | 35 | 5 | 50 |
| Total | 40 | 50 | 10 | 100 |
Proporções condicionais. Entre os estudantes de Estatística, 60% preferem R e 30% Python; entre os de Computação, 20% e 70%. As distribuições condicionais são bem diferentes, o que sugere associação.
Frequências esperadas. Como cada linha tem total 50 e \(n = 100\), \(E_{ij} = 50 \times n_{\cdot j}/100\): para R, \(50 \times 40/100 = 20\); para Python, \(25\); para Outra, \(5\) — iguais nas duas linhas.
Estatística. As contribuições \((n_{ij} - E_{ij})^2/E_{ij}\) são:
- R: \((30 - 20)^2/20 = 5\) e \((10 - 20)^2/20 = 5\);
- Python: \((15 - 25)^2/25 = 4\) e \((35 - 25)^2/25 = 4\);
- Outra: \(0\) e \(0\).
Logo \(\chi^2 = 5 + 5 + 4 + 4 = 18\), com \((2-1)(3-1) = 2\) graus de liberdade. Para 2 graus de liberdade, \(P(\chi^2_2 > x) = e^{-x/2}\), de modo que o valor-p é \(e^{-9} \approx 0{,}00012\).
Intensidade. \(V = \sqrt{18/(100 \times (2 - 1))} = \sqrt{0{,}18} \approx 0{,}42\): uma associação moderada. Os resíduos de Pearson das caselas de R são \(\pm 10/\sqrt{20} \approx \pm 2{,}24\) e os de Python, \(\pm 10/5 = \pm 2\): a associação está concentrada na troca R \(\leftrightarrow\) Python, e a categoria “Outra” não contribui.
import numpy as np
from scipy import stats

obs = np.array([[30, 15, 5],
                [10, 35, 5]])
chi2, p_valor, gl, esperados = stats.chi2_contingency(obs)
print(chi2, gl, p_valor)          #> 18.0 2 0.000123
print(esperados)                  #> [[20. 25.  5.] [20. 25.  5.]]

residuos = (obs - esperados) / np.sqrt(esperados)
print(residuos.round(2))          #> [[ 2.24 -2.  0.] [-2.24  2.  0.]]

v = np.sqrt(chi2 / (obs.sum() * (min(obs.shape) - 1)))
print(round(v, 3))                #> 0.424
print(stats.contingency.association(obs, method="cramer"))   # mesmo resultado
8.10.2 Informação Mútua
O coeficiente de correlação captura apenas dependência linear, e o \(\chi^2\) só se aplica a variáveis categóricas. Uma medida geral de dependência, vinda da teoria da informação (Shannon 1948; Cover e Thomas 2006), é a informação mútua. Para variáveis discretas com distribuição conjunta \(p(x, y)\) e marginais \(p(x)\), \(p(y)\),
\[ I(X; Y) = \sum_{x}\sum_{y} p(x, y)\,\log\frac{p(x, y)}{p(x)\,p(y)} = H(X) + H(Y) - H(X, Y), \]
em que \(H(X) = -\sum_x p(x)\log p(x)\) é a entropia. Interpretações e propriedades:
- \(I(X; Y) \ge 0\), com igualdade se, e somente se, \(X\) e \(Y\) são independentes (consequência da desigualdade de Jensen, pois \(I\) é a divergência de Kullback–Leibler entre \(p(x, y)\) e \(p(x)p(y)\)). Diferentemente de \(r = 0\), \(I = 0\) realmente significa independência.
- \(I(X; Y) = H(Y) - H(Y \mid X)\): é a redução da incerteza sobre \(Y\) quando se conhece \(X\). Com logaritmo na base 2, é medida em bits; com logaritmo natural, em nats.
- É simétrica e invariante a reparametrizações bijetoras de \(X\) e de \(Y\) (renomear categorias ou aplicar transformações monótonas não a altera).
- Para a normal bivariada com correlação \(\rho\), \(I(X; Y) = -\frac{1}{2}\ln(1 - \rho^2)\); para os pinguins, \(\rho \approx 0{,}871\) dá \(I \approx 0{,}71\) nats.
- Ligação com o qui-quadrado: substituindo as probabilidades pelas proporções amostrais, a estatística da razão de verossimilhanças para independência é \(G = 2\,n\,\hat{I}(X; Y)\) (com \(\hat{I}\) em nats), que, como o \(\chi^2\) de Pearson, tem distribuição aproximada \(\chi^2_{(r-1)(c-1)}\).
Na tabela anterior, as marginais são \(p(\text{curso}) = (0{,}5;\ 0{,}5)\) e \(p(\text{linguagem}) = (0{,}4;\ 0{,}5;\ 0{,}1)\). Em bits: \(H(\text{curso}) = 1\), \(H(\text{linguagem}) = -(0{,}4\log_2 0{,}4 + 0{,}5\log_2 0{,}5 + 0{,}1\log_2 0{,}1) \approx 1{,}361\) e, com as seis proporções conjuntas \((0{,}30;\ 0{,}15;\ 0{,}05;\ 0{,}10;\ 0{,}35;\ 0{,}05)\), \(H(\text{curso}, \text{linguagem}) \approx 2{,}226\). Logo
\[ I = 1 + 1{,}361 - 2{,}226 \approx 0{,}135 \text{ bits} \approx 0{,}0935 \text{ nats}. \]
Conhecer o curso reduz a incerteza sobre a linguagem preferida em cerca de 10% (\(0{,}135/1{,}361\)). A estatística \(G = 2 \times 100 \times 0{,}0935 \approx 18{,}7\) é próxima do \(\chi^2 = 18\) de Pearson, como esperado. Em Python, sklearn.metrics.mutual_info_score calcula \(\hat{I}\) em nats a partir de dois vetores de rótulos, e stats.chi2_contingency(obs, lambda_="log-likelihood") retorna \(G\).
Para variáveis contínuas, a informação mútua exige estimar densidades, o que é bem mais delicado; o Scikit-learn oferece estimadores baseados em vizinhos mais próximos (mutual_info_regression, mutual_info_classif), muito usados para ordenar variáveis por relevância antes da modelagem, pois detectam relações não lineares e não monotônicas que escapam a Pearson e Spearman.
8.11 Tratamento de Dados Faltantes e Outliers
No mundo real, os dados são frequentemente “sujos”, contendo campos nulos e erros de digitação.
8.11.1 Mecanismos de Dados Faltantes
Antes de decidir como tratar dados faltantes, é preciso refletir sobre por que eles faltam. Rubin (1976) formalizou três mecanismos. Seja \(\mathbf{Y} = (\mathbf{Y}_{obs}, \mathbf{Y}_{mis})\) o conjunto completo de dados, dividido em parte observada e parte faltante, e \(\mathbf{R}\) a matriz indicadora de observação (\(R_{ij} = 1\) se \(y_{ij}\) foi observado):
- MCAR (Missing Completely At Random — faltante completamente ao acaso): a probabilidade de faltar não depende de nenhum dado, observado ou não: \[P(\mathbf{R} \mid \mathbf{Y}_{obs}, \mathbf{Y}_{mis}) = P(\mathbf{R}).\] Exemplo: um tubo de ensaio que quebra acidentalmente. Os casos completos são uma subamostra aleatória dos dados.
- MAR (Missing At Random — faltante ao acaso): a probabilidade de faltar depende apenas de dados observados: \[P(\mathbf{R} \mid \mathbf{Y}_{obs}, \mathbf{Y}_{mis}) = P(\mathbf{R} \mid \mathbf{Y}_{obs}).\] Exemplo: em uma pesquisa, jovens deixam a renda em branco com mais frequência, e a idade é observada para todos.
- MNAR (Missing Not At Random — faltante não ao acaso): a probabilidade de faltar depende do próprio valor não observado. Exemplo: pessoas de renda muito alta tendem a não declarar a renda.
O mecanismo MCAR pode ser parcialmente investigado comparando quem tem e quem não tem o valor faltante em outras variáveis; já a distinção entre MAR e MNAR não pode ser verificada apenas com os dados observados e depende de conhecimento do domínio.
8.11.1.1 Por que o mecanismo importa: ignorabilidade
Suponha que a distribuição dos dados completos dependa de um parâmetro \(\theta\) (o que queremos estimar) e o mecanismo de ausência, de um parâmetro \(\psi\). A densidade do que de fato observamos — os valores observados e o padrão de ausência — é obtida integrando sobre os valores faltantes:
\[ f(\mathbf{Y}_{obs}, \mathbf{R} \mid \theta, \psi) = \int f(\mathbf{Y}_{obs}, \mathbf{Y}_{mis} \mid \theta)\; f(\mathbf{R} \mid \mathbf{Y}_{obs}, \mathbf{Y}_{mis}, \psi)\; d\mathbf{Y}_{mis}. \]
Sob MAR, o segundo fator não depende de \(\mathbf{Y}_{mis}\) e sai da integral:
\[ f(\mathbf{Y}_{obs}, \mathbf{R} \mid \theta, \psi) = f(\mathbf{R} \mid \mathbf{Y}_{obs}, \psi)\int f(\mathbf{Y}_{obs}, \mathbf{Y}_{mis} \mid \theta)\, d\mathbf{Y}_{mis} = f(\mathbf{R} \mid \mathbf{Y}_{obs}, \psi)\; f(\mathbf{Y}_{obs} \mid \theta). \]
Se, além disso, \(\theta\) e \(\psi\) não têm relação entre si, a verossimilhança de \(\theta\) é proporcional a \(f(\mathbf{Y}_{obs} \mid \theta)\): o mecanismo de ausência pode ser ignorado em inferências baseadas na verossimilhança (Rubin 1976; Little e Rubin 2019). Note a sutileza: “ignorável” não significa que podemos simplesmente descartar os casos incompletos — significa que um modelo que use todas as informações observadas (inclusive das variáveis que explicam a ausência) produz inferências válidas. Sob MNAR, a fatoração falha, e qualquer análise exige modelar explicitamente o mecanismo de ausência, com suposições que os dados não podem verificar.
Uma população tem 50% de jovens, com renda média de R$ 2.000, e 50% de idosos, com renda média de R$ 4.000; a média geral é, portanto, R$ 3.000. Suponha que 40% dos jovens e nenhum idoso deixem a renda em branco (MAR: a ausência depende apenas da idade, que é observada).
- Casos completos: restam 30% da população (jovens que responderam) e 50% (idosos). A média dos respondentes é \[\frac{0{,}30 \times 2000 + 0{,}50 \times 4000}{0{,}30 + 0{,}50} = \frac{600 + 2000}{0{,}80} = 3250,\] um viés de R$ 250 (8,3%), que não diminui com o aumento da amostra.
- Usando a informação observada: como, dentro de cada faixa etária, os respondentes são uma amostra aleatória (MAR), podemos estimar a média de cada faixa com os respondentes e ponderar pelas proporções populacionais, que são conhecidas: \(0{,}5 \times 2000 + 0{,}5 \times 4000 = 3000\), sem viés.
Esse é o princípio por trás da imputação por grupo, da ponderação pelo inverso da probabilidade de resposta e da imputação múltipla: condicionar nas variáveis que explicam a ausência.
8.11.2 Tratando Valores Nulos
Temos duas estratégias básicas quando detectamos valores nulos em colunas essenciais:
Eliminação: Remover as linhas ou colunas que possuem campos nulos. Adequado se os registros nulos forem uma porcentagem muito pequena do total de dados:
# Remove linhas onde qualquer coluna tenha valor nulo
df_limpo = df.dropna()
Imputação: Substituir os valores nulos por estimadores estatísticos robustos (como a média para distribuições normais ou a mediana se houver muitos outliers):
# Preenchendo valores faltantes da coluna Idade com a mediana das idades
df["Idade"] = df["Idade"].fillna(df["Idade"].median())
Essas estratégias têm consequências estatísticas que precisam ser conhecidas:
| Estratégia | Quando é razoável | Efeitos colaterais |
|---|---|---|
Análise de casos completos (dropna) |
MCAR e poucos faltantes | Perda de tamanho amostral; viés se o mecanismo não for MCAR |
| Imputação pela média/mediana | Poucos faltantes, análise exploratória | Subestima a variância e atenua correlações; cria um “pico” artificial |
| Imputação pela média/mediana do grupo | MAR, com o grupo explicando a ausência | Ainda subestima a variabilidade dentro do grupo |
| Indicador de ausência + imputação | Quando o fato de faltar é informativo | Aumenta o número de variáveis |
| Imputação por regressão ou k-NN | MAR, variáveis correlacionadas | Valores imputados “perfeitos demais”, subestimam incerteza |
| Imputação múltipla | MAR; inferência formal | Mais complexa; combina resultados de \(m\) bases imputadas (Little e Rubin 2019) |
Por que a imputação pela média reduz a variância? Se \(n_{obs}\) valores são observados com variância \(s^2_{obs}\) e \(n_{mis}\) valores recebem exatamente \(\bar{x}_{obs}\), a soma dos quadrados dos desvios não muda, mas o denominador cresce: a nova variância é aproximadamente \(s^2_{obs}\cdot\frac{n_{obs} - 1}{n_{obs} + n_{mis} - 1}\).
penguins = sns.load_dataset("penguins")

# Quantos e quais faltantes?
print(penguins.isna().sum())
#> species               0
#> island                0
#> bill_length_mm        2
#> bill_depth_mm         2
#> flipper_length_mm     2
#> body_mass_g           2
#> sex                  11

# Linhas com algum faltante
print(penguins[penguins.isna().any(axis=1)])

# Imputação da massa corporal pela mediana da espécie (estratégia por grupo)
penguins["body_mass_g"] = penguins.groupby("species")["body_mass_g"] \
    .transform(lambda s: s.fillna(s.median()))

# Variável indicadora de ausência do sexo
penguins["sexo_faltante"] = penguins["sex"].isna().astype(int)Em projetos de aprendizado de máquina, estatísticas de imputação (médias, medianas) devem ser calculadas apenas no conjunto de treinamento e depois aplicadas ao conjunto de teste. Calculá-las com todos os dados é uma forma de vazamento de dados (data leakage), discutida no Capítulo de Aprendizado de Máquina e o Processo de Modelagem.
8.11.3 Imputação Múltipla e as Regras de Rubin
Qualquer imputação única — pela média, por regressão ou por vizinhos — trata os valores imputados como se fossem conhecidos, e por isso subestima a incerteza: erros padrão ficam pequenos demais e intervalos de confiança, estreitos demais. A imputação múltipla, proposta por Rubin (1987), resolve o problema em três etapas:
- Imputar: gera-se \(m\) bases completas, cada uma com valores imputados sorteados de uma distribuição preditiva dos faltantes dados os observados (e não apenas o valor previsto, que seria “perfeito demais”);
- Analisar: em cada base, calcula-se a estimativa de interesse \(\hat{Q}_\ell\) e sua variância \(U_\ell\), \(\ell = 1, \dots, m\);
- Combinar pelas regras de Rubin: \[\bar{Q} = \frac{1}{m}\sum_{\ell=1}^m \hat{Q}_\ell, \qquad \bar{W} = \frac{1}{m}\sum_{\ell=1}^m U_\ell, \qquad B = \frac{1}{m - 1}\sum_{\ell=1}^m \big(\hat{Q}_\ell - \bar{Q}\big)^2,\] \[T = \bar{W} + \left(1 + \frac{1}{m}\right) B.\]
A variância total \(T\) tem uma interpretação clara: \(\bar{W}\) é a variância dentro das imputações (a incerteza que existiria se não houvesse dados faltantes) e \(B\) é a variância entre imputações (a incerteza adicional causada pela ausência); o fator \(1 + 1/m\) corrige o fato de usarmos um número finito de imputações. O intervalo de confiança é \(\bar{Q} \pm t_{\nu;\,0{,}975}\sqrt{T}\), com graus de liberdade
\[ \nu = (m - 1)\left(1 + \frac{1}{r}\right)^2, \qquad r = \frac{(1 + 1/m)\,B}{\bar{W}}, \]
em que \(r\) é o aumento relativo da variância devido à ausência. A quantidade \(\lambda = (1 + 1/m)B/T\) é a fração da variância atribuível aos dados faltantes. Antigamente recomendavam-se \(m = 3\) a \(5\) imputações; com computadores modernos, recomenda-se \(m\) ao menos igual à porcentagem de casos incompletos (por exemplo, \(m = 20\) para 20% de faltantes) (Buuren 2018).
Uma média foi estimada em \(m = 5\) bases imputadas, com estimativas \(\hat{Q} = (10{,}2;\ 10{,}5;\ 9{,}9;\ 10{,}4;\ 10{,}0)\) e variâncias \(U = (0{,}25;\ 0{,}24;\ 0{,}26;\ 0{,}25;\ 0{,}25)\).
- \(\bar{Q} = 51/5 = 10{,}2\) e \(\bar{W} = 1{,}25/5 = 0{,}25\);
- desvios \(\hat{Q}_\ell - \bar{Q} = (0;\ 0{,}3;\ -0{,}3;\ 0{,}2;\ -0{,}2)\), com quadrados somando \(0{,}26\); logo \(B = 0{,}26/4 = 0{,}065\);
- \(T = 0{,}25 + 1{,}2 \times 0{,}065 = 0{,}25 + 0{,}078 = 0{,}328\) e \(\sqrt{T} \approx 0{,}573\);
- \(r = 0{,}078/0{,}25 = 0{,}312\) e \(\nu = 4\,(1 + 1/0{,}312)^2 \approx 4 \times 4{,}205^2 \approx 70{,}7\);
- \(\lambda = 0{,}078/0{,}328 \approx 0{,}24\): cerca de 24% da variância deve-se aos dados faltantes;
- com \(t_{70{,}7;\,0{,}975} \approx 1{,}994\), o IC 95% é \(10{,}2 \pm 1{,}994 \times 0{,}573 = [9{,}06;\ 11{,}34]\).
Se tivéssemos usado apenas uma base imputada, o erro padrão seria \(\sqrt{0{,}25} = 0{,}5\), cerca de 13% menor que o correto, e o intervalo seria otimista.
O código abaixo ilustra o procedimento completo com o IterativeImputer do Scikit-learn, que imputa cada variável por regressão nas demais, em ciclos; com sample_posterior=True, os valores imputados são sorteados da distribuição preditiva, como a imputação múltipla exige. Simulamos ausência MAR na massa corporal dos pinguins, mais frequente entre os animais de nadadeira curta:
import numpy as np
import pandas as pd
import seaborn as sns
from sklearn.experimental import enable_iterative_imputer  # noqa: F401
from sklearn.impute import IterativeImputer

penguins = sns.load_dataset("penguins")
num = ["bill_length_mm", "bill_depth_mm", "flipper_length_mm", "body_mass_g"]
X = penguins[num].dropna().reset_index(drop=True)

# Ausência MAR: a probabilidade de faltar depende da nadadeira (observada)
rng = np.random.default_rng(42)
p_falta = 0.4 / (1 + np.exp((X["flipper_length_mm"] - 195) / 5))
Xm = X.copy()
Xm.loc[rng.random(len(X)) < p_falta, "body_mass_g"] = np.nan

m = 20
est, var = [], []
for k in range(m):
    imp = IterativeImputer(sample_posterior=True, random_state=k)
    Xk = pd.DataFrame(imp.fit_transform(Xm), columns=num)
    est.append(Xk["body_mass_g"].mean())
    var.append(Xk["body_mass_g"].var() / len(Xk))

est, var = np.array(est), np.array(var)
Q, W, B = est.mean(), var.mean(), est.var(ddof=1)
T = W + (1 + 1 / m) * B
print(f"Imputação múltipla: {Q:.0f} (EP {np.sqrt(T):.1f})")
print(f"Casos completos:    {Xm['body_mass_g'].mean():.0f}")
print(f"Dados completos:    {X['body_mass_g'].mean():.0f}")
Em uma execução, cerca de 18% das massas foram removidas; a média dos casos completos foi aproximadamente 4.315 g — viesada para cima, pois faltam sobretudo os pinguins pequenos —, enquanto a imputação múltipla forneceu cerca de 4.185 g, próxima do valor de 4.202 g dos dados completos.
8.11.4 Detectando Outliers com o Boxplot
Os outliers são registros muito distantes dos limites superiores ou inferiores esperados do seu conjunto de dados. Uma das ferramentas mais eficazes para visualizá-los é o gráfico Boxplot (Diagrama de Caixa):
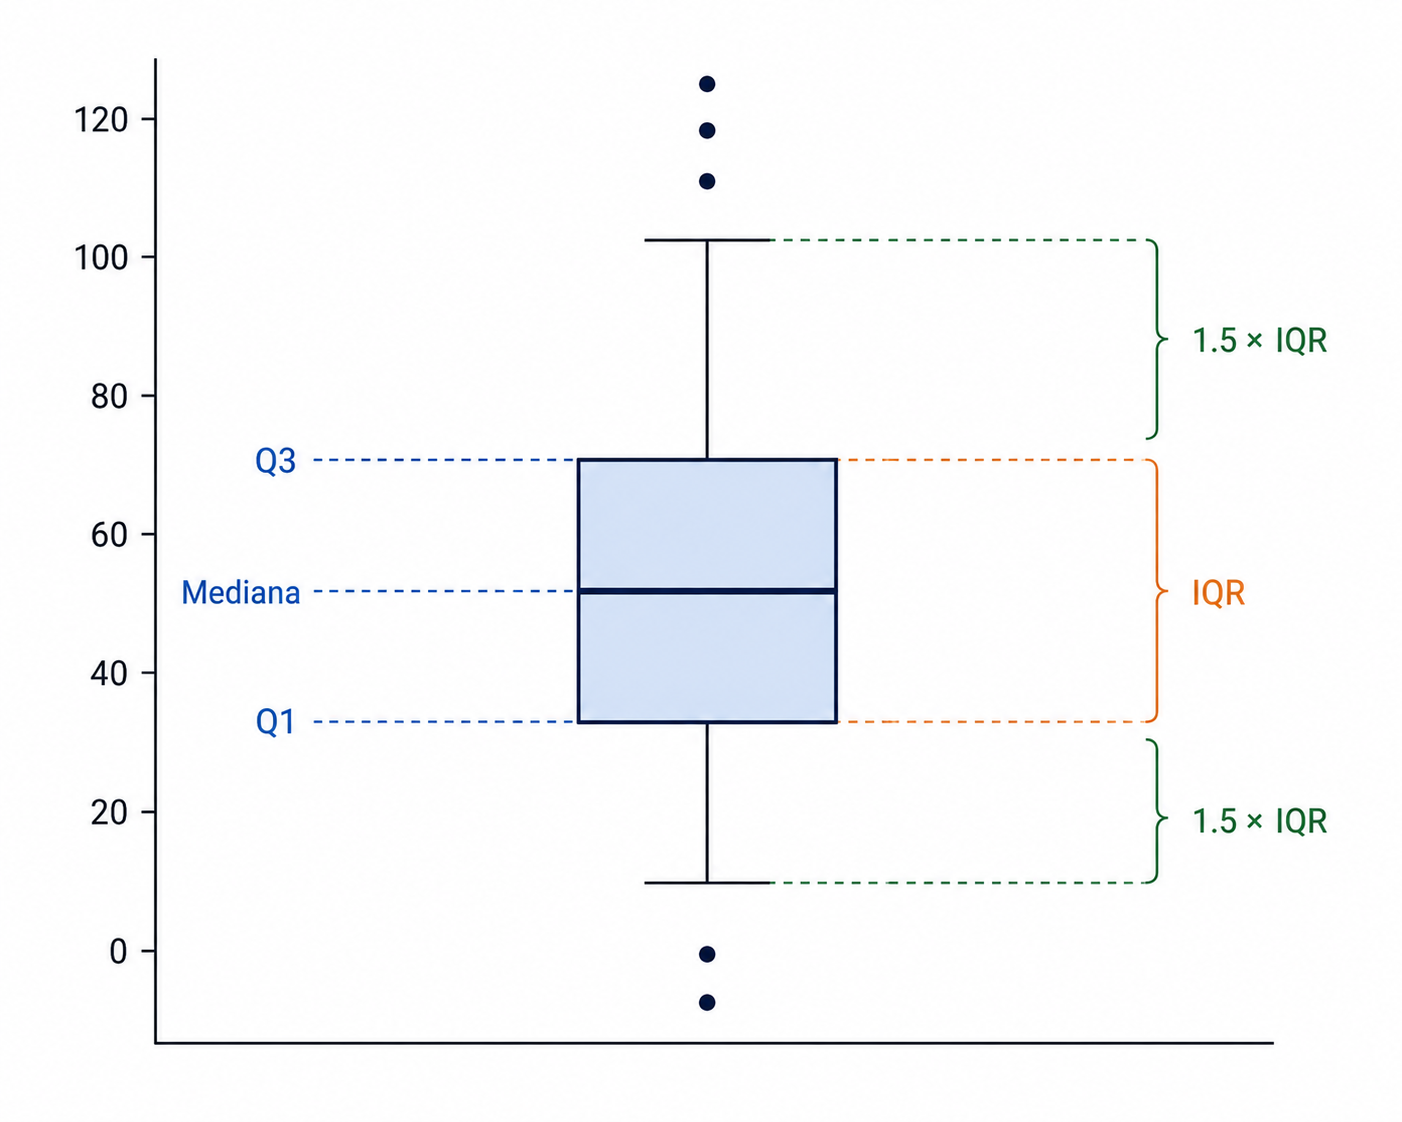
O Boxplot divide os dados em quartis:
- A linha central dentro da caixa representa a Mediana (Segundo Quartil - Q2).
- A parte inferior da caixa representa o Primeiro Quartil (Q1, percentil 25).
- A parte superior da caixa representa o Terceiro Quartil (Q3, percentil 75).
- O Intervalo Interquartil (IQR) é a distância entre Q3 e Q1 (\(IQR = Q3 - Q1\)).
- Os limites ou “bigodes” (whiskers) são definidos a partir do limite inferior (\(Q1 - 1.5 \times IQR\)) e superior (\(Q3 + 1.5 \times IQR\)). Mais precisamente, cada bigode se estende até a observação mais extrema que ainda está dentro desses limites (as “cercas”). Qualquer dado além desses limites é plotado individualmente e classificado como outlier.
A construção passo a passo do boxplot, com um exemplo numérico e a justificativa do fator 1,5, foi apresentada no Capítulo de Visualização de Dados com ggplot2. Tukey também definia cercas externas em \(Q_1 - 3\,\mathrm{IQR}\) e \(Q_3 + 3\,\mathrm{IQR}\): pontos além delas são considerados outliers extremos.
8.11.5 Outras Regras de Detecção: Escore-z e Escore-z Modificado
- Escore-z: \(z_i = (x_i - \bar{x})/s\). Sob normalidade, \(|z_i| > 3\) ocorre com probabilidade de cerca de 0,27%, e é um critério comum de sinalização. Sua fraqueza é que \(\bar{x}\) e \(s\) são eles próprios afetados pelos outliers, que podem “se esconder” (efeito de mascaramento, masking), sobretudo em amostras pequenas.
- Escore-z modificado (Iglewicz e Hoaglin 1993): substitui média e desvio padrão por mediana e MAD, \[M_i = \frac{0{,}6745\,(x_i - \operatorname{Md})}{\mathrm{MAD}},\] sinalizando como outlier as observações com \(|M_i| > 3{,}5\).
Nas gorjetas \(\{1, 2, 2, 3, 3, 3, 4, 5, 6, 11\}\) (\(\bar{x} = 4\), \(s \approx 2{,}87\), \(\operatorname{Md} = 3\), \(\mathrm{MAD} = 1\), \(Q_1 = 2{,}25\), \(Q_3 = 4{,}75\)):
- Escore-z do valor 11: \((11 - 4)/2{,}87 \approx 2{,}44 < 3\) — não é sinalizado, pois o próprio 11 inflou \(s\);
- Regra do boxplot: cerca superior \(4{,}75 + 1{,}5 \times 2{,}5 = 8{,}5 < 11\) — é sinalizado;
- Escore-z modificado: \(0{,}6745 \times (11 - 3)/1 \approx 5{,}40 > 3{,}5\) — é sinalizado.
x = pd.Series([1, 2, 2, 3, 3, 3, 4, 5, 6, 11])

# Regra do boxplot (1,5 IQR)
q1, q3 = x.quantile([0.25, 0.75])
iqr = q3 - q1
outliers_iqr = x[(x < q1 - 1.5 * iqr) | (x > q3 + 1.5 * iqr)]

# Escore-z
z = (x - x.mean()) / x.std()
outliers_z = x[z.abs() > 3]

# Escore-z modificado
mad = (x - x.median()).abs().median()
m = 0.6745 * (x - x.median()) / mad
outliers_m = x[m.abs() > 3.5]

print(outliers_iqr.tolist(), outliers_z.tolist(), outliers_m.tolist())
#> [11] [] [11]
O que fazer com um outlier? Detectar não é o mesmo que remover. Um outlier pode ser (i) um erro de digitação ou medição (corrija ou remova, documentando a decisão); (ii) um valor legítimo e raro (mantenha-o; considere métodos robustos ou transformações); ou (iii) o fenômeno de interesse (em detecção de fraudes, os outliers são o objetivo). Remover outliers apenas para “melhorar” um resultado é uma prática metodologicamente inaceitável.
8.11.6 Um Pouco Mais de Teoria sobre Outliers
Um limite para o escore-z. O mascaramento do exemplo anterior não é acidental. A desigualdade de Samuelson garante que, em qualquer amostra de tamanho \(n\),
\[ \lvert z_i \rvert = \frac{\lvert x_i - \bar{x}\rvert}{s} \le \frac{n - 1}{\sqrt{n}}. \]
Para \(n = 10\), o limite é \(9/\sqrt{10} \approx 2{,}85\): nenhuma observação de uma amostra de 10 valores pode ter escore-z maior que 3, por mais absurda que seja! A regra \(\lvert z \rvert > 3\) é, portanto, inútil para amostras com \(n \le 10\) (pois \((n-1)/\sqrt{n} \le 3\) nesses casos).
Testes formais. Se os dados (sem o outlier) forem aproximadamente normais, o teste de Grubbs (Grubbs 1969) usa a estatística \(G = \max_i \lvert x_i - \bar{x}\rvert / s\) e rejeita a hipótese de ausência de outliers quando
\[ G > \frac{n - 1}{\sqrt{n}}\sqrt{\frac{t^2}{n - 2 + t^2}}, \qquad t = t_{n-2;\ 1 - \alpha/(2n)}. \]
Nas gorjetas, \(G = 7/2{,}87 \approx 2{,}44\), enquanto o valor crítico para \(n = 10\) e \(\alpha = 0{,}05\) é aproximadamente \(2{,}29\) (com \(t_{8;\,0{,}9975} \approx 3{,}83\)): o valor 11 é declarado outlier, sob a suposição de normalidade. O teste de Grubbs foi desenhado para um único outlier; aplicá-lo repetidamente, removendo um ponto de cada vez, sofre de mascaramento quando há vários outliers próximos entre si.
Mascaramento e inundação. Dois fenômenos complementares afetam regras baseadas em estimadores não robustos: o mascaramento (masking), em que outliers inflam \(s\) e escondem uns aos outros, e a inundação (swamping), em que outliers deslocam \(\bar{x}\) e fazem observações típicas parecerem discrepantes. A solução geral é usar estimadores de locação e escala com alto ponto de ruptura, como mediana e MAD.
8.11.7 Outliers Multivariados: a Distância de Mahalanobis
Um ponto pode ser típico em cada variável isoladamente e, ainda assim, ser atípico na combinação delas — um pinguim com nadadeira longa e massa pequena, por exemplo. Boxplots univariados não detectam esse tipo de outlier. A ferramenta adequada é a distância de Mahalanobis (Mahalanobis 1936) de um vetor \(\mathbf{x}\) ao centro \(\bar{\mathbf{x}}\) da nuvem de pontos, levando em conta a matriz de covariâncias amostral \(\mathbf{S}\):
\[ D^2(\mathbf{x}) = (\mathbf{x} - \bar{\mathbf{x}})^\top\, \mathbf{S}^{-1}\, (\mathbf{x} - \bar{\mathbf{x}}). \]
Ela generaliza o escore-z ao caso multivariado: em uma dimensão, \(D^2 = z^2\). Geometricamente, os pontos com mesma distância de Mahalanobis formam elipses (elipsoides) alinhadas com a correlação dos dados, em vez de círculos. Se os dados são normais multivariados em \(p\) dimensões, \(D^2\) tem distribuição aproximadamente \(\chi^2_p\), e um critério usual é sinalizar pontos com \(D^2 > \chi^2_{p;\,0{,}975}\) ou \(\chi^2_{p;\,0{,}999}\).
Considere duas variáveis padronizadas, com médias \((0, 0)\), variâncias 1 e correlação \(0{,}8\), isto é, \(\mathbf{S} = \begin{pmatrix} 1 & 0{,}8\\ 0{,}8 & 1\end{pmatrix}\), cuja inversa é \(\mathbf{S}^{-1} = \frac{1}{0{,}36}\begin{pmatrix} 1 & -0{,}8\\ -0{,}8 & 1\end{pmatrix}\).
- Ponto \(A = (2, 2)\): \(D^2 = \frac{1}{0{,}36}\,(4 - 2 \times 0{,}8 \times 4 + 4) = \frac{1{,}6}{0{,}36} \approx 4{,}44\). Distância euclidiana ao quadrado: \(8\).
- Ponto \(B = (1, -1)\): \(D^2 = \frac{1}{0{,}36}\,(1 + 2 \times 0{,}8 \times 1 + 1) = \frac{3{,}6}{0{,}36} = 10\). Distância euclidiana ao quadrado: \(2\).
Pela distância euclidiana, \(A\) está mais longe do centro; pela de Mahalanobis, \(B\) é muito mais atípico, pois contraria a correlação positiva (um valor acima da média em uma variável e abaixo na outra). Com \(\chi^2_{2;\,0{,}975} \approx 7{,}38\), apenas \(B\) seria sinalizado.
import numpy as np
import seaborn as sns
from scipy import stats

penguins = sns.load_dataset("penguins")
num = ["bill_length_mm", "bill_depth_mm", "flipper_length_mm", "body_mass_g"]
X = penguins[num].dropna().to_numpy()

centro = X.mean(axis=0)
S_inv = np.linalg.inv(np.cov(X, rowvar=False))
D = X - centro
d2 = np.einsum("ij,jk,ik->i", D, S_inv, D)     # D^2 de cada linha

limiar = stats.chi2.ppf(0.999, df=X.shape[1])   # aproximadamente 18,47
print((d2 > limiar).sum())                      #> 1 pinguim sinalizado
print(d2.mean())                                #> ~3.99 (próximo de p = 4)
Como \(\bar{\mathbf{x}}\) e \(\mathbf{S}\) também são sensíveis a outliers, versões robustas usam estimadores como o determinante de covariância mínima (MCD), disponível em sklearn.covariance.MinCovDet. Note ainda que, nos pinguins, a mistura de três espécies torna a suposição de normalidade multivariada inadequada: uma análise mais cuidadosa calcularia as distâncias dentro de cada espécie.
8.12 Transformações de Variáveis
Transformações alteram a escala de uma variável para facilitar a visualização, estabilizar a variância ou atender suposições de modelos.
- Logarítmica: \(x \mapsto \log x\) (exige \(x > 0\); para dados com zeros, usa-se \(\log(1 + x)\),
np.log1p). Reduz a assimetria à direita, transforma relações multiplicativas em aditivas e torna diferenças interpretáveis em termos relativos: \(\log x_2 - \log x_1 \approx (x_2 - x_1)/x_1\) para variações pequenas. - Raiz quadrada: \(x \mapsto \sqrt{x}\), transformação mais branda, útil para contagens.
- Box–Cox (Box e Cox 1964): família paramétrica para \(x > 0\), \[x^{(\lambda)} = \begin{cases} \dfrac{x^\lambda - 1}{\lambda}, & \lambda \neq 0,\\[4pt] \log x, & \lambda = 0, \end{cases}\] com \(\lambda\) escolhido por máxima verossimilhança para aproximar a normalidade (
scipy.stats.boxcox). Inclui a raiz (\(\lambda = 0{,}5\)) e o log (\(\lambda = 0\)) como casos particulares. - Padronização (escore-z): \(z = (x - \bar{x})/s\); resulta em média 0 e desvio padrão 1, sem alterar a forma da distribuição. Essencial para métodos baseados em distâncias, como o k-NN e o k-means.
- Normalização min-max: \(x' = (x - \min x)/(\max x - \min x) \in [0, 1]\); sensível a outliers.
diamonds = sns.load_dataset("diamonds")

print(diamonds["price"].skew())              # forte assimetria à direita
print(np.log(diamonds["price"]).skew())      # muito mais próxima de zero

diamonds["log_price"] = np.log(diamonds["price"])
diamonds["carat_z"] = (diamonds["carat"] - diamonds["carat"].mean()) / diamonds["carat"].std()

precos_bc, lambda_otimo = stats.boxcox(diamonds["price"])
print(f"lambda de Box-Cox: {lambda_otimo:.3f}")
Nos diamantes, a assimetria do preço cai de aproximadamente 1,62 para 0,12 com o logaritmo, e o \(\lambda\) estimado por Box–Cox é próximo de zero (\(\hat{\lambda} \approx -0{,}07\)), confirmando que o log é praticamente a melhor transformação de potência para essa variável.
8.12.1 Como o \(\lambda\) de Box–Cox é Estimado
Box e Cox (1964) supõem que, para algum \(\lambda\), os valores transformados \(x_i^{(\lambda)}\) são normais com média \(\mu\) e variância \(\sigma^2\). A verossimilhança dos dados originais precisa incluir o jacobiano da transformação, \(\prod_i \lvert dx_i^{(\lambda)}/dx_i\rvert = \prod_i x_i^{\lambda - 1}\) — sem ele, poderíamos “aumentar” a verossimilhança simplesmente encolhendo a escala dos dados. Maximizando em \(\mu\) e \(\sigma^2\) para cada \(\lambda\) fixo, obtemos a log-verossimilhança perfilada
\[ \ell(\lambda) = -\frac{n}{2}\ln \hat{\sigma}^2(\lambda) + (\lambda - 1)\sum_{i=1}^n \ln x_i + \text{constante}, \]
em que \(\hat{\sigma}^2(\lambda)\) é a variância (com denominador \(n\)) dos valores transformados. O estimador \(\hat{\lambda}\) maximiza \(\ell(\lambda)\), e um intervalo de confiança aproximado de 95% é dado pelos valores de \(\lambda\) com \(\ell(\lambda) \ge \ell(\hat{\lambda}) - \frac{1}{2}\chi^2_{1;\,0{,}95} \approx \ell(\hat{\lambda}) - 1{,}92\). Na prática, arredonda-se \(\hat{\lambda}\) para um valor interpretável dentro do intervalo (\(-1\), \(-0{,}5\), \(0\), \(0{,}5\), \(1\)).
Para a amostra \(\{1, 2, 4, 8, 16\}\) (\(n = 5\)), temos \(\sum \ln x_i = \ln(1 \cdot 2 \cdot 4 \cdot 8 \cdot 16) = \ln 1024 = 10 \ln 2 \approx 6{,}931\).
- \(\lambda = 1\) (sem transformação, a menos de uma translação): os valores \(x - 1 = (0, 1, 3, 7, 15)\) têm média \(5{,}2\) e variância (denominador \(n\)) \(148{,}8/5 = 29{,}76\). Logo \(\ell(1) = -2{,}5\ln 29{,}76 + 0 \approx -8{,}48\).
- \(\lambda = 0\) (log): os valores \(\ln x = (0;\ 0{,}693;\ 1{,}386;\ 2{,}079;\ 2{,}773)\) são igualmente espaçados, com variância \(2(\ln 2)^2 \approx 0{,}961\). Logo \(\ell(0) = -2{,}5\ln 0{,}961 - 6{,}931 \approx 0{,}099 - 6{,}931 \approx -6{,}83\).
- \(\lambda = 0{,}5\): calculando da mesma forma, \(\ell(0{,}5) \approx -7{,}27\).
O máximo ocorre em \(\lambda = 0\): como os dados formam uma progressão geométrica, o log os torna perfeitamente simétricos. Em Python: stats.boxcox_llf(0, x) retorna \(-6{,}832\) e stats.boxcox(x) estima \(\hat{\lambda} \approx 0\).
Dados com zeros ou negativos: Yeo–Johnson. Box–Cox exige \(x > 0\). A família de Yeo e Johnson (2000) estende a ideia a toda a reta real:
\[ \psi(\lambda, x) = \begin{cases} \dfrac{(x + 1)^\lambda - 1}{\lambda}, & x \ge 0,\ \lambda \ne 0,\\[6pt] \ln(x + 1), & x \ge 0,\ \lambda = 0,\\[6pt] -\dfrac{(1 - x)^{2 - \lambda} - 1}{2 - \lambda}, & x < 0,\ \lambda \ne 2,\\[6pt] -\ln(1 - x), & x < 0,\ \lambda = 2. \end{cases} \]
Para \(x \ge 0\), é a transformação de Box–Cox aplicada a \(x + 1\); para \(x < 0\), é a transformação “espelhada” com parâmetro \(2 - \lambda\), o que garante continuidade e monotonia. Está disponível em scipy.stats.yeojohnson e em sklearn.preprocessing.PowerTransformer (que, por padrão, usa Yeo–Johnson e padroniza o resultado).
Escolhendo transformações pela relação média–variância. Como discutido no Capítulo de Visualização de Dados com ggplot2, o método delta, \(\mathrm{Var}[g(X)] \approx g'(\mu)^2\,\mathrm{Var}(X)\), indica a transformação que estabiliza a variância: se o desvio padrão de grupos cresce proporcionalmente à média, use o log; se a variância cresce proporcionalmente à média (contagens), use a raiz quadrada. Um diagnóstico prático na AED é plotar, para vários grupos, \(\ln s\) contra \(\ln \bar{x}\): se a inclinação é \(b\), a transformação de potência sugerida é \(\lambda = 1 - b\).
Transformações mudam a pergunta respondida. A média de \(\ln x\), retransformada, \(\exp(\overline{\ln x})\), é a média geométrica, e não a média aritmética de \(x\) (pela desigualdade de Jensen, é sempre menor ou igual a ela). Diferenças em escala log correspondem a razões na escala original: uma diferença de \(0{,}1\) em \(\ln x\) significa que um valor é cerca de \(e^{0{,}1} \approx 1{,}105\) vezes o outro. Ao relatar resultados, volte sempre à escala original de forma correta.
8.13 Redução de Dimensionalidade na AED: Componentes Principais
Com \(p\) variáveis numéricas, há \(p(p-1)/2\) gráficos de dispersão bivariados — 45 para \(p = 10\) —, e nenhum deles mostra a estrutura conjunta. A Análise de Componentes Principais (Principal Component Analysis, PCA), proposta por Pearson (1901) e desenvolvida por Hotelling, busca poucas combinações lineares das variáveis que preservem o máximo possível da variabilidade, permitindo visualizar dados multivariados em duas dimensões (Jolliffe 2002).
8.13.1 Derivação
Seja \(\mathbf{S}\) a matriz \(p \times p\) de covariâncias amostrais dos dados centrados \(\mathbf{x}_1, \dots, \mathbf{x}_n \in \mathbb{R}^p\). Procuramos uma direção unitária \(\mathbf{a}\) (\(\mathbf{a}^\top\mathbf{a} = 1\)) tal que a projeção \(y_i = \mathbf{a}^\top \mathbf{x}_i\) tenha variância máxima. Como \(\mathrm{Var}(y) = \mathbf{a}^\top \mathbf{S}\,\mathbf{a}\), o problema é
\[ \max_{\mathbf{a}}\ \mathbf{a}^\top \mathbf{S}\,\mathbf{a} \quad \text{sujeito a} \quad \mathbf{a}^\top \mathbf{a} = 1. \]
Com o lagrangiano \(\mathcal{L}(\mathbf{a}, \lambda) = \mathbf{a}^\top\mathbf{S}\,\mathbf{a} - \lambda(\mathbf{a}^\top\mathbf{a} - 1)\) e \(\partial\mathcal{L}/\partial\mathbf{a} = 2\mathbf{S}\mathbf{a} - 2\lambda\mathbf{a} = \mathbf{0}\), obtemos
\[ \mathbf{S}\,\mathbf{a} = \lambda\,\mathbf{a}, \]
isto é, \(\mathbf{a}\) deve ser um autovetor de \(\mathbf{S}\). Multiplicando à esquerda por \(\mathbf{a}^\top\), a variância atingida é \(\mathbf{a}^\top\mathbf{S}\,\mathbf{a} = \lambda\): o máximo é o maior autovalor \(\lambda_1\), atingido pelo autovetor correspondente \(\mathbf{a}_1\). A segunda componente maximiza a variância entre as direções ortogonais a \(\mathbf{a}_1\), e o mesmo argumento leva ao segundo autovetor, e assim por diante. Como \(\mathbf{S}\) é simétrica e semidefinida positiva, seus autovalores são reais e não negativos, \(\lambda_1 \ge \lambda_2 \ge \dots \ge \lambda_p \ge 0\), e seus autovetores podem ser escolhidos ortonormais.
Propriedades fundamentais:
- Variância total preservada: \(\sum_{k=1}^p \lambda_k = \operatorname{tr}(\mathbf{S}) = \sum_{j=1}^p s_j^2\). A proporção de variância explicada pela \(k\)-ésima componente é \(\lambda_k / \sum_j \lambda_j\).
- Componentes não correlacionadas: os escores \(y_{ik} = \mathbf{a}_k^\top\mathbf{x}_i\) de componentes diferentes têm covariância zero.
- Melhor aproximação de posto \(q\): projetar nos \(q\) primeiros autovetores minimiza a soma dos quadrados das distâncias entre os pontos e um subespaço de dimensão \(q\) — era essa a formulação geométrica original de Pearson (1901) (“retas e planos de melhor ajuste”).
- Dependência da escala: se as variáveis estão em unidades diferentes (milímetros e gramas), a de maior variância numérica domina. Por isso, na AED, quase sempre se padronizam as variáveis, o que equivale a usar a matriz de correlações \(\mathbf{R}\) em vez de \(\mathbf{S}\); nesse caso, \(\sum_k \lambda_k = p\).
Para duas variáveis padronizadas com correlação \(r\), a matriz é \(\mathbf{R} = \begin{pmatrix} 1 & r\\ r & 1\end{pmatrix}\). O polinômio característico é \(\det(\mathbf{R} - \lambda\mathbf{I}) = (1 - \lambda)^2 - r^2 = 0\), logo \(\lambda = 1 \pm r\). Para \(r > 0\), os autovetores normalizados são \(\mathbf{a}_1 = \frac{1}{\sqrt{2}}(1, 1)\) (a “soma” das variáveis) e \(\mathbf{a}_2 = \frac{1}{\sqrt{2}}(1, -1)\) (o “contraste”).
Para a nadadeira e a massa dos pinguins, \(r \approx 0{,}871\): \(\lambda_1 \approx 1{,}871\) e \(\lambda_2 \approx 0{,}129\). A primeira componente — essencialmente o “tamanho” do animal — explica \(1{,}871/2 \approx 93{,}6\%\) da variância total. A segunda, a diferença entre nadadeira e massa padronizadas, captura o que resta: pinguins com nadadeira longa “para o seu peso”.
Com as quatro medidas morfológicas padronizadas dos pinguins, os autovalores são aproximadamente \(2{,}75\), \(0{,}77\), \(0{,}37\) e \(0{,}11\), e as proporções de variância explicada são \(68{,}8\%\), \(19{,}3\%\), \(9{,}1\%\) e \(2{,}7\%\): as duas primeiras componentes concentram \(88{,}2\%\) da informação. Os coeficientes (loadings) da primeira componente têm o mesmo sinal para comprimento do bico, nadadeira e massa, e sinal oposto para a profundidade do bico — refletindo o contraste entre os Gentoo (grandes, de bico raso) e as outras espécies.
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

penguins = sns.load_dataset("penguins").dropna(subset=["bill_length_mm"])
num = ["bill_length_mm", "bill_depth_mm", "flipper_length_mm", "body_mass_g"]

# 1. Padronização (PCA sobre a matriz de correlações)
Z = (penguins[num] - penguins[num].mean()) / penguins[num].std()

# 2. Autovalores e autovetores da matriz de correlações
autoval, autovet = np.linalg.eigh(Z.corr().to_numpy())
ordem = np.argsort(autoval)[::-1]               # ordem decrescente
autoval, autovet = autoval[ordem], autovet[:, ordem]
print((autoval / autoval.sum()).round(3))       #> [0.688 0.193 0.091 0.027]
print(pd.DataFrame(autovet[:, :2], index=num, columns=["CP1", "CP2"]).round(2))

# 3. Escores e gráfico das duas primeiras componentes
escores = Z.to_numpy() @ autovet[:, :2]
penguins[["CP1", "CP2"]] = escores
sns.scatterplot(data=penguins, x="CP1", y="CP2", hue="species")
plt.show()

# Equivalente com Scikit-learn
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler
pca = PCA().fit(StandardScaler().fit_transform(penguins[num]))
print(pca.explained_variance_ratio_.round(3))   #> [0.688 0.193 0.091 0.027]
O sinal de cada autovetor é arbitrário (se \(\mathbf{a}\) é autovetor, \(-\mathbf{a}\) também é), de modo que softwares diferentes podem produzir componentes com sinais trocados. Na AED, a PCA serve para (i) visualizar agrupamentos e outliers multivariados no plano das duas primeiras componentes; (ii) detectar colinearidade (autovalores próximos de zero indicam combinações lineares quase constantes); e (iii) resumir muitas variáveis correlacionadas em poucos índices. Seu uso como etapa de pré-processamento em modelos preditivos é discutido nos capítulos de aprendizado de máquina.
8.14 Prática de AED com Python
Vejamos um exemplo completo de manipulação exploratória combinada com agregação e filtragem no Pandas:
# Filtrando dados: selecionando apenas clientes ativos com idade superior a 30 anos
clientes_filtrados = df[(df["Ativo"] == True) & (df["Idade"] > 30)]

# Agrupando e resumindo: descobrindo a média de compras por região geográfica
media_compras_regiao = df.groupby("Regiao")["Compras"].mean().reset_index()
print(media_compras_regiao)
O método groupby() implementa o paradigma dividir–aplicar–combinar (split–apply–combine): o DataFrame é dividido em grupos, uma função é aplicada a cada grupo e os resultados são combinados. Com agg(), podemos calcular vários resumos de uma vez:
resumo = df.groupby("Regiao").agg(
    n_clientes=("Compras", "size"),
    media_compras=("Compras", "mean"),
    mediana_compras=("Compras", "median"),
    dp_compras=("Compras", "std"),
).round(2)
8.14.1 Um Fluxo Completo de AED: os Pinguins de Palmer
O conjunto de dados penguins (Gorman, Williams, e Fraser 2014; Horst, Hill, e Gorman 2020) contém medidas de 344 pinguins de três espécies (Adelie, Chinstrap e Gentoo) coletadas em três ilhas do Arquipélago Palmer, na Antártida. Ele está disponível no Seaborn e é uma alternativa moderna ao clássico iris. Seguiremos um roteiro em etapas.
Etapa 1 — Carregamento e visão estrutural.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from scipy import stats

sns.set_theme(style="whitegrid")

penguins = sns.load_dataset("penguins")
print(penguins.shape)          #> (344, 7)
print(penguins.head())
penguins.info()

# Tipos categóricos explícitos
for col in ["species", "island", "sex"]:
    penguins[col] = penguins[col].astype("category")
Etapa 2 — Qualidade dos dados. Verificamos faltantes, duplicatas e valores impossíveis:
print(penguins.isna().sum())
print(penguins.duplicated().sum())                  #> 0
print((penguins.select_dtypes("number") <= 0).sum())  # medidas não positivas?

# Duas linhas não têm nenhuma medida: removê-las é razoável.
# O sexo falta em 11 linhas: mantemos e tratamos quando necessário.
penguins = penguins.dropna(subset=["bill_length_mm"])
print(penguins.shape)          #> (342, 7)
Etapa 3 — Análise univariada. Resumos numéricos, frequências e distribuições:
num = ["bill_length_mm", "bill_depth_mm", "flipper_length_mm", "body_mass_g"]

resumo = penguins[num].describe().T
resumo["cv"] = resumo["std"] / resumo["mean"]
resumo["assimetria"] = penguins[num].skew()
resumo["curtose"] = penguins[num].kurt()
print(resumo.round(2))

print(penguins["species"].value_counts())
#> Adelie       151
#> Gentoo       123
#> Chinstrap     68

fig, axes = plt.subplots(2, 2, figsize=(10, 7))
for ax, col in zip(axes.flat, num):
    sns.histplot(data=penguins, x=col, kde=True, bins="fd", ax=ax)
fig.tight_layout()
plt.show()
O argumento bins="fd" aplica a regra de Freedman–Diaconis. A massa corporal mostra assimetria positiva moderada (\(G_1 \approx 0{,}47\)), e os histogramas do comprimento da nadadeira sugerem bimodalidade — um sinal de mistura de subpopulações (espécies).
Etapa 4 — Análise bivariada: numérica × categórica.
print(penguins.groupby("species", observed=True)["body_mass_g"]
      .agg(["mean", "median", "std"]).round(1))
#>             mean  median    std
#> Adelie    3700.7  3700.0  458.6
#> Chinstrap 3733.1  3700.0  384.3
#> Gentoo    5076.0  5000.0  504.1

fig, axes = plt.subplots(1, 2, figsize=(11, 4))
sns.boxplot(data=penguins, x="species", y="body_mass_g", ax=axes[0])
sns.violinplot(data=penguins, x="species", y="flipper_length_mm",
               hue="sex", split=True, inner="quart", ax=axes[1])
fig.tight_layout()
plt.show()
A bimodalidade observada na etapa 3 é explicada: os Gentoo são bem mais pesados e têm nadadeiras maiores que as outras duas espécies.
Etapa 5 — Análise bivariada: numérica × numérica e correlações.
corr_p = penguins[num].corr(method="pearson")
corr_s = penguins[num].corr(method="spearman")

fig, axes = plt.subplots(1, 2, figsize=(12, 5))
sns.heatmap(corr_p, annot=True, fmt=".2f", cmap="RdBu_r", vmin=-1, vmax=1,
            ax=axes[0]).set_title("Pearson")
sns.heatmap(corr_s, annot=True, fmt=".2f", cmap="RdBu_r", vmin=-1, vmax=1,
            ax=axes[1]).set_title("Spearman")
fig.tight_layout()
plt.show()

sns.pairplot(penguins, vars=num, hue="species", corner=True)
plt.show()
O comprimento da nadadeira e a massa corporal são fortemente correlacionados (\(r \approx 0{,}87\)). Note o uso da paleta divergente RdBu_r com limites simétricos em \([-1, 1]\).
Etapa 6 — Investigando o paradoxo de Simpson.
print(penguins[["bill_length_mm", "bill_depth_mm"]].corr().iloc[0, 1])
#> -0.235  (correlação agregada: negativa!)

print(penguins.groupby("species", observed=True)[["bill_length_mm", "bill_depth_mm"]]
      .apply(lambda g: g["bill_length_mm"].corr(g["bill_depth_mm"])))
#> Adelie       0.391
#> Chinstrap    0.654
#> Gentoo       0.643   (positiva em todas as espécies)

sns.lmplot(data=penguins, x="bill_length_mm", y="bill_depth_mm",
           hue="species", ci=None, height=5)
plt.show()
Etapa 7 — Variáveis categóricas. A tabela de contingência entre espécie e ilha (seção anterior) mostra associação forte (\(V \approx 0{,}66\)). Também podemos verificar se a proporção de sexos é equilibrada em cada espécie:
print(pd.crosstab(penguins["species"], penguins["sex"],
                  normalize="index", margins=True).round(2))
Etapa 8 — Outliers. Aplicamos a regra 1,5·IQR dentro de cada espécie, pois um pinguim Adelie pesado pode ser perfeitamente típico se comparado aos Gentoo:
def flag_iqr(s):
    q1, q3 = s.quantile([0.25, 0.75])
    iqr = q3 - q1
    return (s < q1 - 1.5 * iqr) | (s > q3 + 1.5 * iqr)

penguins["outlier_massa"] = (penguins.groupby("species", observed=True)["body_mass_g"]
                             .transform(flag_iqr))
print(penguins.loc[penguins["outlier_massa"], ["species", "sex", "body_mass_g"]])
Etapa 9 — Síntese. Uma AED deve terminar com conclusões escritas, por exemplo: (i) há 2 registros sem medidas e 11 sem sexo, ambos em pequena proporção; (ii) as medidas morfológicas variam fortemente entre espécies, que é a principal fonte de variabilidade; (iii) a massa corporal e o comprimento da nadadeira são quase colineares, o que importa para modelos lineares; (iv) a relação entre as medidas do bico exige estratificação por espécie (paradoxo de Simpson); (v) a distribuição de espécies entre ilhas é muito desbalanceada. Essas conclusões orientam a modelagem e a comunicação dos resultados (veja o Capítulo de Storytelling com Dados).
8.15 Resumo do Capítulo
- A AED, proposta por Tukey, é uma atitude investigativa complementar à análise confirmatória: busca padrões, anomalias e hipóteses.
- Dados arrumados (tidy) facilitam a análise;
melt()epivot()convertem entre os formatos largo e longo. - O tipo da variável (nominal, ordinal, discreta, contínua) e a escala de mensuração determinam quais resumos são legítimos.
- Posição: a média minimiza desvios quadráticos, mas não é robusta; a mediana minimiza desvios absolutos e é robusta. Quantis amostrais têm várias definições.
- Dispersão: a variância amostral divide por \(n-1\) para ser não viesada; IQR e MAD são alternativas robustas; o CV permite comparar variabilidades relativas.
- Forma: assimetria (\(g_1\)) e curtose (\(g_2\)) baseiam-se no 3º e 4º momentos centrais.
- Associação: Pearson mede relação linear; Spearman, monotônica e robusta. Correlação não implica causalidade; o paradoxo de Simpson e o quarteto de Anscombe mostram os perigos da agregação e dos resumos sem gráficos.
- Para variáveis categóricas, usam-se tabelas de contingência, proporções condicionais, \(\chi^2\) e V de Cramér.
- Dados faltantes podem ser MCAR, MAR ou MNAR; a estratégia de tratamento deve considerar o mecanismo. A imputação pela média subestima a variância.
- Outliers podem ser detectados pela regra 1,5·IQR, pelo escore-z (sujeito a mascaramento) ou pelo escore-z modificado; detectar não significa remover.
- A padronização gera escores com média 0 e desvio padrão 1 sem alterar a forma; a desigualdade de Chebyshev garante que ao menos \(1 - 1/k^2\) dos dados estão a até \(k\) desvios padrão da média, para qualquer distribuição.
- Estatística robusta: o ponto de ruptura da média é 0 e o da mediana, 50%; a média aparada a \(\alpha\) tem ponto de ruptura \(\alpha\). A função de influência mede o efeito local de uma observação; a robustez tem um custo em eficiência sob normalidade (\(2/\pi\) para a mediana).
- Os coeficientes de forma são viesados e muito variáveis em amostras pequenas (\(\mathrm{EP}(g_1) \approx \sqrt{6/n}\)); o teste de Jarque–Bera combina assimetria e curtose, e a assimetria de Bowley é uma alternativa robusta.
- O \(\tau\) de Kendall compara pares concordantes e discordantes. A inferência para \(\rho\) usa o teste \(t\) com \(n - 2\) graus de liberdade e a transformação \(z\) de Fisher, cuja variância \(1/(n-3)\) não depende de \(\rho\).
- A estatística \(\chi^2\) é a soma dos quadrados dos resíduos de Pearson; os resíduos indicam quais caselas geram a associação. A informação mútua é zero se, e somente se, há independência, e relaciona-se ao teste \(G = 2n\hat{I}\).
- Sob MAR, o mecanismo de ausência é ignorável para inferências baseadas na verossimilhança, mas a análise de casos completos pode ser viesada. A imputação múltipla combina \(m\) análises pelas regras de Rubin, \(T = \bar{W} + (1 + 1/m)B\).
- A desigualdade de Samuelson limita o escore-z a \((n-1)/\sqrt{n}\); o teste de Grubbs formaliza a detecção de um outlier sob normalidade; a distância de Mahalanobis detecta outliers multivariados.
- Transformações (log, Box–Cox, Yeo–Johnson, padronização) reduzem assimetria, estabilizam variâncias e preparam os dados para a modelagem; o \(\lambda\) de Box–Cox é estimado por máxima verossimilhança perfilada, incluindo o jacobiano.
- A PCA encontra as direções de máxima variância, que são os autovetores da matriz de covariâncias (ou de correlações), com variâncias iguais aos autovalores; é uma ferramenta essencial para visualizar dados multivariados.
8.16 Exercícios Propostos
- (Teórico) Mostre que a média aritmética minimiza \(S(c) = \sum_{i=1}^n (x_i - c)^2\) e argumente por que a mediana minimiza \(\sum_{i=1}^n |x_i - c|\).
- (Teórico) Prove a identidade \(\sum_{i}(X_i - \bar{X})^2 = \sum_{i}(X_i - \mu)^2 - n(\bar{X} - \mu)^2\) e use-a para mostrar que \(\mathbb{E}[s^2] = \sigma^2\).
- (Cálculo) Para a amostra \(\{12, 15, 15, 18, 20, 22, 25, 60\}\), calcule à mão: média, mediana, moda, variância, desvio padrão, CV, \(Q_1\) e \(Q_3\) (tipo 7), IQR, MAD e o coeficiente de assimetria \(g_1\). Confira os resultados com Pandas e SciPy.
- (Cálculo) Para a amostra do exercício anterior, verifique se o valor 60 é outlier segundo (a) a regra 1,5·IQR, (b) o escore-z com limiar 3 e (c) o escore-z modificado. Discuta o mascaramento.
- (Cálculo) Calcule os coeficientes de Pearson e de Spearman para \(x = (2, 4, 6, 8, 10, 12)\) e \(y = (3, 5, 4, 9, 11, 40)\). Qual deles descreve melhor a relação? Justifique.
- (Teórico) Mostre que, se \(y_i = a + b\,x_i\) com \(b < 0\), então \(r = -1\). Mostre também que \(r\) não se altera se \(x\) for convertido de centímetros para milímetros.
- (Teórico) Dê um exemplo numérico com cinco pares \((x, y)\) em que \(r = 0\), mas \(y\) é uma função determinística de \(x\).
- (Teórico) Para cada situação, classifique o mecanismo de dados faltantes (MCAR, MAR ou MNAR) e justifique: (a) um sensor falha aleatoriamente por problemas de bateria; (b) pacientes com sintomas mais graves abandonam o estudo antes da medição final; (c) estudantes de um determinado turno, informado no cadastro, deixam de responder a uma questão com mais frequência.
- (Teórico) Considere uma variável com 80 valores observados de variância 25 e 20 valores faltantes imputados pela média. Calcule a variância após a imputação e comente o efeito.
- (Prático) Com o conjunto
tipsdo Seaborn, investigue se a porcentagem de gorjeta (tip / total_bill) difere entre fumantes e não fumantes, entre dias da semana e entre almoço e jantar. Use resumos agrupados e gráficos adequados. - (Prático) Ainda com
tips, construa a tabela de contingência entredayetime, as proporções condicionais por linha, a estatística \(\chi^2\) e o V de Cramér. Interprete. - (Prático) Com o conjunto
anscombe, reproduza as estatísticas resumo e os quatro gráficos de dispersão. Para cada conjunto, calcule também o coeficiente de Spearman e comente as diferenças. - (Prático) Com
diamonds, compare histogramas depricee delog(price). Estime o \(\lambda\) de Box–Cox e compare a assimetria antes e depois de cada transformação. - (Prático) Simule o paradoxo de Simpson: gere três grupos com correlação positiva interna, mas com médias deslocadas de modo que a correlação agregada seja negativa. Apresente as correlações por grupo e global e um gráfico de dispersão colorido por grupo.
- (Projeto) Escolha um conjunto de dados público de seu interesse e escreva um relatório de AED seguindo as nove etapas do fluxo apresentado, terminando com uma síntese de no máximo dez conclusões.
- (Teórico) Prove a desigualdade de Markov e deduza dela a desigualdade de Chebyshev. Dê um exemplo de distribuição discreta para a qual a desigualdade de Chebyshev é atingida com igualdade para \(k = 2\).
- (Teórico) Determine o ponto de ruptura amostral da média aparada a 20% para \(n = 20\) e o do IQR. Explique por que nenhum estimador de locação equivariante pode ter ponto de ruptura assintótico maior que 50%.
- (Cálculo) Para \(x = (3, 1, 4, 2, 5, 6)\) e \(y = (2, 1, 5, 3, 4, 6)\), conte os pares concordantes e discordantes e calcule o \(\tau\) de Kendall. Compare com o Spearman e confira com
stats.kendalltauestats.spearmanr. - (Cálculo) Um estudo com \(n = 28\) encontrou \(r = 0{,}45\). Teste \(H_0: \rho = 0\) ao nível de 5% e construa um IC de 95% para \(\rho\) pela transformação \(z\) de Fisher. Qual seria o IC se o mesmo \(r\) tivesse sido obtido com \(n = 280\)?
- (Cálculo) Para a tabela \(2 \times 2\) com caselas \(a = 40\), \(b = 10\), \(c = 20\), \(d = 30\), calcule as frequências esperadas, \(\chi^2\), o coeficiente \(\phi\) e verifique que \(\chi^2 = n\phi^2\). Calcule também a informação mútua (em bits) e a estatística \(G\).
- (Cálculo) As estimativas de um coeficiente em \(m = 4\) bases imputadas foram \((1{,}8;\ 2{,}1;\ 1{,}9;\ 2{,}2)\), com variâncias \((0{,}09;\ 0{,}10;\ 0{,}09;\ 0{,}10)\). Aplique as regras de Rubin: calcule \(\bar{Q}\), \(\bar{W}\), \(B\), \(T\), os graus de liberdade e a fração de variância devida aos faltantes.
- (Teórico) Prove a desigualdade de Samuelson, \(\lvert x_i - \bar{x}\rvert \le s\,(n-1)/\sqrt{n}\). Dica: aplique a desigualdade de Cauchy–Schwarz aos desvios das demais observações, usando \(\sum_{j \ne i}(x_j - \bar{x}) = -(x_i - \bar{x})\).
- (Cálculo) Com \(\bar{\mathbf{x}} = (0, 0)\) e \(\mathbf{S} = \begin{pmatrix} 4 & -1\\ -1 & 1\end{pmatrix}\), calcule a distância de Mahalanobis dos pontos \((2, 1)\) e \((2, -1)\). Qual é mais atípico? Interprete à luz do sinal da covariância.
- (Teórico) Mostre que, para a matriz de correlações de duas variáveis, os autovalores são \(1 \pm r\). Generalize: para \(p\) variáveis com todas as correlações iguais a \(r > 0\), mostre que o maior autovalor é \(1 + (p - 1)r\), com autovetor \((1, \dots, 1)/\sqrt{p}\).
- (Prático) Com o conjunto
penguins, simule ausência MCAR, MAR e MNAR (20%) na massa corporal. Para cada mecanismo, compare a média e o desvio padrão obtidos por casos completos, imputação pela média e imputação múltipla com o valor verdadeiro. Qual método falha em cada cenário? - (Prático) Aplique a PCA às medidas padronizadas dos pinguins separadamente para cada espécie. A estrutura das componentes muda em relação à análise conjunta? Relacione sua resposta com o paradoxo de Simpson.
8.17 Leituras Recomendadas
- Tukey (1977) — a obra fundadora da Análise Exploratória de Dados; Tukey (1962) é o manifesto que a antecedeu.
- McKinney (2022) — Python for Data Analysis, escrito pelo criador do Pandas; referência completa da biblioteca.
- VanderPlas (2016) — Python Data Science Handbook, com capítulos acessíveis sobre NumPy, Pandas e Matplotlib.
- Wickham (2014) — o artigo que formaliza o conceito de dados arrumados.
- Morettin e Singer (2021) — texto em português que articula a Estatística descritiva clássica com a Ciência de Dados.
- Anscombe (1973) — artigo curto e clássico sobre a importância dos gráficos na análise estatística.
- Little e Rubin (2019) — referência sobre dados faltantes, mecanismos MCAR/MAR/MNAR e imputação múltipla; o artigo original é Rubin (1976).
- Iglewicz e Hoaglin (1993) — monografia prática sobre detecção e tratamento de outliers.
- Schutt e O’Neil (2013) — visão aplicada do papel da AED no processo de ciência de dados.
- Huber e Ronchetti (2009) e Hampel (1974) — fundamentos da estatística robusta: M-estimadores, ponto de ruptura e função de influência.
- Joanes e Gill (1998) — comparação das diferentes versões amostrais dos coeficientes de assimetria e curtose.
- Kendall (1938) e Fisher (1921) — os artigos originais do \(\tau\) de Kendall e da transformação \(z\) de Fisher.
- Pearson (1900) e Cramér (1946) — a origem da estatística qui-quadrado e do coeficiente V de Cramér.
- Cover e Thomas (2006) — texto de referência em teoria da informação: entropia, informação mútua e divergência de Kullback–Leibler.
- Rubin (1987) e Buuren (2018) — a obra fundadora da imputação múltipla e um guia moderno e prático (com versão online gratuita).
- Grubbs (1969) — procedimentos clássicos para detecção de outliers sob normalidade.
- Yeo e Johnson (2000) — a família de transformações de Yeo–Johnson, que estende Box–Cox a dados com zeros e negativos.
- Pearson (1901) e Jolliffe (2002) — o artigo original da análise de componentes principais e a referência mais completa sobre o método.