12 Classificação com Floresta Aleatória
A Floresta Aleatória é um método conjunto (ensemble) robusto que reduz a variância de árvores individuais. Neste capítulo entenderemos formalmente o funcionamento do bagging e da seleção randômica de atributos, por que a combinação dessas duas fontes de aleatoriedade reduz a variância, como estimar o erro de generalização sem um conjunto de teste (erro out-of-bag), como medir a importância das variáveis e como ajustar os principais hiperparâmetros em R e Python. Além disso, estudaremos resultados teóricos (a decomposição da ambiguidade, o limite de erro de Breiman e sua demonstração, a relação entre o erro OOB e a validação cruzada leave-one-out, resultados de consistência), as proximidades entre observações, ferramentas de interpretação (dependência parcial, curvas ICE e valores de Shapley), variantes como as Extra Trees, as florestas de regressão quantílica e as florestas balanceadas, e, por fim, o boosting (AdaBoost, gradient boosting, XGBoost, LightGBM e CatBoost) e o empilhamento.
12.1 Métodos de Aprendizado de Conjunto (Ensemble)
O algoritmo de Floresta Aleatória (ou Random Forest, proposto por Breiman (2001)) baseia-se em uma filosofia intuitiva e poderosa: o Aprendizado de Conjunto (Ensemble Learning). O princípio central é que um comitê formado por vários modelos preditivos fracos ou de média acurácia individuais (no caso, árvores de decisão simples) performará muito melhor de forma combinada do que qualquer árvore individual isolada.
Podemos fazer uma analogia prática com a “Sabedoria das Massas”: se você fizer uma pergunta difícil a um único especialista, ele pode cometer um erro de viés pessoal. Porém, se você fizer a mesma pergunta a centenas de pessoas independentes e coletar o voto majoritário, a resposta combinada tende a ser altamente precisa.
12.1.1 Por que comitês funcionam? Um cálculo simples
Suponha \(B\) classificadores binários (com \(B\) ímpar), cada um com probabilidade \(q > 1/2\) de acertar, e que seus erros sejam independentes. O número de classificadores que acertam é \(S \sim \text{Binomial}(B, q)\), e o comitê por voto majoritário acerta quando \(S > B/2\): \[ P(\text{comitê acerta}) = \sum_{s = \lceil B/2 \rceil}^{B} \binom{B}{s} q^s (1-q)^{B-s}. \] Com \(q = 0{,}6\) (classificadores apenas um pouco melhores que o acaso), essa probabilidade vale aproximadamente \(0{,}683\) para \(B = 5\), \(0{,}846\) para \(B = 25\) e \(0{,}979\) para \(B = 101\). Pela lei dos grandes números, ela tende a 1 quando \(B \to \infty\) — resultado conhecido desde o Teorema do Júri de Condorcet (século XVIII).
A hipótese crucial é a independência dos erros. Árvores treinadas no mesmo conjunto de dados são fortemente correlacionadas: se todas erram nas mesmas observações, o voto majoritário não corrige nada. Todo o desenho da Floresta Aleatória pode ser entendido como um esforço para reduzir a correlação entre as árvores sem aumentar muito o erro de cada uma.
12.1.2 A decomposição da ambiguidade
O cálculo binomial acima supõe independência, o que nunca ocorre na prática. Um resultado que dispensa essa hipótese, válido para a perda quadrática, é a decomposição da ambiguidade de Krogh e Vedelsby (1995). Sejam \(f_1(\mathbf{x}), \ldots, f_B(\mathbf{x})\) as predições de \(B\) modelos em um ponto \(\mathbf{x}\) com resposta \(y\), e \(\bar{f}(\mathbf{x}) = \frac{1}{B}\sum_b f_b(\mathbf{x})\) a predição do conjunto.
\[ \underbrace{\big(\bar{f} - y\big)^2}_{\text{erro do conjunto}} = \underbrace{\frac{1}{B}\sum_{b=1}^{B} \big(f_b - y\big)^2}_{\text{erro médio dos membros}} - \underbrace{\frac{1}{B}\sum_{b=1}^{B} \big(f_b - \bar{f}\big)^2}_{\text{ambiguidade (diversidade)}}. \]
Demonstração. Escreva \(f_b - y = (f_b - \bar{f}) + (\bar{f} - y)\) e eleve ao quadrado: \[ \frac{1}{B}\sum_b (f_b - y)^2 = \frac{1}{B}\sum_b (f_b - \bar{f})^2 + 2(\bar{f} - y)\,\frac{1}{B}\sum_b (f_b - \bar{f}) + (\bar{f} - y)^2. \] O termo cruzado é nulo, pois \(\sum_b (f_b - \bar{f}) = 0\). Rearranjando, obtém-se o resultado. \(\blacksquare\)
Como a ambiguidade é não negativa, o erro quadrático do conjunto nunca é maior que o erro médio de seus membros, quaisquer que sejam as dependências entre eles; e o ganho é exatamente a dispersão das predições em torno da média. A lição é a mesma da seção anterior: um conjunto só ajuda se seus membros discordam.
Exemplo resolvido. Três modelos predizem \(f_1 = 2\), \(f_2 = 3\) e \(f_3 = 7\) em um ponto cuja resposta é \(y = 5\). A média é \(\bar{f} = 4\), com erro \((4 - 5)^2 = 1\). O erro médio dos membros é \(\frac{(2-5)^2 + (3-5)^2 + (7-5)^2}{3} = \frac{9 + 4 + 4}{3} = \frac{17}{3}\), e a ambiguidade é \(\frac{(2-4)^2 + (3-4)^2 + (7-4)^2}{3} = \frac{14}{3}\). De fato, \(\frac{17}{3} - \frac{14}{3} = 1\). Nenhum dos três modelos, isoladamente, tem erro tão pequeno quanto o do conjunto.
Os métodos de conjunto mais usados com árvores são o bagging (Breiman 1996), a Floresta Aleatória (Breiman 2001) e o boosting (Freund e Schapire 1997; J. H. Friedman 2001). Os dois primeiros combinam árvores treinadas em paralelo e têm como objetivo principal reduzir a variância; o boosting treina árvores sequencialmente e atua sobretudo na redução do viés. Uma quarta estratégia, o empilhamento (stacking), combina modelos de naturezas diferentes por meio de um segundo modelo. Todas são estudadas neste capítulo.
12.2 Bootstrap e Bagging
12.2.1 O bootstrap
O bootstrap, introduzido por Efron (1979), é um método de reamostragem: a partir da amostra original \(\mathcal{D} = \{(\mathbf{x}_1, y_1), \ldots, (\mathbf{x}_n, y_n)\}\), geramos uma amostra \(\mathcal{D}^{*}\) de mesmo tamanho \(n\) sorteando com reposição das \(n\) observações originais, cada uma com probabilidade \(1/n\) em cada sorteio. Algumas observações aparecem várias vezes em \(\mathcal{D}^{*}\), e outras não aparecem.
A probabilidade de que uma observação específica \(i\) não seja sorteada em nenhum dos \(n\) sorteios é \[ P(i \notin \mathcal{D}^{*}) = \left(1 - \frac{1}{n}\right)^n \xrightarrow{n \to \infty} e^{-1} \approx 0{,}368, \] pois \(\lim_{n\to\infty}(1 + x/n)^n = e^{x}\) com \(x = -1\). A convergência é rápida:
| \(n\) | \((1 - 1/n)^n\) |
|---|---|
| 5 | 0,328 |
| 10 | 0,349 |
| 100 | 0,366 |
| 1000 | 0,368 |
Consequentemente, cada amostra bootstrap contém, em média, cerca de \(1 - e^{-1} \approx 63{,}2\%\) das observações distintas originais, e cerca de \(36{,}8\%\) das observações ficam fora da bolsa (out-of-bag, OOB).
12.2.2 Bagging
O bagging (bootstrap aggregating), proposto por Breiman (1996), consiste em:
- Gerar \(B\) amostras bootstrap \(\mathcal{D}^{*1}, \ldots, \mathcal{D}^{*B}\).
- Ajustar um modelo \(\hat{f}^{*b}\) (tipicamente, uma árvore profunda e não podada) em cada amostra.
- Agregar as predições. Para regressão, pela média: \[ \hat{f}_{\text{bag}}(\mathbf{x}) = \frac{1}{B} \sum_{b=1}^{B} \hat{f}^{*b}(\mathbf{x}). \] Para classificação, por voto majoritário: \[ \hat{C}_{\text{bag}}(\mathbf{x}) = \arg\max_{k} \sum_{b=1}^{B} \mathbb{I}\{\hat{C}^{*b}(\mathbf{x}) = k\}. \]
As árvores do bagging são deliberadamente crescidas sem poda: cada uma tem viés baixo e variância alta, e a agregação se encarrega de reduzir a variância. O bagging é especialmente útil para procedimentos instáveis, como árvores de decisão (ver Capítulo de Classificação com Árvores de Decisão); para métodos estáveis, como k-NN com \(k\) grande ou regressão linear, o ganho é pequeno.
12.2.3 Redução de variância e o papel da correlação
Considere \(B\) variáveis aleatórias \(T_1, \ldots, T_B\) identicamente distribuídas — pense em \(T_b = \hat{f}^{*b}(\mathbf{x})\), a predição da \(b\)-ésima árvore num ponto fixo \(\mathbf{x}\) — com variância \(\sigma^2\) e correlação dois a dois \(\rho > 0\). A variância de sua média é \[ \begin{aligned} \operatorname{Var}\left(\frac{1}{B}\sum_{b=1}^{B} T_b\right) &= \frac{1}{B^2}\left[\sum_{b=1}^{B}\operatorname{Var}(T_b) + \sum_{b \neq b'} \operatorname{Cov}(T_b, T_{b'})\right] \\ &= \frac{1}{B^2}\left[B\sigma^2 + B(B-1)\rho\sigma^2\right] \\ &= \rho\sigma^2 + \frac{1-\rho}{B}\sigma^2. \end{aligned} \]
Essa expressão, destacada por Hastie, Tibshirani, e Friedman (2009), é a chave para entender a Floresta Aleatória:
- O segundo termo, \((1-\rho)\sigma^2/B\), desaparece quando \(B \to \infty\). Por isso, aumentar o número de árvores nunca piora o modelo; apenas estabiliza o resultado.
- O primeiro termo, \(\rho\sigma^2\), não depende de \(B\): é um piso para a variância do conjunto. Com árvores muito correlacionadas, adicionar árvores não ajuda.
Exemplo numérico. Com \(\sigma^2 = 1\) e \(B = 100\): se \(\rho = 0{,}5\), a variância da média é \(0{,}5 + 0{,}5/100 = 0{,}505\); se \(\rho = 0{,}1\), é \(0{,}1 + 0{,}9/100 = 0{,}109\). Reduzir a correlação de 0,5 para 0,1 diminui a variância quase cinco vezes, algo que nenhum aumento de \(B\) conseguiria.
No bagging puro, as árvores são bastante correlacionadas: se houver um preditor muito forte, praticamente todas as árvores o usarão na raiz, e suas estruturas serão parecidas. É aqui que entra a ideia central da Floresta Aleatória.
12.2.4 O que o bagging não faz
Duas observações delimitam o alcance do bagging:
- O viés praticamente não muda. Como as árvores \(\hat{f}^{*b}\) são identicamente distribuídas, \(E[\hat{f}_{\text{bag}}(\mathbf{x})] = E[\hat{f}^{*1}(\mathbf{x})]\): o valor esperado do conjunto é o de uma única árvore ajustada a uma amostra bootstrap. Se o modelo-base tem viés alto (por exemplo, um toco de decisão com uma única divisão), o bagging não o corrige. Por isso usam-se árvores profundas, de viés baixo, e deixa-se a redução de variância para a agregação. Reduzir o viés é o papel do boosting, que veremos adiante.
- Em classificação, o bagging pode piorar um classificador ruim. O cálculo binomial do início do capítulo mostra que o voto majoritário “amplifica” a tendência dos membros: se, em um ponto \(\mathbf{x}\), cada árvore acerta com probabilidade \(q > 1/2\), o voto acerta com probabilidade maior que \(q\); mas se \(q < 1/2\), o voto acerta com probabilidade menor. Breiman (1996) observou que o bagging melhora classificadores que são “bons em média, mas instáveis”, e pode piorar classificadores sistematicamente errados em certas regiões.
Para regressão com perda quadrática, por outro lado, a desigualdade de Jensen (ou a decomposição da ambiguidade) garante que a média agregada nunca tem erro quadrático esperado maior que o de um único membro.
12.3 O Funcionamento da Floresta Aleatória
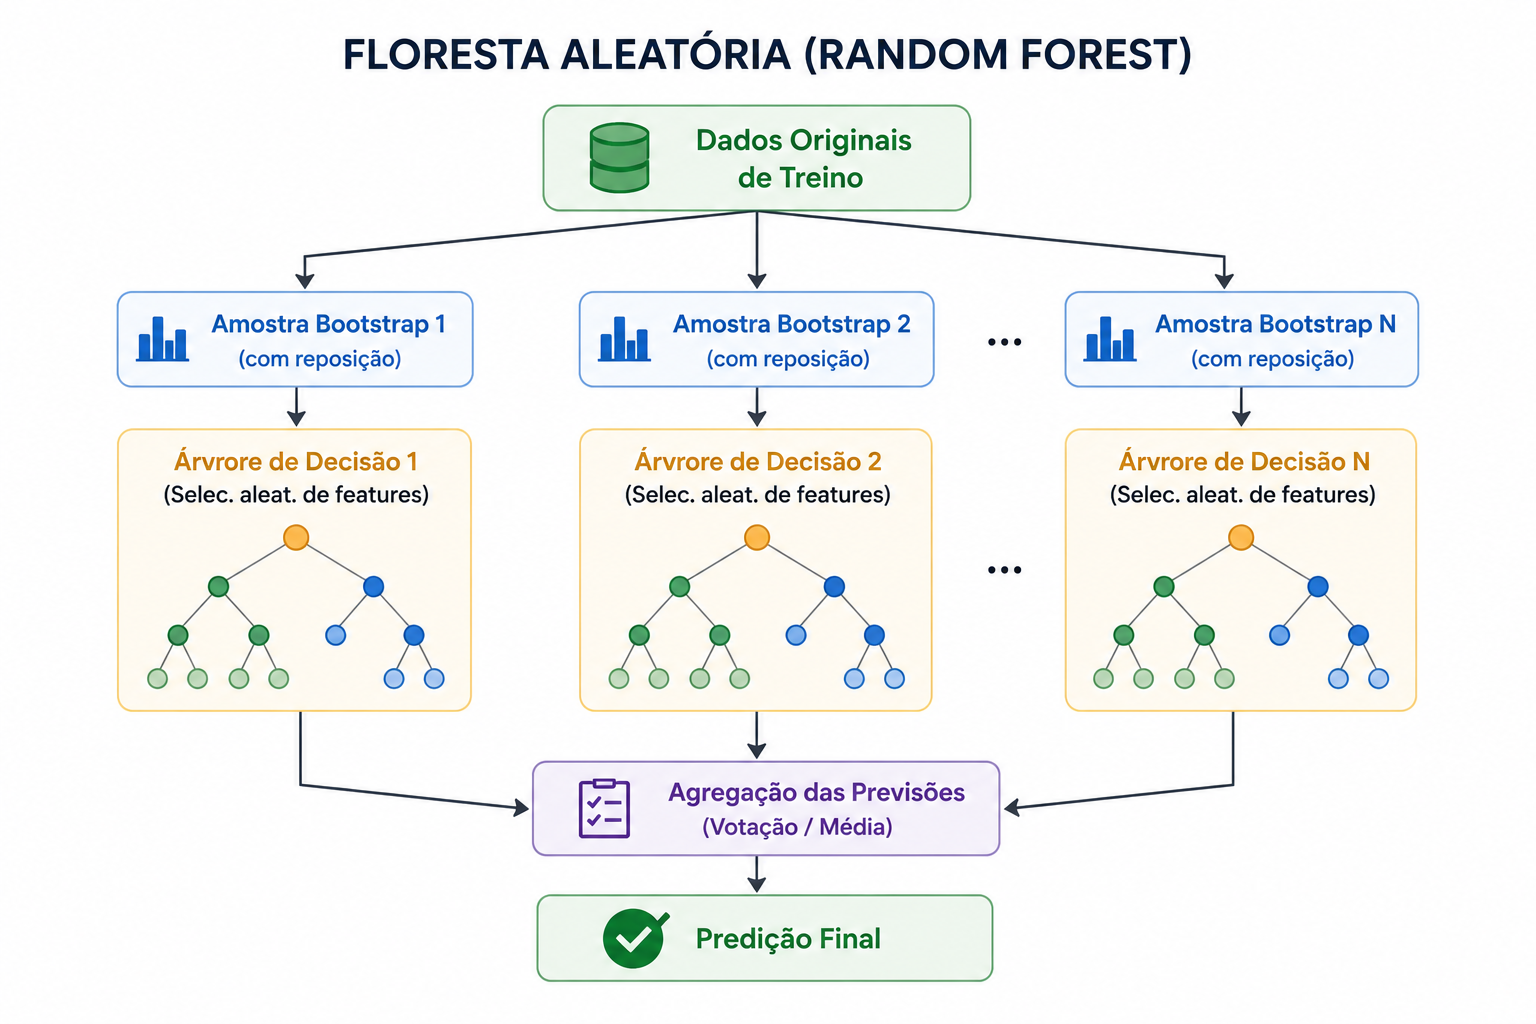
Para criar um comitê forte composto por centenas de árvores de decisão, a Floresta Aleatória precisa garantir que as árvores criadas sejam independentes e diversificadas entre si. O algoritmo faz isso utilizando dois processos cruciais de aleatorização:
12.3.1 Agregação por Bootstrap
Em vez de treinar todas as árvores na mesma base de dados, a Floresta Aleatória gera subconjuntos de dados aleatórios de tamanho igual ao original através do processo de Amostragem com Reposição (Bootstrap). Isso significa que alguns registros originais serão repetidos no treino de uma determinada árvore, enquanto outros dados (conhecidos como dados Out-Of-Bag ou OOB) serão deixados de fora para aquela árvore específica.
12.3.2 Seleção Randômica de Atributos (Feature Randomness)
Ao treinar uma árvore de decisão clássica, o nó examina todos os atributos disponíveis para escolher a melhor divisão. Na Floresta Aleatória, a cada nova divisão de nó de cada árvore, o algoritmo escolhe de forma aleatória apenas um subconjunto reduzido de variáveis (representado matematicamente como \(m\)). O corte ideal deve ser selecionado apenas entre as variáveis desse subconjunto sorteado.
- Para classificação, a recomendação clássica é selecionar \(m = \sqrt{p}\) variáveis (arredondado para baixo), onde \(p\) é o total de colunas preditoras nos dados.
- Para regressão (Capítulo de Modelos de Regressão com Árvores e Florestas), a recomendação clássica é \(m = p/3\).
- Com \(m = p\), a Floresta Aleatória reduz-se ao bagging.
Ao combinar o Bagging com a Seleção de Atributos, a Floresta Aleatória garante que as árvores geradas tenham estruturas de decisão altamente descorrelacionadas entre si.
Por que sortear atributos reduz \(\rho\)? Se um preditor \(x_1\) é muito forte, no bagging ele domina a raiz de quase todas as árvores. Com seleção aleatória, a probabilidade de \(x_1\) estar entre os candidatos de um nó é apenas \(m/p\); por exemplo, com \(p = 16\) e \(m = 4\), \(x_1\) fica de fora em 75% dos nós. Outros preditores, moderadamente informativos, têm então a chance de ser usados, e as árvores passam a explorar estruturas diferentes dos dados. Cada árvore individual fica um pouco pior (o viés e a variância de cada uma aumentam ligeiramente), mas a correlação entre elas cai bastante, e o efeito líquido sobre a variância do conjunto, \(\rho\sigma^2 + (1-\rho)\sigma^2/B\), costuma ser muito favorável. O valor de \(m\) controla exatamente esse equilíbrio: \(m\) pequeno \(\Rightarrow\) \(\rho\) menor, mas árvores individualmente mais fracas.
12.3.3 Algoritmo
Entrada: dados \(\mathcal{D} = \{(\mathbf{x}_i, y_i)\}_{i=1}^n\) com \(p\) preditores; número de árvores \(B\); número de variáveis sorteadas \(m\); tamanho mínimo de nó \(n_{\min}\).
- Para \(b = 1, \ldots, B\):
- Sorteie uma amostra bootstrap \(\mathcal{D}^{*b}\) de tamanho \(n\) a partir de \(\mathcal{D}\), e guarde o conjunto OOB \(\mathcal{O}_b = \mathcal{D} \setminus \mathcal{D}^{*b}\).
- Cresça uma árvore \(T_b\) em \(\mathcal{D}^{*b}\) repetindo recursivamente, em cada nó com pelo menos \(n_{\min}\) observações:
- sorteie, sem reposição, \(m\) das \(p\) variáveis;
- encontre a melhor divisão (pelo índice de Gini) usando apenas essas \(m\) variáveis;
- divida o nó em dois filhos.
- Não pode a árvore.
- Saída: o conjunto \(\{T_b\}_{b=1}^{B}\). Para um novo ponto \(\mathbf{x}\), a predição é \(\hat{C}_{\text{rf}}(\mathbf{x}) = \arg\max_k \sum_{b=1}^{B} \mathbb{I}\{\hat{C}_b(\mathbf{x}) = k\}\).
Note que o sorteio das \(m\) variáveis é feito a cada nó, e não uma única vez por árvore. Essa é uma diferença importante em relação ao “método do subespaço aleatório” de Ho (1995), que sorteava um subconjunto de variáveis por árvore.
12.3.4 Resultados teóricos de Breiman
Breiman (2001) demonstrou dois resultados que ajudam a entender o comportamento do método:
- Convergência: à medida que o número de árvores cresce, o erro de generalização da floresta converge quase certamente para um limite. Portanto, a Floresta Aleatória não sobreajusta por aumentar \(B\); o custo de usar muitas árvores é apenas computacional.
- Limite superior para o erro: definindo a força (strength) \(s\) como a margem esperada do conjunto (quanto, em média, a proporção de votos na classe correta supera a da classe errada mais votada) e \(\bar{\rho}\) como a correlação média entre as árvores, vale \[ PE^{*} \leq \frac{\bar{\rho}\,(1 - s^2)}{s^2}. \] O limite deixa explícito o compromisso: queremos árvores fortes (grande \(s\)) e pouco correlacionadas (pequeno \(\bar{\rho}\)).
Vejamos as definições com mais cuidado e um esboço da demonstração. Represente a floresta por classificadores \(h(\mathbf{x}, \Theta)\), em que \(\Theta\) é o vetor aleatório que codifica a amostra bootstrap e os sorteios de variáveis de uma árvore. Para um par \((\mathbf{X}, Y)\), a função margem da floresta (no limite \(B \to \infty\)) é \[ mr(\mathbf{X}, Y) = P_\Theta\big(h(\mathbf{X}, \Theta) = Y\big) - \max_{j \neq Y} P_\Theta\big(h(\mathbf{X}, \Theta) = j\big), \] isto é, a fração de árvores que votam na classe correta menos a fração que vota na classe errada mais popular. A floresta erra em \((\mathbf{X}, Y)\) se, e somente se, \(mr < 0\), de modo que \(PE^{*} = P_{\mathbf{X},Y}(mr(\mathbf{X}, Y) < 0)\). A força é \(s = E_{\mathbf{X},Y}[mr(\mathbf{X}, Y)]\).
Suponha \(s > 0\). Pela desigualdade de Chebyshev, \[ PE^{*} = P(mr < 0) \leq P\big(|mr - s| \geq s\big) \leq \frac{\operatorname{Var}(mr)}{s^2}. \] Defina a margem bruta de uma árvore, \(rmg(\Theta, \mathbf{X}, Y) = \mathbb{I}\{h(\mathbf{X}, \Theta) = Y\} - \mathbb{I}\{h(\mathbf{X}, \Theta) = \hat{j}(\mathbf{X}, Y)\}\), em que \(\hat{j}\) é a classe errada mais votada. Então \(mr = E_\Theta[rmg]\), e, para duas árvores independentes \(\Theta, \Theta'\), \[ \operatorname{Var}(mr) = E_{\Theta, \Theta'}\big[\operatorname{Cov}_{\mathbf{X},Y}(rmg(\Theta), rmg(\Theta'))\big] = \bar{\rho}\, \big(E_\Theta[\operatorname{sd}(\Theta)]\big)^2 \leq \bar{\rho}\, E_\Theta[\operatorname{Var}(\Theta)], \] em que \(\bar{\rho}\) é a correlação média entre as margens brutas de duas árvores e \(\operatorname{sd}(\Theta)\) é o desvio padrão de \(rmg(\Theta, \cdot)\); a desigualdade final é a de Jensen. Por fim, como \(rmg \in \{-1, 0, 1\}\), \(E_\Theta[\operatorname{Var}(\Theta)] \leq E_\Theta\big[E_{\mathbf{X},Y}(rmg^2)\big] - s^2 \leq 1 - s^2\). Combinando as desigualdades, obtém-se \(PE^{*} \leq \bar{\rho}(1 - s^2)/s^2\). \(\blacksquare\)
O limite costuma ser frouxo (por exemplo, com \(\bar{\rho} = 0{,}2\) e \(s = 0{,}5\), ele vale \(0{,}2 \times 0{,}75 / 0{,}25 = 0{,}6\)), e seu valor está na forma qualitativa: o erro diminui quando a correlação cai ou quando a força aumenta. Breiman também mostrou empiricamente que, ao reduzir \(m\), \(\bar{\rho}\) e \(s\) diminuem juntos, e que o erro é mínimo em valores intermediários de \(m\).
12.3.5 Consistência
Um estimador é consistente se seu risco converge para o risco de Bayes quando \(n \to \infty\). Apesar do enorme sucesso prático, a teoria da Floresta Aleatória original é difícil, pois os cortes dependem da resposta e das amostras bootstrap de forma complexa. Os principais resultados são:
- Biau, Devroye, e Lugosi (2008) provaram a consistência de diversas versões simplificadas de florestas (por exemplo, com cortes escolhidos ao acaso, sem olhar a resposta), desde que as folhas fiquem cada vez menores e, ao mesmo tempo, contenham cada vez mais observações. Também mostraram que a agregação pode tornar consistente um conjunto de árvores individualmente inconsistentes.
- Scornet, Biau, e Vert (2015) demonstraram a consistência da floresta original de Breiman para regressão quando a função de regressão é aditiva, \(f(\mathbf{x}) = \sum_j f_j(x_j)\), sob condições de regularidade — o primeiro resultado desse tipo para o algoritmo efetivamente usado na prática.
- Um panorama acessível desses e de outros resultados (incluindo intervalos de confiança e propriedades de adaptação a dimensões esparsas) está em Biau e Scornet (2016).
Um ponto comum a esses resultados é que eles exigem algum mecanismo que impeça cada árvore de simplesmente “decorar” os dados: ou o número de observações por folha cresce com \(n\), ou cada árvore é ajustada a uma subamostra de tamanho \(a_n\) com \(a_n \to \infty\) e \(a_n/n \to 0\). Isso dá respaldo teórico aos hiperparâmetros de tamanho mínimo de nó e de tamanho da amostra de cada árvore.
12.4 A Votação Majoritária e Conclusão
Após criar e treinar centenas de árvores de forma independente, quando um novo dado de teste precisa ser classificado pelo modelo:
- O registro de teste é enviado simultaneamente para todas as árvores da floresta.
- Cada árvore realiza sua previsão individual e “vota” em uma classe.
- O algoritmo computa os votos de todas as árvores e atribui ao dado a classe vencedora pelo voto majoritário.
12.4.1 Votos e probabilidades
Além da classe, a floresta fornece uma estimativa da probabilidade de cada classe. Há duas formas usuais:
- Proporção de votos (usada pelo
randomForestdo R): \(\hat{P}(Y = k \mid \mathbf{x}) = \frac{1}{B}\sum_{b} \mathbb{I}\{\hat{C}_b(\mathbf{x}) = k\}\). - Média das probabilidades das folhas (soft voting, usada pelo
scikit-learne pelorangercomprobability = TRUE): \(\hat{P}(Y = k \mid \mathbf{x}) = \frac{1}{B}\sum_b \hat{p}_{b,k}(\mathbf{x})\), em que \(\hat{p}_{b,k}(\mathbf{x})\) é a proporção da classe \(k\) na folha da árvore \(b\) que contém \(\mathbf{x}\).
Exemplo. Uma floresta com \(B = 500\) árvores e três classes recebe um ponto \(\mathbf{x}_0\); 310 árvores votam em A, 140 em B e 50 em C. A predição é A, com probabilidades estimadas \((0{,}62;\ 0{,}28;\ 0{,}10)\). Essas probabilidades permitem alterar o limiar de decisão (útil para classes desbalanceadas) e construir curvas ROC, conforme as métricas discutidas no Capítulo de Introdução ao Aprendizado de Máquina.
Essa arquitetura confere à Floresta Aleatória uma robustez fantástica contra o sobreajuste (overfitting), tornando-a um dos modelos de classificação de referência e mais eficientes na Ciência de Dados aplicada do mercado. Convém, porém, uma ressalva: cada árvore individual está sobreajustada aos seus dados bootstrap (a acurácia de treino da floresta costuma ser próxima de 100%); o que a floresta garante é que esse sobreajuste não se traduza em erro de generalização alto, graças à agregação. A avaliação deve sempre ser feita com dados não vistos, seja um conjunto de teste, seja o erro OOB.
12.5 Erro Out-of-Bag (OOB)
Uma vantagem prática notável do bagging e da Floresta Aleatória é que eles fornecem uma estimativa do erro de generalização sem necessidade de validação cruzada ou de um conjunto de teste separado. Como cada observação \(i\) fica fora da amostra bootstrap em cerca de 36,8% das árvores, podemos predizê-la usando apenas essas árvores, para as quais ela é um dado “novo”: \[ \hat{C}_{\text{oob}}(\mathbf{x}_i) = \arg\max_k \sum_{b \,:\, i \in \mathcal{O}_b} \mathbb{I}\{\hat{C}_b(\mathbf{x}_i) = k\}, \qquad \widehat{\text{Err}}_{\text{oob}} = \frac{1}{n}\sum_{i=1}^{n} \mathbb{I}\{y_i \neq \hat{C}_{\text{oob}}(\mathbf{x}_i)\}. \]
Com \(B = 500\) árvores, cada observação é predita, em média, por cerca de \(500 \times 0{,}368 \approx 184\) árvores. Para \(B\) suficientemente grande, o erro OOB é praticamente equivalente ao erro de validação cruzada leave-one-out, mas sai “de graça”, durante o próprio treinamento. Isso torna o erro OOB muito conveniente para monitorar o número de árvores e ajustar hiperparâmetros como \(m\).
O erro OOB só é uma estimativa honesta se nenhuma etapa de pré-processamento ou seleção de variáveis tiver usado a resposta de todo o conjunto de dados antes do treinamento. Além disso, se ele for usado para escolher hiperparâmetros, o valor mínimo obtido passa a ser otimista; é prudente reservar um conjunto de teste final.
12.5.1 Propriedades do erro OOB
Quantas árvores predizem cada observação? Os sorteios bootstrap das diferentes árvores são independentes. Assim, o número \(N_i\) de árvores para as quais a observação \(i\) é OOB tem distribuição \[ N_i \sim \text{Binomial}\big(B,\ \pi_n\big), \qquad \pi_n = \left(1 - \tfrac{1}{n}\right)^n \approx e^{-1} \approx 0{,}368. \] Com \(B = 100\), por exemplo, \(E[N_i] \approx 36{,}8\) e \(\operatorname{sd}(N_i) \approx \sqrt{100 \times 0{,}368 \times 0{,}632} \approx 4{,}8\). A probabilidade de que uma observação nunca seja OOB (e, portanto, não tenha predição OOB) é \((1 - \pi_n)^B \approx 0{,}632^B\): cerca de \(0{,}010\) para \(B = 10\) e \(10^{-5}\) para \(B = 25\). Por isso as implementações emitem um aviso quando \(B\) é muito pequeno.
Condicionalmente ao evento \(\{i \notin \mathcal{D}^{*b}\}\), a amostra bootstrap \(\mathcal{D}^{*b}\) tem a mesma distribuição de uma amostra de tamanho \(n\) sorteada com reposição do conjunto \(\mathcal{D}_{-i} = \mathcal{D} \setminus \{(\mathbf{x}_i, y_i)\}\). Consequentemente, a predição OOB de \(\mathbf{x}_i\) é uma aproximação de Monte Carlo, com \(N_i\) árvores, do preditor bagging ajustado sem a observação \(i\), e o erro OOB é uma aproximação do erro de validação cruzada leave-one-out do bagging.
Demonstração. Cada um dos \(n\) sorteios da amostra bootstrap é uniforme em \(\{1, \ldots, n\}\), independentemente dos outros. Condicionar ao evento de que nenhum sorteio resultou em \(i\) equivale a condicionar cada sorteio, independentemente, a ser diferente de \(i\); e um sorteio uniforme em \(\{1, \ldots, n\}\) condicionado a ser diferente de \(i\) é uniforme em \(\{1, \ldots, n\} \setminus \{i\}\). Logo, condicionalmente, os \(n\) sorteios são i.i.d. uniformes em \(\mathcal{D}_{-i}\). \(\blacksquare\)
Duas consequências práticas seguem dessa proposição. Primeiro, o erro OOB herda as boas propriedades da validação cruzada leave-one-out: viés pequeno e nenhum custo adicional de reajuste. Segundo, como cada predição OOB usa apenas cerca de \(0{,}368B\) árvores (e não \(B\)), o erro OOB de uma floresta com \(B\) árvores estima, na verdade, o erro de uma floresta menor; para \(B\) pequeno, isso o torna ligeiramente pessimista. Para \(B\) da ordem de centenas, a diferença é desprezível.
12.6 Importância das Variáveis
Uma floresta com centenas de árvores perde a interpretabilidade direta de uma árvore única. Para recuperar parte dela, usam-se medidas de importância de variáveis.
12.6.1 Diminuição média da impureza (MDI)
Também chamada de importância de Gini (Mean Decrease Impurity ou Mean Decrease Gini), soma, para cada variável \(j\), os decréscimos de impureza ponderados pelo tamanho dos nós em que \(j\) foi usada, e tira a média sobre as árvores: \[ \operatorname{MDI}(j) = \frac{1}{B}\sum_{b=1}^{B} \sum_{t \in T_b \,:\, v(t) = j} \frac{n_t}{n}\,\Delta Q(t). \] É rápida de calcular (subproduto do treinamento), mas é calculada nos dados de treino e é enviesada a favor de variáveis contínuas ou categóricas com muitos níveis, que oferecem mais oportunidades de corte, mesmo quando não são informativas (Strobl et al. 2007).
12.6.2 Importância por permutação (MDA)
Proposta por Breiman (2001), a importância por permutação (Mean Decrease Accuracy) mede quanto o erro OOB piora quando a associação entre a variável \(j\) e a resposta é destruída. Para cada árvore \(b\):
- Calcule o erro da árvore em seus dados OOB, \(e_b\).
- Permute aleatoriamente os valores da variável \(j\) entre as observações OOB e calcule novamente o erro, \(e_b^{(j)}\).
- A importância é a média das diferenças: \[ \operatorname{MDA}(j) = \frac{1}{B}\sum_{b=1}^{B}\left(e_b^{(j)} - e_b\right). \]
Se \(x_j\) é irrelevante, embaralhá-la não muda o erro e \(\operatorname{MDA}(j) \approx 0\); se é importante, o erro cresce. Essa medida é calculada em dados não usados no treinamento e é menos enviesada que a MDI. Ainda assim, quando há preditores fortemente correlacionados, a permutação de um deles cria combinações irreais de valores e a importância se divide entre eles, o que exige cuidado na interpretação. Versões condicionais da permutação foram propostas para mitigar esse problema, como veremos a seguir.
12.6.3 O viés da MDI em uma simulação
Para visualizar o viés da MDI, simulamos \(n = 1\,000\) observações com cinco preditores: \(x_1\) binária e informativa (\(P(Y = 1 \mid x_1 = 1) = 0{,}7\) e \(P(Y = 1 \mid x_1 = 0) = 0{,}3\)), e quatro preditores de puro ruído, independentes de \(Y\): \(x_2\) categórica com 4 níveis, \(x_3\) com 10 níveis, \(x_4\) com 20 níveis e \(x_5\) contínua normal. Ajustamos uma floresta com 500 árvores em 70% dos dados e calculamos a MDI e a importância por permutação nos 30% restantes:
| Variável | Natureza | MDI | Permutação (teste) |
|---|---|---|---|
| \(x_1\) | binária, informativa | 0,157 | 0,114 |
| \(x_2\) | 4 níveis, ruído | 0,081 | −0,003 |
| \(x_3\) | 10 níveis, ruído | 0,163 | 0,006 |
| \(x_4\) | 20 níveis, ruído | 0,226 | 0,009 |
| \(x_5\) | contínua, ruído | 0,372 | 0,002 |
O resultado é eloquente: pela MDI, a variável mais importante é o ruído contínuo, e a única variável informativa fica em terceiro lugar! A explicação é que árvores profundas usam qualquer variável com muitos cortes possíveis para “decorar” os dados de treino nos nós mais profundos, e cada uso soma um decréscimo de impureza positivo. Já a importância por permutação, calculada em dados não vistos, coloca \(x_1\) claramente em primeiro e atribui valores próximos de zero (às vezes negativos, por flutuação amostral) aos ruídos. O código que gera essa tabela está na seção de implementação em Python.
Louppe et al. (2013) mostraram que, para florestas de árvores totalmente aleatorizadas (com \(m = 1\) e cortes sorteados) crescidas sobre preditores categóricos, a soma das MDIs das variáveis, calculada com a entropia, converge para a informação mútua \(I(X_1, \ldots, X_p; Y)\), e a MDI de uma variável irrelevante converge para zero. O viés observado na prática vem, portanto, da busca do melhor corte em amostras finitas, e não da ideia de somar decréscimos de impureza em si. Usar árvores menos profundas (min_samples_leaf maior) ou calcular os decréscimos em dados OOB reduz o problema.
12.6.4 Importância condicional por permutação
A importância por permutação usual responde à pergunta “quanto o erro aumenta se destruirmos toda a informação de \(x_j\)?”. Quando \(x_j\) é correlacionada com outra variável \(x_k\), a permutação gera pontos fora da distribuição observada (por exemplo, pessoas de 1,90 m pesando 40 kg), nos quais a floresta é forçada a extrapolar, e a importância de \(x_j\) fica inflada. Strobl et al. (2008) propuseram a importância condicional: em vez de permutar \(x_j\) em todo o conjunto OOB, permuta-se \(x_j\) dentro de grupos de observações com valores semelhantes das variáveis correlacionadas com ela (os grupos são definidos pelos cortes que a própria árvore fez nessas variáveis). Assim, preserva-se a relação entre \(x_j\) e as demais, e mede-se apenas a contribuição adicional de \(x_j\) — algo análogo a um coeficiente parcial de regressão. No R, essa medida está disponível em party::varimp(..., conditional = TRUE) e no pacote permimp.
Uma alternativa computacionalmente mais cara, mas conceitualmente simples, é a importância por remoção (drop-column importance): reajusta-se o modelo sem a variável \(x_j\) e mede-se a perda de desempenho. Com variáveis fortemente correlacionadas, ela tende a atribuir importância baixa a cada uma isoladamente, pois a outra compensa sua ausência — o que é, de fato, uma resposta correta para a pergunta “quanto perco se não medir \(x_j\)?”.
12.7 Proximidades entre Observações
Além de predizer, a Floresta Aleatória define uma noção de semelhança entre observações, aprendida a partir da resposta. Breiman chamou-a de proximidade.
12.7.1 Definição
A proximidade entre as observações \(i\) e \(j\) é a fração das árvores em que ambas caem na mesma folha: \[
\operatorname{prox}(i, j) = \frac{1}{B}\sum_{b=1}^{B} \mathbb{I}\{\text{$\mathbf{x}_i$ e $\mathbf{x}_j$ caem na mesma folha de $T_b$}\}.
\] A matriz \(\mathbf{P} = [\operatorname{prox}(i,j)]\) é simétrica, com diagonal unitária e entradas em \([0, 1]\); como é uma média de matrizes de “co-pertinência” a blocos, é também positiva semidefinida. Pode-se definir a dissimilaridade \(d(i, j) = 1 - \operatorname{prox}(i, j)\) (ou \(\sqrt{1 - \operatorname{prox}(i, j)}\), que é uma distância euclidiana em um espaço de características). No randomForest, por padrão, a proximidade é calculada usando apenas as árvores em que ambas as observações são OOB, para evitar o otimismo dos dados de treino.
Exemplo resolvido. Uma floresta com \(B = 3\) árvores e 4 observações produz as seguintes folhas:
| Árvore | Folhas |
|---|---|
| \(T_1\) | \(\{1, 2\}\), \(\{3, 4\}\) |
| \(T_2\) | \(\{1, 2, 3\}\), \(\{4\}\) |
| \(T_3\) | \(\{1\}\), \(\{2, 3\}\), \(\{4\}\) |
As observações 1 e 2 compartilham folha em \(T_1\) e \(T_2\); 2 e 3, em \(T_2\) e \(T_3\); 1 e 3, só em \(T_2\); 3 e 4, só em \(T_1\); e 4 nunca está com 1 ou 2. Logo, \[ \mathbf{P} = \begin{bmatrix} 1 & 2/3 & 1/3 & 0 \\ 2/3 & 1 & 2/3 & 0 \\ 1/3 & 2/3 & 1 & 1/3 \\ 0 & 0 & 1/3 & 1 \end{bmatrix}. \]
Diferentemente da distância euclidiana usada no k-NN (Capítulo de k-Vizinhos Mais Próximos), essa semelhança é supervisionada: duas observações são próximas se a floresta as trata da mesma forma ao predizer a resposta, e variáveis irrelevantes praticamente não influenciam a proximidade. Ela também é invariante a transformações monótonas dos preditores e lida naturalmente com variáveis mistas.
12.7.2 Usos das proximidades
- Visualização. Aplicando escalonamento multidimensional (MDS) às dissimilaridades \(1 - \operatorname{prox}(i, j)\), obtém-se um gráfico bidimensional em que observações tratadas de forma semelhante pela floresta ficam próximas.
- Detecção de outliers. Uma observação é atípica para sua classe se for pouco próxima das demais observações da mesma classe. Breiman definiu a medida bruta \[ \operatorname{out}(i) = \frac{n}{\sum_{j \,:\, y_j = y_i} \operatorname{prox}(i, j)^2}, \] que é depois padronizada dentro de cada classe (subtraindo a mediana e dividindo pelo desvio absoluto mediano). Valores acima de 10 costumam merecer inspeção.
- Imputação de valores ausentes. O algoritmo de
rfImputecomeça com uma imputação grosseira (mediana ou moda); ajusta uma floresta; substitui cada valor ausente de uma variável contínua pela média ponderada pelas proximidades dos valores observados dessa variável (ou pela categoria de maior proximidade total, se categórica); e repete o ciclo algumas vezes. - Agrupamento. A matriz de dissimilaridades pode alimentar métodos hierárquicos ou o PAM. Treinando uma floresta para distinguir os dados reais de uma versão “sintética” com as colunas permutadas independentemente, obtêm-se proximidades mesmo sem variável resposta — é a chamada floresta aleatória não supervisionada.
library(randomForest)
set.seed(123)
rf_prox <- randomForest(Species ~ ., data = iris, ntree = 500, proximity = TRUE)

round(rf_prox$proximity[c(1, 2, 51, 101), c(1, 2, 51, 101)], 3)
MDSplot(rf_prox, iris$Species, k = 2)            # MDS das dissimilaridades 1 - prox

out <- outlier(rf_prox)                          # medida de atipicidade por classe
head(sort(out, decreasing = TRUE), 5)

# Imputação baseada em proximidades
iris_na <- iris
set.seed(1)
iris_na[sample(150, 20), "Petal.Length"] <- NA
iris_imp <- rfImpute(Species ~ ., data = iris_na, iter = 5, ntree = 300)
Para matrizes grandes, convém lembrar que \(\mathbf{P}\) tem \(n^2\) entradas: com \(n = 100\,000\), são \(10^{10}\) números, o que inviabiliza armazená-la. Nesses casos, calculam-se proximidades apenas entre os pontos de interesse e o restante da amostra.
12.8 Interpretação: Dependência Parcial, ICE e Valores de Shapley
As importâncias dizem quanto cada variável importa, mas não como ela afeta a predição. Esta seção apresenta três ferramentas agnósticas ao modelo, muito usadas com florestas e boosting.
12.8.1 Gráficos de dependência parcial
Seja \(\hat{f}\) o modelo ajustado (para classificação, a probabilidade estimada ou o log-odds de uma classe). Separe as variáveis em um subconjunto de interesse \(\mathbf{x}_S\) (em geral, uma ou duas variáveis) e o complemento \(\mathbf{x}_C\). A função de dependência parcial (J. H. Friedman 2001) é \[ \bar{f}_S(\mathbf{x}_S) = E_{\mathbf{X}_C}\big[\hat{f}(\mathbf{x}_S, \mathbf{X}_C)\big] \approx \frac{1}{n}\sum_{i=1}^{n} \hat{f}(\mathbf{x}_S, \mathbf{x}_{iC}), \] isto é, fixamos \(\mathbf{x}_S\) em um valor, mantemos as demais variáveis nos valores observados de cada indivíduo, e tiramos a média das predições. Repetindo isso numa grade de valores de \(\mathbf{x}_S\), obtém-se o gráfico de dependência parcial (PDP). Se o modelo for aditivo em \(\mathbf{x}_S\), isto é, \(\hat{f} = g(\mathbf{x}_S) + h(\mathbf{x}_C)\), o PDP recupera \(g\) a menos de uma constante.
12.8.2 Curvas ICE
O PDP é uma média e pode esconder heterogeneidade. As curvas de expectativa condicional individual (ICE) de Goldstein et al. (2015) mostram, para cada observação \(i\), a curva \(\hat{f}^{(i)}(\mathbf{x}_S) = \hat{f}(\mathbf{x}_S, \mathbf{x}_{iC})\); o PDP é a média dessas curvas.
Exemplo resolvido. Suponha que o modelo seja \(\hat{f}(x_1, x_2) = 2x_1 + x_1 x_2\) e que a amostra tenha três observações com \(x_2 \in \{0, 1, 2\}\). As curvas ICE de \(x_1\) são \[ \hat{f}^{(1)}(x_1) = 2x_1, \qquad \hat{f}^{(2)}(x_1) = 3x_1, \qquad \hat{f}^{(3)}(x_1) = 4x_1, \] e o PDP é a média, \(\bar{f}_1(x_1) = 3x_1\). O PDP sozinho sugeriria um efeito linear de inclinação 3 para todos; as curvas ICE, com inclinações diferentes, revelam a interação entre \(x_1\) e \(x_2\).
O PDP avalia o modelo em combinações \((\mathbf{x}_S, \mathbf{x}_{iC})\) que podem ser muito improváveis quando \(\mathbf{X}_S\) e \(\mathbf{X}_C\) são correlacionadas — o mesmo problema da importância por permutação. Nesses casos, os gráficos de efeitos locais acumulados (ALE) são uma alternativa mais segura. Além disso, nenhum desses gráficos tem interpretação causal: eles descrevem o comportamento do modelo, não o efeito de intervir em \(\mathbf{x}_S\).
12.8.3 Valores de Shapley e SHAP
Os valores de Shapley vêm da teoria dos jogos cooperativos (Shapley 1953). Considere um “jogo” com jogadores \(N = \{1, \ldots, p\}\) e uma função característica \(v(S)\) que dá o “ganho” obtido por cada coalizão \(S \subseteq N\). O valor de Shapley do jogador \(j\) é a média de sua contribuição marginal \(v(S \cup \{j\}) - v(S)\) sobre todas as ordens possíveis de entrada dos jogadores: \[ \phi_j = \sum_{S \subseteq N \setminus \{j\}} \frac{|S|!\,(p - |S| - 1)!}{p!}\,\big[v(S \cup \{j\}) - v(S)\big]. \] Shapley provou que essa é a única forma de repartir \(v(N) - v(\emptyset)\) que satisfaz quatro axiomas: eficiência (\(\sum_j \phi_j = v(N) - v(\emptyset)\)), simetria (jogadores com contribuições idênticas recebem o mesmo valor), jogador nulo (quem nunca contribui recebe zero) e aditividade (o valor de um jogo soma de dois jogos é a soma dos valores).
Para explicar a predição de um modelo em um ponto \(\mathbf{x}\), os “jogadores” são as variáveis e \(v(S) = E[\hat{f}(\mathbf{X}) \mid \mathbf{X}_S = \mathbf{x}_S]\) é a predição esperada quando só conhecemos as variáveis em \(S\). Pela eficiência, \(\hat{f}(\mathbf{x}) = E[\hat{f}(\mathbf{X})] + \sum_j \phi_j\): a predição é decomposta em uma linha de base mais uma contribuição de cada variável. Scott M. Lundberg e Lee (2017) chamaram essa abordagem de SHAP e Scott M. Lundberg et al. (2020) desenvolveram o TreeSHAP, um algoritmo que calcula os valores exatamente e em tempo polinomial para conjuntos de árvores.
Exemplo resolvido. Um modelo de risco de crédito com três variáveis produz, para um cliente, as seguintes predições esperadas (probabilidade de inadimplência) conforme as variáveis conhecidas:
| Coalizão \(S\) | \(\emptyset\) | \(\{1\}\) | \(\{2\}\) | \(\{3\}\) | \(\{1,2\}\) | \(\{1,3\}\) | \(\{2,3\}\) | \(\{1,2,3\}\) |
|---|---|---|---|---|---|---|---|---|
| \(v(S)\) | 0,30 | 0,50 | 0,40 | 0,30 | 0,70 | 0,55 | 0,40 | 0,80 |
Para \(p = 3\), os pesos são \(1/3\) para \(|S| = 0\), \(1/6\) para \(|S| = 1\) e \(1/3\) para \(|S| = 2\). Para a variável 1: \[ \phi_1 = \tfrac{1}{3}(0{,}50 - 0{,}30) + \tfrac{1}{6}(0{,}70 - 0{,}40) + \tfrac{1}{6}(0{,}55 - 0{,}30) + \tfrac{1}{3}(0{,}80 - 0{,}40) = 0{,}0667 + 0{,}05 + 0{,}0417 + 0{,}1333 = 0{,}2917. \] Analogamente, \[ \phi_2 = \tfrac{1}{3}(0{,}10) + \tfrac{1}{6}(0{,}20) + \tfrac{1}{6}(0{,}10) + \tfrac{1}{3}(0{,}25) = 0{,}1667, \qquad \phi_3 = \tfrac{1}{3}(0) + \tfrac{1}{6}(0{,}05) + \tfrac{1}{6}(0) + \tfrac{1}{3}(0{,}10) = 0{,}0417. \] Verificando a eficiência: \(0{,}2917 + 0{,}1667 + 0{,}0417 = 0{,}50 = 0{,}80 - 0{,}30\). A predição de 80% para esse cliente se decompõe em uma taxa de base de 30%, mais 29,2 pontos percentuais atribuídos à variável 1, 16,7 à variável 2 e 4,2 à variável 3. Note que a variável 3 sozinha não altera a predição (\(v(\{3\}) = v(\emptyset)\)), mas recebe crédito positivo por sua contribuição em conjunto com a variável 1 — os valores de Shapley repartem as interações de forma equitativa.
# pip install shap
import shap
explicador = shap.TreeExplainer(rf)          # rf: floresta já ajustada
valores = explicador(X_te)                   # valores SHAP para cada observação de teste
shap.plots.waterfall(valores[0, :, 1])       # decomposição da predição da 1a observação (classe 1)
shap.plots.beeswarm(valores[:, :, 1])        # visão global: distribuição dos efeitos
12.9 Hiperparâmetros
Uma razão do sucesso prático da Floresta Aleatória é que ela funciona bem com os valores padrão, exigindo pouco ajuste. Os principais hiperparâmetros são:
| Hiperparâmetro | Significado | randomForest (R) |
ranger (R) |
scikit-learn (Python) |
|---|---|---|---|---|
| Número de árvores \(B\) | Quantidade de árvores no conjunto | ntree = 500 |
num.trees = 500 |
n_estimators = 100 |
| Variáveis por nó \(m\) | Tamanho do subconjunto sorteado | mtry = \(\lfloor\sqrt{p}\rfloor\) (classif.), \(\lfloor p/3 \rfloor\) (regr.) |
mtry = \(\lfloor\sqrt{p}\rfloor\) |
max_features = "sqrt" |
| Tamanho mínimo do nó | Controla a profundidade | nodesize = 1 (classif.), 5 (regr.) |
min.node.size |
min_samples_leaf = 1 |
| Profundidade máxima | Limite direto de profundidade | maxnodes |
max.depth |
max_depth = None |
| Tamanho da amostra | Fração / reposição das amostras | sampsize, replace = TRUE |
sample.fraction, replace |
max_samples, bootstrap = True |
Algumas orientações:
- \(B\) (número de árvores): não é propriamente um parâmetro de ajuste, pois aumentar \(B\) não causa sobreajuste. Basta escolher um valor grande o suficiente para que o erro OOB se estabilize (centenas a poucos milhares de árvores).
- \(m\) (
mtry): é o hiperparâmetro mais influente. Os padrões \(\sqrt{p}\) (classificação) e \(p/3\) (regressão) são bons pontos de partida; quando há muitas variáveis irrelevantes, valores maiores de \(m\) podem ser melhores, pois aumentam a chance de uma variável relevante estar entre as candidatas. - Tamanho mínimo do nó / profundidade: árvores profundas (nós pequenos) são o padrão; limitar a profundidade reduz a variância de cada árvore e o custo computacional, ao preço de algum viés.
- Desbalanceamento de classes: é possível usar pesos por classe (
class_weight="balanced"noscikit-learn,classwtnorandomForest) ou amostragem estratificada balanceada (strataesampsizenorandomForest).
Uma variante relacionada são as Árvores Extremamente Aleatorizadas (Extra Trees) (Geurts, Ernst, e Wehenkel 2006), que, além de sortear variáveis, sorteiam também os pontos de corte, reduzindo ainda mais a correlação e o custo computacional. Ela é detalhada na próxima seção.
12.10 Variantes e Extensões da Floresta Aleatória
12.10.1 Árvores extremamente aleatorizadas
No algoritmo Extra Trees de Geurts, Ernst, e Wehenkel (2006), cada nó é dividido da seguinte forma:
- sorteiam-se \(K\) variáveis candidatas (o análogo de \(m\));
- para cada candidata \(x_j\), sorteia-se um único ponto de corte \(s_j\) uniformemente no intervalo \([\min x_j, \max x_j]\) dos valores do nó;
- entre as \(K\) divisões aleatórias \((j, s_j)\), escolhe-se a de maior decréscimo de impureza.
Além disso, por padrão, cada árvore é ajustada à amostra completa, sem bootstrap. A ideia é que a aleatorização dos cortes já gera diversidade suficiente; usar todos os dados reduz o viés de cada árvore. Em termos da decomposição \(\rho\sigma^2 + (1-\rho)\sigma^2/B\), as árvores ficam ainda menos correlacionadas que as da Floresta Aleatória, ao custo de um pequeno aumento de viés individual. Duas vantagens adicionais são o custo computacional (não é preciso ordenar os dados para buscar o melhor corte) e o fato de que, com muitas árvores, a função estimada fica mais suave, pois os limiares se espalham continuamente em vez de se concentrarem nos pontos médios entre observações. No caso extremo \(K = 1\), obtêm-se árvores totalmente aleatorizadas, cuja estrutura não depende da resposta. No scikit-learn, a classe é ExtraTreesClassifier; no ranger, usa-se splitrule = "extratrees".
12.10.2 Florestas como vizinhos mais próximos adaptativos
Para regressão, a floresta prediz a média das predições das árvores, e cada árvore prediz a média das respostas de sua folha. Combinando as duas médias, a predição da floresta em \(\mathbf{x}\) é uma média ponderada das respostas de treino: \[ \hat{f}_{\text{rf}}(\mathbf{x}) = \sum_{i=1}^{n} w_i(\mathbf{x})\, y_i, \qquad w_i(\mathbf{x}) = \frac{1}{B}\sum_{b=1}^{B} \frac{\mathbb{I}\{\mathbf{x}_i \in L_b(\mathbf{x})\}}{|L_b(\mathbf{x})|}, \] em que \(L_b(\mathbf{x})\) é a folha da árvore \(b\) que contém \(\mathbf{x}\) (ignorando, para simplificar, as repetições do bootstrap). Os pesos são não negativos e somam 1. Lin e Jeon (2006) exploraram essa representação para mostrar que a floresta é um método de vizinhos mais próximos adaptativo: os “vizinhos” de \(\mathbf{x}\) são as observações que costumam cair em suas folhas, e a vizinhança se estica nas direções de variáveis irrelevantes e se contrai nas direções de variáveis importantes. Essa representação também mostra por que a floresta não extrapola: a predição é sempre uma média de respostas observadas.
12.10.3 Florestas de regressão quantílica
Meinshausen (2006) observou que os mesmos pesos estimam a distribuição condicional inteira, e não apenas a média: \[ \hat{F}(y \mid \mathbf{x}) = \sum_{i=1}^{n} w_i(\mathbf{x})\, \mathbb{I}\{y_i \leq y\}, \qquad \hat{Q}_\tau(\mathbf{x}) = \inf\{y : \hat{F}(y \mid \mathbf{x}) \geq \tau\}. \] A única modificação no algoritmo é que cada folha deve guardar todas as respostas de treino, e não apenas sua média. Os quantis condicionais permitem construir intervalos de predição, por exemplo \([\hat{Q}_{0{,}05}(\mathbf{x}),\ \hat{Q}_{0{,}95}(\mathbf{x})]\) para 90%, e Meinshausen provou a consistência do estimador \(\hat{F}\) sob condições de regularidade.
Exemplo resolvido. Uma floresta com \(B = 2\) árvores foi treinada com 6 observações. Para um novo ponto \(\mathbf{x}_0\), a folha da árvore 1 contém as observações \(\{1, 2, 3\}\) e a da árvore 2 contém \(\{2, 4\}\). Os pesos são \[ w_1 = \tfrac{1}{2}\cdot\tfrac{1}{3} = \tfrac{1}{6}, \quad w_2 = \tfrac{1}{2}\left(\tfrac{1}{3} + \tfrac{1}{2}\right) = \tfrac{5}{12}, \quad w_3 = \tfrac{1}{6}, \quad w_4 = \tfrac{1}{2}\cdot\tfrac{1}{2} = \tfrac{1}{4}, \quad w_5 = w_6 = 0, \] que somam \(\frac{2 + 5 + 2 + 3}{12} = 1\). Se \(y_1 = 10\), \(y_2 = 12\), \(y_3 = 15\) e \(y_4 = 30\), a predição da média é \(\frac{10}{6} + \frac{5 \cdot 12}{12} + \frac{15}{6} + \frac{30}{4} \approx 16{,}67\). A distribuição acumulada estimada vale \(1/6 \approx 0{,}167\) em \(y = 10\), \(7/12 \approx 0{,}583\) em \(y = 12\), \(0{,}75\) em \(y = 15\) e \(1\) em \(y = 30\). Logo, a mediana condicional estimada é \(\hat{Q}_{0{,}5} = 12\) e o quantil de 90% é \(\hat{Q}_{0{,}9} = 30\): a distribuição condicional é assimétrica à direita, algo que a média sozinha não revelaria.
# Regressão quantílica com ranger: quantreg = TRUE guarda as respostas das folhas
library(ranger)
rf_q <- ranger(mpg ~ ., data = mtcars, num.trees = 1000,
               quantreg = TRUE, keep.inbag = TRUE, seed = 1)
predict(rf_q, data = mtcars[1:3, ], type = "quantiles",
        quantiles = c(0.05, 0.5, 0.95))$predictions
12.10.4 Dados desbalanceados: florestas balanceadas e ponderadas
Quando uma classe é rara (fraudes, doenças raras), as amostras bootstrap contêm poucos exemplos dela, as árvores crescem dominadas pela classe majoritária e o voto majoritário raramente prediz a classe minoritária. C. Chen, Liaw, e Breiman (2004) propuseram duas soluções:
- Floresta aleatória balanceada (balanced random forest): em cada árvore, sorteia-se uma amostra bootstrap estratificada, com o mesmo número de observações de cada classe (tipicamente, o tamanho da classe minoritária). Cada árvore vê um problema balanceado, e o conjunto de árvores, em conjunto, usa toda a classe majoritária.
- Floresta aleatória ponderada (weighted random forest): atribui-se peso maior à classe minoritária tanto no critério de divisão (Gini ponderado) quanto no voto das folhas.
Em qualquer caso, é fundamental avaliar o modelo com métricas adequadas ao desbalanceamento (sensibilidade, precisão, \(F_1\), área sob a curva precisão-revocação) e ajustar o limiar de decisão sobre as probabilidades estimadas, como discutido no Capítulo de Introdução ao Aprendizado de Máquina.
library(randomForest)
library(MASS)                             # conjunto Pima.tr (diabetes)
n_min <- min(table(Pima.tr$type))         # tamanho da classe minoritária
rf_bal <- randomForest(type ~ ., data = Pima.tr, ntree = 500,
                       strata = Pima.tr$type,
                       sampsize = c(n_min, n_min))   # bootstrap balanceado
rf_bal$confusion
from imblearn.ensemble import BalancedRandomForestClassifier # pip install imbalanced-learn
from sklearn.ensemble import RandomForestClassifier
brf = BalancedRandomForestClassifier(n_estimators=500, sampling_strategy="all",
replacement=True, bootstrap=False, random_state=42)
rf_pond = RandomForestClassifier(n_estimators=500, class_weight="balanced_subsample",
random_state=42)12.11 Boosting
O boosting é a outra grande família de conjuntos de árvores. Nele, as árvores são construídas sequencialmente: cada nova árvore é ajustada para corrigir os erros das anteriores — no AdaBoost (Freund e Schapire 1997), aumentando o peso das observações mal classificadas; no gradient boosting (J. H. Friedman 2001), ajustando a nova árvore aos resíduos (mais precisamente, ao gradiente negativo da função de perda). O modelo final é uma soma ponderada das árvores, \(F_B(\mathbf{x}) = \sum_{b=1}^{B} \nu\, h_b(\mathbf{x})\), em que \(\nu\) é a taxa de aprendizado.
12.11.1 Origem: aprendizes fracos e fortes
O boosting nasceu de uma pergunta teórica formulada por Kearns e Valiant no fim dos anos 1980: um aprendiz fraco — um algoritmo que, para qualquer distribuição dos dados, produz um classificador apenas ligeiramente melhor que o acaso (erro \(\leq 1/2 - \gamma\), com \(\gamma > 0\)) — pode ser transformado em um aprendiz forte, com erro arbitrariamente pequeno? Schapire (1990) respondeu afirmativamente, com uma construção engenhosa que treinava classificadores em distribuições modificadas dos dados. O AdaBoost (Adaptive Boosting) de Freund e Schapire (1997) tornou a ideia prática e se tornou um dos algoritmos mais influentes do aprendizado de máquina, rendendo aos autores o Prêmio Gödel de 2003.
12.11.2 O algoritmo AdaBoost
Entrada: dados \(\{(\mathbf{x}_i, y_i)\}_{i=1}^n\) com \(y_i \in \{-1, +1\}\); número de iterações \(M\); um aprendiz fraco (por exemplo, tocos de decisão — árvores com uma única divisão).
- Inicialize os pesos \(w_i^{(1)} = 1/n\), \(i = 1, \ldots, n\).
- Para \(m = 1, \ldots, M\):
- Ajuste o classificador \(h_m(\mathbf{x}) \in \{-1, +1\}\) aos dados ponderados por \(w^{(m)}\).
- Calcule o erro ponderado \(\varepsilon_m = \sum_{i} w_i^{(m)}\, \mathbb{I}\{y_i \neq h_m(\mathbf{x}_i)\}\).
- Calcule o peso do classificador \(\alpha_m = \frac{1}{2}\ln\frac{1 - \varepsilon_m}{\varepsilon_m}\).
- Atualize os pesos: \(w_i^{(m+1)} = w_i^{(m)} \exp\{-\alpha_m\, y_i\, h_m(\mathbf{x}_i)\} / Z_m\), em que \(Z_m\) é a constante que faz os pesos somarem 1.
- Saída: \(\hat{C}(\mathbf{x}) = \operatorname{sinal}\big(F_M(\mathbf{x})\big)\), com \(F_M(\mathbf{x}) = \sum_{m=1}^{M} \alpha_m h_m(\mathbf{x})\).
Observe que \(\alpha_m > 0\) sempre que \(\varepsilon_m < 1/2\), e que \(\alpha_m\) cresce à medida que \(\varepsilon_m\) diminui: classificadores melhores têm voto maior. Na atualização, observações mal classificadas (\(y_i h_m(\mathbf{x}_i) = -1\)) têm o peso multiplicado por \(e^{\alpha_m} > 1\), e as bem classificadas, por \(e^{-\alpha_m} < 1\). Uma conta simples mostra que, após a renormalização, as observações mal classificadas passam a somar exatamente \(1/2\) do peso total: o classificador \(h_m\) fica com erro ponderado de exatamente 50% na nova distribuição, e \(h_{m+1}\) é forçado a aprender algo diferente.
12.11.3 Exemplo resolvido: AdaBoost com tocos
Considere dez pontos na reta, \(x = 1, 2, \ldots, 10\), com rótulos
| \(x\) | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| \(y\) | + | + | + | − | − | − | + | + | + | − |
Nenhum toco (“se \(x \leq s\), então \(\pm 1\); caso contrário, \(\mp 1\)”) classifica esses dados perfeitamente; o melhor erra 3 pontos.
Iteração 1. Com pesos iguais a \(0{,}1\), os tocos “\(x \leq 3{,}5 \Rightarrow +\)” (que erra \(x = 7, 8, 9\)) e “\(x \leq 9{,}5 \Rightarrow +\)” (que erra \(x = 4, 5, 6\)) empatam com erro 0,3; escolhemos o primeiro. Então \(\varepsilon_1 = 0{,}3\) e \(\alpha_1 = \frac{1}{2}\ln\frac{0{,}7}{0{,}3} \approx 0{,}4236\). Os pesos dos 7 pontos corretos passam a \(\frac{0{,}1\, e^{-\alpha_1}}{Z_1} = \frac{1}{14} \approx 0{,}0714\), e os dos 3 incorretos, a \(\frac{1}{6} \approx 0{,}1667\), com \(Z_1 = 2\sqrt{0{,}3 \times 0{,}7} \approx 0{,}9165\). Note que \(3 \times \frac{1}{6} = \frac{1}{2}\).
Iteração 2. Agora errar \(x = 7, 8, 9\) é caro. O melhor toco é “\(x \leq 9{,}5 \Rightarrow +\)”, que erra \(x = 4, 5, 6\), com \(\varepsilon_2 = 3/14 \approx 0{,}2143\) e \(\alpha_2 \approx 0{,}6496\). Os novos pesos são \(1/22 \approx 0{,}0455\) para \(x \in \{1, 2, 3, 10\}\), \(1/6 \approx 0{,}1667\) para \(x \in \{4, 5, 6\}\) e \(7/66 \approx 0{,}1061\) para \(x \in \{7, 8, 9\}\).
Iteração 3. O melhor toco é “\(x \leq 6{,}5 \Rightarrow -\)”, que erra \(x = 1, 2, 3, 10\), com \(\varepsilon_3 = 4/22 \approx 0{,}1818\) e \(\alpha_3 \approx 0{,}7520\).
O classificador combinado \(F_3(x) = 0{,}4236\, h_1(x) + 0{,}6496\, h_2(x) + 0{,}7520\, h_3(x)\) assume os valores
| \(x\) | 1–3 | 4–6 | 7–9 | 10 |
|---|---|---|---|---|
| \(F_3(x)\) | \(+0{,}321\) | \(-0{,}526\) | \(+0{,}978\) | \(-0{,}321\) |
| \(\operatorname{sinal}(F_3)\) | + | − | + | − |
e classifica corretamente todos os dez pontos, embora cada toco, sozinho, erre pelo menos 30% deles. A soma de três funções-degrau produziu uma função com quatro patamares, algo que nenhum toco consegue representar: o boosting reduz o viés do aprendiz fraco.
12.11.4 Limite para o erro de treinamento
O erro de treinamento do AdaBoost satisfaz \[ \frac{1}{n}\sum_{i=1}^{n} \mathbb{I}\{y_i \neq \operatorname{sinal}(F_M(\mathbf{x}_i))\} \leq \prod_{m=1}^{M} Z_m = \prod_{m=1}^{M} 2\sqrt{\varepsilon_m(1 - \varepsilon_m)} \leq \exp\left(-2\sum_{m=1}^{M} \gamma_m^2\right), \] em que \(\gamma_m = 1/2 - \varepsilon_m\) é a “vantagem” do \(m\)-ésimo classificador sobre o acaso.
Demonstração. (i) Se \(y_i \neq \operatorname{sinal}(F_M(\mathbf{x}_i))\), então \(y_i F_M(\mathbf{x}_i) \leq 0\) e \(e^{-y_i F_M(\mathbf{x}_i)} \geq 1\); logo \(\mathbb{I}\{\text{erro}\} \leq e^{-y_i F_M(\mathbf{x}_i)}\). (ii) Desenrolando a atualização dos pesos, \(w_i^{(M+1)} = \frac{1}{n}\, e^{-y_i F_M(\mathbf{x}_i)} \big/ \prod_m Z_m\); como os pesos somam 1, \(\frac{1}{n}\sum_i e^{-y_i F_M(\mathbf{x}_i)} = \prod_m Z_m\). (iii) Para cada \(m\), \(Z_m = (1 - \varepsilon_m)e^{-\alpha_m} + \varepsilon_m e^{\alpha_m}\), que, com o valor de \(\alpha_m\) do algoritmo, vale \(2\sqrt{\varepsilon_m(1-\varepsilon_m)} = \sqrt{1 - 4\gamma_m^2}\). (iv) Por fim, \(1 + x \leq e^{x}\) dá \(\sqrt{1 - 4\gamma_m^2} \leq e^{-2\gamma_m^2}\). \(\blacksquare\)
Se cada classificador tem vantagem de pelo menos \(\gamma > 0\), o erro de treinamento cai exponencialmente, como \(e^{-2M\gamma^2}\). No exemplo anterior, \(\prod Z_m = 0{,}9165 \times 0{,}8207 \times 0{,}7714 \approx 0{,}580\) e o limite exponencial vale \(\exp\{-2(0{,}2^2 + 0{,}2857^2 + 0{,}3182^2)\} \approx 0{,}640\); o erro efetivo é zero, abaixo de ambos. O teorema fala do erro de treinamento; o comportamento no teste é explicado, em parte, pela teoria das margens: o AdaBoost continua aumentando as margens \(y_i F_M(\mathbf{x}_i)\) mesmo depois de o erro de treino chegar a zero, o que tende a melhorar a generalização. Ainda assim, com dados ruidosos o AdaBoost pode sobreajustar, pois insiste exponencialmente nas observações mal rotuladas.
12.11.5 AdaBoost como modelagem aditiva com perda exponencial
Por muitos anos o sucesso do AdaBoost pareceu misterioso, até que J. Friedman, Hastie, e Tibshirani (2000) mostraram que ele é um caso particular de um procedimento estatístico clássico: a modelagem aditiva por etapas (forward stagewise additive modeling). Nela, constrói-se \(F_M(\mathbf{x}) = \sum_m \beta_m h_m(\mathbf{x})\) adicionando um termo por vez, sem reajustar os anteriores: \[ (\beta_m, h_m) = \arg\min_{\beta, h} \sum_{i=1}^{n} L\big(y_i,\ F_{m-1}(\mathbf{x}_i) + \beta\, h(\mathbf{x}_i)\big). \]
Com a perda exponencial \(L(y, F) = e^{-yF}\) e \(w_i^{(m)} = e^{-y_i F_{m-1}(\mathbf{x}_i)}\) (que não depende de \(\beta\) nem de \(h\)), \[ \sum_i w_i^{(m)} e^{-\beta y_i h(\mathbf{x}_i)} = e^{-\beta}\sum_{i : y_i = h(\mathbf{x}_i)} w_i^{(m)} + e^{\beta}\sum_{i : y_i \neq h(\mathbf{x}_i)} w_i^{(m)} = \big(e^{\beta} - e^{-\beta}\big)\sum_i w_i^{(m)} \mathbb{I}\{y_i \neq h(\mathbf{x}_i)\} + e^{-\beta}\sum_i w_i^{(m)}. \] Para qualquer \(\beta > 0\) fixo, o \(h\) ótimo é o que minimiza o erro ponderado — o passo 2a do AdaBoost. Dado \(h_m\), derivando em relação a \(\beta\) e igualando a zero, obtém-se \(e^{2\beta}\varepsilon_m = 1 - \varepsilon_m\), ou seja, \(\beta_m = \frac{1}{2}\ln\frac{1-\varepsilon_m}{\varepsilon_m}\) — exatamente o \(\alpha_m\) do passo 2c. Por fim, \(w_i^{(m+1)} = w_i^{(m)} e^{-\beta_m y_i h_m(\mathbf{x}_i)}\), que é a atualização do passo 2d. O AdaBoost minimiza, de forma gulosa, a perda exponencial.
Que função o AdaBoost estima? Minimizando a perda esperada condicional \(E[e^{-YF} \mid \mathbf{x}] = p(\mathbf{x})e^{-F} + (1 - p(\mathbf{x}))e^{F}\), em que \(p(\mathbf{x}) = P(Y = 1 \mid \mathbf{x})\), obtém-se \[ F^{*}(\mathbf{x}) = \frac{1}{2}\ln\frac{p(\mathbf{x})}{1 - p(\mathbf{x})}, \qquad\text{ou seja,}\qquad p(\mathbf{x}) = \frac{1}{1 + e^{-2F^{*}(\mathbf{x})}}. \] O AdaBoost estima metade do log-odds, a mesma quantidade modelada pela regressão logística (Capítulo de Modelos de Regressão). Essa conexão permite converter a saída do AdaBoost em probabilidades e sugere substituir a perda exponencial pela deviance binomial \(\ln(1 + e^{-2yF})\), que tem o mesmo minimizador populacional mas cresce apenas linearmente para margens muito negativas, sendo mais robusta a rótulos errados.
12.11.6 Gradient boosting: descida do gradiente no espaço de funções
J. H. Friedman (2001) generalizou a ideia para qualquer perda diferenciável. Pense no vetor de predições \(\mathbf{F} = (F(\mathbf{x}_1), \ldots, F(\mathbf{x}_n))\) como o parâmetro a ser otimizado. A descida do gradiente atualizaria \(\mathbf{F} \leftarrow \mathbf{F} - \nu\, \nabla_{\mathbf{F}} \sum_i L(y_i, F(\mathbf{x}_i))\), mas isso só define \(F\) nos pontos de treino. A solução é ajustar uma árvore de regressão ao gradiente negativo, o que generaliza o passo para todo o espaço.
- Inicialize com uma constante: \(F_0(\mathbf{x}) = \arg\min_\gamma \sum_i L(y_i, \gamma)\).
- Para \(m = 1, \ldots, M\):
- Calcule os pseudo-resíduos \(r_{im} = -\left[\frac{\partial L(y_i, F)}{\partial F}\right]_{F = F_{m-1}(\mathbf{x}_i)}\), \(i = 1, \ldots, n\).
- Ajuste uma árvore de regressão com \(J\) folhas aos pares \((\mathbf{x}_i, r_{im})\), obtendo as regiões \(R_{jm}\), \(j = 1, \ldots, J\).
- Para cada folha, calcule o valor ótimo \(\gamma_{jm} = \arg\min_\gamma \sum_{\mathbf{x}_i \in R_{jm}} L\big(y_i, F_{m-1}(\mathbf{x}_i) + \gamma\big)\).
- Atualize \(F_m(\mathbf{x}) = F_{m-1}(\mathbf{x}) + \nu \sum_{j=1}^{J} \gamma_{jm}\, \mathbb{I}\{\mathbf{x} \in R_{jm}\}\), com taxa de aprendizado \(0 < \nu \leq 1\).
- Saída: \(F_M\).
Os pseudo-resíduos dependem da perda escolhida:
| Perda | \(L(y, F)\) | Pseudo-resíduo \(-\partial L / \partial F\) | Uso |
|---|---|---|---|
| Quadrática | \(\frac{1}{2}(y - F)^2\) | \(y - F\) (o resíduo usual) | Regressão |
| Absoluta | \(\lvert y - F \rvert\) | \(\operatorname{sinal}(y - F)\) | Regressão robusta |
| Deviance binomial | \(-[yF - \ln(1 + e^{F})]\), \(y \in \{0, 1\}\) | \(y - p\), com \(p = \frac{1}{1 + e^{-F}}\) | Classificação binária |
| Exponencial | \(e^{-yF}\), \(y \in \{-1, 1\}\) | \(y\, e^{-yF}\) | Equivale ao AdaBoost |
Com perda quadrática, o algoritmo consiste literalmente em ajustar árvores aos resíduos do modelo atual. Na classificação com deviance binomial, \(F\) é o log-odds e o pseudo-resíduo é a diferença entre o rótulo observado e a probabilidade predita.
Exemplo resolvido (perda quadrática). Considere seis observações com \(x = 1, \ldots, 6\) e \(y = (1{,}0;\ 1{,}5;\ 2{,}0;\ 5{,}0;\ 5{,}5;\ 7{,}0)\), tocos como aprendizes e \(\nu = 0{,}5\).
- \(F_0 = \bar{y} = 22/6 \approx 3{,}667\); a soma de quadrados dos resíduos é \(30{,}83\).
- Iteração 1. Os resíduos são \(r = (-2{,}667;\ -2{,}167;\ -1{,}667;\ 1{,}333;\ 1{,}833;\ 3{,}333)\). O melhor toco divide em \(x \leq 3{,}5\), com médias \(-2{,}167\) (esquerda) e \(+2{,}167\) (direita). Assim, \(F_1 = 3{,}667 \mp 0{,}5 \times 2{,}167\), isto é, \(F_1 = 2{,}583\) para \(x \leq 3\) e \(4{,}750\) para \(x \geq 4\). A soma de quadrados cai para \(9{,}71\).
- Iteração 2. Os novos resíduos são \((-1{,}583;\ -1{,}083;\ -0{,}583;\ 0{,}25;\ 0{,}75;\ 2{,}25)\). O melhor toco é novamente \(x \leq 3{,}5\), com médias \(\mp 1{,}083\), e \(F_2 = 2{,}042\) (para \(x \leq 3\)) e \(5{,}292\) (para \(x \geq 4\)). A soma de quadrados cai para \(4{,}43\).
- Iteração 3. Os resíduos passam a ser dominados pela última observação (\(y_6 - F_2 = 1{,}708\)), e o melhor toco agora divide em \(x \leq 5{,}5\); a soma de quadrados cai para \(1{,}80\).
Com \(\nu = 1\), a iteração 1 já levaria \(F\) às médias dos dois grupos; com \(\nu = 0{,}5\), o modelo “anda metade do caminho” a cada passo. Essa lentidão deliberada é a principal forma de regularização do boosting.
12.11.7 Regularização do gradient boosting
Ao contrário da Floresta Aleatória, o gradient boosting sobreajusta se \(M\) for grande demais, pois cada nova árvore se ajusta a resíduos cada vez mais dominados por ruído. Os principais mecanismos de controle são:
- Encolhimento (shrinkage): a taxa de aprendizado \(\nu\) (tipicamente entre 0,01 e 0,1). Valores menores exigem mais árvores, mas quase sempre generalizam melhor; \(\nu\) e \(M\) devem ser ajustados em conjunto.
- Número de iterações \(M\), escolhido por validação cruzada ou por parada antecipada (early stopping) em um conjunto de validação.
- Tamanho das árvores: árvores com \(J\) folhas capturam interações de ordem até \(J - 1\); na prática, profundidades entre 2 e 8 bastam. Com tocos (\(J = 2\)), o modelo é aditivo nas variáveis.
- Subamostragem (stochastic gradient boosting): J. H. Friedman (2002) propôs ajustar cada árvore a uma subamostra sem reposição de, digamos, 50% das observações, o que reduz a variância e o custo computacional. Implementações modernas também sorteiam colunas, à moda da Floresta Aleatória.
12.11.8 XGBoost: objetivo regularizado e aproximação de segunda ordem
O XGBoost de T. Chen e Guestrin (2016) tornou-se popular por sua eficiência e por vencer inúmeras competições de dados tabulares. Sua principal ideia teórica é escrever explicitamente um objetivo regularizado e otimizá-lo com uma aproximação de segunda ordem. Na iteração \(m\), busca-se a árvore \(f\) que minimiza \[ \mathcal{L}^{(m)} = \sum_{i=1}^{n} L\big(y_i,\ \hat{y}_i^{(m-1)} + f(\mathbf{x}_i)\big) + \Omega(f), \qquad \Omega(f) = \gamma\, T + \frac{\lambda}{2}\sum_{j=1}^{T} w_j^2, \] em que \(T\) é o número de folhas e \(w_j\) é o valor da folha \(j\). A penalidade \(\gamma T\) desestimula árvores grandes (como na poda por custo-complexidade) e \(\lambda\) encolhe os valores das folhas (como na regressão ridge). Expandindo a perda em série de Taylor até segunda ordem em torno de \(\hat{y}_i^{(m-1)}\), com \(g_i = \partial L / \partial \hat{y}\) e \(h_i = \partial^2 L / \partial \hat{y}^2\) avaliados em \(\hat{y}_i^{(m-1)}\), \[ \mathcal{L}^{(m)} \approx \text{const} + \sum_{i=1}^{n}\left[g_i f(\mathbf{x}_i) + \frac{1}{2} h_i f(\mathbf{x}_i)^2\right] + \gamma T + \frac{\lambda}{2}\sum_{j=1}^{T} w_j^2. \] Como \(f(\mathbf{x}_i) = w_j\) para \(\mathbf{x}_i\) na folha \(j\), agrupando por folha, com \(G_j = \sum_{i \in j} g_i\) e \(H_j = \sum_{i \in j} h_i\), \[ \mathcal{L}^{(m)} \approx \text{const} + \sum_{j=1}^{T}\left[G_j w_j + \frac{1}{2}(H_j + \lambda) w_j^2\right] + \gamma T. \] Cada termo é uma parábola em \(w_j\), minimizada em \[ w_j^{*} = -\frac{G_j}{H_j + \lambda}, \qquad \mathcal{L}^{*} = -\frac{1}{2}\sum_{j=1}^{T} \frac{G_j^2}{H_j + \lambda} + \gamma T. \] O valor \(\mathcal{L}^{*}\) funciona como uma medida de impureza da estrutura da árvore, e o ganho de dividir uma folha em esquerda (L) e direita (R) é \[ \text{Ganho} = \frac{1}{2}\left[\frac{G_L^2}{H_L + \lambda} + \frac{G_R^2}{H_R + \lambda} - \frac{(G_L + G_R)^2}{H_L + H_R + \lambda}\right] - \gamma. \] Uma divisão só é feita se o ganho for positivo: \(\gamma\) age como um decréscimo mínimo exigido, e a poda é incorporada ao próprio crescimento.
Exemplo resolvido. Classificação binária com perda logística, \(L = -[y \ln p + (1-y)\ln(1-p)]\) com \(p = 1/(1 + e^{-\hat{y}})\), para a qual \(g_i = p_i - y_i\) e \(h_i = p_i(1 - p_i)\). Uma folha contém quatro observações com rótulos \(y = (1, 1, 1, 0)\) e predição atual \(\hat{y} = 0\) (isto é, \(p = 0{,}5\) para todas). Então \(g = (-0{,}5;\ -0{,}5;\ -0{,}5;\ 0{,}5)\), \(h_i = 0{,}25\), \(G = -1\) e \(H = 1\). Com \(\lambda = 1\): \[ w^{*} = -\frac{-1}{1 + 1} = 0{,}5. \] A folha passa a somar \(0{,}5\) ao log-odds dessas observações. Considere agora dividir a folha em \(\{y = 1, 1, 1\}\) e \(\{y = 0\}\): \(G_L = -1{,}5\), \(H_L = 0{,}75\), \(G_R = 0{,}5\), \(H_R = 0{,}25\), e \[ \text{Ganho} = \frac{1}{2}\left[\frac{2{,}25}{1{,}75} + \frac{0{,}25}{1{,}25} - \frac{1}{2}\right] - \gamma = \frac{1}{2}\left[1{,}2857 + 0{,}2 - 0{,}5\right] - \gamma \approx 0{,}493 - \gamma. \] A divisão é feita se \(\gamma < 0{,}493\), e os valores das novas folhas seriam \(w_L^{*} = 1{,}5/1{,}75 \approx 0{,}857\) e \(w_R^{*} = -0{,}5/1{,}25 = -0{,}4\). Observe o efeito de \(\lambda\): sem regularização (\(\lambda = 0\)), a folha direita, com uma única observação, receberia \(w_R^{*} = -0{,}5/0{,}25 = -2\), um valor bem mais extremo.
Além do objetivo regularizado, o XGBoost introduziu um algoritmo eficiente para dados esparsos (aprendendo uma direção padrão para valores ausentes em cada nó), a busca aproximada de cortes por quantis ponderados e otimizações de memória e paralelismo.
12.11.9 LightGBM e CatBoost
Duas outras implementações dominam a prática atual:
- LightGBM (Ke et al. 2017): discretiza as variáveis em histogramas (no máximo 255 faixas por padrão), o que torna a busca de cortes muito rápida; cresce as árvores por folha (leaf-wise), sempre dividindo a folha de maior ganho, em vez de nível a nível, o que reduz a perda mais rapidamente, mas exige limitar o número de folhas; e usa duas técnicas de amostragem: a GOSS (gradient-based one-side sampling), que mantém todas as observações com gradiente grande e subamostra as de gradiente pequeno, e o EFB (exclusive feature bundling), que agrupa variáveis esparsas que raramente são não nulas simultaneamente.
- CatBoost (Prokhorenkova et al. 2018): especializado em variáveis categóricas. Substitui cada categoria por uma estatística da resposta calculada apenas com observações “anteriores” em uma permutação aleatória (ordered target statistics), evitando o vazamento de informação da codificação pela média da resposta; usa também o ordered boosting, que corrige um viés sutil na estimação dos gradientes, e árvores simétricas (a mesma divisão em todos os nós de um nível), que são rápidas na predição e atuam como regularização.
12.11.10 Floresta Aleatória versus boosting
| Aspecto | Floresta Aleatória | Boosting |
|---|---|---|
| Construção das árvores | Paralela e independente | Sequencial, cada árvore depende das anteriores |
| Tipo de árvore | Profundas, sem poda | Rasas (poucos níveis) |
| Efeito principal | Redução de variância | Redução de viés (e de variância) |
| Sobreajuste ao aumentar \(B\) | Não ocorre | Pode ocorrer; \(B\) deve ser ajustado |
| Sensibilidade a hiperparâmetros | Baixa | Alta (taxa de aprendizado, profundidade, \(B\)) |
| Paralelização | Trivial | Limitada |
Em muitos problemas tabulares, implementações modernas de gradient boosting superam ligeiramente a Floresta Aleatória quando bem ajustadas; a Floresta Aleatória, por outro lado, oferece desempenho muito bom com quase nenhum ajuste, sendo um excelente modelo de referência (baseline).
12.12 Empilhamento (Stacking)
Bagging, florestas e boosting combinam modelos do mesmo tipo com pesos fixos (iguais, ou \(\alpha_m\)). O empilhamento (stacked generalization), proposto por Wolpert (1992), combina modelos diferentes — por exemplo, uma floresta, um gradient boosting, uma regressão logística e um k-NN — e aprende como combiná-los por meio de um segundo modelo, chamado metamodelo.
O ponto delicado é que o metamodelo não pode ser treinado com as predições dos modelos-base nos próprios dados em que eles foram ajustados: modelos que sobreajustam (como uma árvore profunda) pareceriam perfeitos e receberiam peso excessivo. A solução é usar predições fora da partição (out-of-fold):
- Divida os dados de treino em \(K\) partes.
- Para cada modelo-base \(\ell = 1, \ldots, L\) e cada parte \(k\), ajuste o modelo nas outras \(K - 1\) partes e prediga a parte \(k\). Ao final, cada observação \(i\) tem um vetor de predições \(\mathbf{z}_i = (\hat{f}_1^{(-k(i))}(\mathbf{x}_i), \ldots, \hat{f}_L^{(-k(i))}(\mathbf{x}_i))\) obtidas por modelos que não a viram.
- Ajuste o metamodelo \(g\) aos pares \((\mathbf{z}_i, y_i)\) — tipicamente um modelo simples, como uma regressão logística ou uma combinação linear com pesos não negativos.
- Reajuste cada modelo-base em todos os dados de treino. A predição final é \(g\big(\hat{f}_1(\mathbf{x}), \ldots, \hat{f}_L(\mathbf{x})\big)\).
O empilhamento funciona melhor quando os modelos-base são diversos (cometem erros diferentes), pela mesma lógica da decomposição da ambiguidade. Em problemas tabulares, o ganho sobre o melhor modelo individual costuma ser pequeno, mas consistente, e é por isso que o empilhamento é comum em competições; em contrapartida, o modelo final é mais caro e menos interpretável.
12.13 Vantagens e Limitações
Vantagens:
- Alto desempenho preditivo em grande variedade de problemas, com pouco ajuste de hiperparâmetros.
- Herdam das árvores a capacidade de lidar com variáveis numéricas e categóricas, interações e não linearidades, sem necessidade de normalização.
- Robustez ao sobreajuste em relação a uma árvore isolada; aumentar \(B\) não prejudica o modelo.
- Estimativa de erro OOB gratuita e medidas de importância de variáveis.
- Funcionam bem quando \(p\) é grande em relação a \(n\) (por exemplo, dados genômicos), pois cada nó considera apenas \(m\) variáveis.
- Treinamento facilmente paralelizável.
Limitações:
- Perda de interpretabilidade: não é possível visualizar centenas de árvores como um fluxograma; recorre-se a importâncias e a ferramentas de interpretação pós-hoc.
- Custo computacional e de memória: armazenar centenas de árvores profundas pode exigir muita memória; a predição é mais lenta que a de uma árvore única.
- Extrapolação: em regressão, as predições ficam limitadas ao intervalo dos valores observados da resposta (médias de folhas).
- Viés das importâncias (MDI) e dificuldades com preditores correlacionados.
- Probabilidades nem sempre bem calibradas; pode ser necessário calibrá-las.
12.14 Implementação em R com randomForest e ranger
12.14.1 Pacote randomForest
O pacote randomForest (Liaw e Wiener 2002) é a implementação em R baseada no código original de Breiman e Cutler.
library(randomForest)

set.seed(123)
idx    <- sample(seq_len(nrow(iris)), size = 0.7 * nrow(iris))
treino <- iris[idx, ]
teste  <- iris[-idx, ]

rf <- randomForest(Species ~ ., data = treino,
                   ntree = 500,          # número de árvores (B)
                   mtry = 2,             # floor(sqrt(4)) = 2 variáveis por nó
                   importance = TRUE)    # calcula MDA (permutação) e MDI (Gini)

print(rf)          # mostra o erro OOB e a matriz de confusão OOB
plot(rf)           # erro OOB (e por classe) em função do número de árvores

# Predição e avaliação no conjunto de teste
pred <- predict(rf, newdata = teste)
table(Predito = pred, Real = teste$Species)
mean(pred == teste$Species)

# Proporção de votos (probabilidades estimadas)
head(predict(rf, newdata = teste, type = "prob"))

# Importância das variáveis
importance(rf)     # colunas MeanDecreaseAccuracy e MeanDecreaseGini
varImpPlot(rf, main = "Importância das variáveis")

# Ajuste de mtry guiado pelo erro OOB
set.seed(123)
tuneRF(x = treino[, 1:4], y = treino$Species,
       ntreeTry = 500, stepFactor = 1.5, improve = 0.01)
12.14.2 Pacote ranger
O ranger (Wright e Ziegler 2017) é uma implementação muito mais rápida, escrita em C++, adequada a bases grandes.
library(ranger)

# Busca em grade por mtry e min.node.size usando o erro OOB
grade <- expand.grid(mtry = 1:4, min.node.size = c(1, 3, 5, 10))
grade$erro_oob <- NA

for (i in seq_len(nrow(grade))) {
  ajuste <- ranger(Species ~ ., data = treino,
                   num.trees = 500,
                   mtry = grade$mtry[i],
                   min.node.size = grade$min.node.size[i],
                   seed = 123)
  grade$erro_oob[i] <- ajuste$prediction.error   # erro OOB de classificação
}
grade[order(grade$erro_oob), ][1:5, ]

# Modelo final com importância por permutação e probabilidades
melhor <- grade[which.min(grade$erro_oob), ]
rf_rg <- ranger(Species ~ ., data = treino, num.trees = 1000,
                mtry = melhor$mtry, min.node.size = melhor$min.node.size,
                importance = "permutation", probability = TRUE, seed = 123)

sort(rf_rg$variable.importance, decreasing = TRUE)

prob <- predict(rf_rg, data = teste)$predictions   # matriz de probabilidades
pred <- factor(colnames(prob)[max.col(prob)], levels = levels(teste$Species))
mean(pred == teste$Species)
12.14.3 Boosting em R com gbm e xgboost
library(MASS)       # conjunto Pima.tr
library(gbm)
pima <- Pima.tr
pima$y <- as.integer(pima$type == "Yes"); pima$type <- NULL

# Gradient boosting com deviance binomial, árvores de profundidade 2,
# taxa de aprendizado 0,01 e subamostragem de 50% (stochastic gradient boosting)
set.seed(123)
gb <- gbm(y ~ ., data = pima, distribution = "bernoulli",
          n.trees = 2000, interaction.depth = 2, shrinkage = 0.01,
          bag.fraction = 0.5, cv.folds = 5)
melhor_M <- gbm.perf(gb, method = "cv")     # número de árvores escolhido por VC
summary(gb, n.trees = melhor_M)              # influência relativa das variáveis

library(xgboost)
X <- as.matrix(pima[, setdiff(names(pima), "y")])
dtreino <- xgb.DMatrix(X, label = pima$y)
parametros <- list(objective = "binary:logistic", eta = 0.05, max_depth = 3,
                   lambda = 1, gamma = 0, subsample = 0.8,
                   colsample_bytree = 0.8, eval_metric = "logloss")
set.seed(123)
vc <- xgb.cv(params = parametros, data = dtreino, nrounds = 1000, nfold = 5,
             early_stopping_rounds = 30, verbose = 0)
n_rodadas <- which.min(vc$evaluation_log$test_logloss_mean)
modelo_xgb <- xgb.train(params = parametros, data = dtreino, nrounds = n_rodadas)
xgb.importance(model = modelo_xgb)
12.14.4 Verificando a fração out-of-bag por simulação
set.seed(1)
n <- 1000
fora <- replicate(5000, {
  amostra <- sample(n, n, replace = TRUE)
  mean(!(seq_len(n) %in% amostra))   # fração de observações fora da amostra
})
mean(fora)    # próximo de exp(-1) = 0.3679
12.15 Implementação em Python com RandomForestClassifier
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.ensemble import RandomForestClassifier
from sklearn.tree import DecisionTreeClassifier
from sklearn.inspection import permutation_importance
from sklearn.metrics import accuracy_score, roc_auc_score, classification_report

dados = load_breast_cancer()
X, y = dados.data, dados.target
nomes = dados.feature_names
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42)

# 1) Comparação: árvore única x floresta
arvore = DecisionTreeClassifier(random_state=42).fit(X_tr, y_tr)
rf = RandomForestClassifier(
    n_estimators=500,
    max_features="sqrt",     # m = sqrt(p)
    min_samples_leaf=1,
    oob_score=True,          # calcula a acurácia OOB
    n_jobs=-1,
    random_state=42)
rf.fit(X_tr, y_tr)

print("Árvore única - acurácia teste:", accuracy_score(y_te, arvore.predict(X_te)))
print("Floresta     - acurácia OOB  :", rf.oob_score_)
print("Floresta     - acurácia teste:", accuracy_score(y_te, rf.predict(X_te)))
print("Floresta     - AUC teste     :", roc_auc_score(y_te, rf.predict_proba(X_te)[:, 1]))
print(classification_report(y_te, rf.predict(X_te), target_names=dados.target_names))

# 2) Erro OOB em função do número de árvores (warm_start reaproveita as árvores)
rf_inc = RandomForestClassifier(max_features="sqrt", oob_score=True,
                                warm_start=True, n_jobs=-1, random_state=42)
n_arvores = range(25, 501, 25)
erros_oob = []
for B in n_arvores:
    rf_inc.set_params(n_estimators=B)
    rf_inc.fit(X_tr, y_tr)
    erros_oob.append(1 - rf_inc.oob_score_)

plt.plot(list(n_arvores), erros_oob, marker="o")
plt.xlabel("Número de árvores (B)")
plt.ylabel("Erro OOB")
plt.show()

# 3) Importâncias: MDI (impureza) x permutação no conjunto de teste
mdi = pd.Series(rf.feature_importances_, index=nomes)
perm = permutation_importance(rf, X_te, y_te, n_repeats=20,
                              random_state=42, n_jobs=-1)
mda = pd.Series(perm.importances_mean, index=nomes)
comparacao = pd.DataFrame({"MDI": mdi, "Permutacao": mda})
print(comparacao.sort_values("Permutacao", ascending=False).head(10))

# 4) Ajuste de hiperparâmetros por validação cruzada
grade = {
    "max_features": ["sqrt", "log2", 0.3, 0.5],
    "min_samples_leaf": [1, 3, 5],
    "max_depth": [None, 10],
}
busca = GridSearchCV(
    RandomForestClassifier(n_estimators=300, n_jobs=-1, random_state=42),
    grade, cv=5, scoring="roc_auc")
busca.fit(X_tr, y_tr)
print("Melhores hiperparâmetros:", busca.best_params_)
print("AUC teste:", roc_auc_score(y_te, busca.predict_proba(X_te)[:, 1]))
12.15.1 Boosting, Extra Trees e empilhamento em Python
from sklearn.ensemble import (ExtraTreesClassifier, AdaBoostClassifier,
                              GradientBoostingClassifier,
                              HistGradientBoostingClassifier, StackingClassifier)
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import log_loss
from sklearn.inspection import PartialDependenceDisplay

modelos = {
    "Floresta Aleatória": RandomForestClassifier(n_estimators=500, random_state=42, n_jobs=-1),
    "Extra Trees": ExtraTreesClassifier(n_estimators=500, random_state=42, n_jobs=-1),
    "AdaBoost (tocos)": AdaBoostClassifier(
        estimator=DecisionTreeClassifier(max_depth=1),
        n_estimators=300, learning_rate=0.5, random_state=42),
    "Gradient Boosting": GradientBoostingClassifier(
        n_estimators=300, learning_rate=0.05, max_depth=3,
        subsample=0.8, random_state=42),
    "HistGradientBoosting": HistGradientBoostingClassifier(
        learning_rate=0.05, max_iter=500, early_stopping=True,
        validation_fraction=0.15, random_state=42),
}
for nome, mod in modelos.items():
    mod.fit(X_tr, y_tr)
    prob = mod.predict_proba(X_te)[:, 1]
    print(f"{nome:22s} acurácia={accuracy_score(y_te, prob > 0.5):.3f}  "
          f"AUC={roc_auc_score(y_te, prob):.4f}")

# Perda no teste ao longo das iterações do gradient boosting: o sobreajuste
# aparece como uma curva em "U"
gb = modelos["Gradient Boosting"]
perdas = [log_loss(y_te, p[:, 1]) for p in gb.staged_predict_proba(X_te)]
print("Número de árvores com menor perda no teste:", int(np.argmin(perdas)) + 1)

# Empilhamento com predições out-of-fold (cv=5) e metamodelo logístico
empilhado = StackingClassifier(
    estimators=[
        ("rf", RandomForestClassifier(n_estimators=300, random_state=42)),
        ("gb", GradientBoostingClassifier(random_state=42)),
        ("lr", make_pipeline(StandardScaler(), LogisticRegression(max_iter=5000))),
    ],
    final_estimator=LogisticRegression(), cv=5, stack_method="predict_proba")
empilhado.fit(X_tr, y_tr)
print("Empilhamento - AUC teste:", roc_auc_score(y_te, empilhado.predict_proba(X_te)[:, 1]))

# Dependência parcial (média) e curvas ICE para duas variáveis da floresta
fig, ax = plt.subplots(figsize=(10, 4))
PartialDependenceDisplay.from_estimator(
    modelos["Floresta Aleatória"], X_tr, features=[27, 22],
    feature_names=nomes, kind="both", subsample=100, random_state=42, ax=ax)
plt.show()
Nesse conjunto, todos os métodos de conjunto atingem AUC de teste acima de 0,98, e as diferenças entre eles são pequenas — um lembrete de que, em muitos problemas, a escolha entre floresta e boosting importa menos que a qualidade dos dados e das variáveis.
12.15.2 Simulação: o viés da MDI
O código abaixo reproduz a tabela da seção sobre o viés da MDI.
rng = np.random.default_rng(42)
n = 1000
Xs = np.column_stack([
    rng.integers(0, 2, n),     # x1: binária, informativa
    rng.integers(0, 4, n),     # x2: ruído com 4 níveis
    rng.integers(0, 10, n),    # x3: ruído com 10 níveis
    rng.integers(0, 20, n),    # x4: ruído com 20 níveis
    rng.normal(size=n),        # x5: ruído contínuo
])
ys = (rng.uniform(size=n) < np.where(Xs[:, 0] == 1, 0.7, 0.3)).astype(int)
Xs_tr, Xs_te, ys_tr, ys_te = train_test_split(Xs, ys, test_size=0.3, random_state=42)

rf_s = RandomForestClassifier(n_estimators=500, random_state=42, n_jobs=-1).fit(Xs_tr, ys_tr)
perm_s = permutation_importance(rf_s, Xs_te, ys_te, n_repeats=20, random_state=42)
print(pd.DataFrame({"MDI": rf_s.feature_importances_,
                    "Permutacao": perm_s.importances_mean},
                   index=["x1", "x2", "x3", "x4", "x5"]).round(3))
12.15.3 Simulação: o efeito da correlação na variância da média
O código a seguir verifica numericamente a fórmula \(\operatorname{Var}(\bar{T}) = \rho\sigma^2 + (1-\rho)\sigma^2/B\).
import numpy as np

rng = np.random.default_rng(42)
B, sigma2, reps = 100, 1.0, 20000

for rho in [0.0, 0.1, 0.5, 0.9]:
    # Matriz de covariância com variância sigma2 e correlação rho
    Sigma = sigma2 * (rho * np.ones((B, B)) + (1 - rho) * np.eye(B))
    T = rng.multivariate_normal(np.zeros(B), Sigma, size=reps)
    var_sim = T.mean(axis=1).var()
    var_teo = rho * sigma2 + (1 - rho) * sigma2 / B
    print(f"rho={rho:.1f}  simulada={var_sim:.4f}  teórica={var_teo:.4f}")
12.16 Resumo do Capítulo
- Comitês de classificadores melhoram a acurácia quando os erros dos membros são pouco correlacionados; com erros independentes e acurácia individual acima de 50%, a acurácia do voto majoritário tende a 1.
- O bootstrap reamostra com reposição; cada observação fica fora de uma amostra com probabilidade \((1-1/n)^n \to e^{-1} \approx 0{,}368\).
- O bagging agrega árvores profundas treinadas em amostras bootstrap, reduzindo a variância. A variância da média de \(B\) predições com correlação \(\rho\) é \(\rho\sigma^2 + (1-\rho)\sigma^2/B\): o termo \(\rho\sigma^2\) é um piso que não diminui com \(B\).
- A Floresta Aleatória sorteia \(m\) das \(p\) variáveis em cada nó (\(\sqrt{p}\) em classificação, \(p/3\) em regressão), descorrelacionando as árvores; com \(m = p\), obtém-se o bagging.
- O erro OOB estima o erro de generalização usando, para cada observação, apenas as árvores que não a viram no treinamento.
- As importâncias MDI (impureza) e MDA (permutação) resumem a contribuição de cada variável; a MDI é enviesada para variáveis com muitos valores.
- O hiperparâmetro mais relevante é \(m\); aumentar \(B\) não causa sobreajuste. O boosting, em contraste, constrói árvores rasas sequencialmente e exige ajuste mais cuidadoso.
- Pela decomposição da ambiguidade, o erro quadrático de uma média de modelos é o erro médio dos membros menos a sua dispersão; o limite de Breiman, \(PE^* \leq \bar{\rho}(1 - s^2)/s^2\), decorre da desigualdade de Chebyshev aplicada à margem.
- O número de árvores para as quais uma observação é OOB segue uma Binomial\((B, \approx 0{,}368)\), e o erro OOB aproxima a validação cruzada leave-one-out do bagging.
- A MDI pode eleger ruído contínuo ou de alta cardinalidade como variável mais importante; a importância por permutação em dados não vistos, e sua versão condicional, são mais confiáveis.
- As proximidades (fração de árvores em que duas observações compartilham folha) permitem visualização por MDS, detecção de outliers e imputação; os pesos da floresta permitem estimar quantis condicionais (florestas quantílicas).
- PDP, curvas ICE e valores de Shapley explicam como as variáveis afetam as predições; os valores de Shapley são a única repartição que satisfaz eficiência, simetria, jogador nulo e aditividade.
- O AdaBoost minimiza de forma gulosa a perda exponencial, estima metade do log-odds e tem erro de treino que decai exponencialmente; o gradient boosting ajusta árvores ao gradiente negativo da perda; o XGBoost usa uma aproximação de segunda ordem com folhas ótimas \(w^* = -G/(H + \lambda)\).
- O empilhamento combina modelos diferentes por meio de um metamodelo treinado com predições out-of-fold.
12.17 Exercícios Propostos
- Demonstre que \(\lim_{n\to\infty}(1 - 1/n)^n = e^{-1}\) (dica: tome logaritmos e use a expansão \(\ln(1 - x) = -x + O(x^2)\)).
- Calcule o número esperado de observações distintas em uma amostra bootstrap de tamanho \(n = 50\).
- Derive a expressão \(\operatorname{Var}(\bar{T}) = \rho\sigma^2 + (1-\rho)\sigma^2/B\) e calcule seu valor para \(\sigma^2 = 4\), \(B = 200\) e \(\rho \in \{0;\ 0{,}2;\ 0{,}6\}\). Qual o limite quando \(B \to \infty\)?
- Considere 7 classificadores binários independentes, cada um com acurácia 0,65. Calcule a acurácia do voto majoritário. Repita supondo acurácia individual de 0,45 e interprete o resultado.
- Explique, com suas palavras, por que a seleção aleatória de \(m < p\) variáveis por nó diminui a correlação entre as árvores e por que isso pode compensar o aumento do erro de cada árvore individual.
- Em um problema com \(p = 100\) variáveis, das quais apenas 5 são relevantes, qual a probabilidade de que nenhuma variável relevante esteja entre as \(m = 10\) sorteadas em um nó? Discuta o que isso implica para a escolha de \(m\).
- Por que o erro OOB é considerado uma estimativa aproximadamente não viesada do erro de teste? Em que situações ele pode ser otimista?
- Descreva passo a passo o cálculo da importância por permutação e explique por que ela tende a ser menos enviesada que a diminuição média da impureza.
- Uma floresta de 200 árvores, para um ponto \(\mathbf{x}_0\), produz 90 votos na classe A, 70 na classe B e 40 na classe C. Qual a classe predita e as probabilidades estimadas por proporção de votos? Se o custo de deixar de detectar a classe B for muito alto, como as probabilidades poderiam ser usadas?
- Compare Floresta Aleatória e boosting quanto à forma de construção das árvores, ao efeito sobre viés e variância e ao risco de sobreajuste ao aumentar o número de árvores.
- (Prático, R) Usando o pacote
randomForeste o conjuntoPima.trdo pacoteMASS, ajuste uma floresta, trace o erro OOB em função dentreee compare a importância MDA com a MDI. - (Prático, Python) Adicione ao conjunto
load_breast_cancer()uma coluna de ruído contínuo (por exemplo,np.random.rand(n)) e uma coluna de identificador com valores únicos. Compare as importâncias MDI e por permutação dessas colunas. O que se observa? - (Prático) Para o conjunto
load_wine(), avalie a acurácia por validação cruzada da floresta paramax_featuresvariando de 1 a \(p\). Identifique o valor correspondente ao bagging e compare. - (Prático) Repita a simulação da variância da média do capítulo com \(B = 10\) e \(B = 1000\) e verifique empiricamente que, para \(\rho > 0\), a variância não converge para zero.
- Cinco modelos predizem \((4, 6, 7, 9, 14)\) em um ponto com \(y = 8\). Calcule o erro do conjunto, o erro médio dos membros e a ambiguidade, e verifique a decomposição de Krogh e Vedelsby.
- Com \(B = 50\) árvores e \(n\) grande, calcule a probabilidade de uma observação ser OOB em menos de 10 árvores (use a aproximação normal à binomial).
- Uma floresta com 4 árvores e 5 observações produz as folhas \(T_1\): \(\{1,2\},\{3,4,5\}\); \(T_2\): \(\{1\},\{2,3\},\{4,5\}\); \(T_3\): \(\{1,2,3\},\{4,5\}\); \(T_4\): \(\{1,5\},\{2,3,4\}\). Calcule a matriz de proximidades e identifique os pares mais semelhantes.
- Para o modelo \(\hat{f}(x_1, x_2) = x_1^2 + 3 x_2\) e uma amostra com \(x_2 \in \{-1, 0, 2\}\), obtenha as curvas ICE e o PDP de \(x_1\). Compare com o exemplo do capítulo e explique por que não há heterogeneidade.
- Calcule os valores de Shapley do jogo com \(v(\emptyset) = 0\), \(v(\{1\}) = v(\{2\}) = 1\) e \(v(\{1, 2\}) = 4\). Verifique a eficiência e a simetria.
- No exemplo resolvido do AdaBoost, refaça a iteração 1 escolhendo o toco “\(x \leq 9{,}5 \Rightarrow +\)” no empate. O classificador final após três iterações muda?
- Mostre que, após a atualização do AdaBoost, as observações mal classificadas por \(h_m\) têm peso total exatamente \(1/2\).
- Derive o minimizador populacional da perda exponencial, \(F^*(\mathbf{x}) = \frac{1}{2}\ln\frac{p(\mathbf{x})}{1-p(\mathbf{x})}\), e o da deviance binomial. Por que a deviance é mais robusta a rótulos errados?
- No exemplo do gradient boosting com perda quadrática, refaça as duas primeiras iterações com \(\nu = 1\) e compare a soma de quadrados dos resíduos com a obtida com \(\nu = 0{,}5\).
- Para a perda quadrática \(L = \frac{1}{2}(y - \hat{y})^2\), obtenha \(g_i\) e \(h_i\) e mostre que o valor ótimo de folha do XGBoost é \(w^* = \sum_{i \in j}(y_i - \hat{y}_i)/(n_j + \lambda)\), uma média de resíduos encolhida para zero.
- Uma floresta quantílica atribui pesos \((0{,}1;\ 0{,}3;\ 0{,}4;\ 0{,}2)\) às respostas \((5, 8, 9, 20)\). Calcule a média, a mediana e o quantil de 80% condicionais.
- (Prático, Python) Compare
RandomForestClassifier,BalancedRandomForestClassifiereRandomForestClassifier(class_weight="balanced_subsample")em um problema com 5% de positivos, usando a área sob a curva precisão-revocação. - (Prático, R) Usando
gbmno conjuntoPima.tr, trace o erro de validação cruzada em função do número de árvores parashrinkageigual a 0,1, 0,01 e 0,001. Discuta a relação entre taxa de aprendizado e número ótimo de árvores.
12.18 Leituras Recomendadas
- Breiman (2001) — artigo original da Floresta Aleatória, com os resultados de convergência, o limite de erro em termos de força e correlação, e a importância por permutação.
- Breiman (1996) — artigo que introduziu o bagging.
- Efron (1979) — artigo fundador do bootstrap.
- James et al. (2013), Capítulo 8 — introdução didática a bagging, florestas aleatórias e boosting, com laboratórios em R.
- Hastie, Tibshirani, e Friedman (2009), Capítulos 8, 10 e 15 — tratamento aprofundado de bagging, boosting e florestas aleatórias.
- Strobl et al. (2007) — análise do viés das medidas de importância de variáveis.
- Liaw e Wiener (2002) e Wright e Ziegler (2017) — descrição dos pacotes
randomForesteranger. - Freund e Schapire (1997) e Schapire (1990) — os artigos fundadores do boosting e do AdaBoost.
- J. Friedman, Hastie, e Tibshirani (2000) — a interpretação estatística do AdaBoost como modelagem aditiva com perda exponencial.
- J. H. Friedman (2001) e J. H. Friedman (2002) — gradient boosting e sua versão estocástica; o primeiro também introduz os gráficos de dependência parcial.
- T. Chen e Guestrin (2016), Ke et al. (2017) e Prokhorenkova et al. (2018) — XGBoost, LightGBM e CatBoost.
- Geurts, Ernst, e Wehenkel (2006) — árvores extremamente aleatorizadas.
- Meinshausen (2006) — florestas de regressão quantílica.
- Strobl et al. (2008) — importância condicional por permutação.
- Louppe et al. (2013) — análise teórica da MDI.
- Biau e Scornet (2016) — panorama da teoria das florestas aleatórias, incluindo consistência.
- Goldstein et al. (2015), Scott M. Lundberg e Lee (2017) e Scott M. Lundberg et al. (2020) — curvas ICE, SHAP e TreeSHAP.
- Wolpert (1992) — o artigo original do empilhamento.
- C. Chen, Liaw, e Breiman (2004) — florestas aleatórias para dados desbalanceados.