Introdução à Ciência de Dados
SVM - Máquina de Vetores de Suporte
Prof. Jodavid Ferreira
UFPE
Classificação binária: relembrando
Observamos \((\mathbf{x}_i, y_i)\), \(i = 1, \ldots, n\), com \(\mathbf{x}_i \in \mathbb{R}^p\).
No SVM, as duas classes são codificadas como \(y_i \in \{-1, +1\}\).
- Um classificador linear usa uma função de decisão \(f : \mathbb{R}^p \to \mathbb{R}\) e o seu sinal:
\[\hat{y} = \text{sinal}\big(f(\mathbf{x})\big) = \begin{cases} +1, & f(\mathbf{x}) > 0, \\ -1, & f(\mathbf{x}) < 0. \end{cases}\]
- Com essa codificação, a classificação está correta quando \(y_i\, f(\mathbf{x}_i) > 0\).
Pergunta da aula: entre as muitas fronteiras que separam as classes, qual escolher?
SVM - Support Vector Machine
A ideia
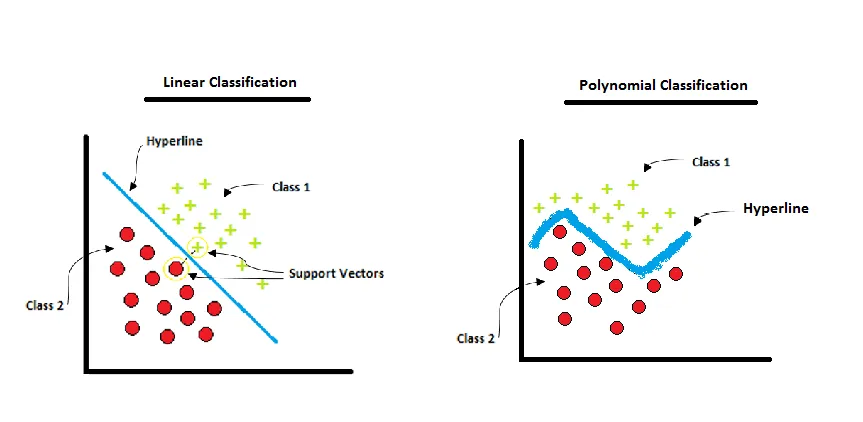
- O SVM escolhe a fronteira com a maior folga (margem) entre as classes.
- Os pontos que “encostam” na margem são os vetores de suporte.
Hiperplano
Definição 1. Um hiperplano em \(\mathbb{R}^p\) é o conjunto \[H = \{\mathbf{x} \in \mathbb{R}^p : \mathbf{w}^\top \mathbf{x} + b = 0\}, \qquad \mathbf{w} \neq \mathbf{0},\] em que \(\mathbf{w}\) é um vetor normal (perpendicular) a \(H\) e \(b \in \mathbb{R}\) é o intercepto.
Em \(\mathbb{R}^2\), \(H\) é uma reta; em \(\mathbb{R}^3\), um plano; em geral, tem dimensão \(p - 1\).
Exemplo em \(\mathbb{R}^2\): \(\; 2x_1 + x_2 - 4 = 0\), com \(\mathbf{w} = (2, 1)\) e \(b = -4\).
- \(H\) divide o espaço em dois lados: \(f(\mathbf{x}) = \mathbf{w}^\top\mathbf{x} + b > 0\) de um lado e \(f(\mathbf{x}) < 0\) do outro.
Distância de um ponto ao hiperplano
Proposição 1. A distância de \(\mathbf{x}_0\) ao hiperplano \(H\) é \(\;\displaystyle d(\mathbf{x}_0, H) = \frac{|\mathbf{w}^\top \mathbf{x}_0 + b|}{\|\mathbf{w}\|}\), com \(\|\mathbf{w}\| = \sqrt{\textstyle\sum_{j=1}^p w_j^2}\).
Demonstração. Seja \(\mathbf{x}_H\) a projeção ortogonal de \(\mathbf{x}_0\) em \(H\). Como \(\mathbf{x}_0 - \mathbf{x}_H\) é paralelo a \(\mathbf{w}\),
\[\mathbf{x}_0 = \mathbf{x}_H + t\,\frac{\mathbf{w}}{\|\mathbf{w}\|}, \quad \text{com } |t| = d(\mathbf{x}_0, H).\]
Aplicando \(f\) e usando \(\mathbf{w}^\top \mathbf{x}_H + b = 0\):
\[\mathbf{w}^\top \mathbf{x}_0 + b = \underbrace{\mathbf{w}^\top \mathbf{x}_H + b}_{=\,0} + t\,\frac{\mathbf{w}^\top \mathbf{w}}{\|\mathbf{w}\|} = t\,\|\mathbf{w}\| \;\;\Rightarrow\;\; |t| = \frac{|\mathbf{w}^\top \mathbf{x}_0 + b|}{\|\mathbf{w}\|}. \;\; \blacksquare\]
Margem
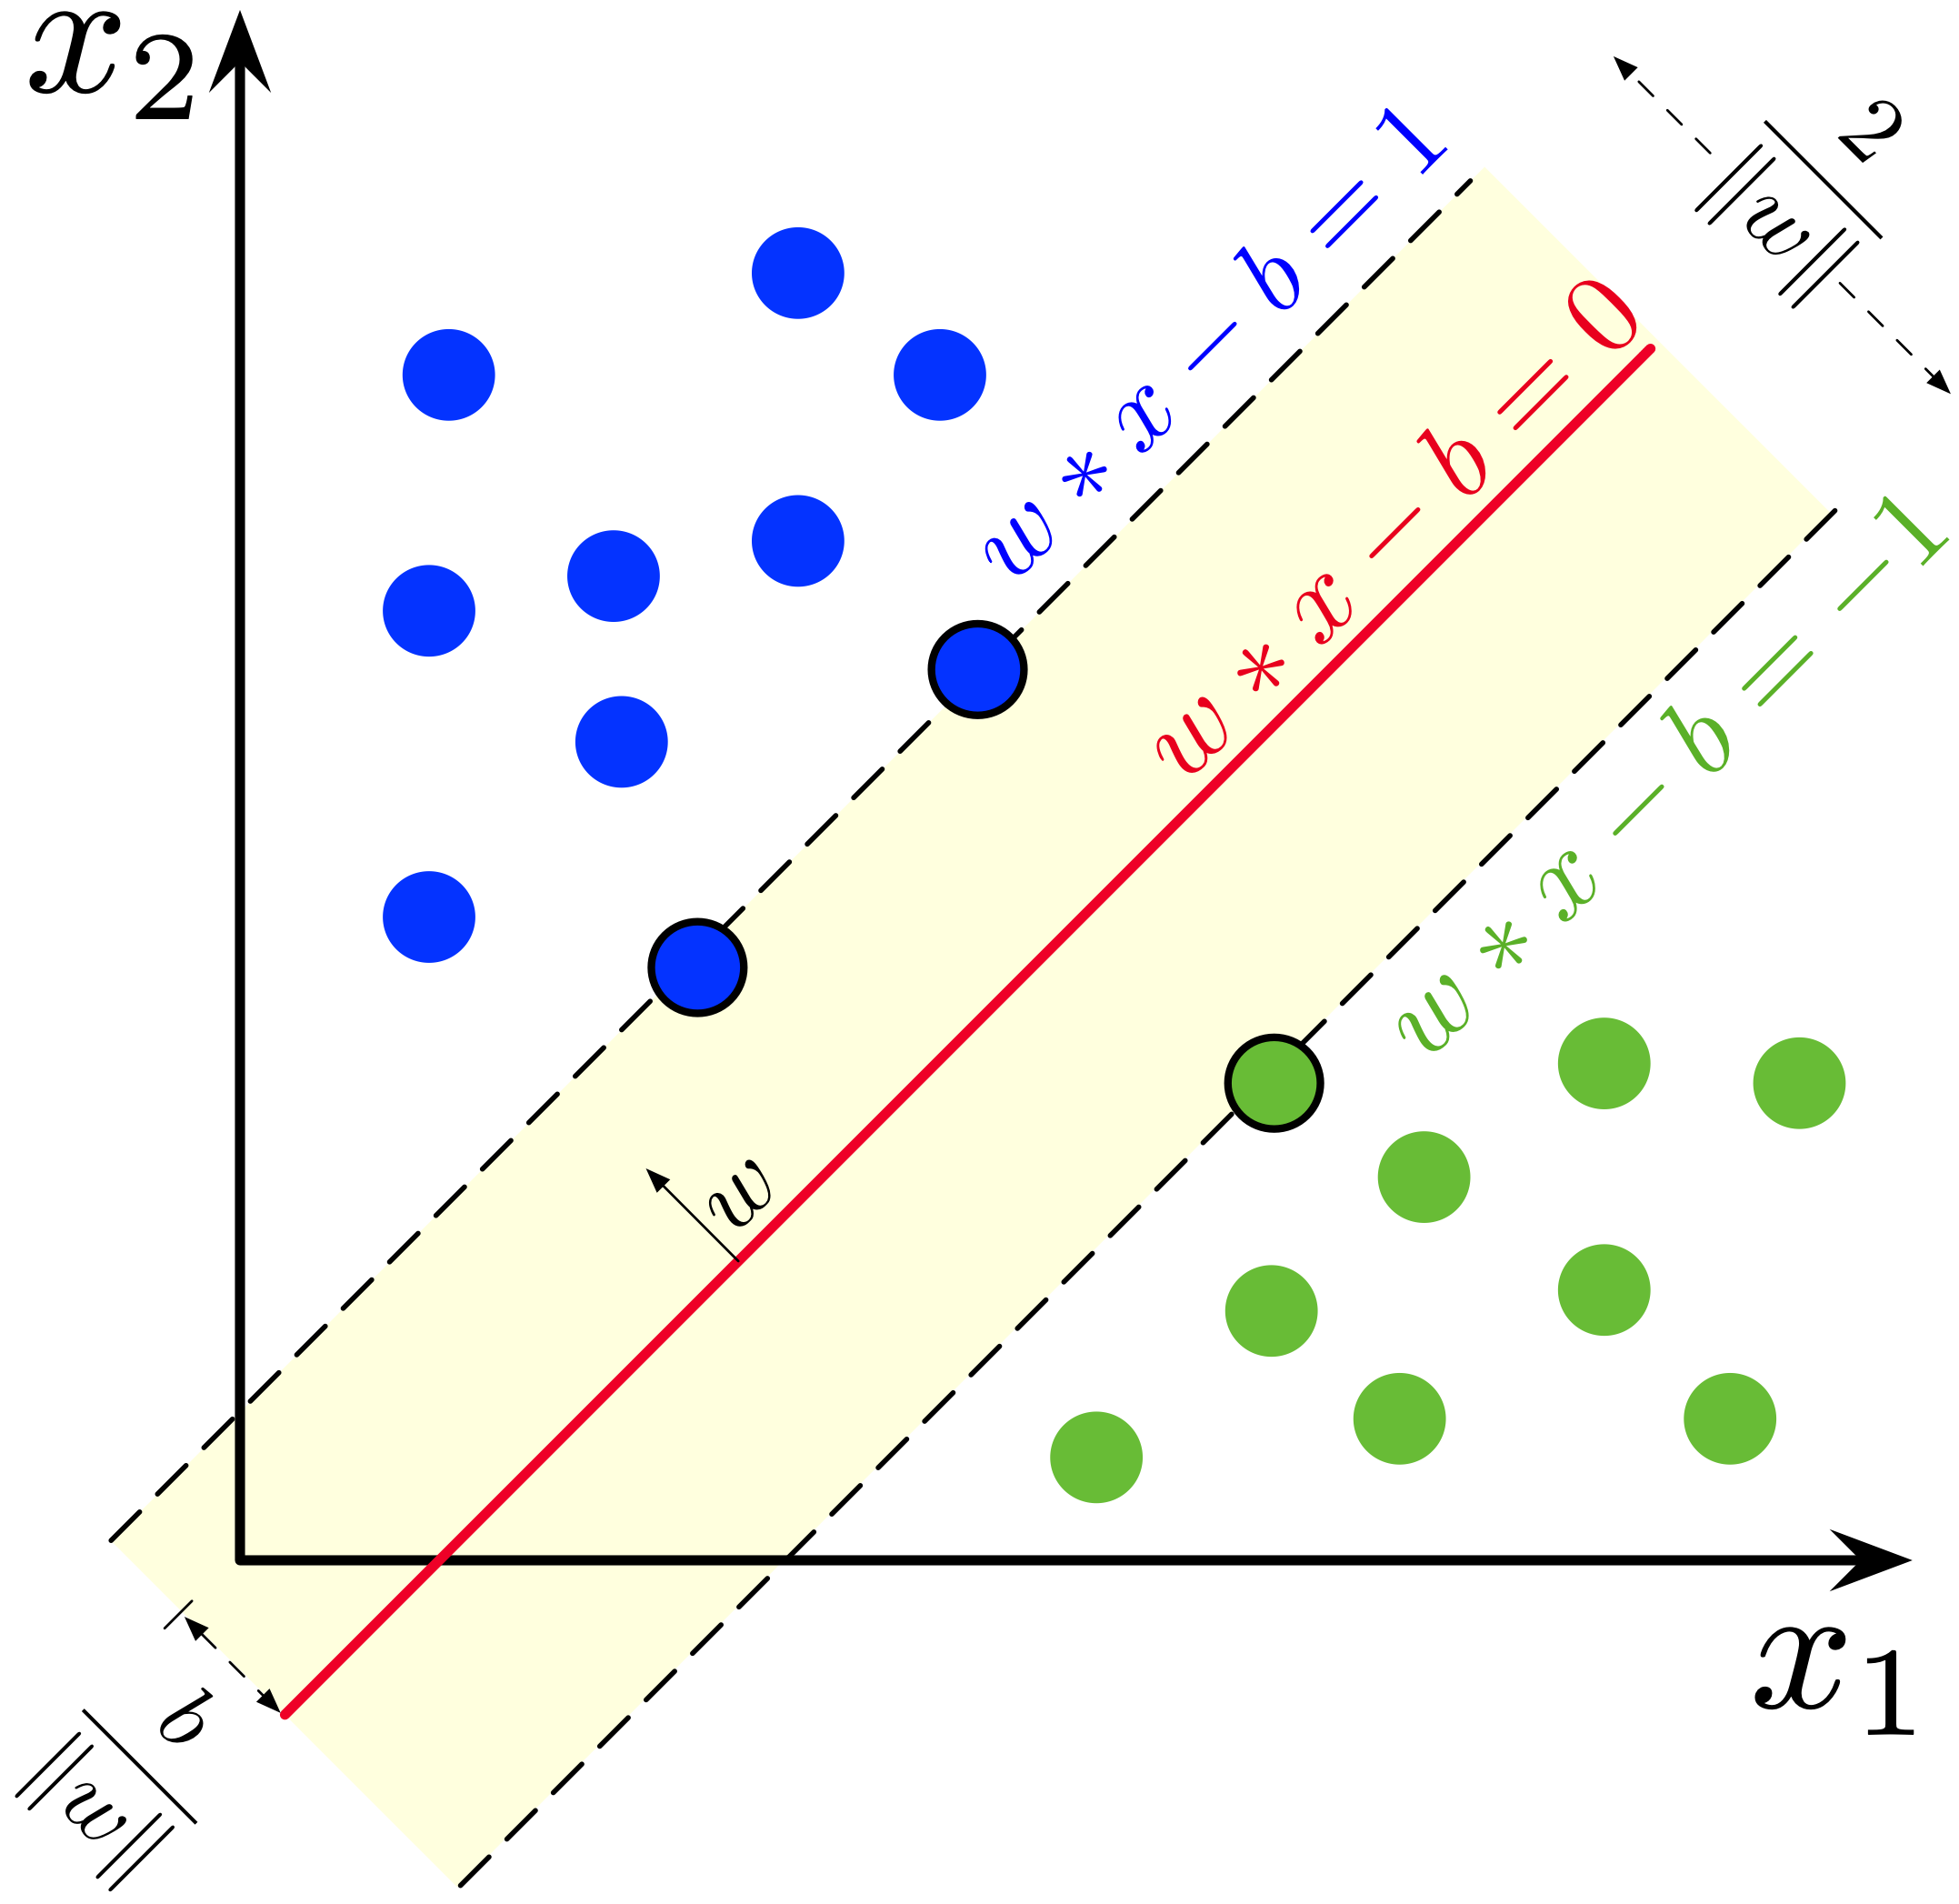
- Multiplicar \((\mathbf{w}, b)\) por \(k > 0\) não muda \(H\). Fixamos a escala de modo que os pontos mais próximos satisfaçam
\[\min_{i} \; y_i(\mathbf{w}^\top \mathbf{x}_i + b) = 1.\]
Então esses pontos estão a distância \(1/\|\mathbf{w}\|\) de \(H\) (Proposição 1), sobre os hiperplanos \(f(\mathbf{x}) = +1\) e \(f(\mathbf{x}) = -1\).
A margem (largura da faixa entre \(f = -1\) e \(f = +1\)) é
\[M = \frac{2}{\|\mathbf{w}\|}.\]
Maximizar a margem \(\;\Longleftrightarrow\;\) minimizar \(\|\mathbf{w}\|\).
Margem
Na figura, o hiperplano é \(\mathbf{w}\cdot\mathbf{x} - b = 0\): o sinal de \(b\) está trocado em relação aos slides.
O problema de otimização (margem rígida)
Se as classes são linearmente separáveis, o SVM resolve:
\[\min_{\mathbf{w},\, b} \; \frac{1}{2}\|\mathbf{w}\|^2 \qquad \text{sujeito a} \qquad y_i(\mathbf{w}^\top \mathbf{x}_i + b) \geq 1, \quad i = 1, \ldots, n.\]
Restrições: todo ponto fica do lado certo e fora da faixa da margem.
Objetivo: \(\frac{1}{2}\|\mathbf{w}\|^2\) em vez de \(\|\mathbf{w}\|\) dá o mesmo mínimo e é mais fácil de derivar.
É um problema quadrático convexo: tem solução única, encontrada por algoritmos de otimização.
- Classificação: \(\; \hat{y} = \text{sinal}(\mathbf{w}^\top \mathbf{x} + b)\).
Exemplo numérico
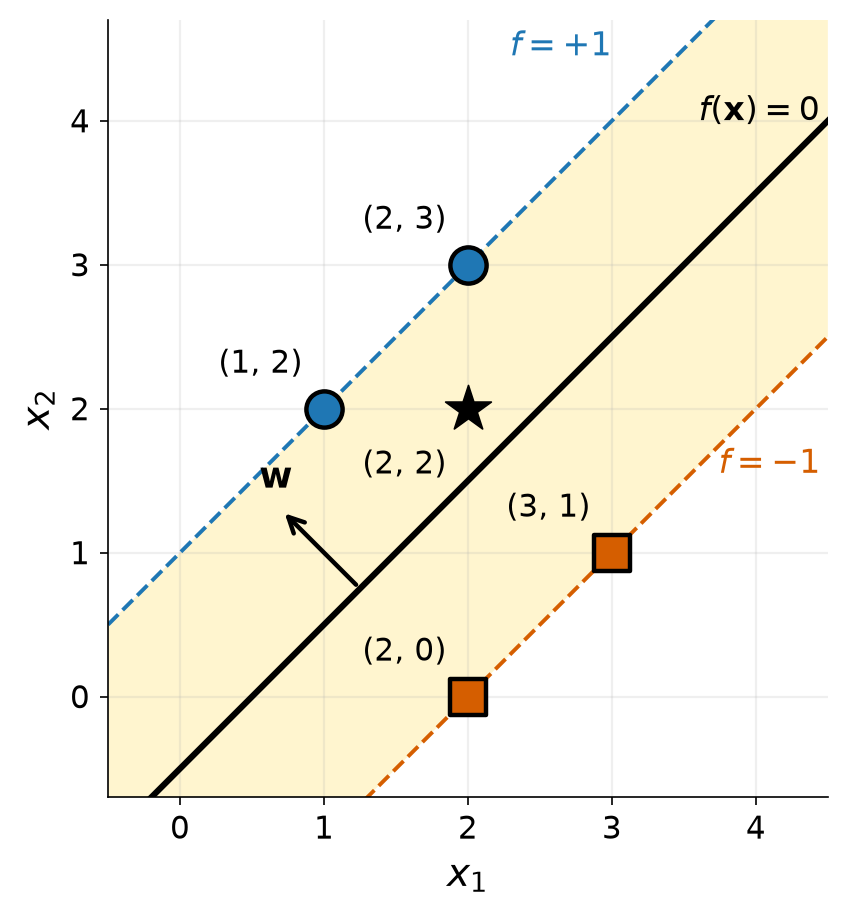
- Classe \(+1\): \(\;(1, 2)\) e \((2, 3)\).
- Classe \(-1\): \(\;(2, 0)\) e \((3, 1)\).
. . .
Os pontos \(+1\) estão na reta \(x_2 = x_1 + 1\); os \(-1\), na reta \(x_2 = x_1 - 2\).
O hiperplano ótimo é paralelo e no meio: \(x_2 = x_1 - \tfrac{1}{2}\).
. . .
Exercício: encontre \(\mathbf{w}\), \(b\), a margem e a classe de \((2, 2)\).
Exemplo numérico - Solução
- O hiperplano \(-x_1 + x_2 + \tfrac{1}{2} = 0\) dá \(\mathbf{w} = k(-1, 1)\) e \(b = k/2\). Impondo \(f(1, 2) = 1\):
\[k\left(-1 + 2 + \tfrac{1}{2}\right) = 1 \;\Rightarrow\; k = \tfrac{2}{3} \;\Rightarrow\; \mathbf{w} = \left(-\tfrac{2}{3}, \tfrac{2}{3}\right), \quad b = \tfrac{1}{3}.\]
Verificação: \(y_i f(\mathbf{x}_i) = 1\) para os quatro pontos: todos estão sobre a margem.
Margem: \(\|\mathbf{w}\| = \frac{2\sqrt{2}}{3}\) \(\;\Rightarrow\; M = \dfrac{2}{\|\mathbf{w}\|} = \dfrac{3}{\sqrt{2}} \approx 2{,}12\).
- Novo ponto: \(f(2, 2) = -\tfrac{4}{3} + \tfrac{4}{3} + \tfrac{1}{3} = \tfrac{1}{3} > 0\) \(\;\Rightarrow\; \hat{y} = +1\).
O problema dual e os vetores de suporte
Com multiplicadores de Lagrange \(\alpha_i \geq 0\), as condições de otimalidade dão
\[\mathbf{w} = \sum_{i=1}^{n} \alpha_i y_i \mathbf{x}_i \qquad \text{e} \qquad \sum_{i=1}^{n} \alpha_i y_i = 0,\]
e os \(\alpha_i\) resolvem o problema dual:
\[\max_{\boldsymbol{\alpha}} \; \sum_{i=1}^{n} \alpha_i - \frac{1}{2} \sum_{i=1}^{n} \sum_{j=1}^{n} \alpha_i \alpha_j y_i y_j\, \mathbf{x}_i^\top \mathbf{x}_j \quad \text{s.a.} \quad \alpha_i \geq 0, \; \sum_{i} \alpha_i y_i = 0.\]
Complementaridade: \(\alpha_i \big[y_i f(\mathbf{x}_i) - 1\big] = 0\). Logo, \(\alpha_i > 0\) só para pontos sobre a margem: os vetores de suporte (SV).
No exemplo, uma solução é \(\boldsymbol{\alpha} = \left(\tfrac{2}{9}, \tfrac{2}{9}, 0, \tfrac{4}{9}\right)\); confira que \(\sum_i \alpha_i y_i \mathbf{x}_i = \mathbf{w}\). Aqui os \(\alpha_i\) não são únicos: \((2, 0)\) está na margem, mas recebeu \(\alpha = 0\).
Margem suave (soft margin)
Na prática, as classes se sobrepõem. Permitimos violações \(\xi_i \geq 0\) (variáveis de folga):
\[\min_{\mathbf{w},\, b,\, \boldsymbol{\xi}} \; \frac{1}{2}\|\mathbf{w}\|^2 + C \sum_{i=1}^{n} \xi_i \quad \text{s.a.} \quad y_i(\mathbf{w}^\top \mathbf{x}_i + b) \geq 1 - \xi_i, \quad \xi_i \geq 0.\]
\(\xi_i = 0\): ponto correto e fora da margem; \(\;0 < \xi_i \leq 1\): dentro da margem, lado certo; \(\;\xi_i > 1\): erro de classificação.
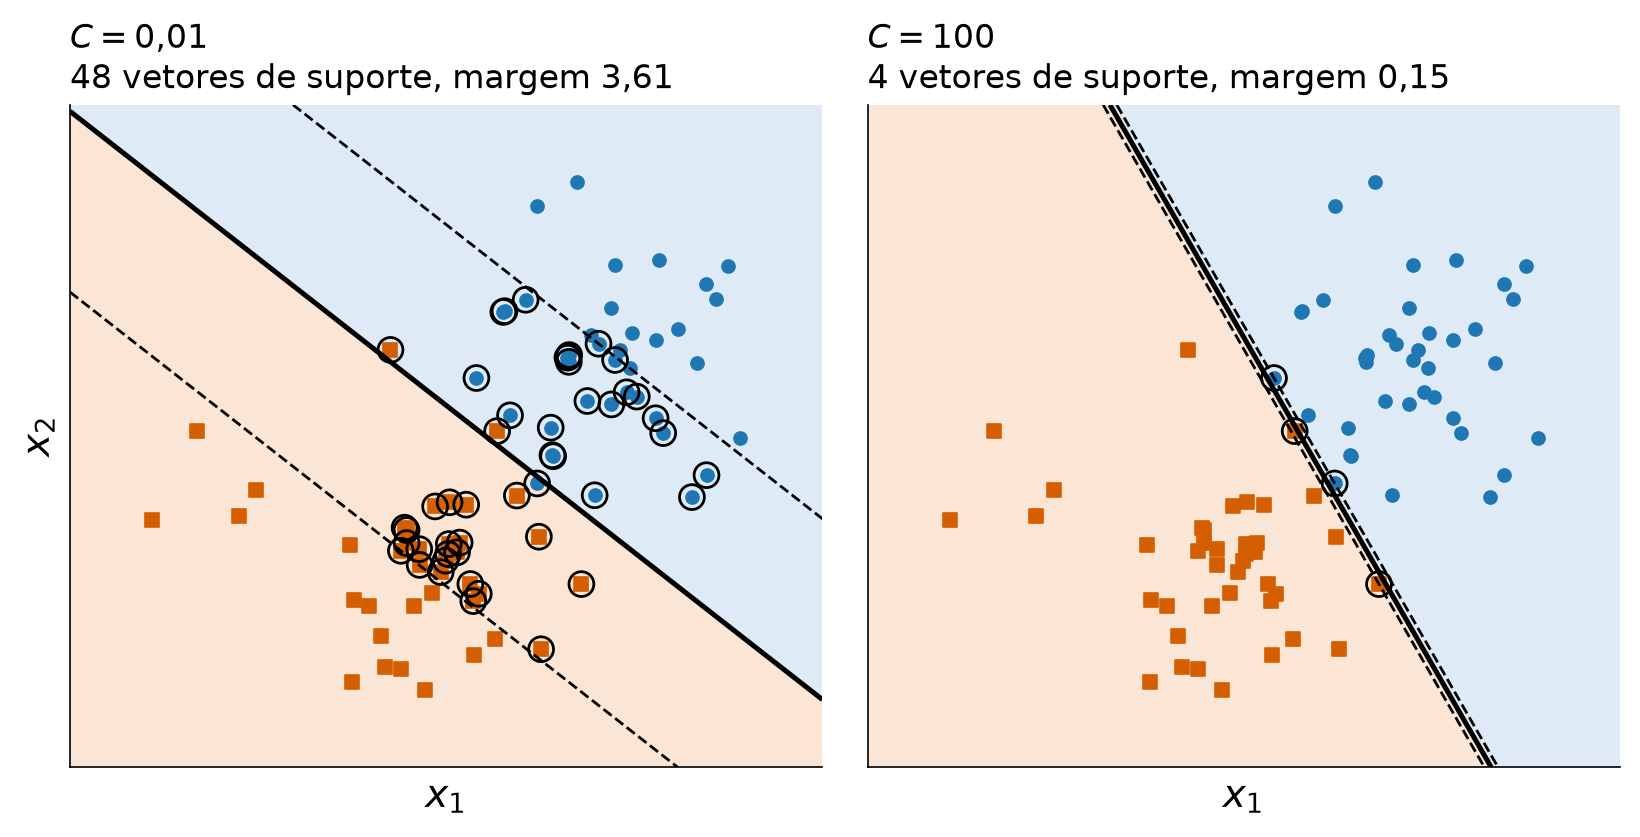
\(C > 0\) equilibra margem larga e poucas violações. No dual, muda apenas a restrição: \(0 \leq \alpha_i \leq C\).
- Forma equivalente, com a perda hinge: \(\; \displaystyle \min_{\mathbf{w}, b} \sum_{i=1}^{n} \max\{0,\, 1 - y_i f(\mathbf{x}_i)\} + \frac{1}{2C}\|\mathbf{w}\|^2\).
O papel de \(C\)
- \(C\) pequeno: margem larga, muitos vetores de suporte (circulados): mais viés, menos variância.
- \(C\) grande: tolera poucas violações, margem estreita: menos viés, mais variância.
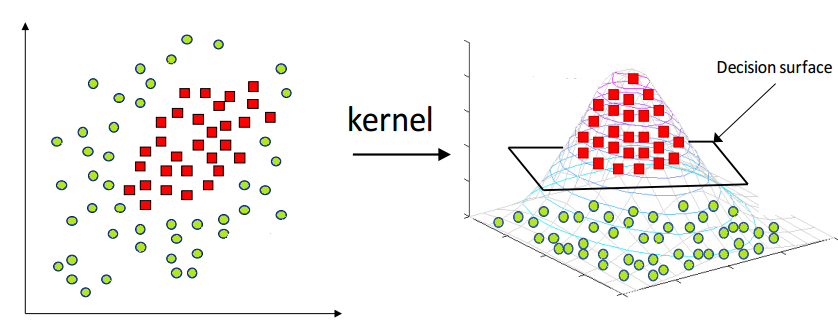
Caso não linear: mudar o espaço
Ideia: aplicar uma transformação \(\boldsymbol{\phi} : \mathbb{R}^p \to \mathbb{R}^D\) (\(D\) grande) e procurar um hiperplano no novo espaço.
Um hiperplano em \(\boldsymbol{\phi}(\mathbf{x})\) corresponde a uma fronteira curva no espaço original.
Caso não linear: mudar o espaço
- No espaço original, nenhuma reta separa as classes; após a transformação, um plano separa.
O truque do kernel
- No dual, os dados aparecem apenas em produtos internos \(\mathbf{x}_i^\top \mathbf{x}_j\). Basta trocá-los por \(\boldsymbol{\phi}(\mathbf{x}_i)^\top \boldsymbol{\phi}(\mathbf{x}_j)\).
Definição 2. Um kernel é uma função \(K(\mathbf{x}, \mathbf{z}) = \boldsymbol{\phi}(\mathbf{x})^\top \boldsymbol{\phi}(\mathbf{z})\), que calcula o produto interno no novo espaço sem calcular \(\boldsymbol{\phi}\).
Exemplo (\(p = 2\)): com \(\boldsymbol{\phi}(\mathbf{x}) = \big(x_1^2,\; \sqrt{2}\,x_1 x_2,\; x_2^2\big)\),
\[\boldsymbol{\phi}(\mathbf{x})^\top \boldsymbol{\phi}(\mathbf{z}) = x_1^2 z_1^2 + 2\,x_1 x_2 z_1 z_2 + x_2^2 z_2^2 = (x_1 z_1 + x_2 z_2)^2 = (\mathbf{x}^\top \mathbf{z})^2.\]
- Calcular \((\mathbf{x}^\top\mathbf{z})^2\) é muito mais barato que montar \(\boldsymbol{\phi}\); para o kernel radial, \(\boldsymbol{\phi}\) tem até dimensão infinita.
Kernels mais usados
| Linear |
\(\mathbf{x}^\top \mathbf{z}\) |
— |
| Polinomial |
\((\gamma\, \mathbf{x}^\top \mathbf{z} + r)^d\) |
grau \(d\), \(\gamma > 0\), \(r \geq 0\) |
| Radial (RBF, gaussiano) |
\(\exp\big(-\gamma \|\mathbf{x} - \mathbf{z}\|^2\big)\) |
\(\gamma > 0\) |
| Sigmoide |
\(\tanh(\kappa\, \mathbf{x}^\top \mathbf{z} + \theta)\) |
\(\kappa\), \(\theta\) |
- O radial é o mais usado na prática. A sigmoide nem sempre é um kernel válido (precisa gerar matriz positiva semidefinida).
- Função de decisão com kernel: \(\displaystyle \; f(\mathbf{x}) = \sum_{i \in \text{SV}} \alpha_i y_i\, K(\mathbf{x}_i, \mathbf{x}) + b, \qquad \hat{y} = \text{sinal}\big(f(\mathbf{x})\big).\)
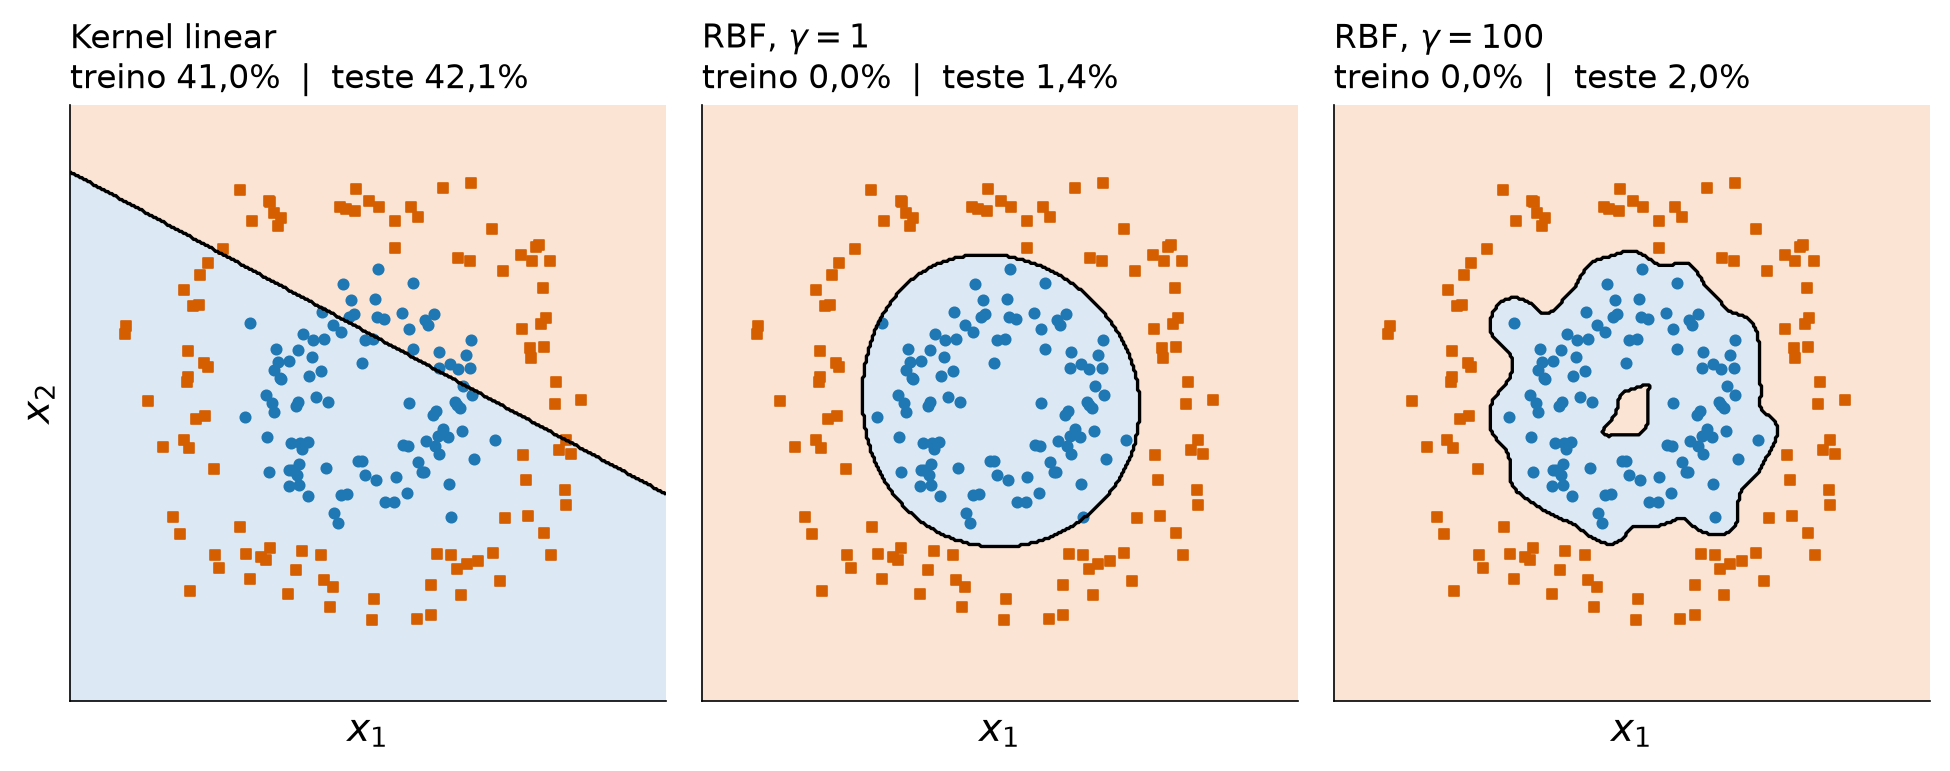
Kernel radial: o papel de \(\gamma\)
Dados simulados em círculos: \(n = 200\) no treino, \(4.000\) no teste, \(C = 1\).
O kernel linear não consegue separar círculos.
RBF com \(\gamma\) grande: influência mais local, fronteira irregular, risco de sobreajuste.
Mais de duas classes
O SVM é binário. Com \(c > 2\) classes, combinamos vários SVMs:
- Um contra todos (one-vs-rest): ajustam-se \(c\) classificadores, \(f_g\) separando a classe \(g\) das demais, e
\[\hat{y} = \arg\max_{g \in \{1, \ldots, c\}} f_g(\mathbf{x}).\]
Um contra um (one-vs-one): ajustam-se \(\binom{c}{2} = \frac{c(c-1)}{2}\) classificadores, um para cada par de classes; a classe final é a mais votada.
Com \(c = 4\): 4 classificadores (um contra todos) ou 6 (um contra um). Bibliotecas como a libsvm usam um contra um.
Resumo do processo
- Padronize as preditoras: o SVM usa distâncias e produtos internos.
- Escolha o kernel (linear, polinomial ou radial).
- Escolha os hiperparâmetros (\(C\) e, se houver, \(\gamma\) ou \(d\)) por validação cruzada, em escala logarítmica (ex.: \(C \in \{0{,}01; 0{,}1; 1; 10; 100\}\)).
- Resolva o problema dual: obtenha os \(\alpha_i\) e os vetores de suporte (\(\alpha_i > 0\)).
- Classifique novos pontos por \(\hat{y} = \text{sinal}\big(\sum_{i \in \text{SV}} \alpha_i y_i K(\mathbf{x}_i, \mathbf{x}) + b\big)\).
Só os vetores de suporte entram na previsão: os demais pontos podem ser removidos sem mudar \(f\).
Vantagens e Limitações
Vantagens
- Fundamentação geométrica e de otimização convexa (solução única);
- fronteiras não lineares com kernels;
- funciona bem com muitas preditoras;
- previsão depende só dos vetores de suporte.
Limitações
- Lento para \(n\) muito grande;
- sensível à escala e à escolha de \(C\) e \(\gamma\);
- não fornece probabilidades diretamente;
- com kernel não linear, é pouco interpretável.
Prática no Google Colab
SVM linear e radial em Python
Referências
Cortes, C. e Vapnik, V. Support-Vector Networks. Machine Learning, 20(3), 273–297, 1995.
Boser, B., Guyon, I. e Vapnik, V. A Training Algorithm for Optimal Margin Classifiers. COLT, 1992.
James, G., Witten, D., Hastie, T. e Tibshirani, R. An Introduction to Statistical Learning. 2ª ed., Springer, 2021.
Hastie, T., Tibshirani, R. e Friedman, J. The Elements of Statistical Learning. 2ª ed., Springer, 2009.
Izbicki, R. e Santos, T. M. Aprendizado de Máquina: uma abordagem estatística. 2020.
Morettin, P. e Singer, J. Estatística e Ciência de Dados. LTC, 2022.