Introdução à Ciência de Dados

k-NN: k Vizinhos Mais Próximos

Prof. Jodavid Ferreira

UFPE

Classificação: relembrando


  • Observamos \((\mathbf{x}_i, y_i)\), \(i = 1, \ldots, n\), com \(\mathbf{x}_i = [x_{i1}, \ldots, x_{ip}]^\top \in \mathbb{R}^p\) e \(y_i \in \mathcal{C} = \{1, \ldots, c\}\).

  • Um classificador é uma função \(f : \mathbb{R}^p \rightarrow \mathcal{C}\), com risco \(\; L(f) = P\{Y \neq f(\mathbf{X})\}\).

  • O classificador que minimiza \(L(f)\) é o classificador de Bayes:

\[f^*(\mathbf{x}) = \arg\max_{g \in \mathcal{C}} \; P(Y = g \mid \mathbf{X} = \mathbf{x}).\]

  • Na prática, \(P(Y = g \mid \mathbf{X} = \mathbf{x})\) é desconhecida e precisa ser estimada a partir dos dados.

Ideia do k-NN: estimar essa probabilidade olhando os vizinhos de \(\mathbf{x}\).


k-NN


Intuição


Intuição


“Diga-me com quem andas…”
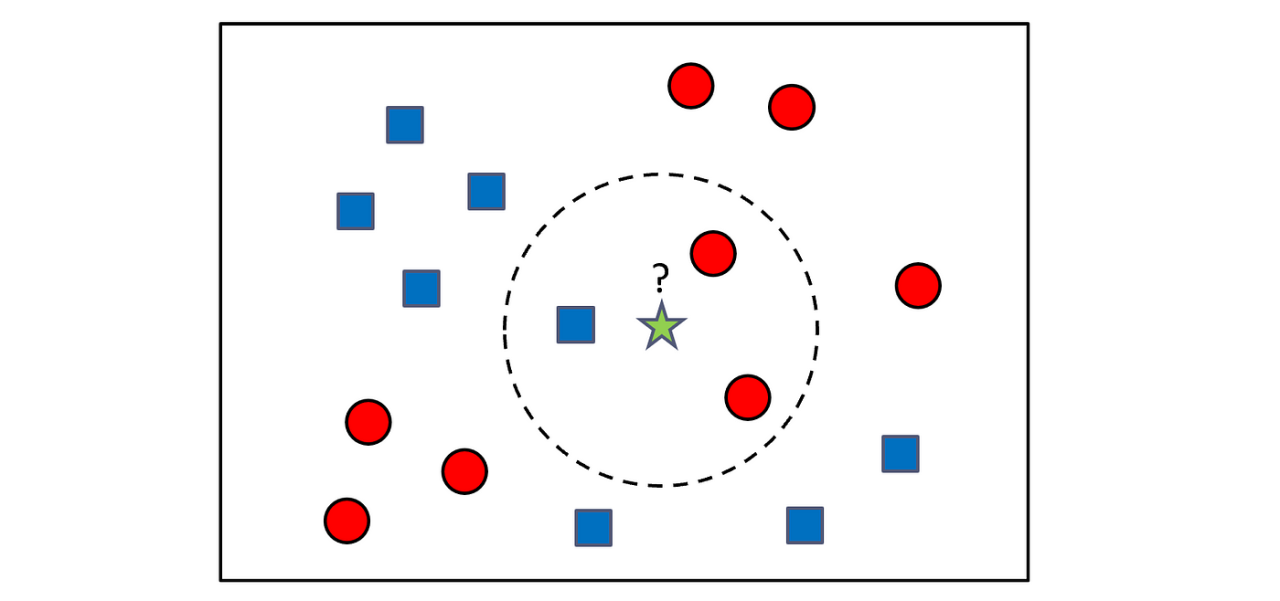

  • A estrela é círculo ou quadrado? Olhamos seus vizinhos e votamos.
  • Proposto por Fix e Hodges (1951); estudado por Cover e Hart (1967).

  • Não paramétrico e baseado em instâncias: não estima parâmetros, apenas guarda o treino.

O k-NN formalmente


Para um novo ponto \(\mathbf{x}_0\) e uma distância \(d\), ordene as distâncias ao treino:

\[d(\mathbf{x}_0, \mathbf{x}_{(1)}) \leq d(\mathbf{x}_0, \mathbf{x}_{(2)}) \leq \cdots \leq d(\mathbf{x}_0, \mathbf{x}_{(n)}).\]

Definição 1. A vizinhança \(\mathcal{N}_k(\mathbf{x}_0)\) é o conjunto dos índices das \(k\) observações mais próximas, \(\mathbf{x}_{(1)}, \ldots, \mathbf{x}_{(k)}\). O k-NN estima

\[\hat{P}(Y = g \mid \mathbf{x}_0) = \frac{1}{k}\sum_{i \in \mathcal{N}_k(\mathbf{x}_0)} \mathbb{I}(y_i = g) \quad \text{e} \quad \hat{y}_0 = \arg\max_{g \in \mathcal{C}} \hat{P}(Y = g \mid \mathbf{x}_0).\]

  • \(\hat{P}\): proporção de vizinhos da classe \(g\); \(\hat{y}_0\): classe mais frequente entre eles.

E como medimos “proximidade”? Com uma distância.

Distância


Definição 2. Uma distância (métrica) é uma função \(d\) tal que, para quaisquer vetores \(\mathbf{x}, \mathbf{z}, \mathbf{w} \in \mathbb{R}^p\):

  1. \(d(\mathbf{x}, \mathbf{z}) \geq 0\);

  2. \(d(\mathbf{x}, \mathbf{z}) = 0\) se, e somente se, \(\mathbf{x} = \mathbf{z}\);

  3. \(d(\mathbf{x}, \mathbf{z}) = d(\mathbf{z}, \mathbf{x})\) (simetria);

  4. \(d(\mathbf{x}, \mathbf{z}) \leq d(\mathbf{x}, \mathbf{w}) + d(\mathbf{w}, \mathbf{z})\) (desigualdade triangular).

  • Interpretação: distância é não negativa, só é zero entre pontos iguais, não depende da ordem e o caminho direto nunca é mais longo que um desvio.

Distâncias mais usadas


  • Euclidiana (a “régua”): \(\quad d_2(\mathbf{x}, \mathbf{z}) = \sqrt{\sum_{l=1}^{p} (x_l - z_l)^2}\).

  • Manhattan (caminhar por quarteirões): \(\quad d_1(\mathbf{x}, \mathbf{z}) = \sum_{l=1}^{p} |x_l - z_l|\).

  • Minkowski (generaliza as duas, \(q \geq 1\)): \(\quad d_q(\mathbf{x}, \mathbf{z}) = \Big(\sum_{l=1}^{p} |x_l - z_l|^q\Big)^{1/q}\).

  • Mahalanobis (leva em conta a correlação entre as variáveis):

\[d_M(\mathbf{x}, \mathbf{z}) = \sqrt{(\mathbf{x} - \mathbf{z})^\top \mathbf{S}^{-1} (\mathbf{x} - \mathbf{z})},\]

em que \(\mathbf{S}\) é a matriz de covariância amostral dos dados de treino. Com \(\mathbf{S} = \mathbf{I}\), ela é a euclidiana.

Exemplo numérico


Ponto \(x_1\) \(x_2\) Classe
1 3 4 Azul
2 4 2 Laranja
3 2 2 Laranja
4 5 5 Azul
5 1 4 Azul
6 5 3 Laranja

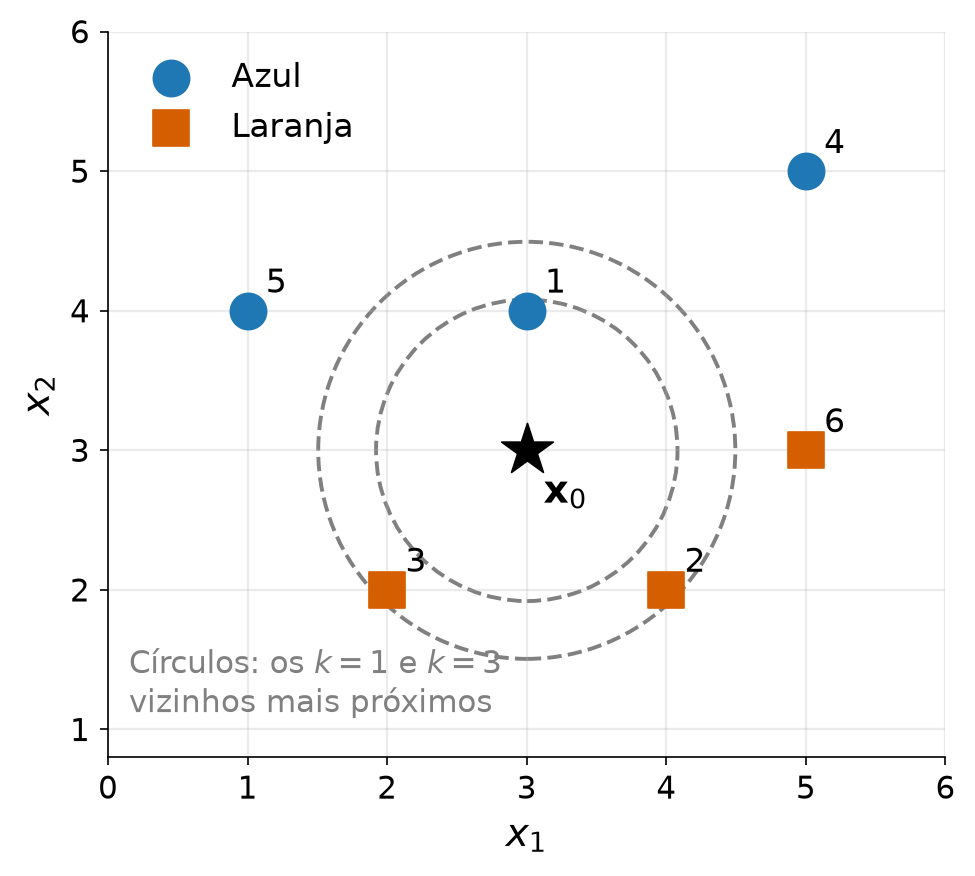
Novo ponto (a estrela): \(\mathbf{x}_0 = (3, 3)\).

Exemplo numérico - Solução


Exercício: classifique \(\mathbf{x}_0 = (3, 3)\) com \(k = 1\), \(3\) e \(5\) (distância euclidiana).

Ex.: \(d(\mathbf{x}_0, \mathbf{x}_2) = \sqrt{(3-4)^2 + (3-2)^2} = \sqrt{2} \approx 1{,}41\).

Ponto 1 2 3 6 5 4
\(d(\mathbf{x}_0, \mathbf{x}_i)\) 1 1,41 1,41 2 2,24 2,83
Classe Azul Laranja Laranja Laranja Azul Azul
  • \(k = 1\): vizinho {1} \(\Rightarrow\) Azul.
  • \(k = 3\): vizinhos {1, 2, 3}: \(\hat{P}(\text{Laranja} \mid \mathbf{x}_0) = 2/3\) \(\Rightarrow\) Laranja.
  • \(k = 5\): vizinhos {1, 2, 3, 6, 5}: \(\hat{P}(\text{Laranja} \mid \mathbf{x}_0) = 3/5\) \(\Rightarrow\) Laranja.

A classe predita depende de \(k\).

Cuidado com a escala


Preditoras: idade (anos) e salário (R$). Novo ponto \(\mathbf{x}_0 = (30;\ 5.000)\).

Pessoa Idade Salário \(d\) sem padronizar \(d\) padronizada
A 31 8.000 3.000,0 1,50
B 60 5.100 104,4 3,00
  • Sem padronizar: B parece mais próxima; o salário domina a distância.
  • Padronizando (desvios-padrão: 10 anos e R$ 2.000): A é a mais próxima.

Padronização, qualitativas e empates


Padronização (escore z): para cada preditora \(l\), \(\; z_{il} = \dfrac{x_{il} - \bar{x}_l}{s_l}\), com \(\bar{x}_l\) e \(s_l\) calculados no treino.

  • Distâncias exigem preditoras numéricas: qualitativas viram indicadoras (dummies) ou usam distâncias para dados mistos (ex.: Gower).
  • Empates na votação: com duas classes, usar \(k\) ímpar evita empates.
  • k-NN ponderado: vizinhos mais próximos podem ter peso maior, por exemplo \(w_i = 1/d(\mathbf{x}_0, \mathbf{x}_i)\): \[\hat{P}(Y = g \mid \mathbf{x}_0) = \frac{\sum_{i \in \mathcal{N}_k} w_i\, \mathbb{I}(y_i = g)}{\sum_{i \in \mathcal{N}_k} w_i}.\]

A escolha de \(k\)


Dados simulados (\(n = 200\) no treino e \(5.000\) no teste), duas preditoras:
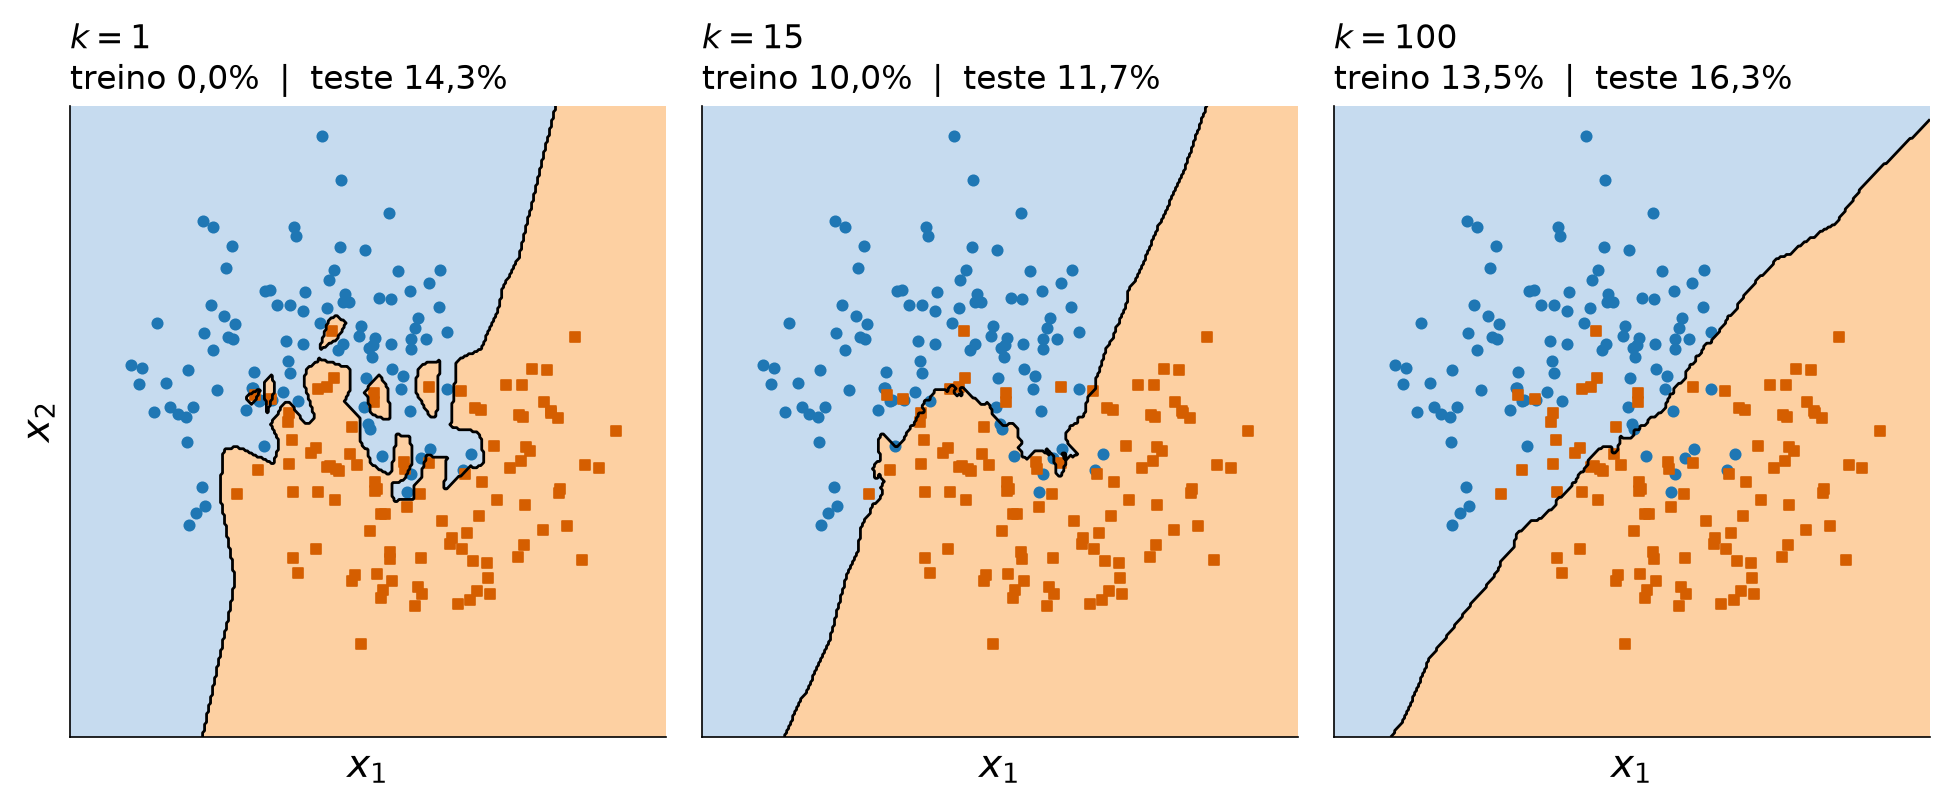
  • \(k = 1\): fronteira recortada; baixo viés, alta variância.
  • \(k\) grande: fronteira suave; alto viés, baixa variância.

A escolha de \(k\)
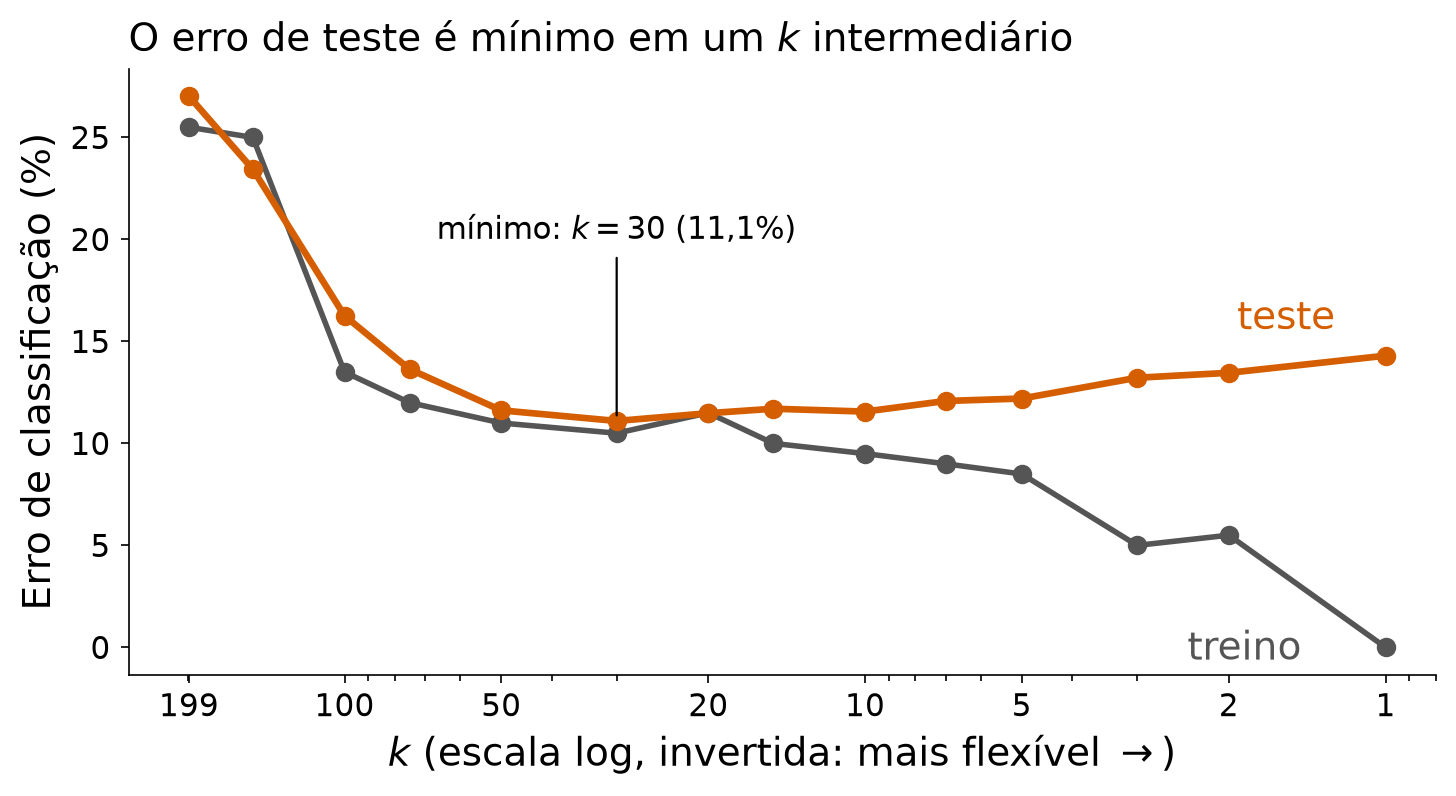

  • O erro de treino sempre diminui quando \(k\) diminui; o de teste, não.

  • \(k\) é um hiperparâmetro: escolha-o por validação cruzada, nunca pelo erro de treino nem pelos dados de teste.

Vantagens e Limitações


Vantagens

  • Simples e intuitivo;
  • não paramétrico: fronteiras de qualquer forma;
  • um único hiperparâmetro principal (\(k\));
  • estima probabilidades de classe.

Limitações

  • Predição lenta: calcula \(n\) distâncias por ponto;
  • guarda todo o treino na memória;
  • sensível à escala e a preditoras irrelevantes;
  • sofre com a dimensionalidade.

Antes de usar: padronize as preditoras e escolha \(k\) por validação cruzada.


Prática no Google Colab


k-NN em R e em Python

Referências


  • Cover, T. e Hart, P. Nearest Neighbor Pattern Classification. IEEE Trans. Inf. Theory, 13(1), 21–27, 1967.

  • Stone, C. J. Consistent Nonparametric Regression. Annals of Statistics, 5(4), 595–645, 1977.

  • James, G., Witten, D., Hastie, T. e Tibshirani, R. An Introduction to Statistical Learning. 2ª ed., Springer, 2021.

  • Hastie, T., Tibshirani, R. e Friedman, J. The Elements of Statistical Learning. 2ª ed., Springer, 2009.

  • Izbicki, R. e Santos, T. M. Aprendizado de Máquina: uma abordagem estatística. 2020.

  • Morettin, P. e Singer, J. Estatística e Ciência de Dados. LTC, 2022.


OBRIGADO!


Slide produzido com quarto