Segmentação de Imagens PolSAR baseada em Entropia de Shannon e Modelos Matriciais


Jodavid Ferreira

Departamento de Estatística — UFPE

Coautores: Abraão D. C. Nascimento (UFPE) & Alejandro C. Frery (VUW)
Sobre a Apresentação


Estrutura:

  1. Imagens PolSAR e seus desafios
  2. Modelos Estatísticos: Wishart e \(\mathcal{G}^0_m\)
  3. Entropia de Shannon e Teoria da Informação
  4. Algoritmo de Segmentação (SEM)
  5. Aplicações Reais e Simulação
  6. Conclusões e Trabalhos Futuros

  • Artigo: Unsupervised segmentation of PolSAR data with complex Wishart and \(\mathcal{G}^0_m\) distributions and Shannon entropy
  • Publicado em: Statistics and Computing, 33:129 (2023)
  • DOI: 10.1007/s11222-023-10298-0

Introdução


  • RADAR é um acrônimo de Radio Detection and Ranging

  • Ele é baseado nos princípios de propagação eletromagnética, em que uma onda eletromagnética é emitida por uma fonte e é retroespalhada para o radar

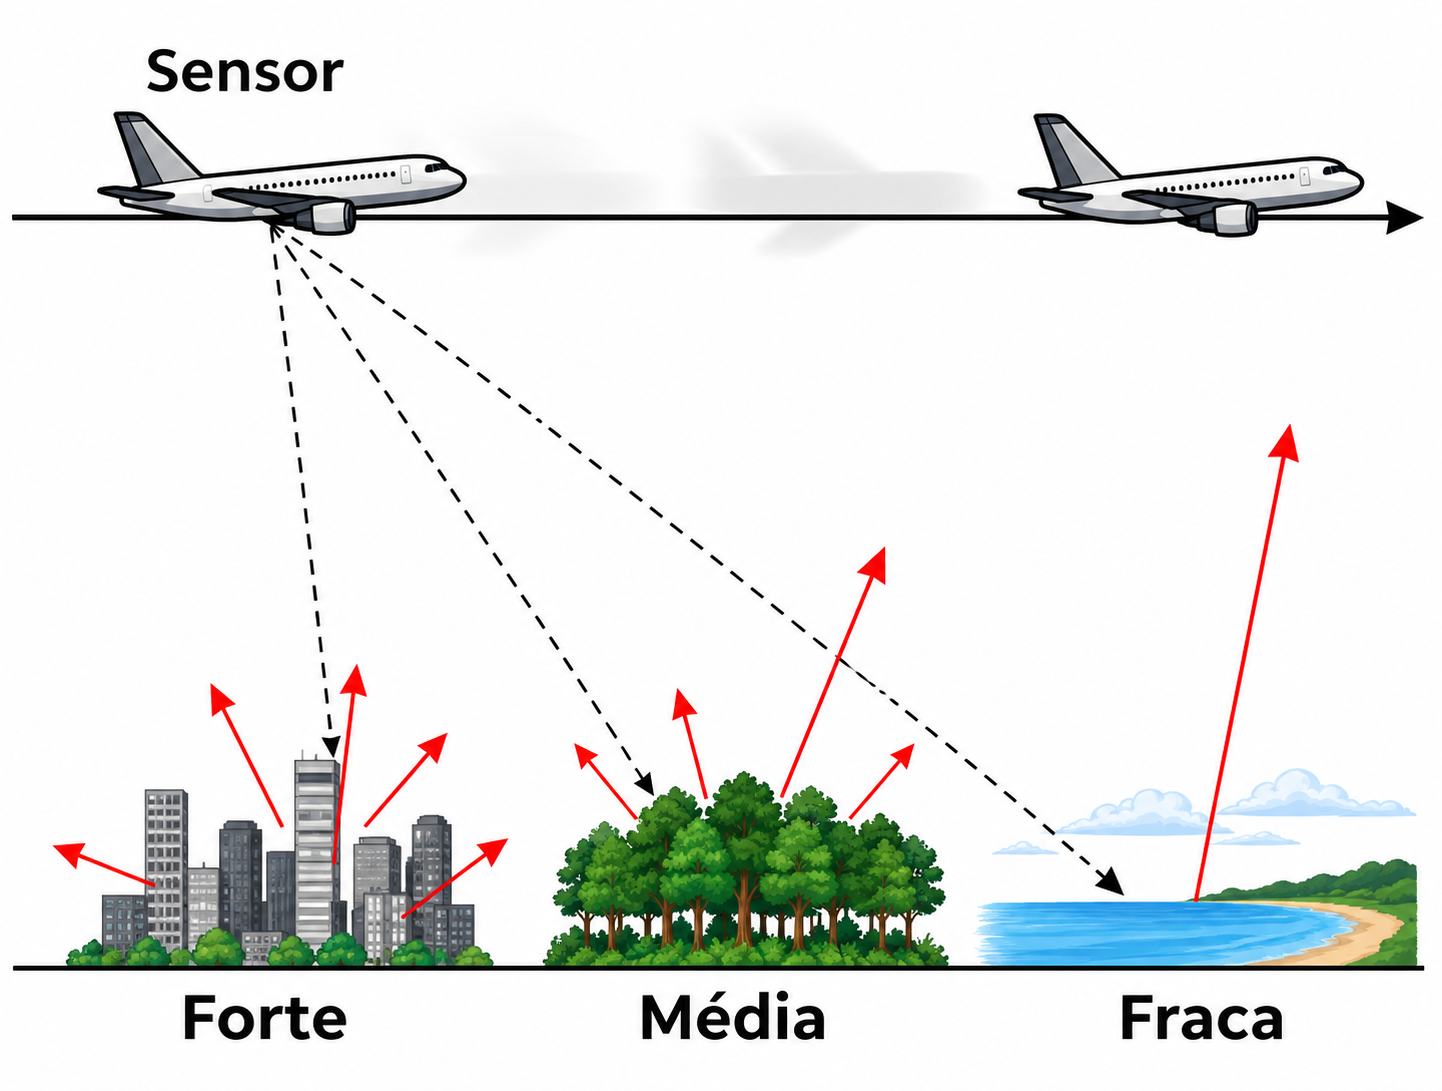
  • Uma imagem de radar é o resultado de uma interação entre a energia emitida pelo radar e o objeto sob estudo, e a aparência da imagem é influenciada pela forma e a textura do alvo;
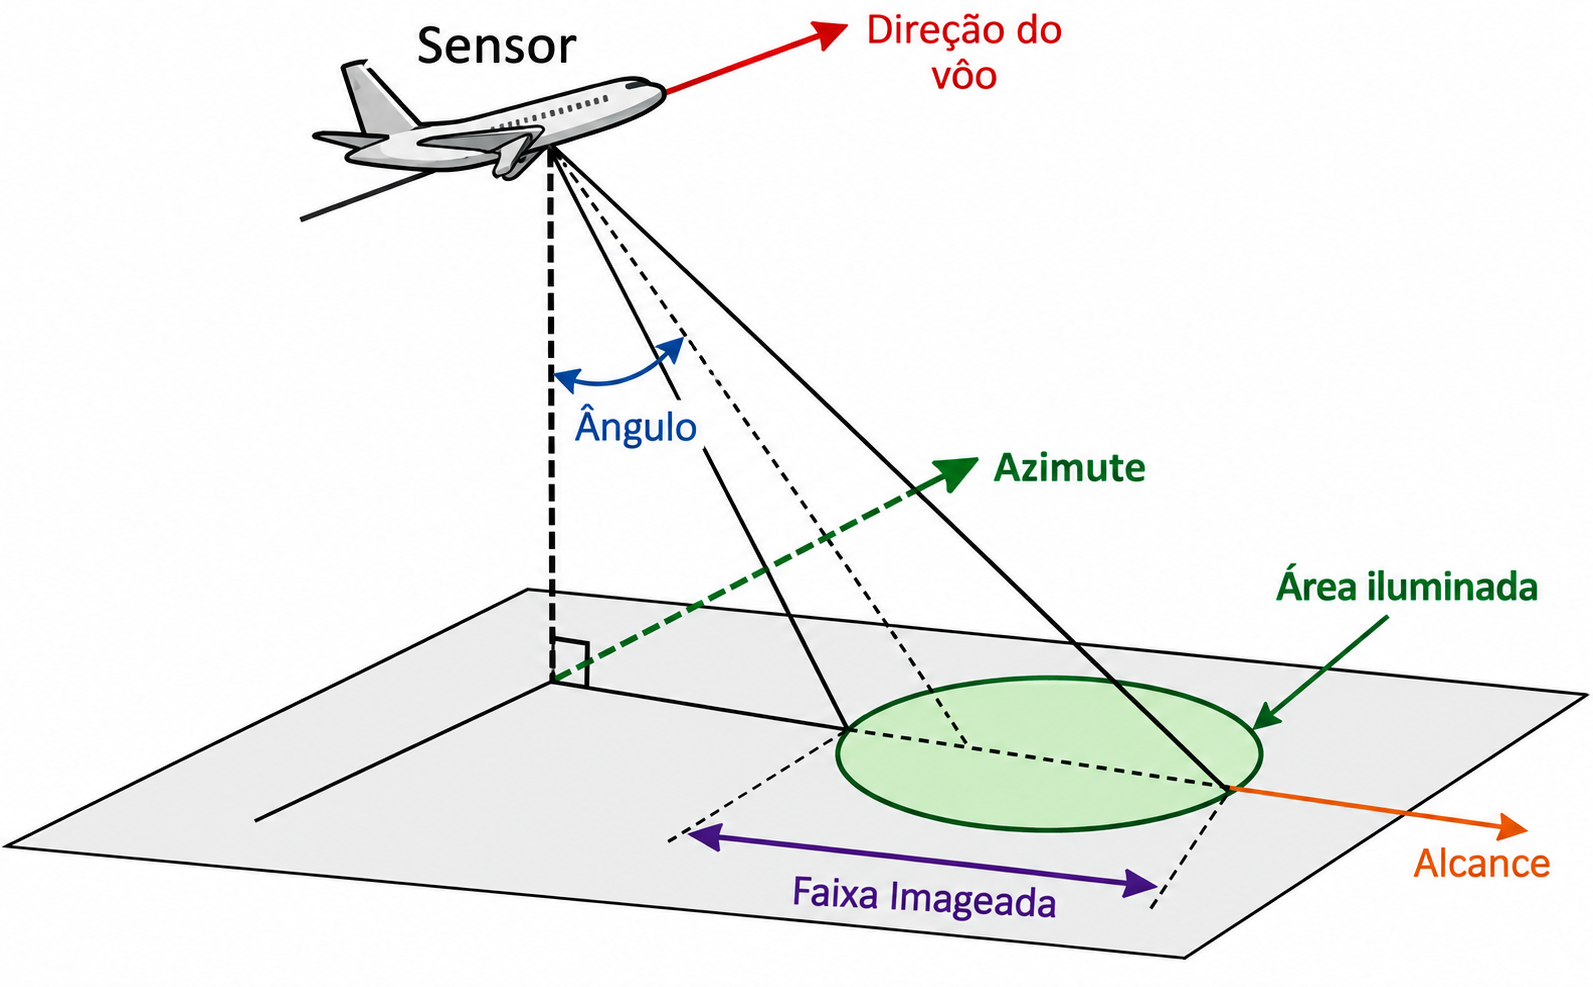
Geometria de uma imagem de RADAR.

Níveis de textura de acordo com o sinal retornado.

Introdução


  • Radar de Abertura Sintética (Synthetic Aperture Radar - SAR) geralmente são estão acoplado a uma plataforma que transmite micro-ondas ao longo de sua rota planejada em direção a um cenário geográfico;

  • Pulsos são emitidos em direção ao cenário e o radar recebe os sinais de retorno que são processados para formar uma imagem, estes podem ser na polarização circular ou linear.
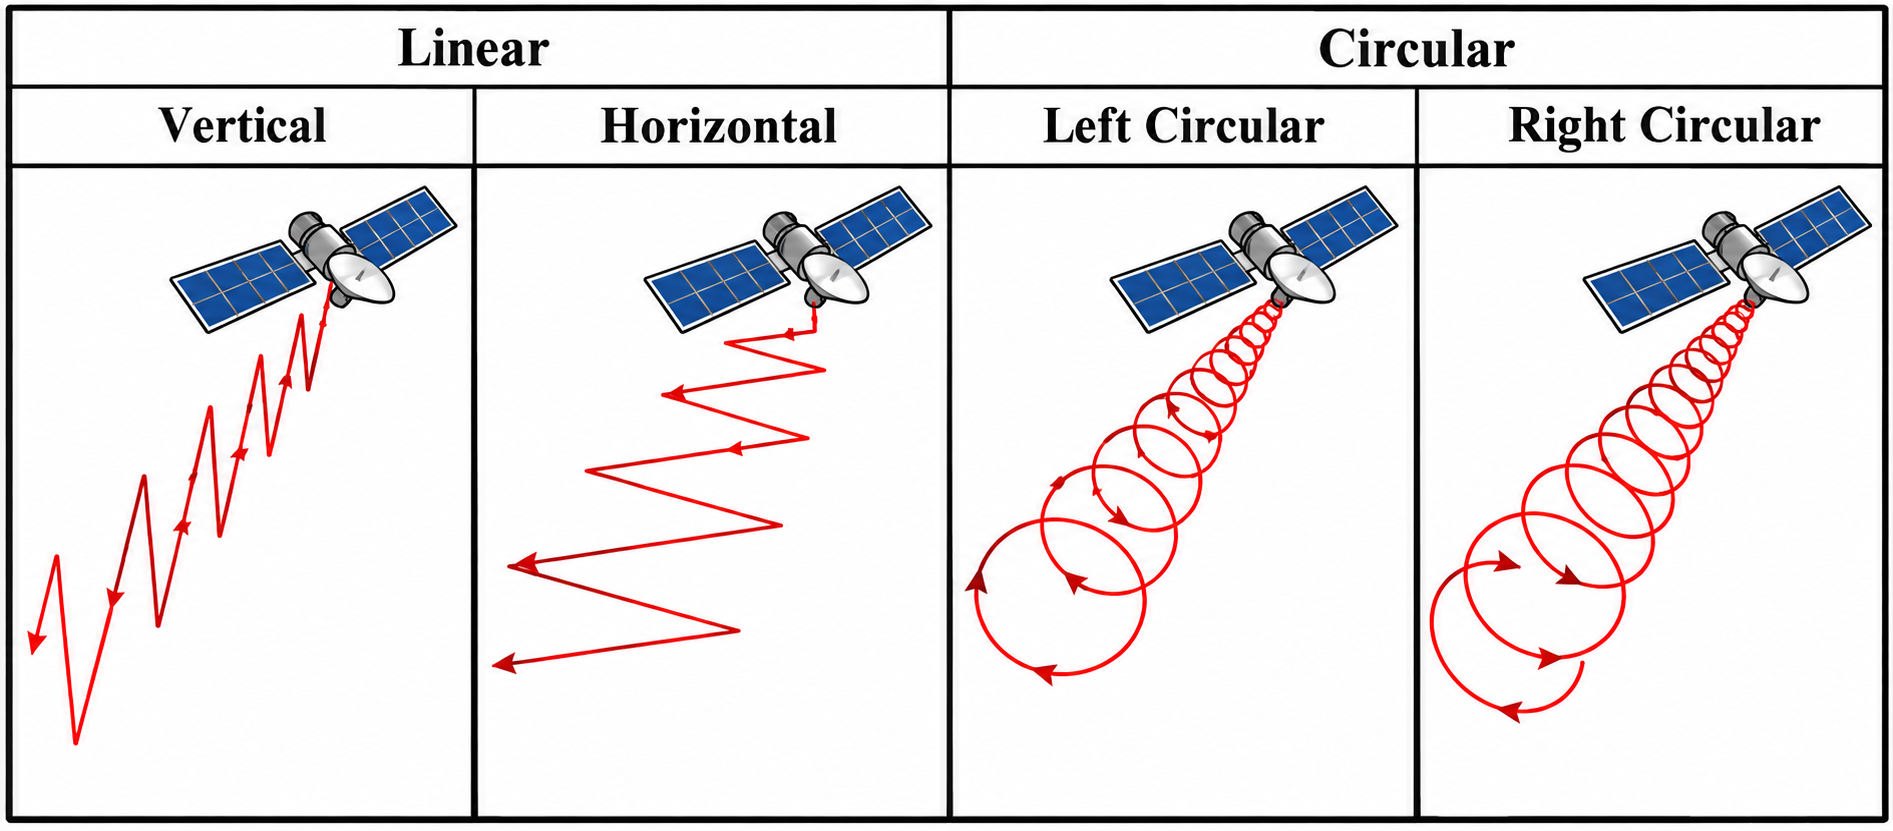
  • Quando apenas um par de direções é usado, as imagens geradas são chamadas de SAR monopolarizadas e, quando várias direções são usadas, o processo é chamado de PolSAR (SAR Polarimétrico);

Introdução


Vantagens

  • Images SAR podem ser obtidas de qualquer lugar (terra, mar,…);
  • a qualquer momento (dia ou noite);
  • em quase todas as condições climáticas (nuvens, chuva);
  • produzem imagens de alta resolução (alta largura de banda) das superfícies estudadas;


Desvantagens

  • custo elevado para aquisição e manutenção dos satélites e radares;
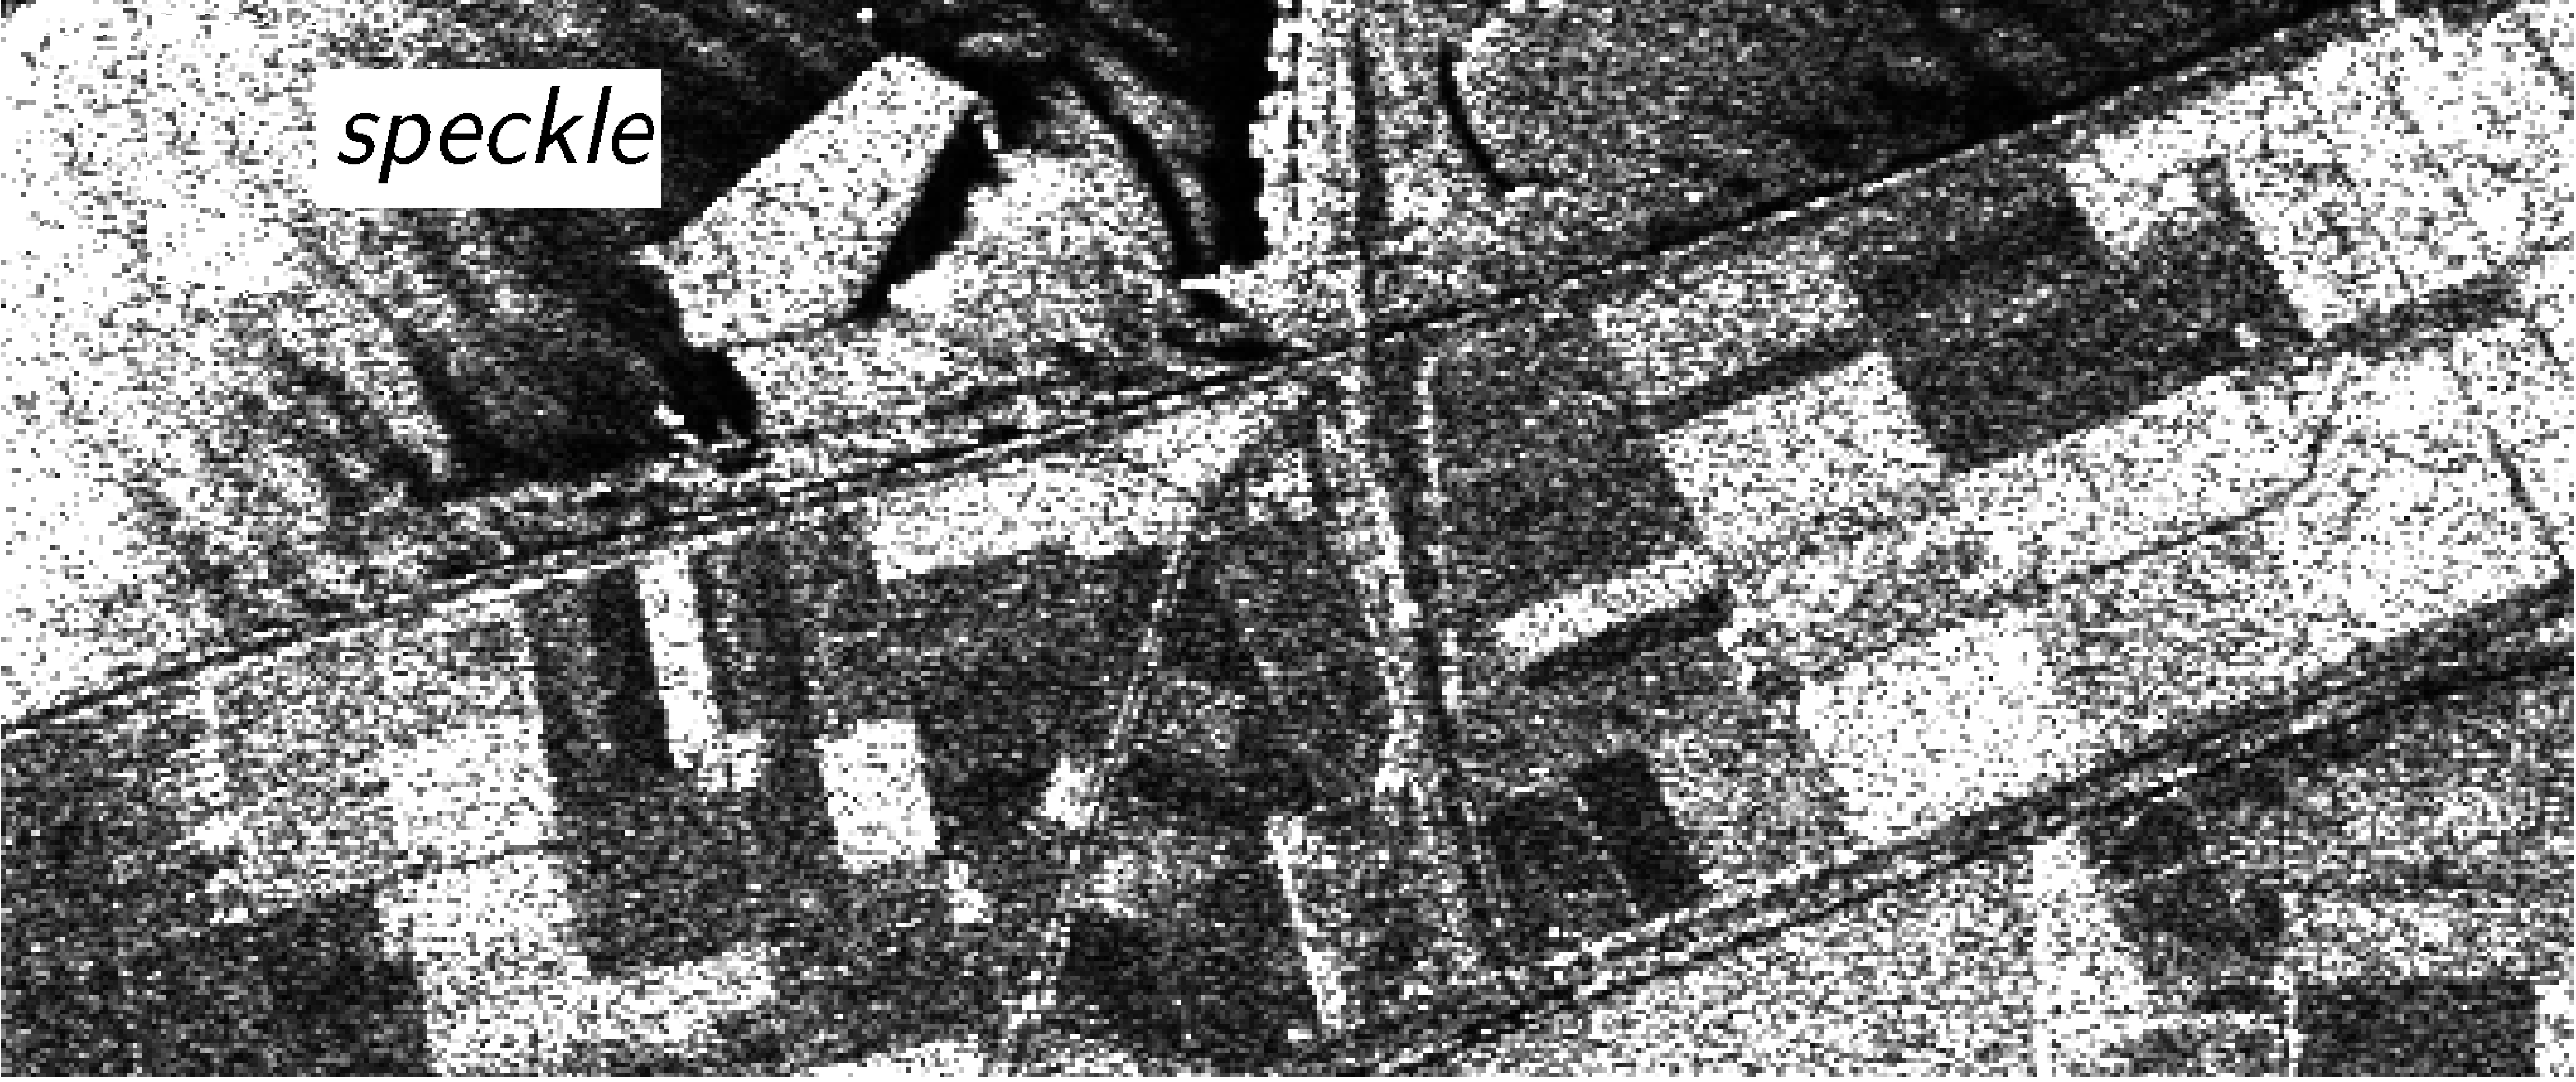
  • as imagens são afetadas por um ruído chamado speckle, que cria uma aparência granulada nas imagens, dificultando a interpretação e análise;
Introdução


Speckle em imagem SAR.

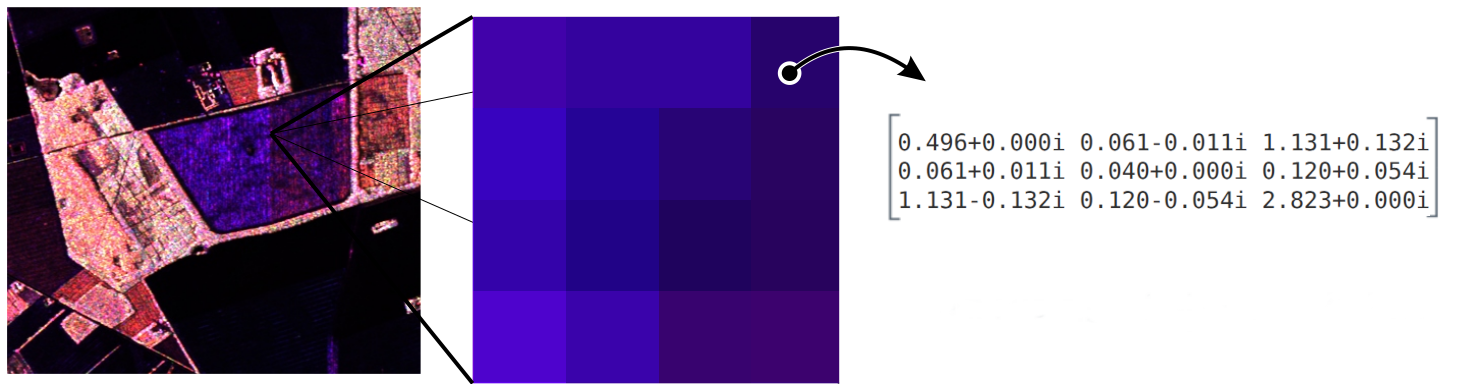
Dados Polarimétricos multi-look
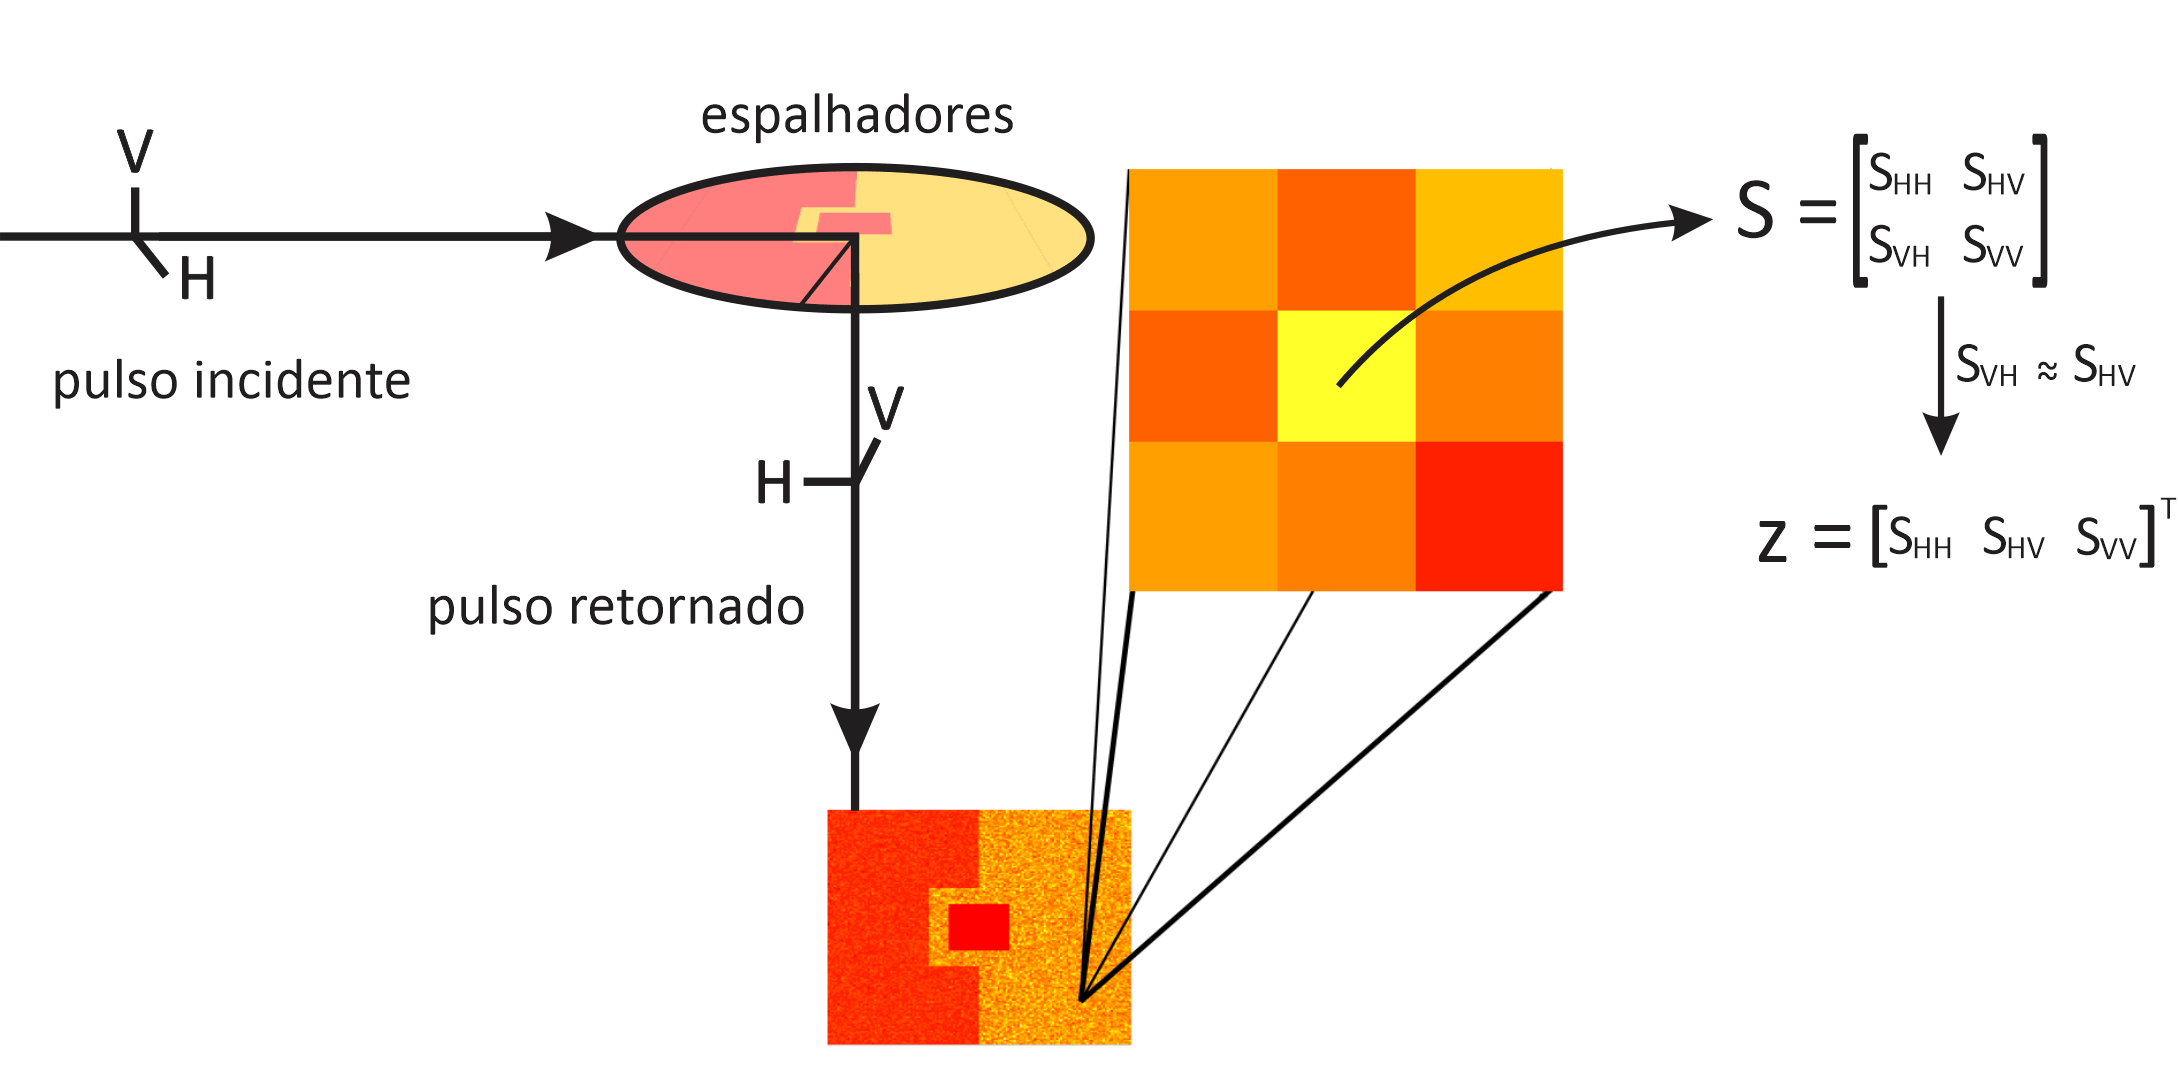

Cada pixel de uma imagem PolSAR pode ser associado a uma matriz de espalhamento complexa:

\[ \mathbf{S}= \begin{pmatrix} S_{hh} & S_{hv}\\ S_{vh} & S_{vv} \end{pmatrix}, \]

em que \(S_{hh}\), \(S_{hv}\), \(S_{vh}\) e \(S_{vv}\) são os coeficientes complexos da matriz de espalhamento para os respectivos canais de polarização. Os subscritos \(h\) e \(v\) representam as polarizações horizontal e vertical, respectivamente.

Cada coeficiente complexo pode ser representado na forma polar como

\[ S_{rs}=A_{rs}e^{i\phi_{rs}} =A_{rs}\cos(\phi_{rs}) +iA_{rs}\sin(\phi_{rs}), \]

em que

\[ \operatorname{Re}(S_{rs})=A_{rs}\cos(\phi_{rs}), \qquad \operatorname{Im}(S_{rs})=A_{rs}\sin(\phi_{rs}). \]

Além disso,

\[ A_{rs}=|S_{rs}| \]

é a amplitude, \(\phi_{rs}=\arg(S_{rs})\) é a fase do coeficiente de espalhamento, \(i=\sqrt{-1}\) é a unidade imaginária, e \(r,s\in\{h,v\}\).

Dados Polarimétricos multi-look


  • Na prática, as polarizações cruzadas são muito semelhantes; ou seja, \(S_{hv} \approx S_{vh}\).

Dados Polarimétricos multi-look


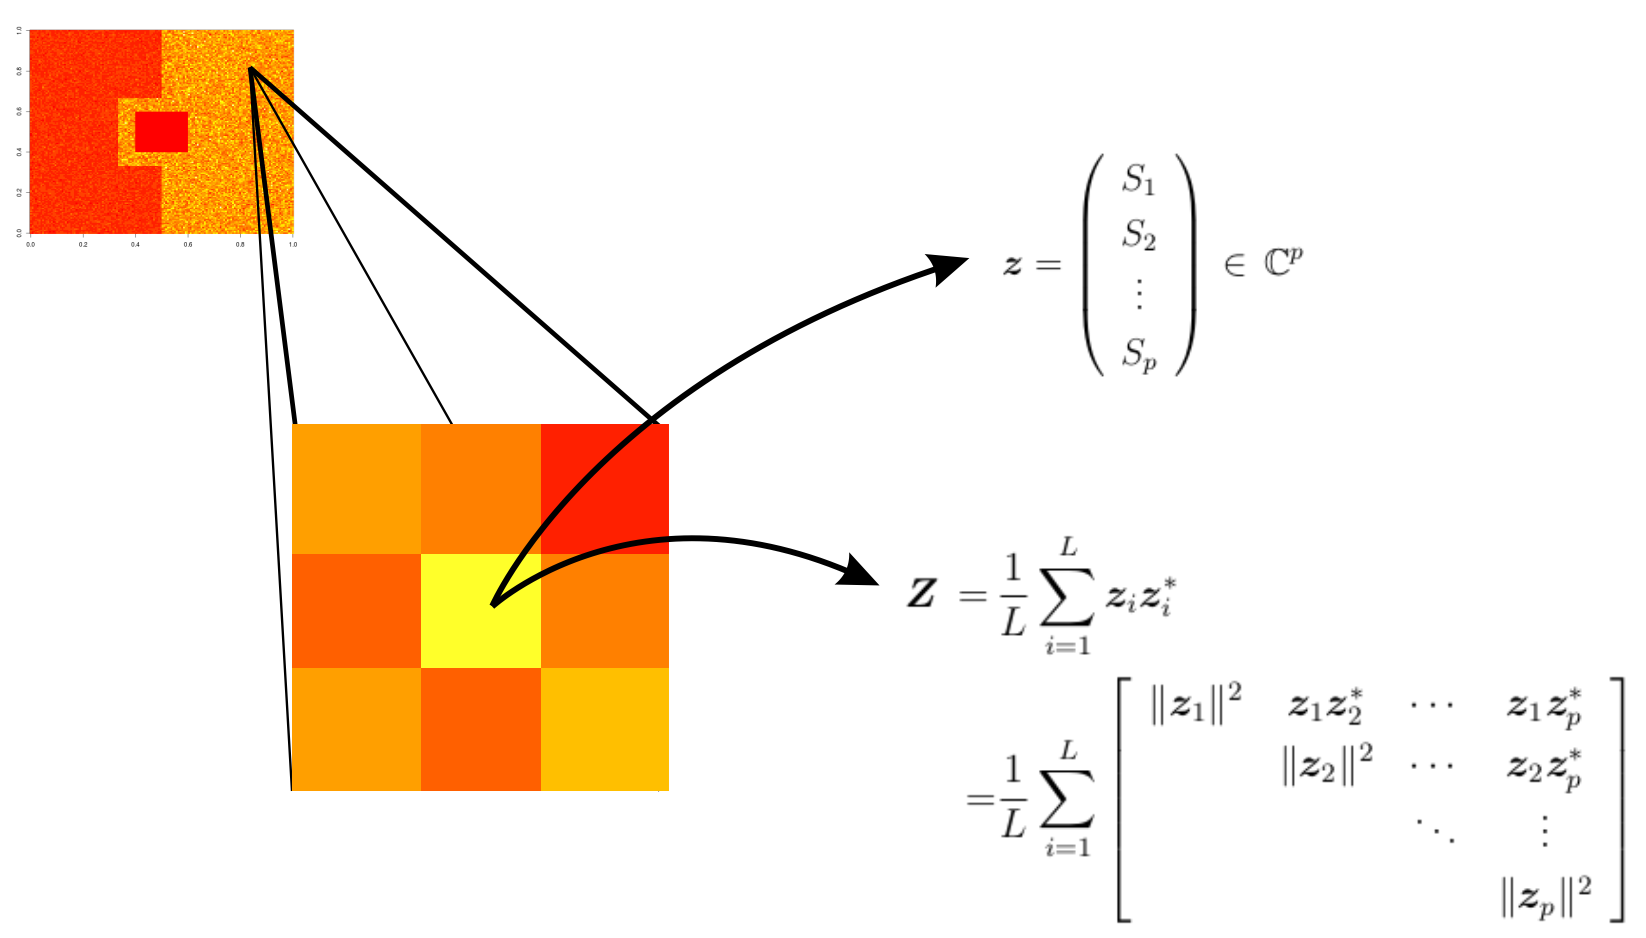
  • Dados PolSAR single-look não levam em conta o controle do efeito speckle sobre as imagens
  • Um processo para contornar isso é chamado de processamento multi-look
Dados Polarimétricos multi-look


\(\mathbf{z}_i = (S_1^{(i)}\,S_2^{(i)}\,\cdots\,S_p^{(i)})^{\top} \, \in \mathbb{C}^{p}\) é o \(i\)-ésimo vetor associado a \(p\) canais de polarização em uma amostra de \(L\) informações extraídas da mesma cena, para \(i=1,\ldots,L\).

Dados Polarimétricos multi-look


  • Uma imagem PolSAR pode ser entendida como uma cena, na qual cada entrada está associada a uma matriz hermitiana definida positiva, o que requer o uso de métodos de processamento multivariado
Modelos Estatísticos para Dados PolSAR

O Modelo Wishart Complexo (\(\mathcal{W}_m\))


Se o alvo possui textura uniforme (speckle plenamente desenvolvido), \(\mathbf{Z}\) segue a distribuição Wishart Complexa Escalada:

\[f_{\mathbf{Z}}(\dot{\mathbf{Z}};\boldsymbol\Sigma,L) = \frac{L^{mL}|\dot{\mathbf{Z}}|^{L-m}}{|\boldsymbol\Sigma|^L \Gamma_m(L)}e^{ -L \operatorname{tr}(\boldsymbol\Sigma^{-1}\dot{\mathbf{Z}})}\]

  • \(\boldsymbol\Sigma = \mathbb{E}[\mathbf{Z}]\): Matriz de covariância populacional
  • \(\Gamma_m(L) = \pi^{m(m-1)/2} \prod_{i=0}^{m-1} \Gamma(L-i)\): Função gama multivariada
  • Suporte: \(\Omega_+\) (matrizes Hermitianas positivas definidas)

Modelos Estatísticos para Dados PolSAR

Modelo Multiplicativo e a Distribuição \(\mathcal{G}^0_m\)


Em alvos heterogêneos (áreas urbanas, florestas), o modelo multiplicativo: \[\mathbf{Z} = X \cdot \mathbf{Y}, \quad X \perp \mathbf{Y}\]

  • \(\mathbf{Y} \sim \mathcal{W}_m(\boldsymbol\Sigma, L)\): speckle multilook
  • \(X \sim \text{Gama-Inversa}(-\alpha, (-\alpha-1)\mu)\): textura do terreno

Integrando (Freitas et al., 2005), obtém-se \(\mathbf{Z} \sim \mathcal{G}^0_m(\alpha, \boldsymbol\Sigma, L)\):

\[f_{\mathbf{Z}}(\dot{\mathbf{Z}};\alpha,\boldsymbol\Sigma,L) = \frac{L^{Lm}\Gamma(Lm-\alpha)|\dot{\mathbf{Z}}|^{L-m}}{|\boldsymbol\Sigma|^L(-\alpha-1)^{\alpha}\Gamma(-\alpha)\Gamma_m(L)} \big[-\alpha-1+L\operatorname{tr}(\boldsymbol\Sigma^{-1}\dot{\mathbf{Z}})\big]^{\alpha-Lm}\]

Modelos Estatísticos para Dados PolSAR

Interpretação Física do Parâmetro \(\alpha\)


O parâmetro \(\alpha \in \mathbb{R}_-\) controla a rugosidade/textura da cena:

Regime Valor de \(\alpha\) Exemplo
Extremamente homogêneo \(\alpha \to -\infty\) Oceano calmo, pastagem
Textura moderada \(\alpha \approx -4\) Florestas
Altamente heterogêneo \(\alpha \to -1\) Áreas urbanas


Propriedade Fundamental: Quando \(\alpha \to -\infty\), a distribuição \(\mathcal{G}^0_m\) converge para a Wishart \(\mathcal{W}_m\).
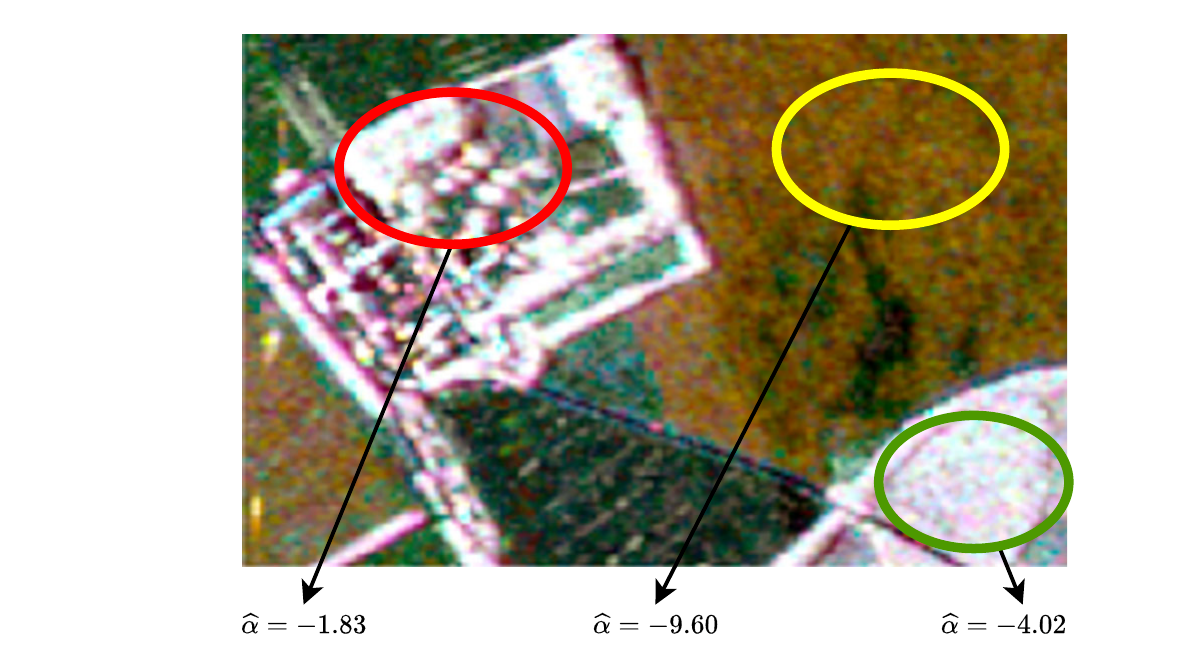
Fig. 1 — Alvos reais e estimativas de \(\alpha\) sob o modelo \(\mathcal{G}^0_m\): urbano (\(\hat{\alpha}=-1.83\)), floresta (\(\hat{\alpha}=-4.02\)), pastagem (\(\hat{\alpha}=-9.60\)).

Modelos Estatísticos para Dados PolSAR

Hierarquia dos Modelos


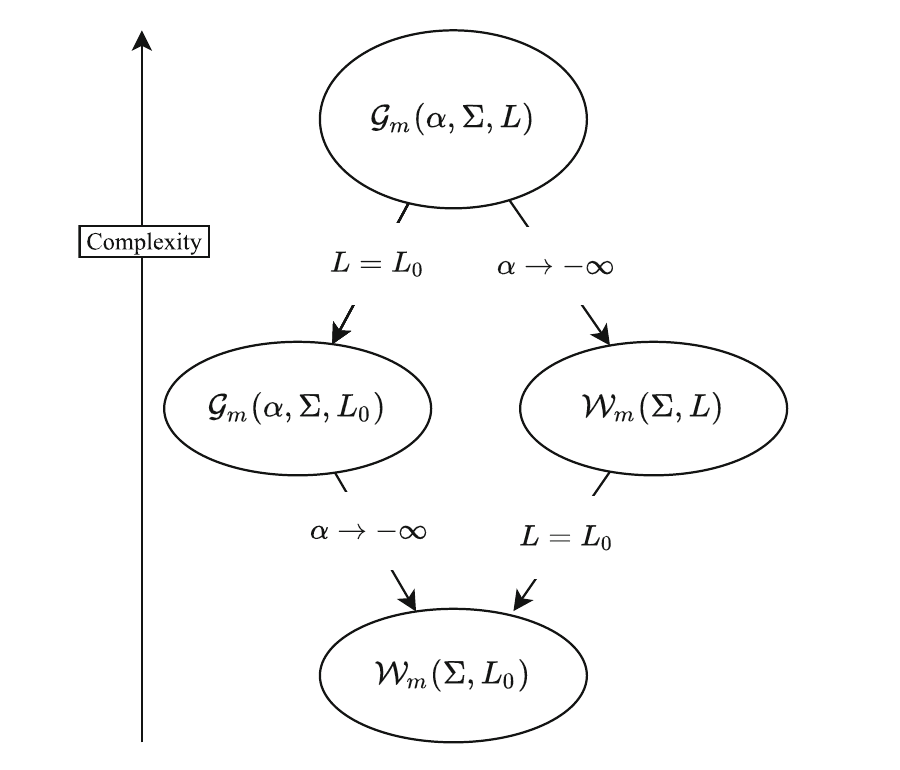
Quatro configurações segundo a dimensão paramétrica:

  1. \(\mathcal{G}^0_m(\alpha, \boldsymbol\Sigma, L)\): Todos os parâmetros estimados
  2. \(\mathcal{G}^0_m(\alpha, \boldsymbol\Sigma, L_0)\): ENL fixado e conhecido
  3. \(\mathcal{W}_m(\boldsymbol\Sigma, L)\): Caso limite Wishart com \(L\) estimado
  4. \(\mathcal{W}_m(\boldsymbol\Sigma, L_0)\): Caso Wishart com \(L_0\) fixado

\[\mathcal{G}^0_m(\alpha,\boldsymbol\Sigma,L) \supset \mathcal{G}^0_m(\alpha,\boldsymbol\Sigma,L_0) \supset \mathcal{W}_m(\boldsymbol\Sigma,L_0)\] \[\mathcal{G}^0_m(\alpha,\boldsymbol\Sigma,L) \supset \mathcal{W}_m(\boldsymbol\Sigma,L) \supset \mathcal{W}_m(\boldsymbol\Sigma,L_0)\]
Entropia de Shannon e Teoria da Informação

A Classe de Entropias \((h, \phi)\)


Proposta por Salicrú et al. (1994), generaliza diversas medidas de entropia clássicas:

\[H_{\phi}^h(\boldsymbol\theta) = h \left( \int_{\Omega_+} \phi\left( f_{\mathbf{Z}}(\dot{\mathbf{Z}}; \boldsymbol\theta) \right) d\dot{\mathbf{Z}} \right)\]


Entropia \((h, \phi)\) \(h(y)\) \(\phi(x)\)
Shannon \(y\) \(-x \ln x\)
Tsallis restrita (\(\beta \ne 1\)) \(y\) \(\frac{x^\beta - x}{1-\beta}\)
Rényi (\(\beta \ne 1\)) \(\frac{\ln y}{1-\beta}\) \(x^\beta\)

A Entropia de Shannon fornece uma medida escalar do contraste/desordem das matrizes de covariância.

Entropia de Shannon e Teoria da Informação

Teorema 1: Entropia de Shannon para \(\mathcal{G}^0_m\)


Resultado Principal (Nascimento, Ferreira & Frery, 2023):

Se \(\mathbf{Z} \sim \mathcal{G}^0_m(\alpha, \boldsymbol\Sigma, L)\), a Entropia de Shannon \(H_S(\mathcal{G}^0_m)\) é dada em forma fechada por:

\[H_S(\mathcal{G}^0_m) = H_S(\alpha, \boldsymbol\Sigma, L) = (m - L)\left[\log|\boldsymbol\Sigma| + \psi^{(0)}_m(L)\right]\]

\[+ \left[-m\log L + m\log(-\alpha-1) - m\psi^{(0)}(-\alpha)\right]\]

\[+ (mL - \alpha)\left[\psi^{(0)}(mL - \alpha) + \log(-\alpha-1) - \psi^{(0)}(-\alpha)\right]\]

\[- \log\frac{L^{mL}\Gamma(Lm-\alpha)}{|\boldsymbol\Sigma|^L(-\alpha-1)^\alpha\Gamma(-\alpha)\Gamma_m(L)}\]

onde \(\psi^{(0)}(\cdot)\) é a função digama.

Entropia de Shannon e Teoria da Informação

Caso Limite: Entropia da Wishart


Fazendo \(\alpha \to -\infty\) no Teorema 1, recupera-se o resultado de Frery et al. (2013):

\[H_S(\mathcal{W}_m) = \frac{m(m-1)}{2}\log \pi - m^2 \log L + m\log|\boldsymbol\Sigma| + mL + (m-L)\psi_m^{(0)}(L) + \sum_{k=0}^{m-1} \log\Gamma(L-k)\]

  • \(H_S(\mathcal{W}_m)\) é o limite superior para \(H_S(\mathcal{G}^0_m)\)
  • Adicionar rugosidade (textura) reduz a entropia
  • Consistente com a hierarquia \(\mathcal{G}^0_m \supset \mathcal{W}_m\)

Entropia de Shannon e Teoria da Informação

Sensibilidade da Entropia de Shannon
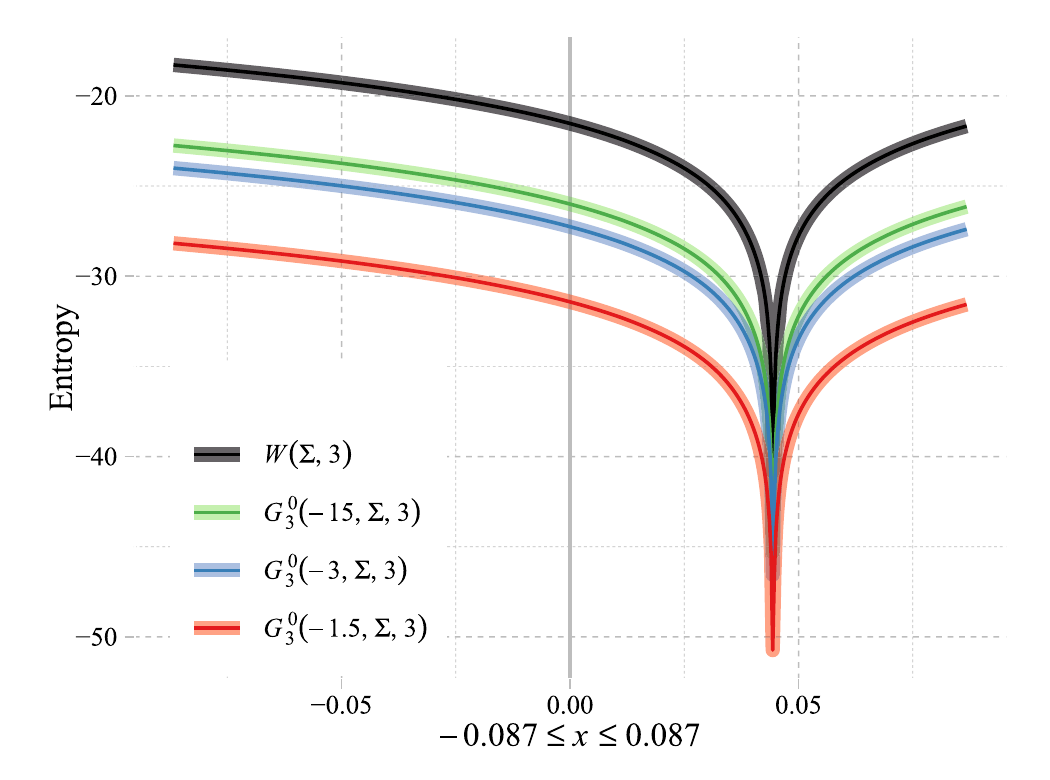

Fig. 3 — Curvas de entropia de Shannon dos modelos \(\mathcal{W}_3\) (preto) e \(\mathcal{G}^0_3\) para diferentes valores de \(\alpha\), variando a intensidade.


  • A entropia capta variações mínimas em:
    • Matriz de covariância \(\boldsymbol\Sigma\)
    • Parâmetro de textura \(\alpha\)
  • Convergência visual: \(\mathcal{G}^0_m \to \mathcal{W}_m\) quando \(\alpha \to -\infty\)

Entropia de Shannon e Teoria da Informação

Distribuição Assintótica do Estimador


Lema 1 (Pardo et al., 1997): Seja \(\hat{\boldsymbol\theta}\) o MLE baseado em amostra de tamanho \(T\):

\[\sqrt{T}\left( H_S(\hat{\boldsymbol\theta}) - H_S(\boldsymbol\theta) \right) \xrightarrow{\mathcal{D}} \mathcal{N}\left(0, \sigma_H^2(\boldsymbol\theta)\right)\]

Com variância assintótica via Método Delta: \[\sigma_H^2(\boldsymbol\theta) = \boldsymbol\delta^T \mathcal{K}(\boldsymbol\theta)^{-1} \boldsymbol\delta\]

  • \(\boldsymbol\delta = \left[ \frac{\partial H_S}{\partial \alpha},\; \left(\frac{\partial H_S}{\partial \operatorname{vec}(\boldsymbol\Sigma)}\right)^T,\; \frac{\partial H_S}{\partial L} \right]^T\)
  • \(\mathcal{K}(\boldsymbol\theta)\): analiticamente intratável → usamos Matriz de Informação Observada (OIM) em janelas \(9 \times 9\)

4. Algoritmo de Segmentação Não Supervisionada

O Modelo de Agrupamento


Classificar \(T\) pixels em \(c\) regiões/classes:

  1. Para cada pixel \(i\):

    • calcula-se a entropia estimada \(\hat{H}_S(i)\) em janela \(9 \times 9\)
  2. Dado que o pixel \(i\) pertence à classe \(g\), a densidade condicional é assintoticamente normal (pelo Lema 1):

\[p(\dot{H}_S(i) \mid U_{ig} = 1;\; \boldsymbol\theta_g) = f_{\mathcal{N}}\left(\dot{H}_S(i);\; \mu_g, \sigma_g^2\right)\]

  • \(U_{ig} \in \{0, 1\}\): variável latente de pertinência
  • O modelo de segmentação\(\rightarrow\) mistura de \(c\) gaussianas para a entropia observada

Algoritmo SEM

Stochastic Expectation-Maximization


Vantagens sobre o EM tradicional:

  1. Evita convergência para máximos locais ruins
  2. Não exige soluções analíticas na etapa E
  3. Excelente desempenho em misturas de dados SAR


Passos por iteração \(k\):

  • Passo E: Probabilidades a posteriori \(\hat{\tau}_g^{(k)}(i)\)
  • Passo S: Amostra rótulos via Multinomial
  • Passo M: Atualiza \((\hat{\mu}_g, \hat{\sigma}_g^2, \hat{\pi}_g)\)
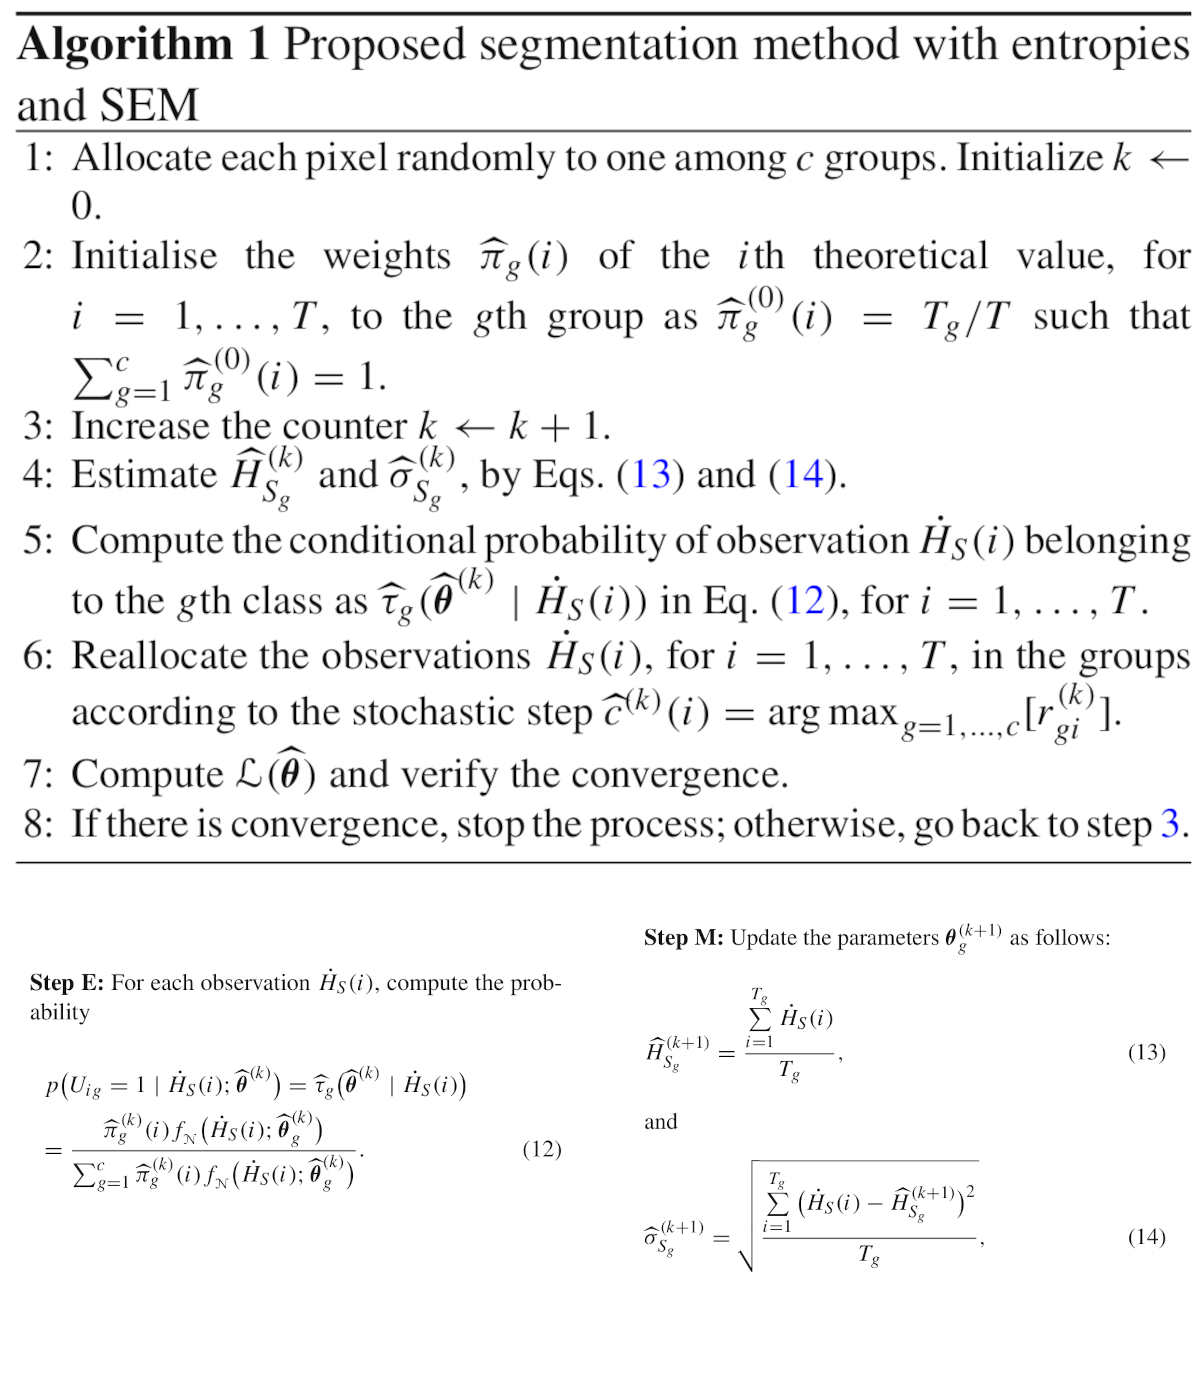
Detalhes do Algoritmo SEM


Passo E — Probabilidade de cada pixel pertencer à classe \(g\): \[\hat{\tau}_g(\boldsymbol\theta^{(k)} \mid \dot{H}_S(i)) = \frac{\hat{\pi}_g^{(k)}(i)\, f_{\mathcal{N}}(\dot{H}_S(i);\boldsymbol\theta_g^{(k)})}{\sum_{g'=1}^{c}\hat{\pi}_{g'}^{(k)}(i)\, f_{\mathcal{N}}(\dot{H}_S(i);\boldsymbol\theta_{g'}^{(k)})}\]

Passo S — Sorteio estocástico: \(R_i^{(k)} \sim \mathcal{M}(1, \boldsymbol\tau_i^{(k)})\)

Passo M — Atualização dos parâmetros: \[\hat{H}_{Sg}^{(k+1)} = \frac{1}{T_g}\sum_{i=1}^{T_g} \dot{H}_S(i), \qquad \hat{\sigma}_{Sg}^{(k+1)} = \sqrt{\frac{1}{T_g}\sum_{i=1}^{T_g}(\dot{H}_S(i) - \hat{H}_{Sg}^{(k+1)})^2}\]

Critério de parada: \(\left|\frac{\mathcal{L}(\boldsymbol\theta^{(k)}) - \mathcal{L}(\boldsymbol\theta^{(k+1)})}{\mathcal{L}(\boldsymbol\theta^{(k+1)})}\right| < \varepsilon\), com \(\varepsilon = 10^{-5}\)

Quatro Métodos Propostos


Sigla Modelo ENL
S-\(H_S(\mathcal{W}_m(\hat{\boldsymbol\Sigma}, L_0))\) Wishart Fixo
S-\(H_S(\mathcal{W}_m(\hat{\boldsymbol\Sigma}, \hat{L}))\) Wishart Estimado
S-\(H_S(\mathcal{G}^0_m(\hat{\alpha}, \hat{\boldsymbol\Sigma}, L_0))\) \(\mathcal{G}^0_m\) Fixo
S-\(H_S(\mathcal{G}^0_m(\hat{\alpha}, \hat{\boldsymbol\Sigma}, \hat{L}))\) \(\mathcal{G}^0_m\) Estimado


Comparados com \(k\)-means e \(k\)-medoids (9 variáveis reais da vetorização de \(\mathbf{Z}\))


Métricas: Acurácia, Coeficiente Kappa (\(\kappa\)), Var(\(\kappa\)), Gwet AC1 (GAC1)

5. Experimentos e Resultados

Experimentos e Resultados

Mapas de Entropia
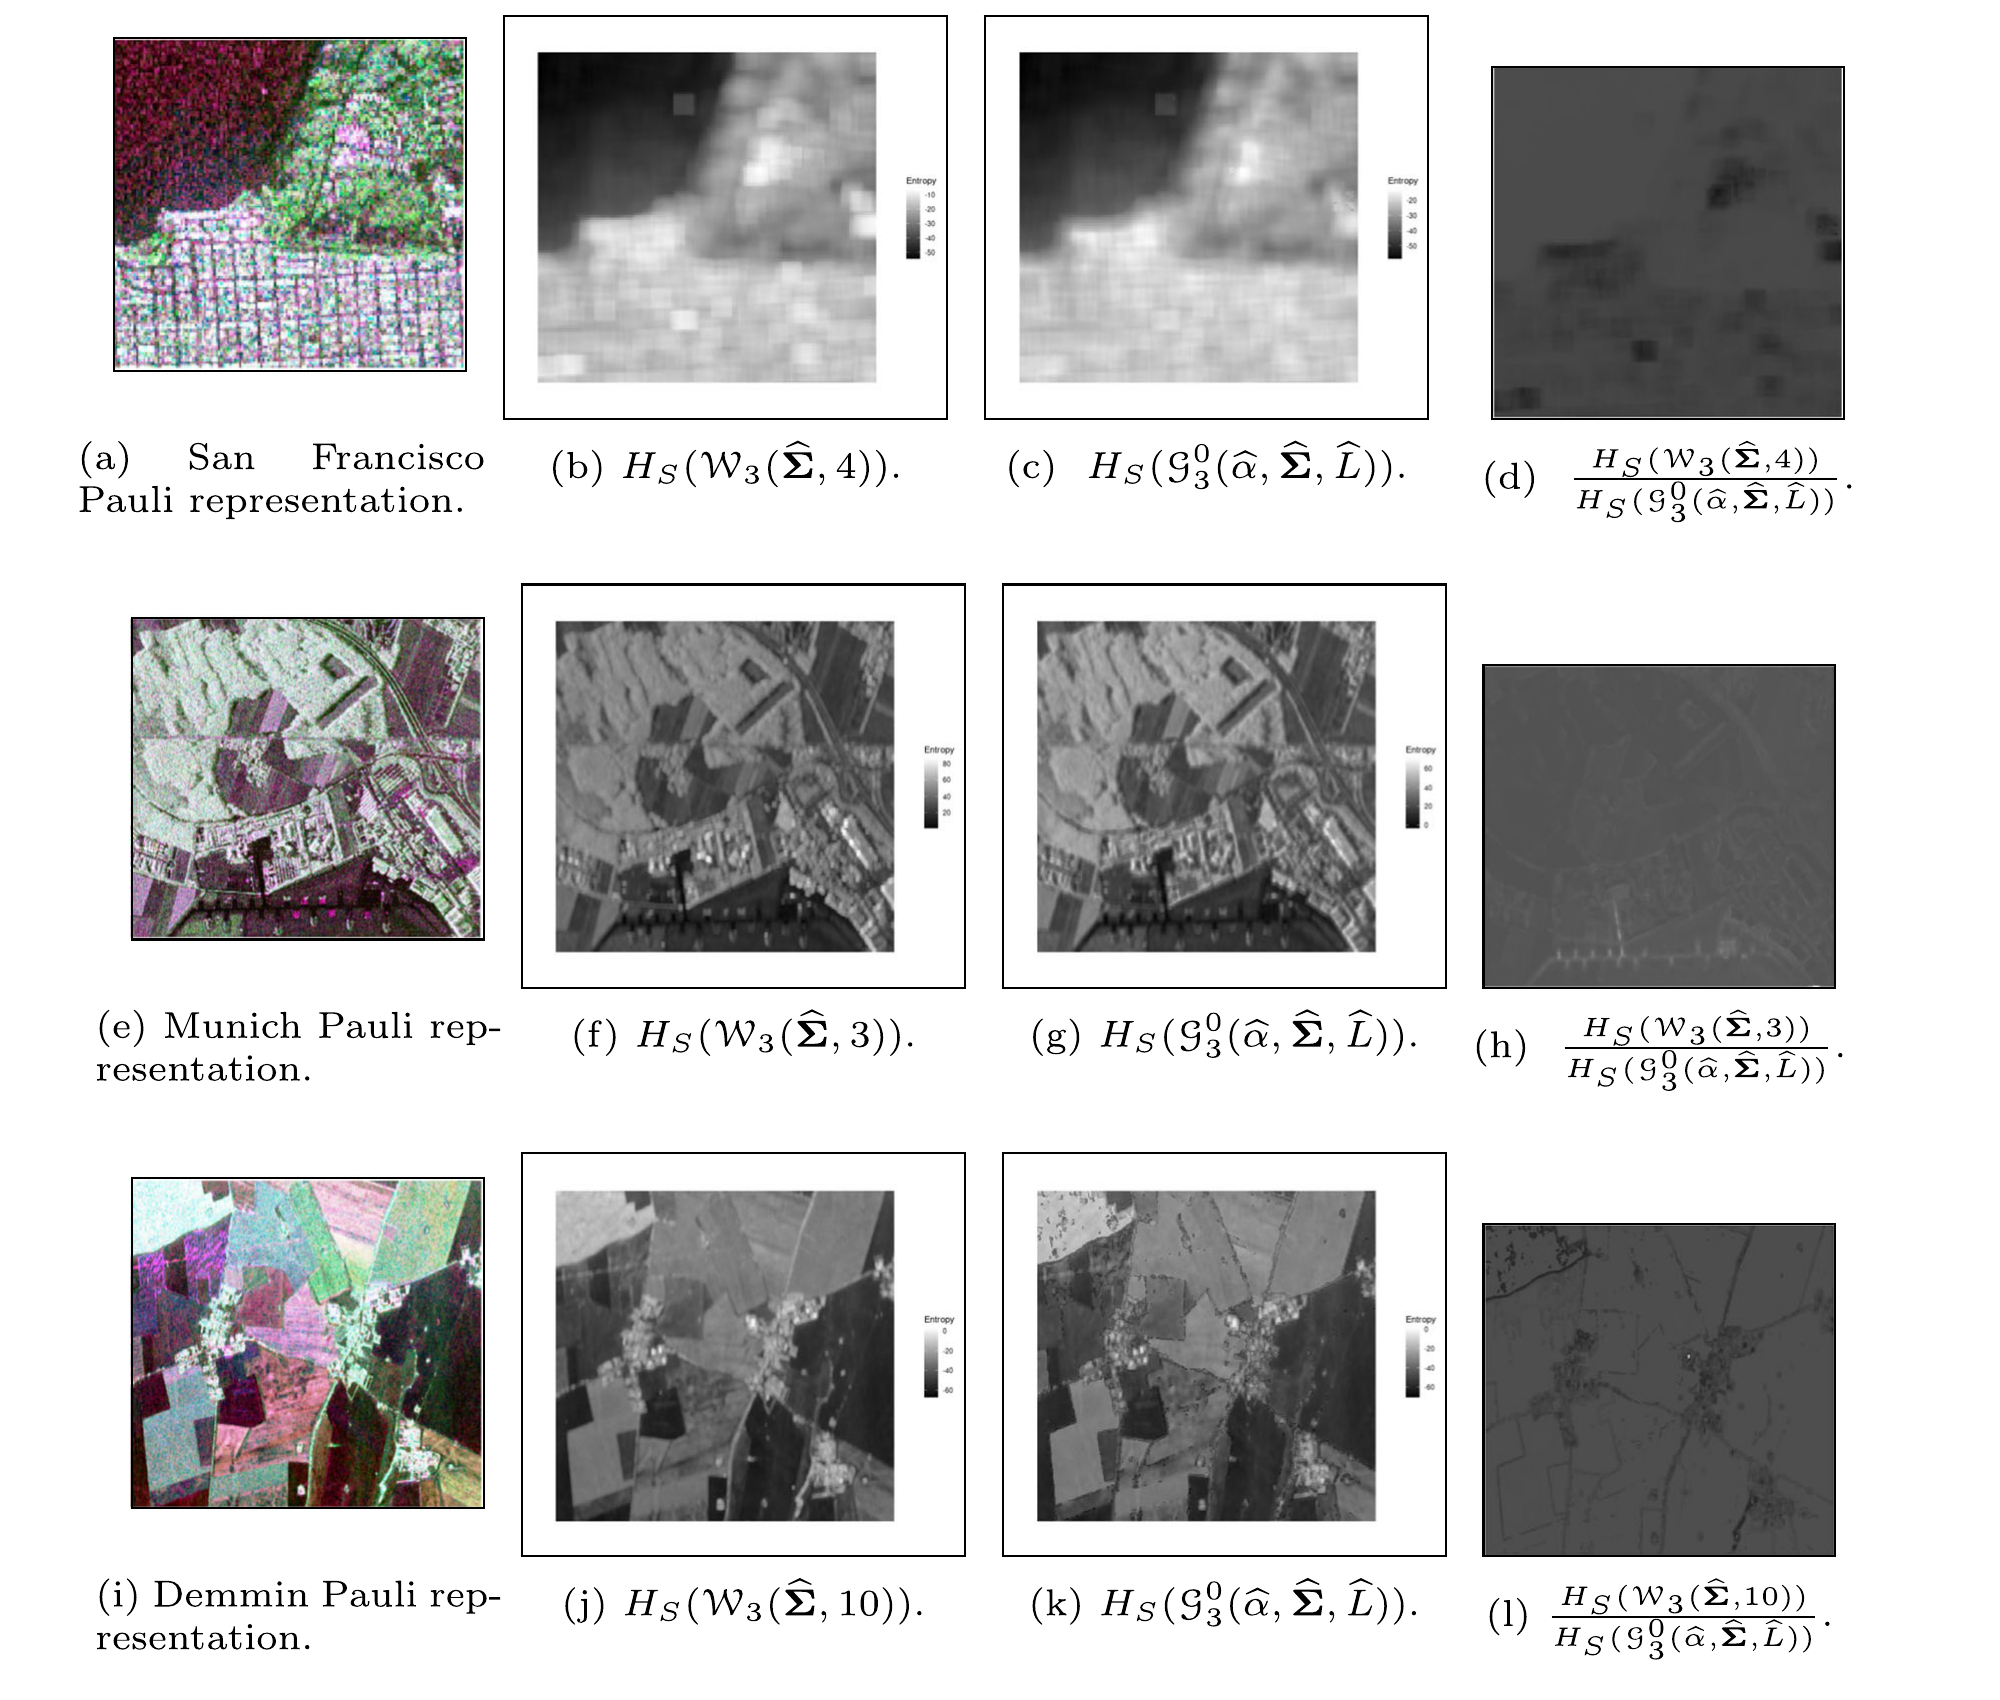

Fig. 4 — Decomposição de Pauli e mapas de entropia sob \(\mathcal{W}_m\) e \(\mathcal{G}^0_m\) para San Francisco, Munique e Demmin (janela \(9 \times 9\)).

Experimentos e Resultados

Estudo com Dados Simulados
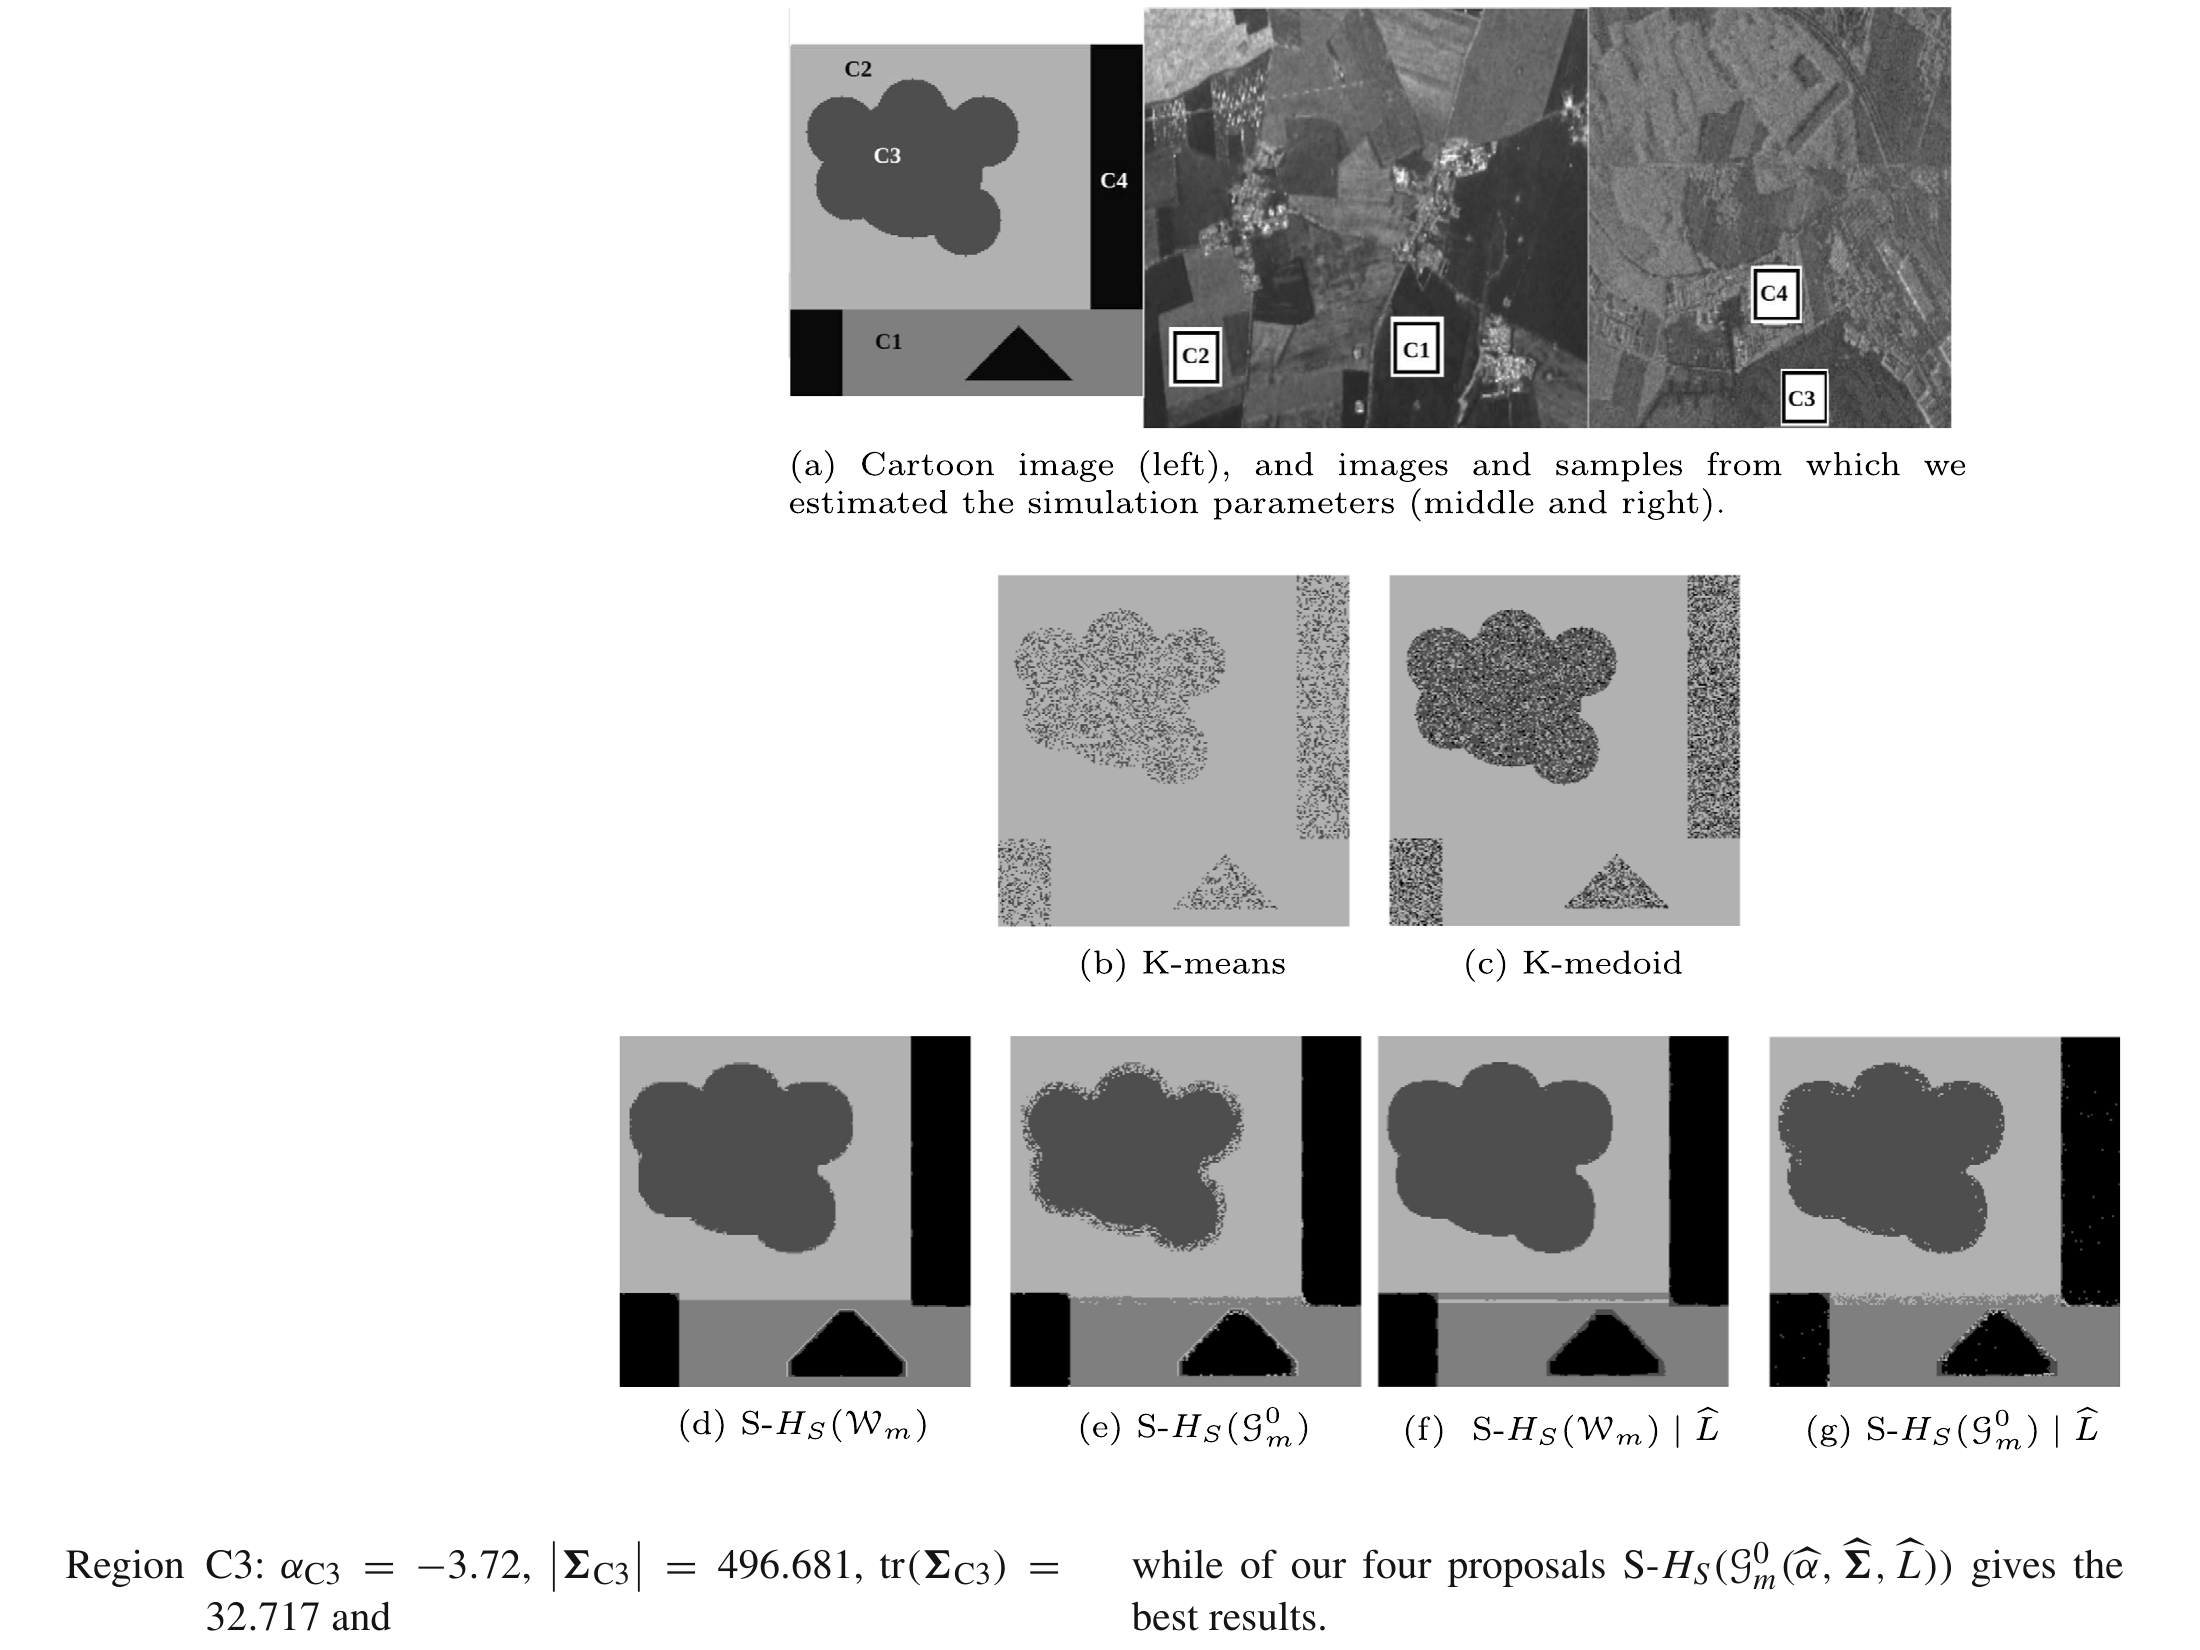

Fig. 8 — Modelo “cartoon” com 4 regiões (parâmetros reais de Demmin e Munique). (a) Ground truth, (b-g) Segmentações.

Cenário: Diferenças sutis entre covariâncias e textura

Método Acurácia \(\kappa\)
\(k\)-means 0.494 0.151
\(k\)-medoids 0.568 0.325
S-\(H_S(\mathcal{W}_m, L_0)\) 0.906 0.870
S-\(H_S(\mathcal{W}_m, \hat{L})\) 0.883 0.839
S-\(H_S(\mathcal{G}^0_m, L_0)\) 0.922 0.891
S-\(H_S(\mathcal{G}^0_m, \hat{L})\) 0.897 0.857

Experimentos e Resultados

Aplicação 1: San Francisco (EUA)
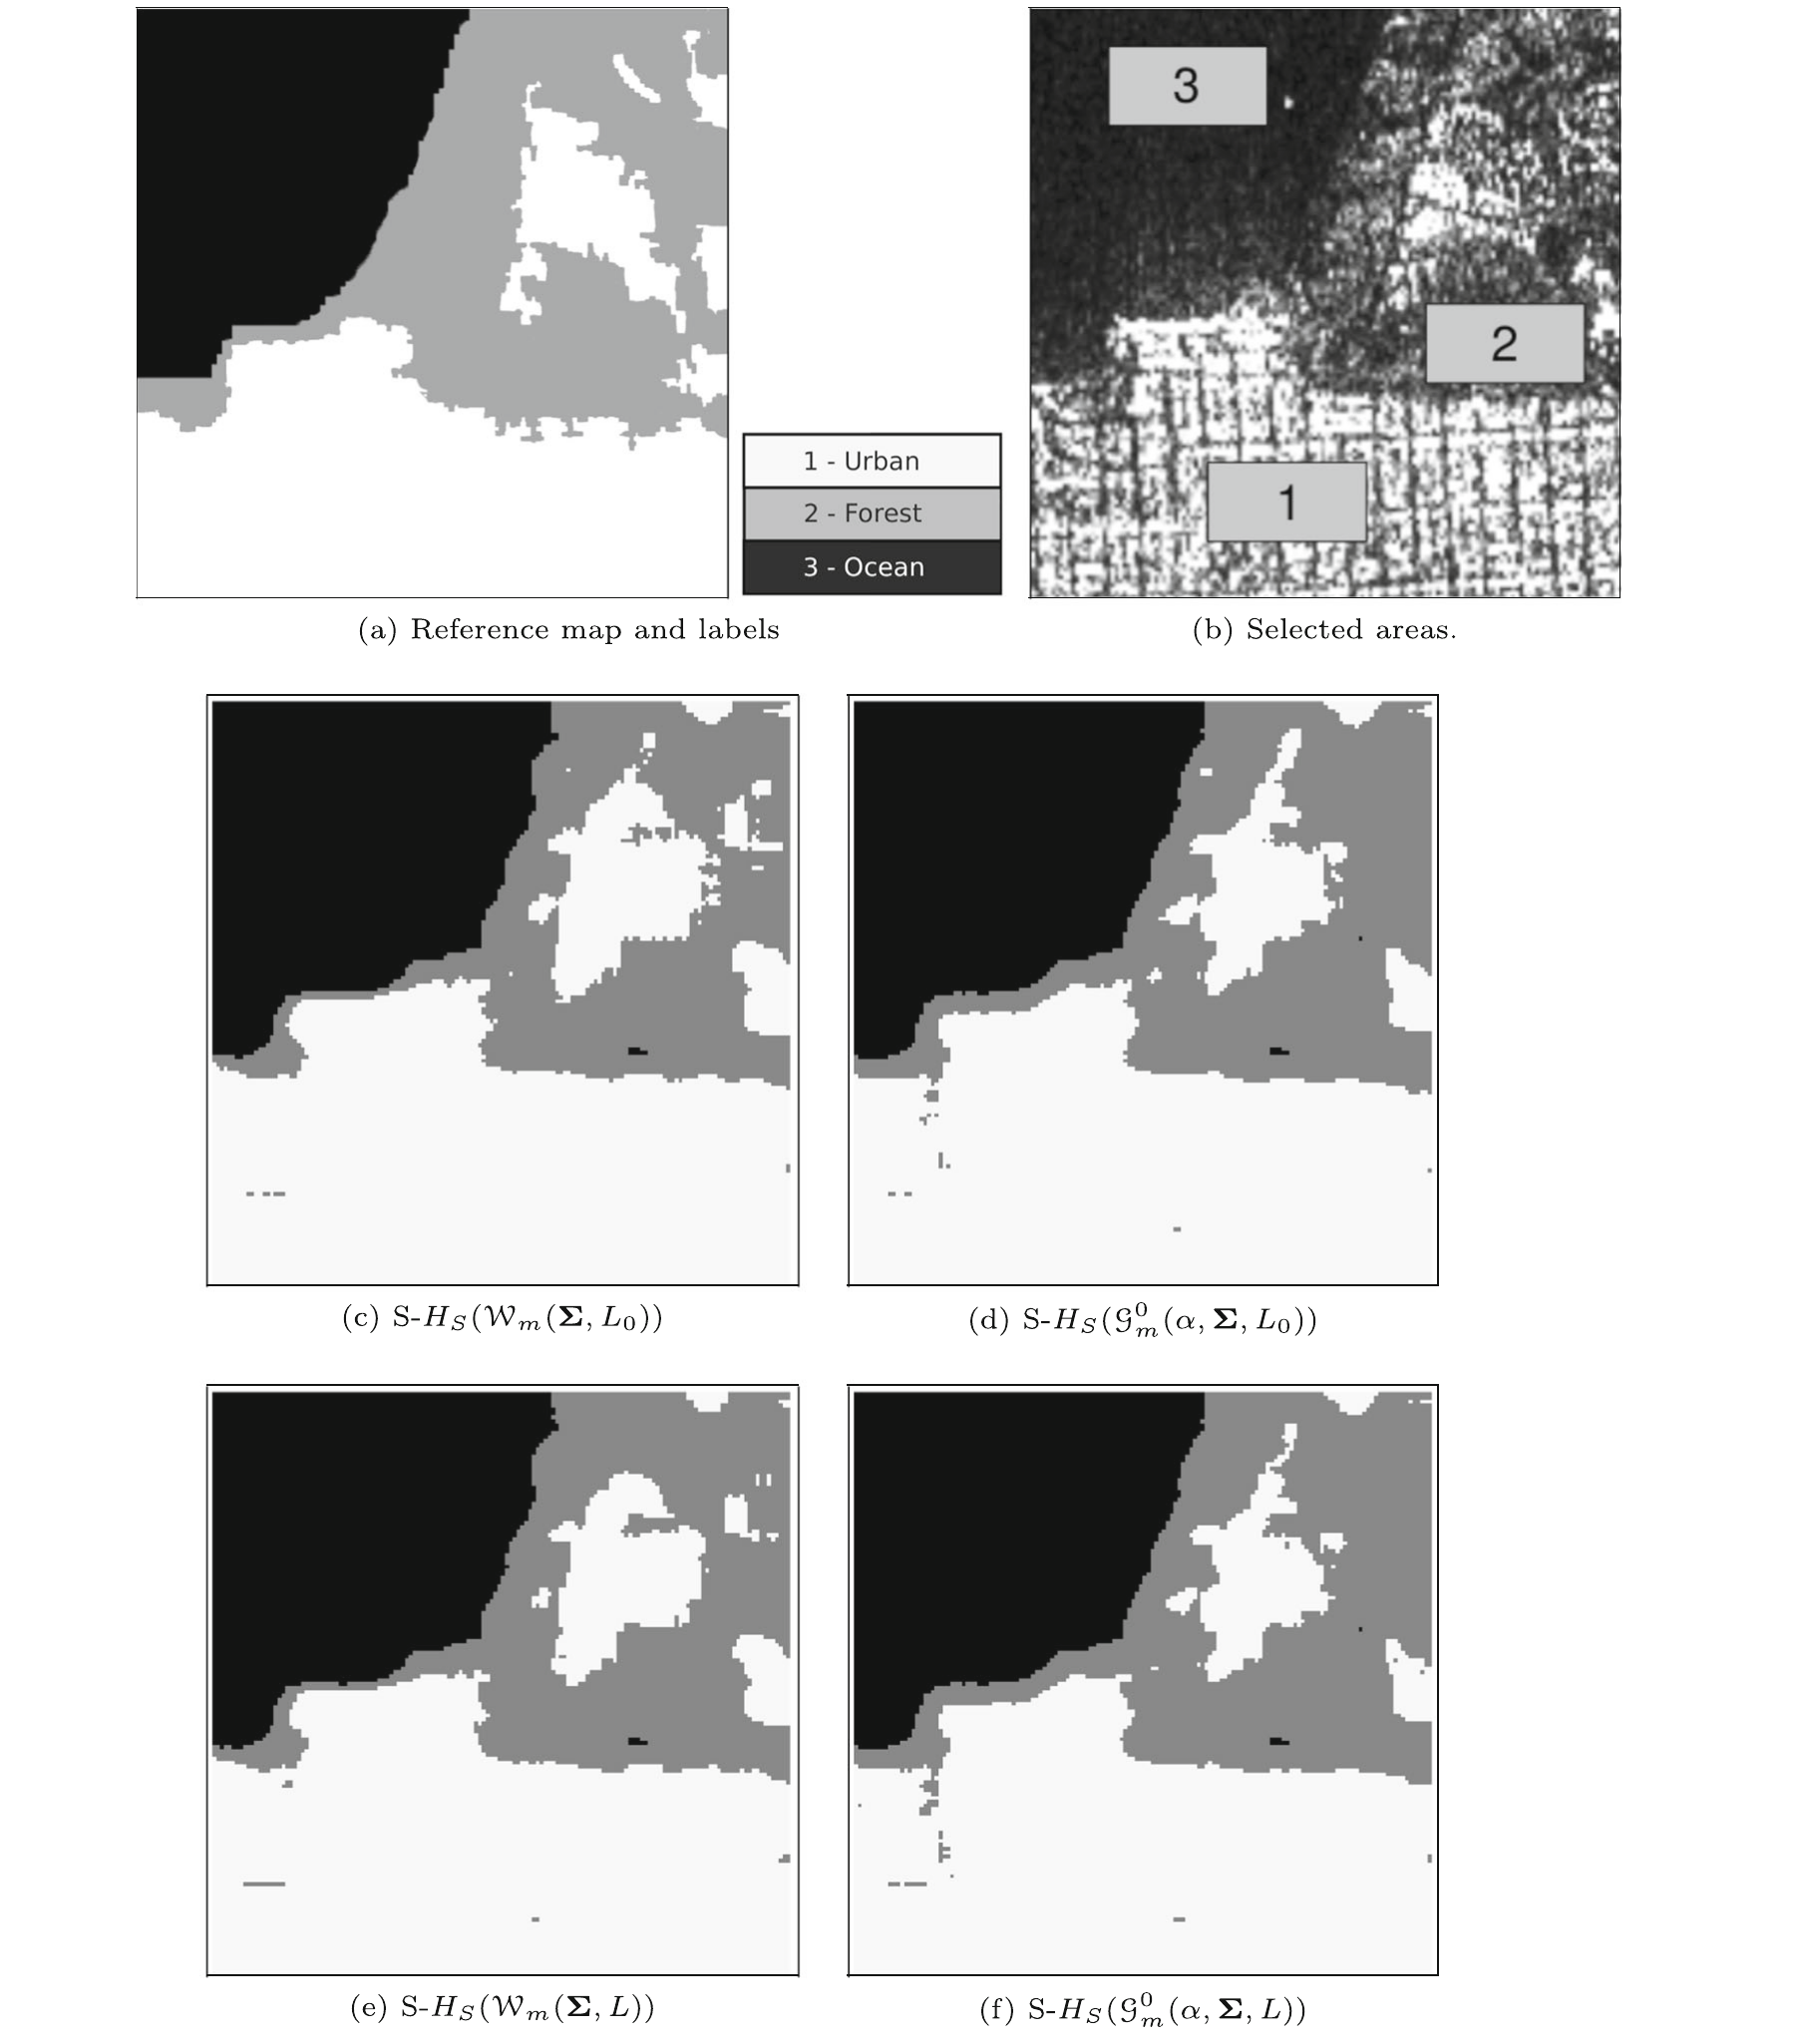

Fig. 5 — AIRSAR, banda L, 4 looks. (a) Ground truth, (b) Áreas selecionadas, (c–f) Segmentações.

Cenário: Classes bem separadas (Urbano, Floresta, Oceano)

Método Acurácia \(\kappa\)
\(k\)-means 0.296 \(\approx 0\)
\(k\)-medoids 0.402 0.131
S-\(H_S(\mathcal{W}_m, L_0)\) 0.991 0.986
S-\(H_S(\mathcal{W}_m, \hat{L})\) 0.990 0.985
S-\(H_S(\mathcal{G}^0_m, L_0)\) 0.980 0.969
S-\(H_S(\mathcal{G}^0_m, \hat{L})\) 0.967 0.949

Experimentos e Resultados

Aplicação 2: Munique (Alemanha)
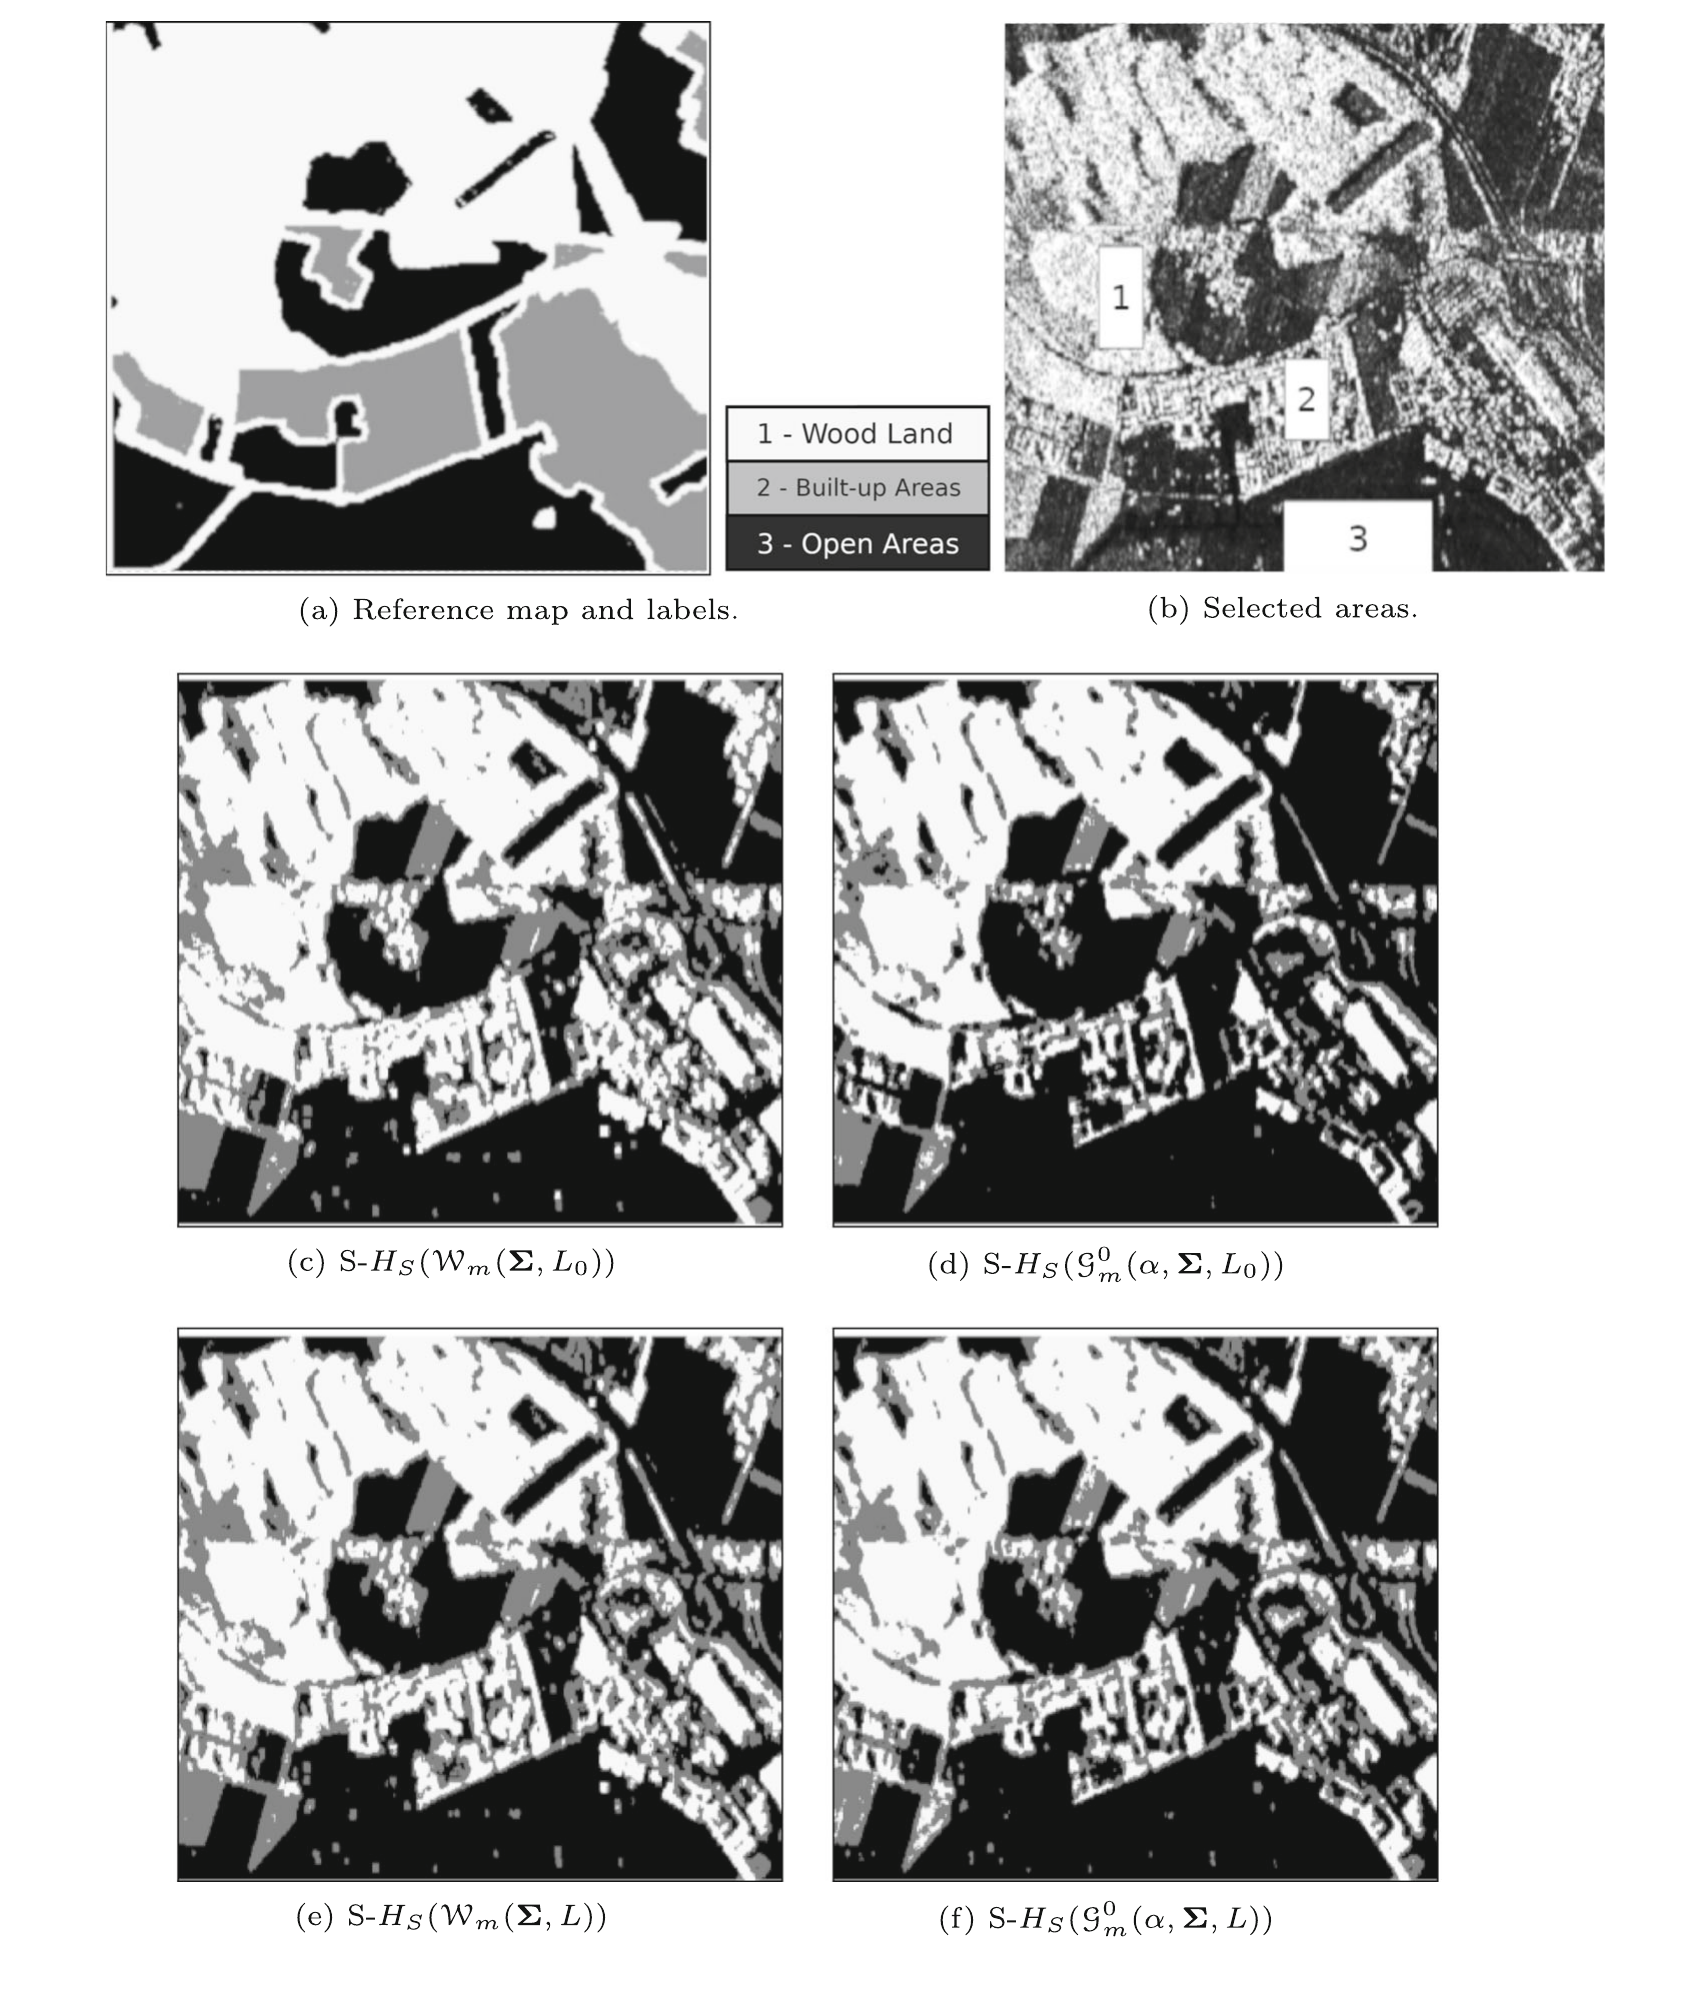

Fig. 6 — E-SAR, banda L, 3.2 looks. (a) Ground truth, (b–f) Segmentações.

Cenário: Regiões altamente misturadas (Floresta, Área construída, Campo)

Método Acurácia \(\kappa\)
\(k\)-means 0.559 \(\approx 0\)
\(k\)-medoids 0.692 0.393
S-\(H_S(\mathcal{W}_m, L_0)\) 0.820 0.689
S-\(H_S(\mathcal{W}_m, \hat{L})\) 0.827 0.701
S-\(H_S(\mathcal{G}^0_m, L_0)\) 0.822 0.678
S-\(H_S(\mathcal{G}^0_m, \hat{L})\) 0.840 0.718

Experimentos e Resultados

Aplicação 3: Demmin (Alemanha)
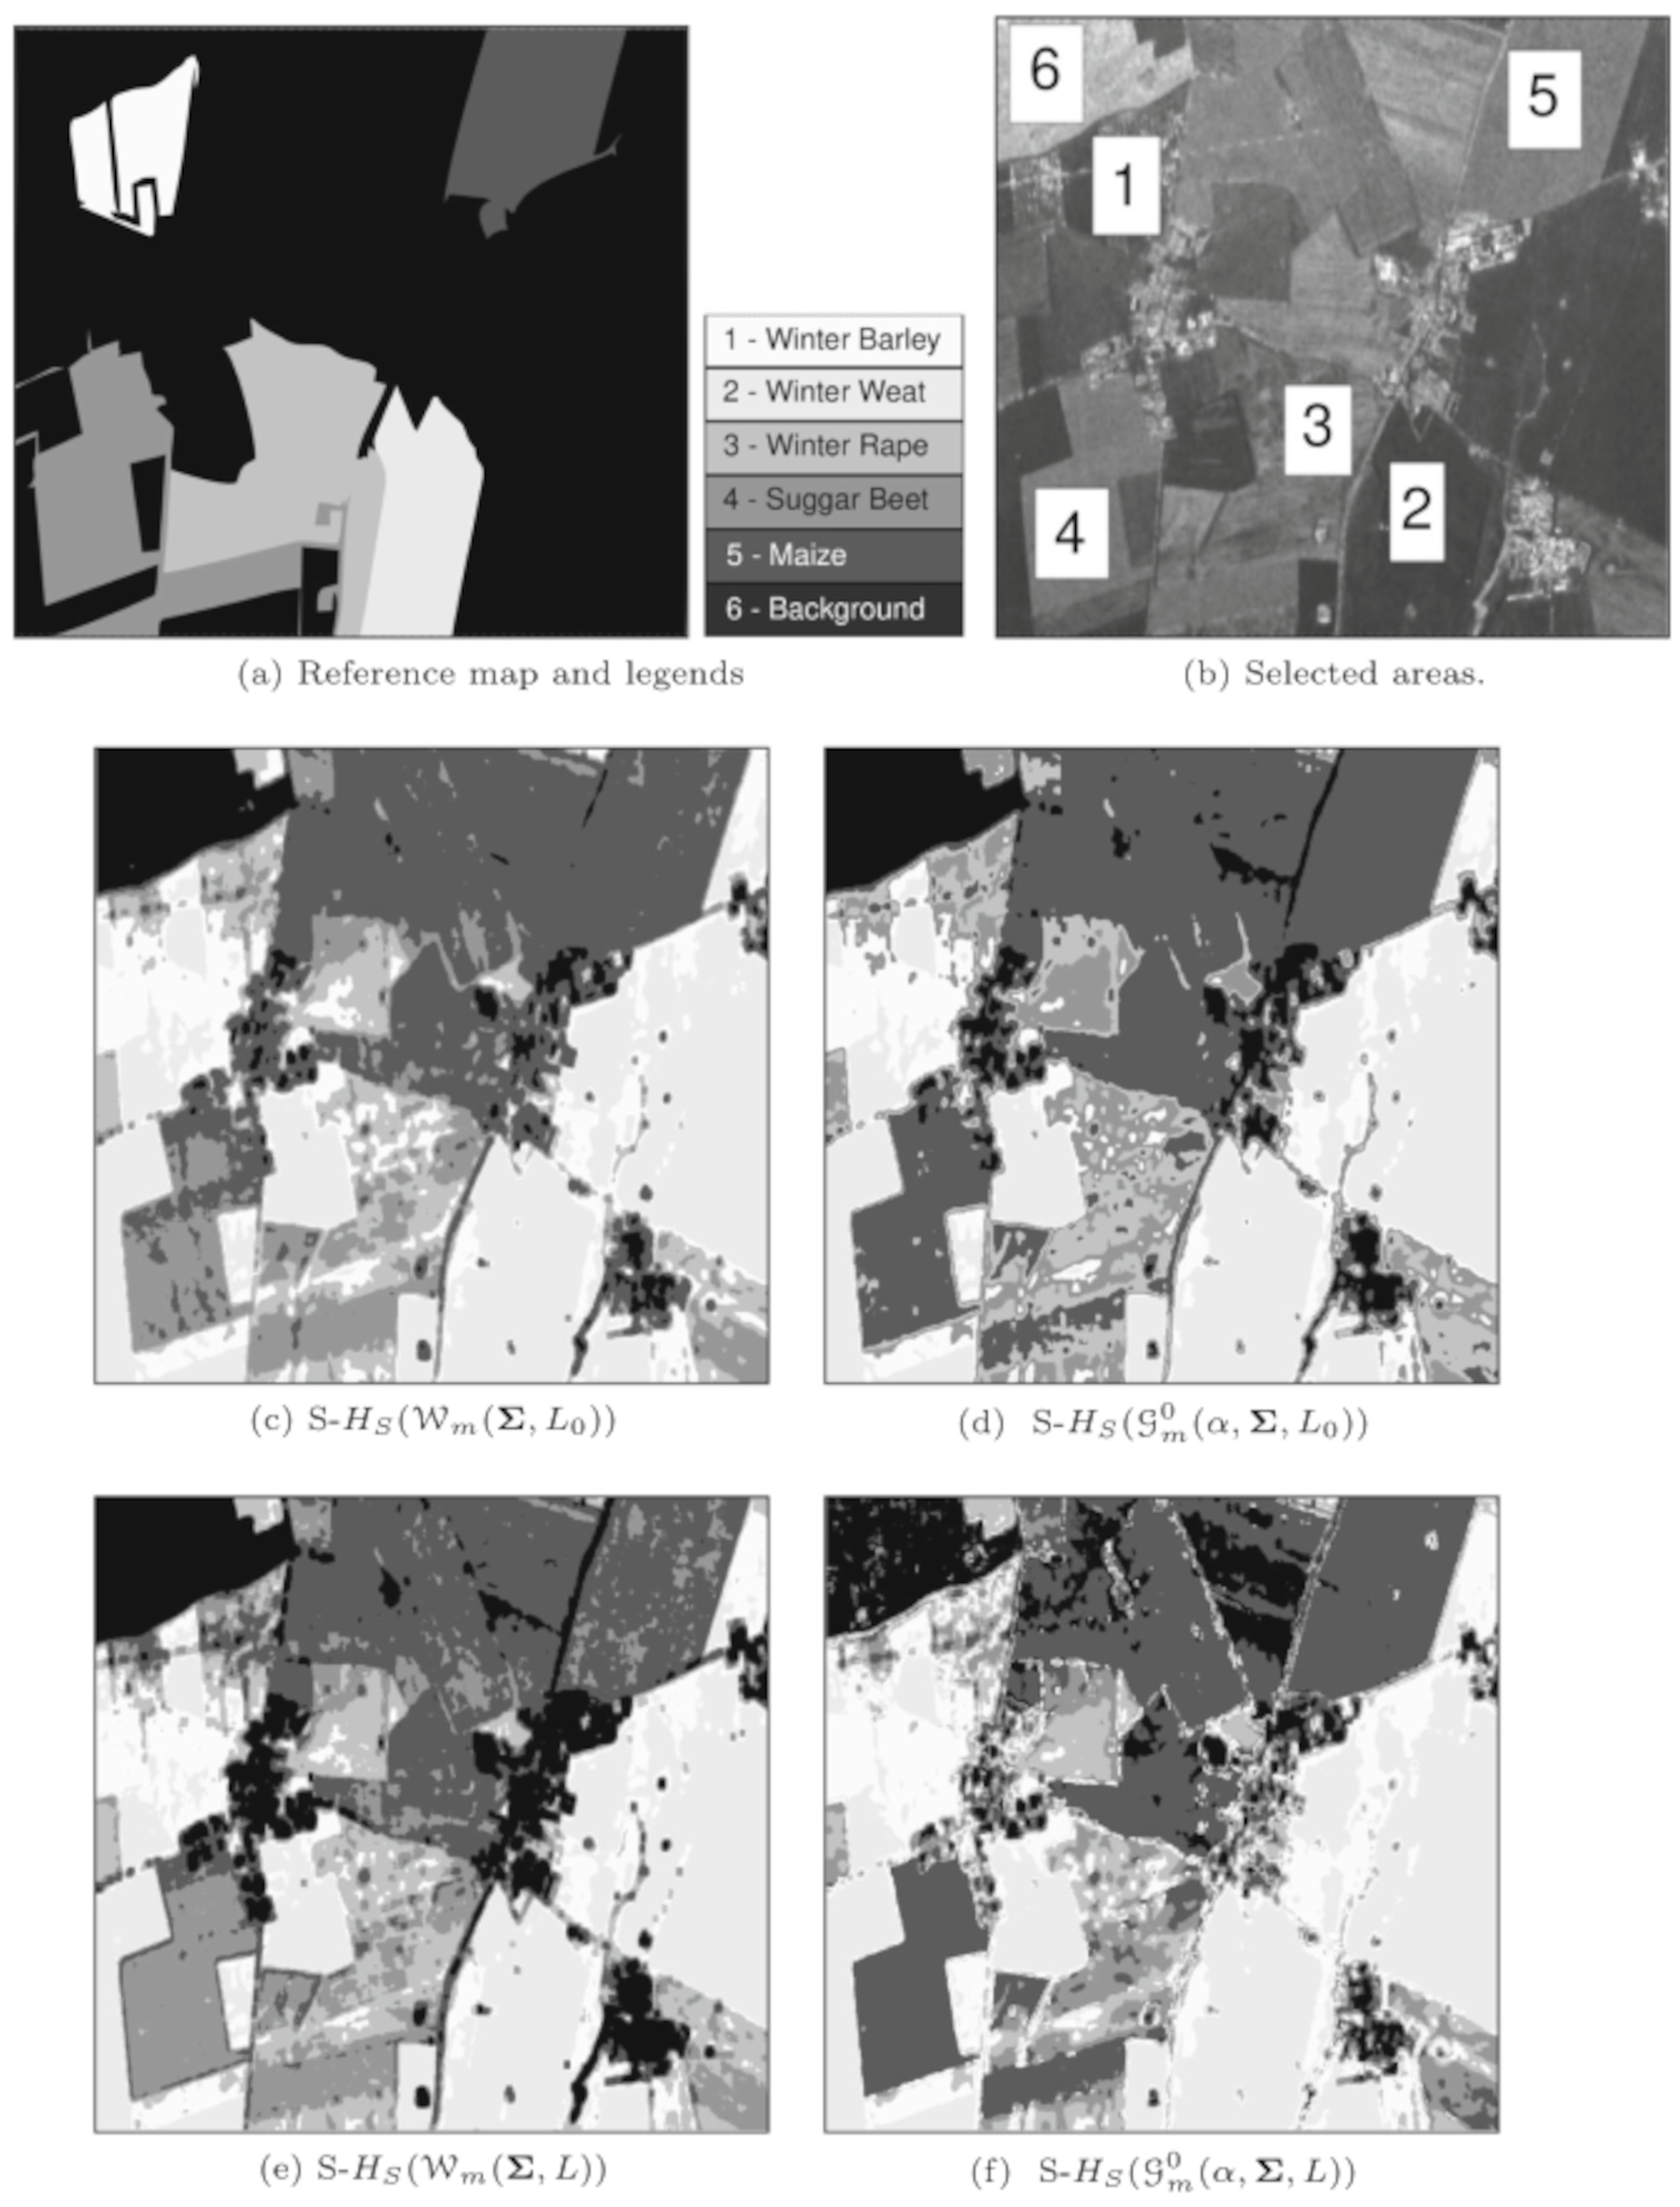

Fig. 7 — AgriSAR, 8 looks. Região agrícola com 5 classes de cultivo.

Cenário: Imagem agrícola, 5 classes, alto \(L\)

Método Acurácia \(\kappa\)
\(k\)-means 0.316 0.198
\(k\)-medoids 0.402 0.284
S-\(H_S(\mathcal{W}_m, L_0)\) 0.774 0.728
S-\(H_S(\mathcal{W}_m, \hat{L})\) 0.755 0.705
S-\(H_S(\mathcal{G}^0_m, L_0)\) 0.601 0.519
S-\(H_S(\mathcal{G}^0_m, \hat{L})\) 0.594 0.512

Experimentos e Resultados

Análise Comparativa dos Resultados


Cenário Melhor Modelo Justificativa
San Francisco (classes bem separadas) \(\mathcal{W}_m(\boldsymbol\Sigma, L_0)\) Parcimônia favorece separação clara
Munique (classes misturadas) \(\mathcal{G}^0_m(\hat\alpha, \hat{\boldsymbol\Sigma}, \hat{L})\) Flexibilidade captura rugosidade
Demmin (agrícola, alto \(L\)) \(\mathcal{W}_m(\boldsymbol\Sigma, L_0)\) Alto multilooking suaviza textura
Simulação (diferenças sutis) \(\mathcal{G}^0_m(\hat\alpha, \hat{\boldsymbol\Sigma}, L_0)\) Modelagem de textura é crucial


Todos os métodos baseados em entropia superam \(k\)-means e \(k\)-medoids em todos os cenários!

Conclusões


  1. Nova Expressão Analítica: Derivou-se a Entropia de Shannon em forma fechada para a distribuição \(\mathcal{G}^0_m\) (Teorema 1)

  2. Propriedades Assintóticas: A aproximação normal e o Método Delta fornecem base teórica sólida para o SEM

  3. Desempenho Superior: A segmentação baseada em Entropia superou \(k\)-means e \(k\)-medoids

  4. Recomendação Prática:

    • \(\mathcal{W}_m\) → alvos bem separados ou alto número de looks
    • \(\mathcal{G}^0_m\) → imagens complexas, urbanas ou com alta heterogeneidade de textura

Referências Selecionadas


  • Nascimento, A.D.C., Ferreira, J.A., Frery, A.C. (2023). Unsupervised segmentation of PolSAR data with complex Wishart and \(\mathcal{G}^0_m\) distributions and Shannon entropy. Statistics and Computing, 33:129.

  • Freitas, C.C., Frery, A.C., Correia, A.H. (2005). The polarimetric \(\mathcal{G}^0\) distribution for SAR data analysis. Environmetrics, 16(1), 13–31.

  • Frery, A.C., Cintra, R.J., Nascimento, A.D.C. (2013). Entropy-based statistical analysis of PolSAR data. IEEE TGRS, 51(6), 3733–3743.

  • Salicrú, M. et al. (1994). On the applications of divergence type measures in testing statistical hypothesis. J. Multivariate Anal., 51(2), 372–391.

  • Pardo, L. et al. (1997). Large sample behavior of entropy measures when parameters are estimated. Commun. Stat. Theory Methods, 26(2), 483–501.

  • Ferreira, J.A., Nascimento, A.D.C. (2020). Shannon entropy for the \(\mathcal{G}^0_I\) model. IEEE JSTARS, 13, 2547–2553.


Obrigado!


Perguntas?


Contato:
Jodavid A. Ferreira — jodavid.ferreira@ufpe.br
Abraão D. C. Nascimento — abraao@de.ufpe.br
Alejandro C. Frery — alejandro.frery@vuw.ac.nz

DOI: 10.1007/s11222-023-10298-0